Command Palette
Search for a command to run...
从像素到动作——迈向原生视觉-语言-动作策略
从像素到动作——迈向原生视觉-语言-动作策略
摘要
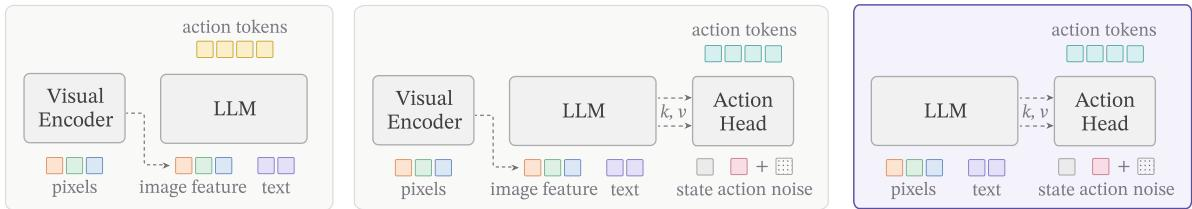
视觉-语言-动作模型通常建立在一个简单前提之上:感知首先由视觉编码器压缩,动作推理随后才开始。然而,操作往往恰恰依赖于那些最易被这种抽象损害的视觉信号,例如局部几何、边界、深度和细微的状态变化。这提出了一个根本性问题:动作策略应继承固定的视觉端点,还是直接获取不断演化的视觉计算?我们提出了 NEO-VLA,一个在结构上无编码器的视觉-语言-动作框架。图像由轻量级分块卷积层进行 token 化,并在整个主干网络中与语言联合演化,使流匹配动作专家能够在不同深度处获取以指令为条件的视觉表征。这一简单改动揭示出一致的规律:在受控比较下,原生架构优于基于编码器的对应架构;全量微调能够缩小但无法消除差距,仅靠扩大规模也无法弥补该差距。更引人注目的是,逐层探测显示,对动作至关重要的信号往往在最终视觉表征之前就已达到峰值。因此,在多种操作场景和分布偏移下,NEO-VLA 实现了更强且更鲁棒的控制。这些结果共同表明,具身控制受益于能够获取计算层级中不同层次的视觉表征,而非仅依赖固定的编码器输出。
一句话总结
来自 S-Lab、南洋理工大学、SenseTime Research 和 Ropedia 的研究者提出了 NEO-VLA,一种结构上无编码器的视觉-语言-动作模型,其中 patch 卷积图像 tokens 与语言共同演化,使 flow-matching action expert 能够在多个深度读取指令条件的视觉表示,从而实现比基于编码器的策略更强、更稳健的操控控制。
核心贡献
- 提出了 NEO-VLA,一种结构上无编码器的视觉-语言-动作框架:图像由轻量级 patch 卷积层 token 化,并在 backbone 中与语言共同演化,flow-matching action expert 在多个深度读取指令条件视觉表示。
- 在 LIBERO、LIBERO-plus 和 RoboTwin 2.0 上的受控比较中,在匹配的 action expert 和训练语料下,原生架构优于基于编码器的对应方案;全量微调减少但没有消除差距,仅靠规模无法弥补差距。
- 逐层探测显示,动作关键的视觉信号往往在最终视觉表示之前达到峰值;分布偏移评估显示,NEO-VLA 在多样操控设置和观测变化下实现了更强、更稳健的控制。
引言
机器人操控策略必须将语义理解与细粒度空间推理结合,但大多数视觉-语言-动作模型将动作头连接到单独预训练视觉编码器的特征上,使策略位于固定视觉终点之后,并隐藏了中间视觉计算。此前工作表明,这种视觉前端可能限制控制,因为视觉组件对剪枝敏感,并且动作微调可能降低预训练视觉表示的质量。作者提出了 NEO-VLA,一种结构上原生的 VLA,将原始像素直接映射到共享视觉-语言 backbone 中,并使用 flow-matching action expert 从不同 backbone 层读取缓存特征,使视觉读取深度成为明确的策略选择。他们表明,早期层和早期-晚期组合读取对控制尤其有用,并且 NEO-VLA 在操控基准和分布偏移中保持稳健。
数据集
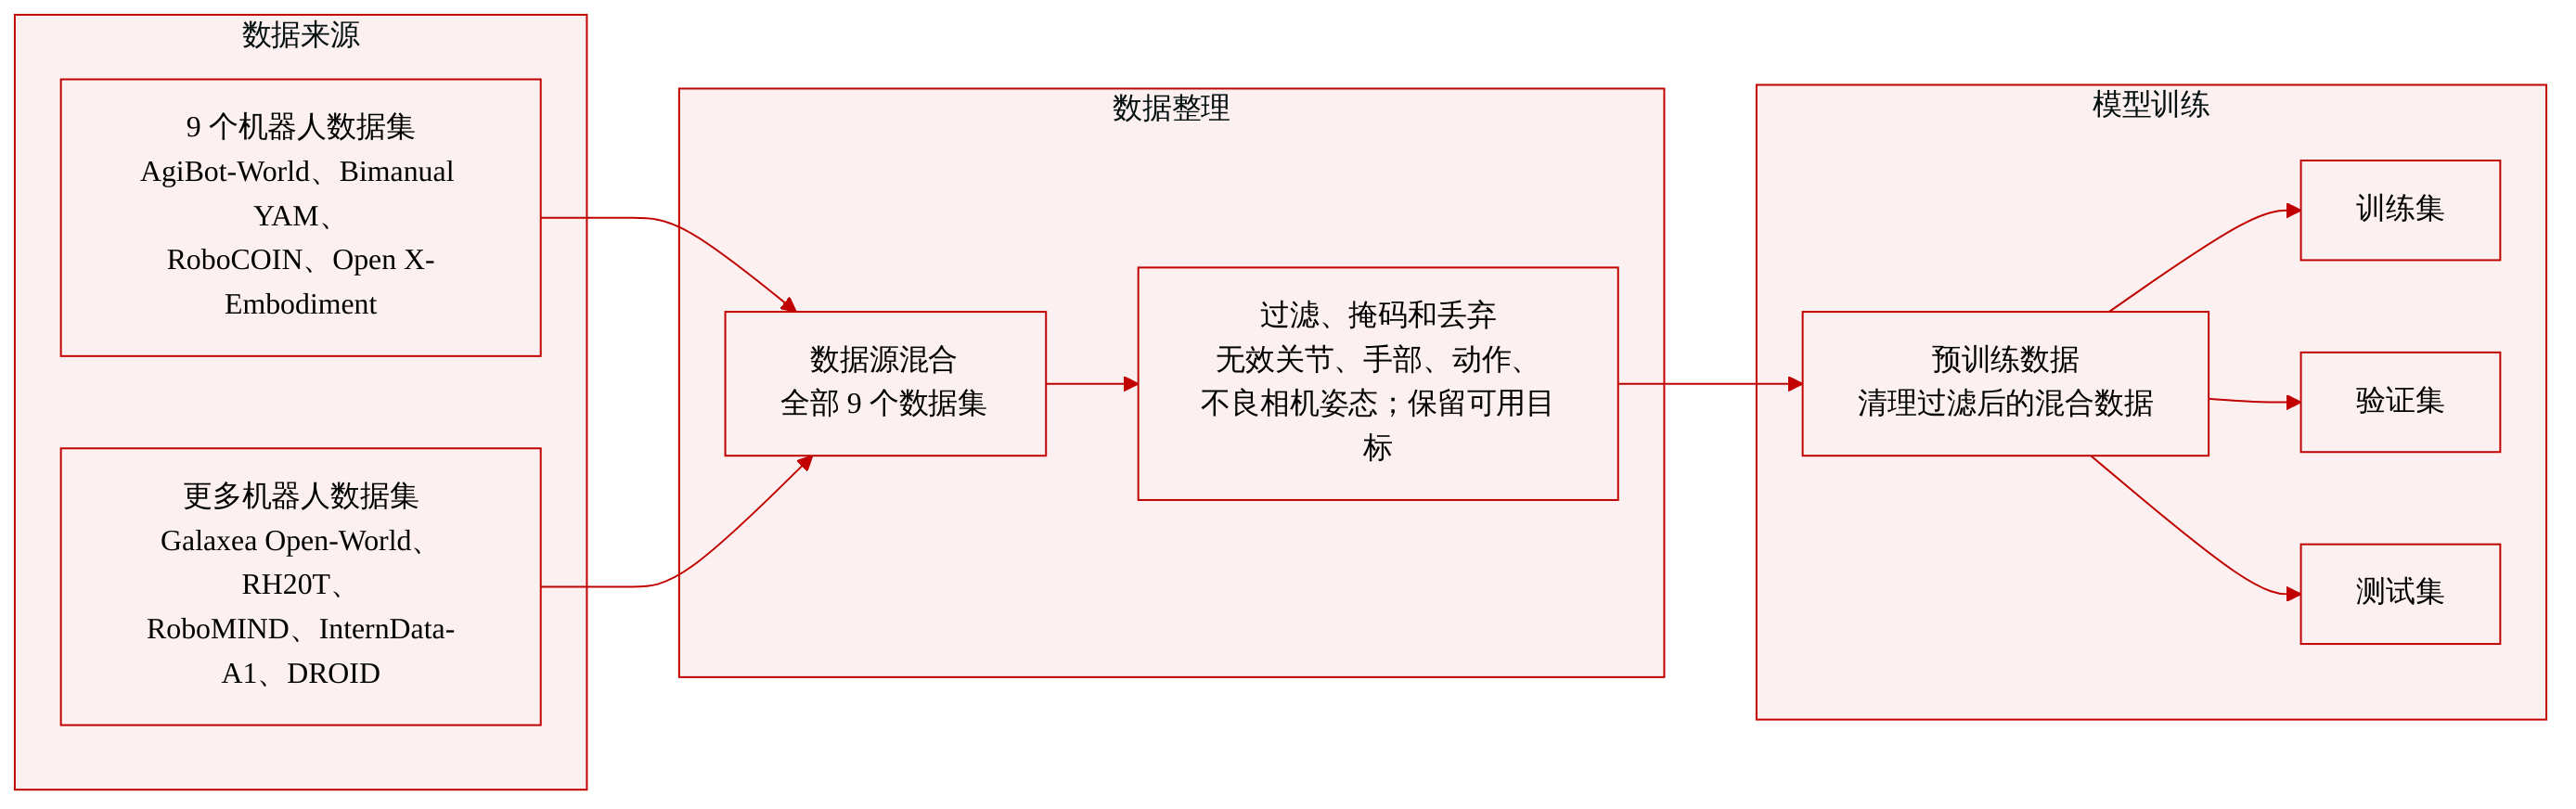
作者从九个来源构建预训练数据:AgiBot-World、Bimanual YAM、RoboCOIN、Open X-Embodiment、Galaxea Open-World、RH20T、RoboMIND、InternData-A1 和 DROID。这些数据集共同覆盖了多样的本体、任务和视觉条件。
数据集过滤与处理:
- 来源检查排除不可靠的测量和损坏的 episode。
- 关节读数超出 ±2π,或与五行局部中位数相差超过 π 的,被标记为无效。
- 在数据集记录的 episode 中至少有 90% 保持不变的关节和手部通道会被遮蔽。
- 对于相应本体,大于 π 的未解决关节不连续会被遮蔽。
- 动作离群值根据扩展的逐本体边界检查。超界或非有限值仅遮蔽该步的对应字段组,其他目标保持可用。
- 当数据缺失或不可读、记录形状不一致、数值无效或 episode 步数过少时,丢弃该 episode。
- 在所需信号可用时检查相机标定。使用内参和完整相机位姿投影记录的 3D 机械臂位置。将投影点处的图像运动与整体图像运动进行评分,并与错误位姿对照比较。不可信位姿被标记为未知,其 episode 仍保留。
- 内参检查覆盖焦距、主点、视场角,以及与存储图像尺寸的一致性。
在模型训练中的作用:
- 过滤后的数据集构成表 1 所示预训练数据。
- 该摘录提及表 1 以了解各来源组成和训练混合细节。
- 处理流水线在可能时通过遮蔽无效的关节、手部、动作或相机位姿字段来保留可用目标,同时丢弃完全不可用的 episode。
方法
作者采用一种结构上原生的视觉接口,通过总步幅为 32 的轻量级两阶段卷积嵌入器,将原始图像直接投影到 backbone token 空间。这为每个 32×32 图像区域生成一个 visual token。
视觉与语言 tokens 在整个 decoder backbone 中被联合处理,而连续动作由 flow-matching expert 生成,避免了显式的动作 token 化。为了处理空间和时间维度,模型采用 Native Rotary Position Embedding,将位置分解为时间、高度和宽度坐标,并采用解耦的旋转频率。这使得可以统一处理图像、视频和交错多模态序列。backbone 进一步采用模态感知的多模态注意力,其中文本 tokens 遵循因果注意力,视觉 tokens 在每个视觉块内双向交互。
如下图所示,模型将机器人观测转换为统一的多模态前缀,该前缀由上一时刻和当前多视角图像、结构化语言以及机器人状态组成。
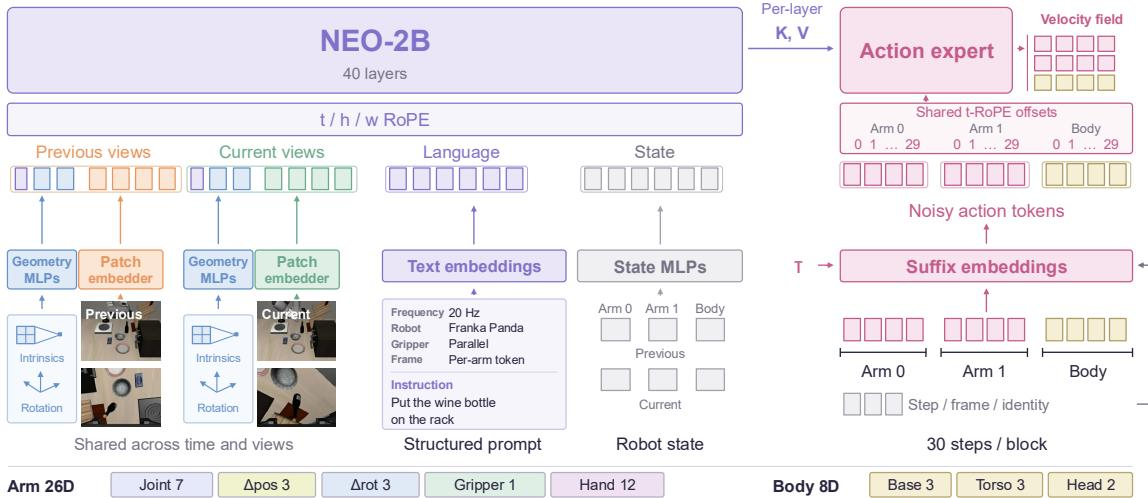
每个时间块最多包含三个相机视角,由相机身份 token、投影相机几何和 patch 级视觉 tokens 表示。相机内参和旋转由轻量级几何 MLP 编码,而单一 patch 嵌入器在所有相机、视角和时间步之间共享。图像保持原生宽高比,并在每个视角最多 88 个 visual tokens 的固定预算下动态 patch 化。视觉块之后是结构化提示,指定控制频率、机器人本体、夹爪配置、动作坐标系参考和任务指令。机器人本体感知由六个额外 tokens 表示,分别对应机械臂和共享身体的上一状态与当前状态。状态 MLP 联合编码测量值及其有效性掩码。所有前缀 tokens 由原生 backbone 使用三维旋转位置联合处理。模型没有将这种计算折叠为单个最终视觉表示,而是直接将 backbone 各层的 keys 和 values 暴露给轻量级 action expert。action expert 从可配置的 backbone 层子集读取,使其能够将这种多模态前缀与带噪声的动作 tokens 和 flow 时间结合,以建模动作块。
action expert 使用单独模块预测连续动作块。每个 expert 层联合关注在其映射 backbone 层缓存的 prefix keys 和 values,以及 action tokens 自身的 keys 和 values。每个目标包含一个机械臂动作块和一个共享身体动作块。给定目标动作,作者采样高斯噪声和时间变量以构造带噪动作。expert 预测速度场,其目标为干净动作与带噪动作之差。训练目标平衡四个动作组:末端执行器运动和夹爪、机械臂关节、手部关节和身体动作。损失被最小化为每组有效项上均方速度误差的加权和:
Laction=E[∑g∈Gwg∑g∈Gwgℓg]推理时,模型在保持 prefix KV cache 固定的情况下,使用 10 个 Euler 步求解从时间 0 到 1 的学习 flow,并对得到的动作块进行反归一化以供执行。
为确保高质量训练数据,作者实现了严格的数据质量过滤工作流。
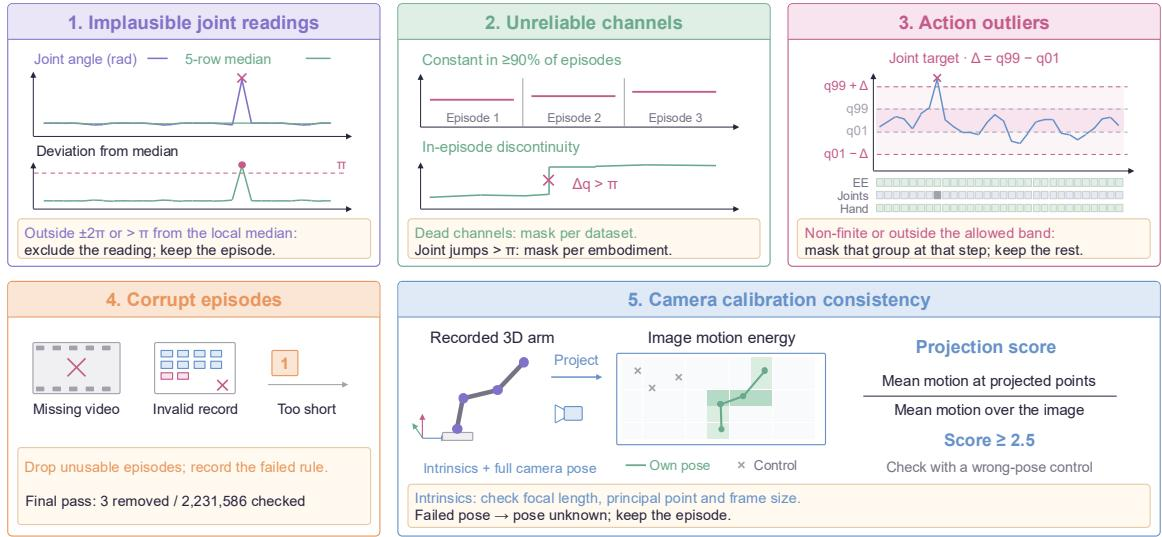
该流水线应用来源检查以排除不可靠的测量和损坏的 episode。超出特定范围或与局部中位数显著偏差的关节读数被标记为无效。在大多数 episode 中保持不变或包含未解决不连续的通道会被遮蔽。动作离群值根据扩展的逐本体边界检查,仅遮蔽该步的对应字段组。数据缺失、形状不一致或步数过少的 episode 会被丢弃。相机标定也通过投影记录的 3D 机械臂位置,并根据投影点处的图像运动相对于整幅图像运动进行评分来验证。不可信位姿被标记为未知,若其他数据有效,其 episode 仍保留。
训练方案由三个渐进阶段组成。第一阶段冻结预训练的视觉-语言 backbone,仅训练 action expert 和条件模块,共 113,400 个优化器步。第二阶段解冻完整模型,并在机器人预训练语料上训练 75,000 步,同时与多模态理解数据联合训练以保持视觉-语言能力。每两个优化器步添加一次打包的理解样本,并施加辅助的 next-token prediction 损失。第三阶段使用内部动作数据进行全参数微调,继续训练 75,000 步。两个阶段均使用 AdamW,具有特定 beta 参数和权重衰减,线性学习率 warmup 后接余弦衰减,bfloat16 混合精度,并采用梯度范数裁剪。
实验
实验在匹配的预训练和 action-expert 设置下,评估了原生输入 VLA backbone 与基于编码器基线,发现无编码器预训练产生可迁移性良好的控制就绪表示,甚至在 backbone 适配之前即可迁移。层分析显示,动作相关信息分布在多个深度中,早期层支持冻结迁移,视觉、语言和几何信号在不同阶段达到峰值。与通用理解数据联合训练可保持多模态能力,并防止场景随机化下的策略崩溃。仿真基准和真实世界任务进一步显示出较强的分布内性能、对感知和语义偏移的稳健性,以及在有限微调下的实际部署特性。
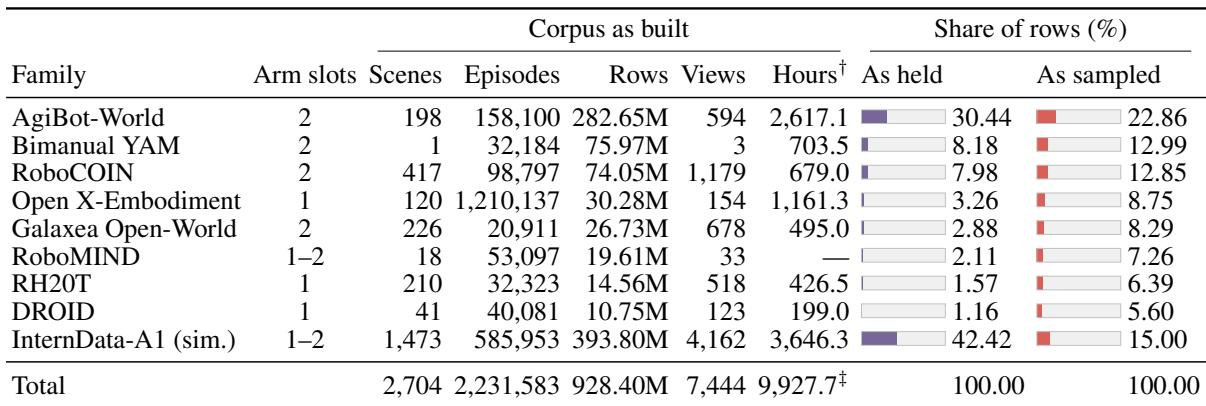
该语料聚合了九个公开数据集家族,涵盖单臂和双臂本体,包含超过 220 万个 episode 和近 10,000 小时机器人数据。存储行最集中于 AgiBot-World,而 Open X-Embodiment 贡献了最大的 episode 数量,但由于每个 episode 记录的视角较少,存储行份额相对较小。采样权重在一定程度上偏离了最大的存储行份额,给予双臂和 RoboCOIN 数据更高的相对权重。按存储行计,AgiBot-World 是最大的单一贡献者,并且在训练期间仍然是被采样最多的来源。Open X-Embodiment 的 episode 数量最多,但存储行份额和采样份额相对较低,这反映了其每 episode 视角数量较低。Bimanual YAM 和 RoboCOIN 的采样比例高于其存储份额,而 AgiBot-World 的采样比例低于其存储份额。
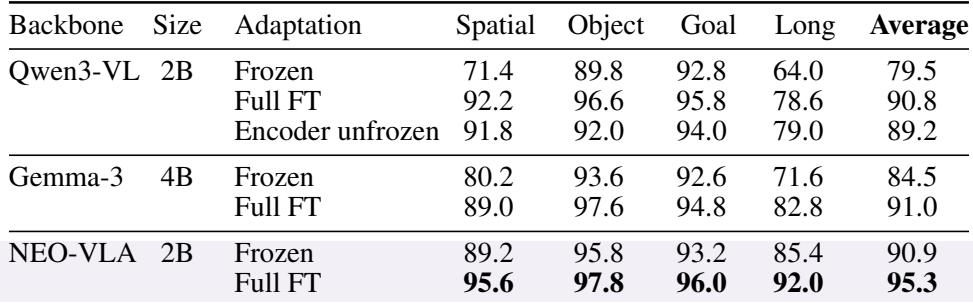
在 LIBERO 各个套件上,当仅更新 action expert 时,原生输入 backbone 显示出比 Qwen3-VL 和 Gemma-3 更强的冻结 backbone 成功率。它在长时程任务上的冻结性能超过两个基于编码器 backbone 的全量微调结果,而全量微调进一步将其平均成功率提升到所有比较模型之上。结果表明,原生 backbone 提供了控制就绪表示,同时保留了通过全模型适配继续提升的空间。在仅训练 action expert 的情况下,原生输入 backbone 在比较的 backbone 中取得最高的冻结平均成功率和最大的长时程分数。其冻结平均成功率与全量微调的 Qwen3-VL 和 Gemma-3 基线相当。全量微调提高了每个 backbone,但原生输入模型保持最佳平均成功率和长时程成功率。在其他层冻结的情况下仅更新视觉编码器和 action expert,使 Qwen3-VL 相对冻结训练有所提升,但仍低于全量微调。
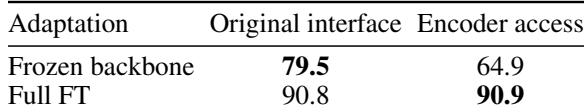
与原始接口相比,Qwen3-VL 中的直接编码器访问降低了冻结 backbone 性能,表明中间视觉塔特征对策略学习而言不那么直接可用。全量微调基本弥合了这一差距,使两种接口达到相近的平均成功率。编码器访问设置不增加参数。在冻结 backbone 训练下,编码器访问的性能显著低于原始接口。全量微调几乎使原始接口和编码器访问持平。编码器访问不引入额外参数。
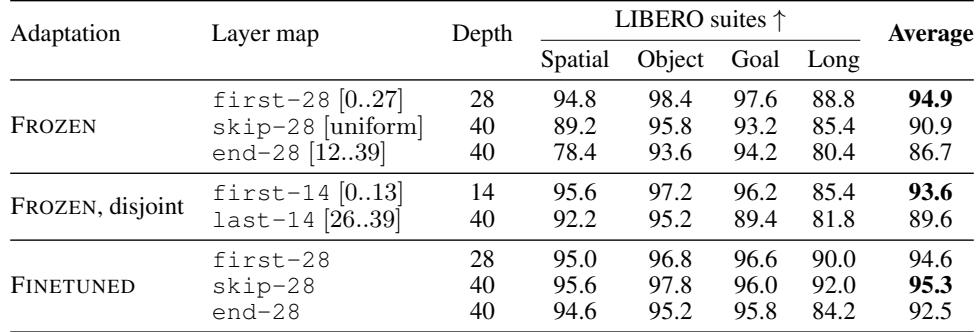
该消融比较了 action expert 在 LIBERO 上读取 backbone 层的方式。保留或读取早期层的冻结配置,例如 first-28 和 first-14,比仅读取后期层的映射,例如 end-28 和 last-14,获得更高的平均成功率。微调后也出现同样的趋势,不过一些早期读取映射也会缩短 backbone,因此读取位置与深度和计算量相互纠缠。冻结的 first-28,即读取第 0-27 层,在比较的映射中取得最高平均成功率,skip-28 居中,而读取第 12-39 层的 end-28 尽管保留相同的 40 层 backbone,但表现最低。在不重叠比较中,first-14 在每个 LIBERO 套件上都优于 last-14,尽管 first-14 也减少了 backbone 深度,使得读取位置与 backbone 深度共同变化。
在 LIBERO-plus 基准上,不同扰动类型和模型之间的鲁棒性差异很大。在列出的开放模型中,π0.5 的总体结果最强,而更早的开放基线大幅落后。被引用上下文报告称,NEO-VLA 在公开代码和权重的模型中领先,相机和语言扰动是特别强项。列出的开放模型从 π0 的非常低总体鲁棒性到 π0.5 的最强开放模型总分。没有一个列出的模型在每个扰动轴上都占优,模型在相机、机器人、语言、光照、背景、噪声和布局偏移上的表现差异显著。据报告,NEO-VLA 在公开代码和权重的模型中实现了最高的总体鲁棒性,尤其是相机和语言性能很强。
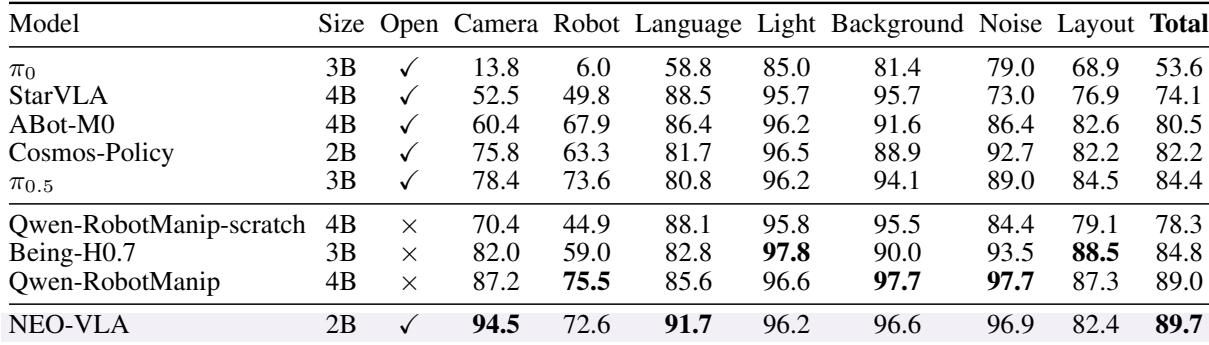
实验刻画了一个大规模多本体机器人数据集,显示 AgiBot-World 在存储行和采样行中占主导地位,而 Open X-Embodiment 贡献大量 episode 但每个 episode 的行数较少,且 Bimanual YAM 和 RoboCOIN 相对存储份额被过采样。在 LIBERO 基准上,原生输入 backbone 给出最强的冻结和微调控制性能,而直接编码器访问会损害冻结的 Qwen3-VL 策略,但在全量微调后恢复。层读取消融表明,读取更早的视觉层比仅读取后期层更能提高成功率,尽管深度和计算量部分相互纠缠。最后,LIBERO-plus 鲁棒性在不同扰动和模型之间差异很大,π0.5 在列出的开放模型中领先,据报告 NEO-VLA 在公开代码模型中最强,尤其是在相机和语言偏移方面。