Command Palette
Search for a command to run...
FrontierPhysics:面向端到端物理研究的智能体评估
FrontierPhysics:面向端到端物理研究的智能体评估
摘要
AI 智能体在物理研究中正发挥日益重要的作用。然而,现有物理基准仅评估固定问题、孤立子任务或给定解答下的论文复现,很少在考察正确性的同时检查研究质量。我们提出了 FRONTIERPHYSICS 这一端到端基准,包含由 42 位物理学家基于自身研究构建的 56 个任务,覆盖理论物理、计算物理和实验物理的九个领域。每个任务都要求智能体查阅文献、制定研究计划、开展研究与实验,并产出结构化输出和科学手稿。FRONTIERPHYSICS 将确定性验证器与专家编写的评分标准相结合,评估智能体的研究是否正确且可发表。在 22 个模型、26 种配置中,没有任何配置能在其 168 次运行中通过 46 次以上。对智能体轨迹的人工审查表明,前沿智能体的主要弱点是推理不够严谨和专家直觉有限,而非物理知识空白或执行错误。
一句话总结
作者提出了 FRONTIERPHYSICS,一个端到端的物理研究基准,包含由 42 位物理学家在九个理论、计算和实验领域创建的 56 个任务;通过将确定性验证器与专家编写的评分标准相结合,该基准同时评估正确性和可发表性,结果发现,22 个模型的 26 种配置中,没有一种配置在 168 次 rollout 中通过超过 46 次。
核心贡献
- FRONTIERPHYSICS 是一个端到端基准,包含 56 个任务,由 42 位物理学家根据自身研究编写,覆盖理论、计算和实验物理的九个领域。每个任务都需要文献综述、研究规划、开展研究和实验,并产出数值结果和科学手稿。
- 该基准将针对数值结果的确定性验证器与针对手稿质量的专家编写评分标准相结合,同时评估正确性和可发表性。任务经过人工通用审查、领域专家同行评审和失败模式分析,以保持开放性,同时减少假阳性和假阴性。
- 在 22 个模型的 26 种配置中,没有一种配置在 168 次 rollout 中通过超过 46 次。人工轨迹审计显示,前沿 agents 的主要弱点是推理不够严谨和专家直觉有限,而不是物理知识空白或执行错误。
引言
大型语言模型正从被动的科学助手转变为工具增强的 agents,能够检索文献、提出假设、编写和调试代码并生成技术报告。评估这一进展需要能够捕捉开放式、多阶段研究的基准,但现有研究级基准要么只针对孤立能力,要么依赖模型很快饱和的封闭式确定性答案,要么在全文复现设置中暴露原始出版物,从而限制开放式探究。作者提出了 FRONTIERPHYSICS,一个由活跃物理研究人员根据其亲自完成的项目构建的基准,并通过人工审查、领域专家同行评审和失败模式分析,在保持开放性的同时减少假阳性和假阴性。每个任务向一个 agent 提供高层首席研究员风格的提示,并要求其同时提交科学手稿和确定性数值输出,由验证器和基于评分标准的 reviewer agents 评分。
数据集
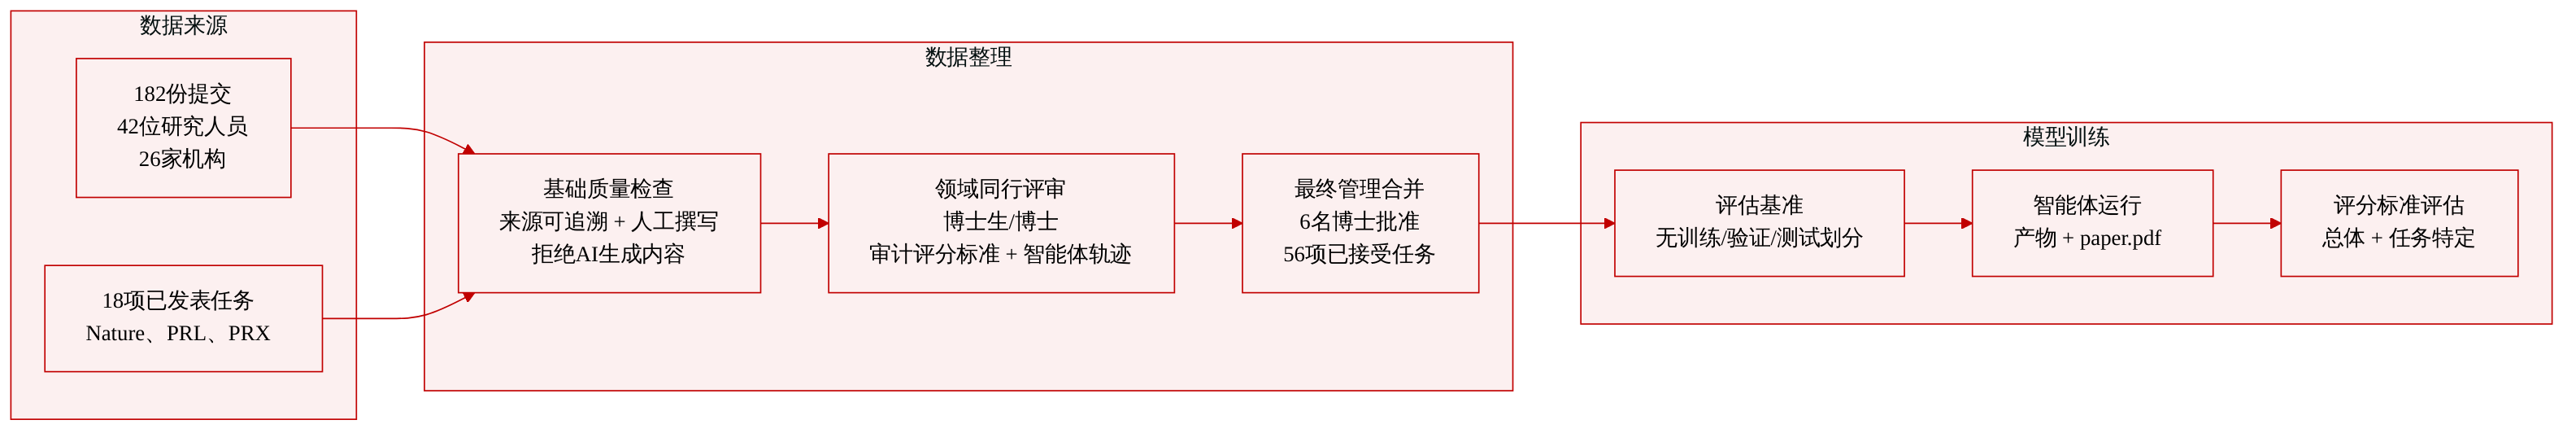
数据来源与规模
- FRONTIERPHYSICS 包含 56 个已接受的研究任务,来自 26 所机构的 42 位物理研究人员,覆盖 9 个物理领域。
- 这些任务从 182 份初始提交中通过真实性检查、领域同行评审和最终管理员批准选出。
- 18 个任务基于贡献者合著的已发表研究,包括四篇 Nature 论文以及发表在 Nature Communications、Physical Review Letters 和 Physical Review X 上的工作。
- 贡献者报告每个任务平均约 270 天的原始研究时间,总研究工作量超过 8,000 小时。
任务结构与模式
- 每个任务重构一个端到端研究项目。主指令保存在
task.md中,评估标准保存在rubric.json中,输入数据或支持文件在需要时于任务环境中提供。 - 提示可能包含重要问题或方向,但不指定明确的方法或解决路径。
- 每个任务都要求确定性产物,例如计算量、模拟输出或处理后的数据,以及作为
paper.pdf提交的最终手稿。 - 手稿必须达到同行评审标准,呈现研究背景、方法、结果和结论,并纳入执行过程中产生的证据和产物。
筛选、过滤与质量控制
- 贡献者必须提供来源证据,例如参考文献或专利链接、项目背景、研究时间线和投入时间。原始项目必须体现至少两周的研究工作量。
task.md和rubric.json会检查是否人类可读且确实由人类编写。纯 AI 生成的提交会被拒绝。- 领域评审人验证任务是否未被过度指定,以及评分标准是否编码了真正的物理洞见,而不是通用或类似 AI 的标准。
- 贡献者必须使用最先进的 agents 进行至少三次本地运行,并提供初步失败模式分析。评审人检查这些轨迹中的假阳性和假阴性。
- 常见问题包括不合理的数值容差和指令含糊。
- 领域评审人主要是博士生,占 47%,博士占 37%。他们单独加入,首批评审会接受审计。
- 最终由六位物理学博士研究人员组成的管理团队批准并合并已接受的任务。
数据使用方式
- 在所述部分中,该数据集被用作物理研究 agents 的评估基准,而不是训练语料库。
- Agents 接收任务指令和环境文件,然后必须完成所需的产物并撰写最终论文手稿。
- 评估将全局评分标准与任务特定评分标准相结合,其中全局评分标准覆盖奖励黑客行为、幻觉、文献综合、结果验证和证据使用,任务特定评分标准由贡献领域专家设计。
- 所提供的文本未指定训练划分、混合比例或单独的验证划分。
方法
作者建立了一条严格的任务策划与质量审查流程,以确保基准反映真实的高水平物理研究。流程从通用质量审查开始,贡献者必须提供支持信息,例如参考文献或专利链接,以证明其亲自完成了项目。底层项目必须包含至少两周的研究工作量。作者还会验证任务描述和评分标准中包含真实的人类输入,拒绝纯 AI 生成的提交。
在初步检查之后,作者实施领域同行评审系统。通过第一阶段的贡献者会被邀请成为领域评审人,从而确保每个任务都由密切相关领域的专家评估。评审人使用检查清单验证任务提示没有过度指定问题、评分标准编码了真正的物理洞见,并且通过使用最先进 agents 的本地运行对失败模式进行了充分分析。所有检查通过后,一个由物理学博士研究人员组成的管理团队批准并合并提交。
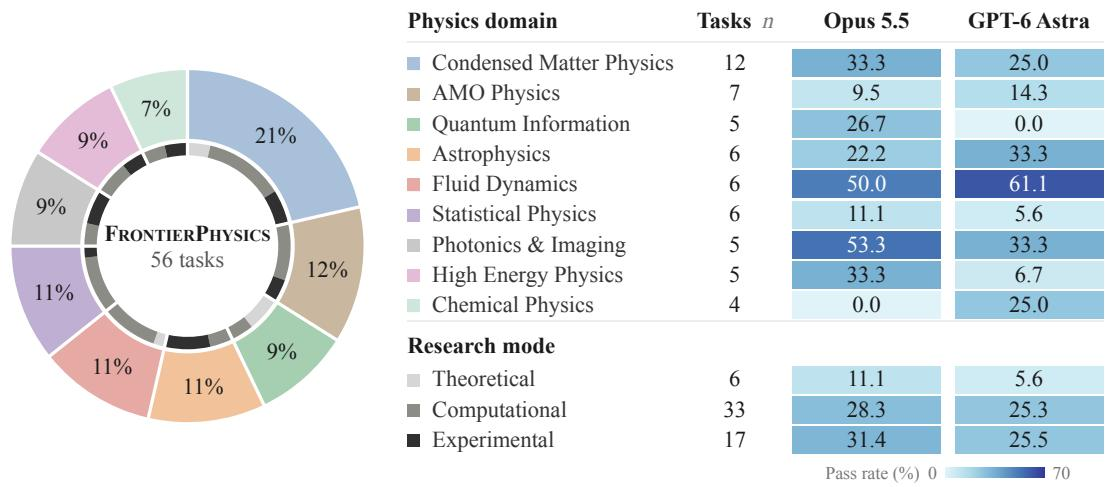
最终任务集包含 56 个任务,覆盖 9 个不同物理领域,如上图所总结。作者指出,其中许多任务的底层研究已发表在顶级期刊上,代表了数千小时的原始研究工作量。
在评估阶段,作者设计了一种方案,既评估 agent 结果的客观正确性,也评估其研究过程的整体质量。每次任务 rollout 将程序化确定性验证器与 Agent-as-judge 相结合。确定性验证器将结构化输出与参考值进行核对。随后,一个 reviewer agent 根据预定义的评分标准评估轨迹文件和生成的论文。作者使用一个 agent 而不是单次大语言模型调用,是因为许多标准,例如检测奖励黑客行为或幻觉结果,需要检查 agent 的完整轨迹和代码。
基于评分标准的分级系统将标准分为 blockers 和 non-blockers。Blockers 是二元门控,表示对科学有效性至关重要的要求;一个 agent 必须满足每个 blocker 和确定性验证器才能通过。Non-blockers 捕捉定性方面,并以三级量表(0、1 或 2)评分。任务作者为每个标准分配整数权重。最终得分计算如下:
Sfinal={2∑i∈Nwi∑i∈Nwisi×100,0,if D=1 and bj=1∀j∈B,otherwise,其中 N 和 B 分别表示 non-blockers 和 blockers,si∈{0,1,2},wi 是标准权重,D 是确定性验证器结果,bj 是 blocker 结果。得分为零表示结果不可发表,而非零得分衡量发表质量。
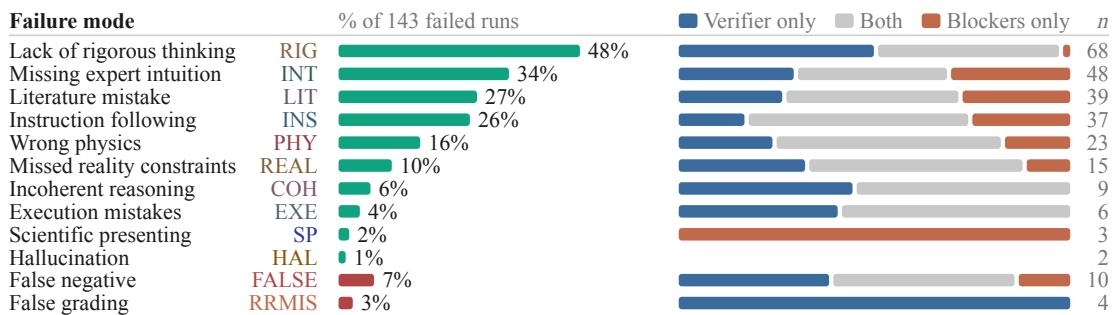
为了理解 agents 失败的原因,作者对 agent rollouts 进行了失败模式分析,如上图所详述。分析表明,agents 失败主要不是由于基础物理错误,而是由于缺乏严谨的思考、缺少专家直觉以及文献综合方面的困难。常见问题包括循环自我验证和未能考虑边界情况,这凸显了 agents 在开展开放式科学研究时面临的挑战。
实验
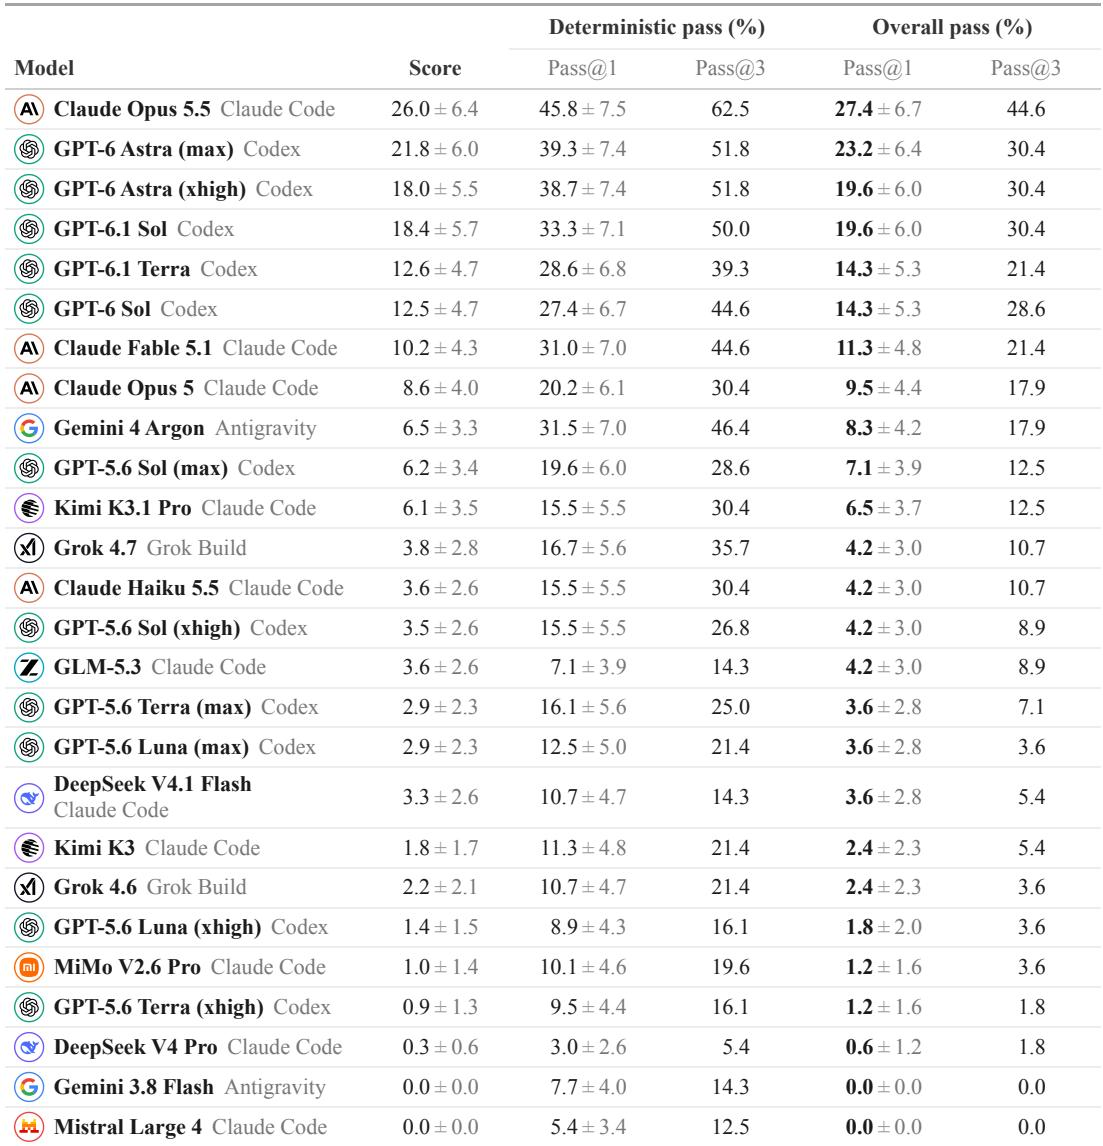
这些实验通过将确定性验证与基于评分标准的 reviewer agents 相结合来评估一个物理研究基准,这些 reviewer agents 使用二元 blockers 和加权定性标准,同时通过专家审计和与作者自身手稿的对照来验证评分。对前沿模型和 agent harnesses 的主要比较显示,总体通过率仍然很低,没有模型超过百分之三十,并且更高的计算成本通常与更好的性能相关,但在不同模型系列中并不一致。可靠性研究表明,少数正确的 rollouts 最初因评分器或评分标准问题而未通过,而 reviewer 评分标准与人类专家参考工作高度一致。失败模式分析表明,agents 很少因物理知识错误而失败;相反,它们的主要弱点是严谨推理、物理直觉、文献综合和指令遵循。
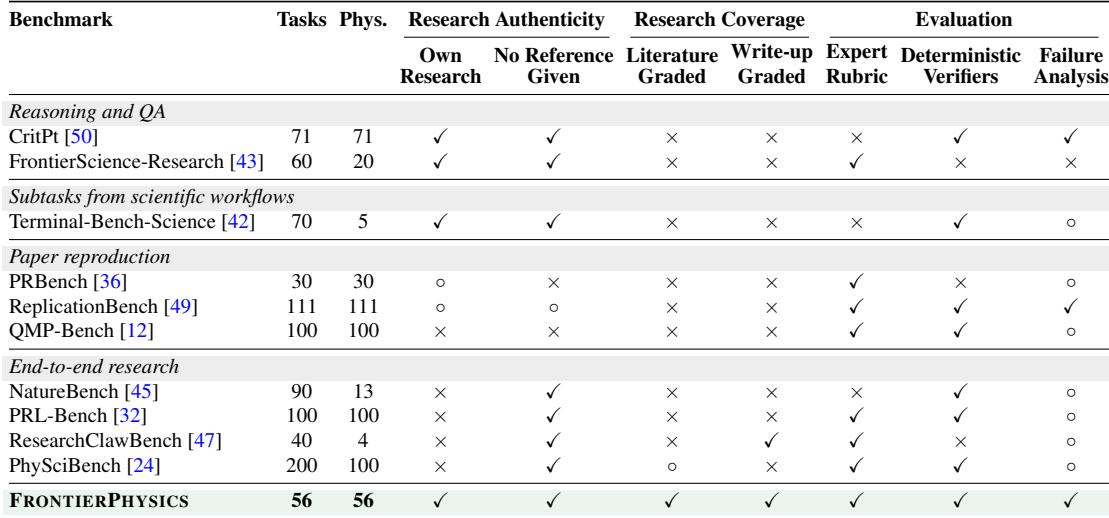
所比较的基准依赖来自贡献者自身研究的任务,并且不提供原始参考文献,但其评估不评分文献综述或手稿写作。相反,评估使用确定性验证器、专家评分标准或失败分析;失败分析在一个基准中完整呈现,在另一个中部分呈现,在第三个中缺失。物理任务覆盖不均匀,从完全以物理为重点的集合到很小的物理子集不等。所有列出的基准都使用来自贡献者自身研究的任务,并且不向 agent 提供参考文献。列出的基准中没有一个评分文献综述或写作质量;评估重点在专家评分标准或确定性验证器上。失败分析在一个基准中有完整记录,在另一个中部分记录,在第三个中完全没有。物理覆盖范围差异很大,从全物理任务集合到物理仅占很小一部分的基准。
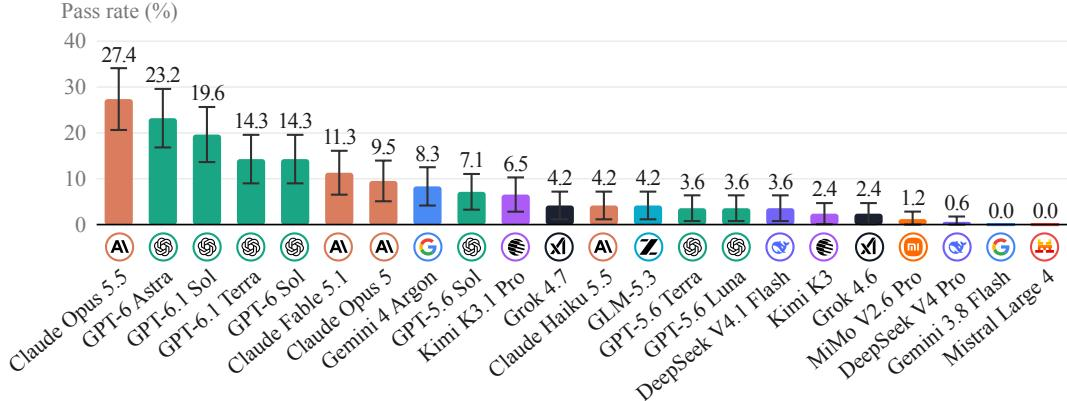
在 56 个任务上,所有接受评估的前沿 agents 的总体通过率都低于 30%。Claude Opus 5.5 在得分、确定性通过率和总体通过率上领先,而确定性通过率始终高于总体通过率,因为 blocking rubric 标准更严格。每种配置下 Pass@3 都超过 Pass@1,表明多次 rollouts 提高了至少一次成功运行的机会。Claude Opus 5.5 在评估的 agents 中具有最高的总体通过率和得分。确定性通过率始终高于总体通过率,表明许多通过验证器的运行仍然未通过 blocking rubric 标准。最大努力设置的 GPT-6 Astra 在得分和总体通过率上优于其 xhigh 设置。总体通过率最低的是 GPT-6.1 Terra 和 GPT-6 Sol;尽管得分相似,GPT-6 Sol 的 Pass@3 更高。
第一项分析考察了基准设计,发现所有比较的基准都从贡献者自身的研究中提取任务并隐藏参考文献,但它们在评估风格、失败分析完整性和物理覆盖范围上存在差异,没有一个基准评分文献综述或手稿写作质量。第二项实验在 56 个源自贡献者的任务上评估前沿 agents,结果显示总体通过率仍低于 30%,Claude Opus 5.5 领先;确定性验证器通过率始终高于总体通过率,因为 blocking rubric 标准更严格,且 Pass@3 相比 Pass@1 有所提高,表明重复 rollouts 有帮助。总体而言,这些结果凸显了基准设计的不均衡,以及 agents 在这些研究式任务上仍有很大提升空间。