Command Palette
Search for a command to run...
LONGBANANA:面向长上下文多参考图像合成的专家验证基准
LONGBANANA:面向长上下文多参考图像合成的专家验证基准
摘要
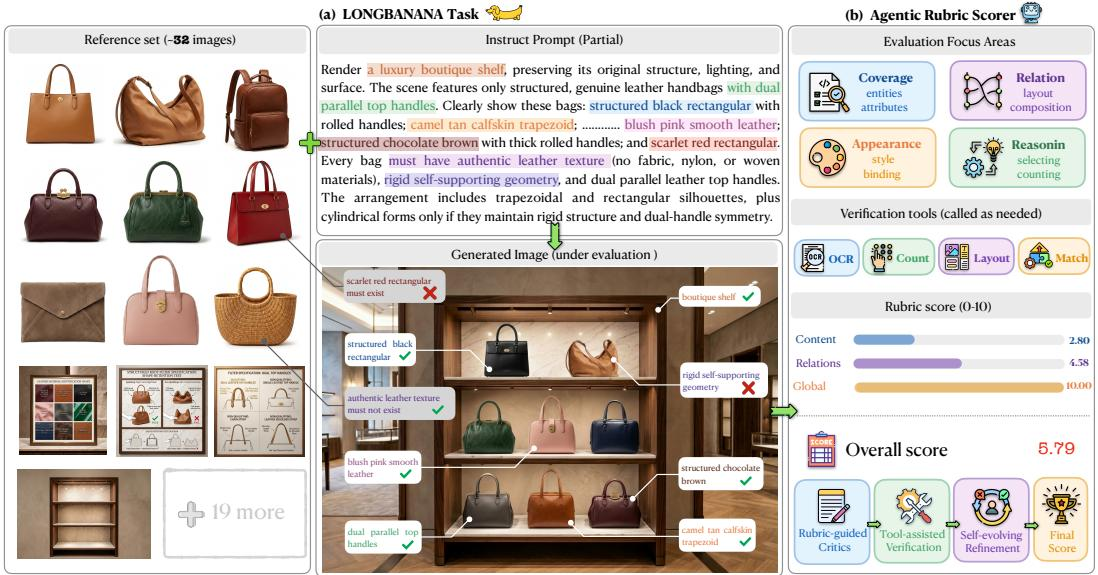
我们提出了 LONGBANANA;据我们所知,这是智能体驱动图像生成时代中首个由专家设计并经专家验证的长上下文多参考图像合成基准。该任务要求检索分散的视觉证据、排除干扰项、绑定实体与关系,并从多个参考图像合成一幅连贯的最终图像。LONGBANANA 包含 90 个精心设计的任务,按 3×3 分类体系组织;每个任务包含约 32 张参考图像、20 项约束和 50 个评价条目,总计产生 4,670 个由专家指定的原子评价条目。其基于图的评估设计将每个任务实例化为参考图像和实体–关系图,随后将节点、边和全图义务转换为检查清单条目,用于内容保真度(Content Fidelity)、关系绑定(Relational Binding)和全局约束满足性(Global Constraint Satisfaction)。经审核的专家标注包含一个 15% 的双标注子集,其完全一致率为 89.4%,二次加权 kappa 为 0.83。我们还提出了 LONGBANANA-Gen,一个面向长程图像生成的智能体编排框架;实验表明,最小化的智能体编排机制相较于直接生成有所提升,而 ReAct–Plan–Exec–Reflect(RPR)工作流通过加强证据锚定与修复带来了依赖编排机制的增益。总体而言,LONGBANANA 为衡量密集视觉证据利用提供了一个可审计的测试平台,也为开发更强的智能体驱动图像生成系统提供了共同目标。代码和数据可在项目页面获取:https://long-banana.com/。
一句话总结
来自华南师范大学、不列颠哥伦比亚大学等机构的研究人员提出 LONGBANANA,这是首个由专家设计并经专家验证的面向长上下文多参考图像合成的基准,包含 90 个任务,按 3×3 分类法组织,每个任务约有 32 张参考图像、20 条约束和 50 个评估项,共产生 4,670 个专家指定的原子评估项;该基准采用基于图的评估,将节点、边和全图义务转换为内容保真度、关系绑定和全局约束满足的清单项,在 15% 的双重标注子集上,经审核标签的完全一致率为 89.4%,二次加权 kappa 为 0.83;同时提出 LONGBANANA-Gen,这是一个 agent-harness 框架,其中最小 agent 框架相比直接生成有所提升,而 ReAct–Plan–Exec–Reflect (RPR) 工作流通过加强证据定位与修复带来依赖框架的收益,为 agent 驱动的图像生成系统提供可审计的测试平台和共同目标;代码和数据可在 https://long-banana.com/ 获取。
核心贡献
- 提出 LONGBANANA-Bench,这是第一个面向长上下文多参考图像合成的专家设计并经专家验证的基准,包含 90 个任务,覆盖 3×3 分类法,每个任务约 32 张参考图像和 20 条约束,共 4,670 个专家指定的原子评估项。
- 提出 LONGBANANA-Eval,一种基于图的清单评估流程,将实体关系图映射到针对内容保真度、关系绑定和全局约束满足的原子清单项,并将各项目路由到受评分标准引导的评估器和确定性工具;该流程在双重标注子集上与专家标签进行验证,完全一致率为 89.4%,二次加权 kappa 为 0.83。
- 提出 LONGBANANA-Gen,一种用于长周期图像生成的 agent-harness 框架,并表明最小 agent 框架相比直接生成有所提升,而 ReAct-Plan-Exec-Reflect 工作流通过加强证据定位与修复,带来依赖框架的收益。
引言
作者研究的是长上下文、多参考图像合成问题,即模型必须依据分布在大量参考图像和指令中的证据来生成图像。这一问题值得关注,因为即使输出看起来逼真,如果模型选错参考、从干扰项复制外观、将属性或关系绑定到错误实体,或添加了未经支持的内容,结果仍可能是错误的。已有基准覆盖了图像编辑、个性化、提示遵循以及部分基于参考的合成,但它们对密集证据使用的规范不足,并且通常依赖整体评分,而不是定位来源错误。为了弥补这一差距,作者提出 LONGBANANA-Bench 和 LONGBANANA-Eval,将每个任务建模为实体关系图,并围绕内容保真度、关系绑定和全局约束满足对原子清单项进行评分。
数据集
作者将 LONGBANANA 用作长周期多参考图像合成的评估基准,而非训练集。生成系统接收一组异构参考集和一条结构化指令,然后必须生成一张满足该案例实体关系图的连贯图像。
数据集组成与规模
- 总计 90 个案例。
- 在 3×3 分类法的每个子类中有 10 个案例。
- 每个典型案例约 32 张参考图像。
- 每个典型案例有超过 20 条跨参考约束。
- 整个基准中共有 4,670 个原子清单项。
子集与任务分类法
- 场景构图:测试语义覆盖、关系图一致性和布局安排。
- 视觉外观:测试全局外观条件化、局部外观绑定和外观协调。
- 参考推理:测试选择与检索、时间/状态推理以及计数/聚合。
来源与参考构建
- 专家作者基于故事板、产品和场景构图用例来设计场景。
- 一个 LLM 将每个场景结构化为实体关系图。
- 参考图像包括实体参考、外观参考和可选背景参考。
- 至少有 30 个案例包含两个或更多硬负参考,这些参考在视觉上看似合理,但与要求的输出无关。
图、元数据与清单构建
- 图节点表示实体和属性。
- 图边编码空间关系、交互以及局部外观绑定,例如纹理、材质、颜色、姿态或状态。
- 全图约束编码构图、布局、数量以及场景级要求。
- 清单项从节点级、边级和全图级的图约束中导出。
- 每个项目记录可观察条件、被评估的图单元、相关参考图像和评分标准。
- 正项检查所需条件;负项检查干扰内容或未经支持的内容是否不存在。
- 人工审核者会一起审核指令、参考图像和清单。他们会拒绝或修订无法判断的要求,并检查参考密度、约束覆盖以及歧义或重复项目。
- 所提供的文本未报告具体的图像裁剪策略。
基准的使用方式
- LONGBANANA 用于评估图像生成系统。
- 正确性通过由图导出的清单来衡量,而不是通过单一的整体质量评分。
- 由于每个清单项都与一个图单元绑定,失败可以被定位到具体内容、关系或场景级义务。
- 没有报告训练划分或混合比例,因为 LONGBANANA 被设计为评估基准。
方法
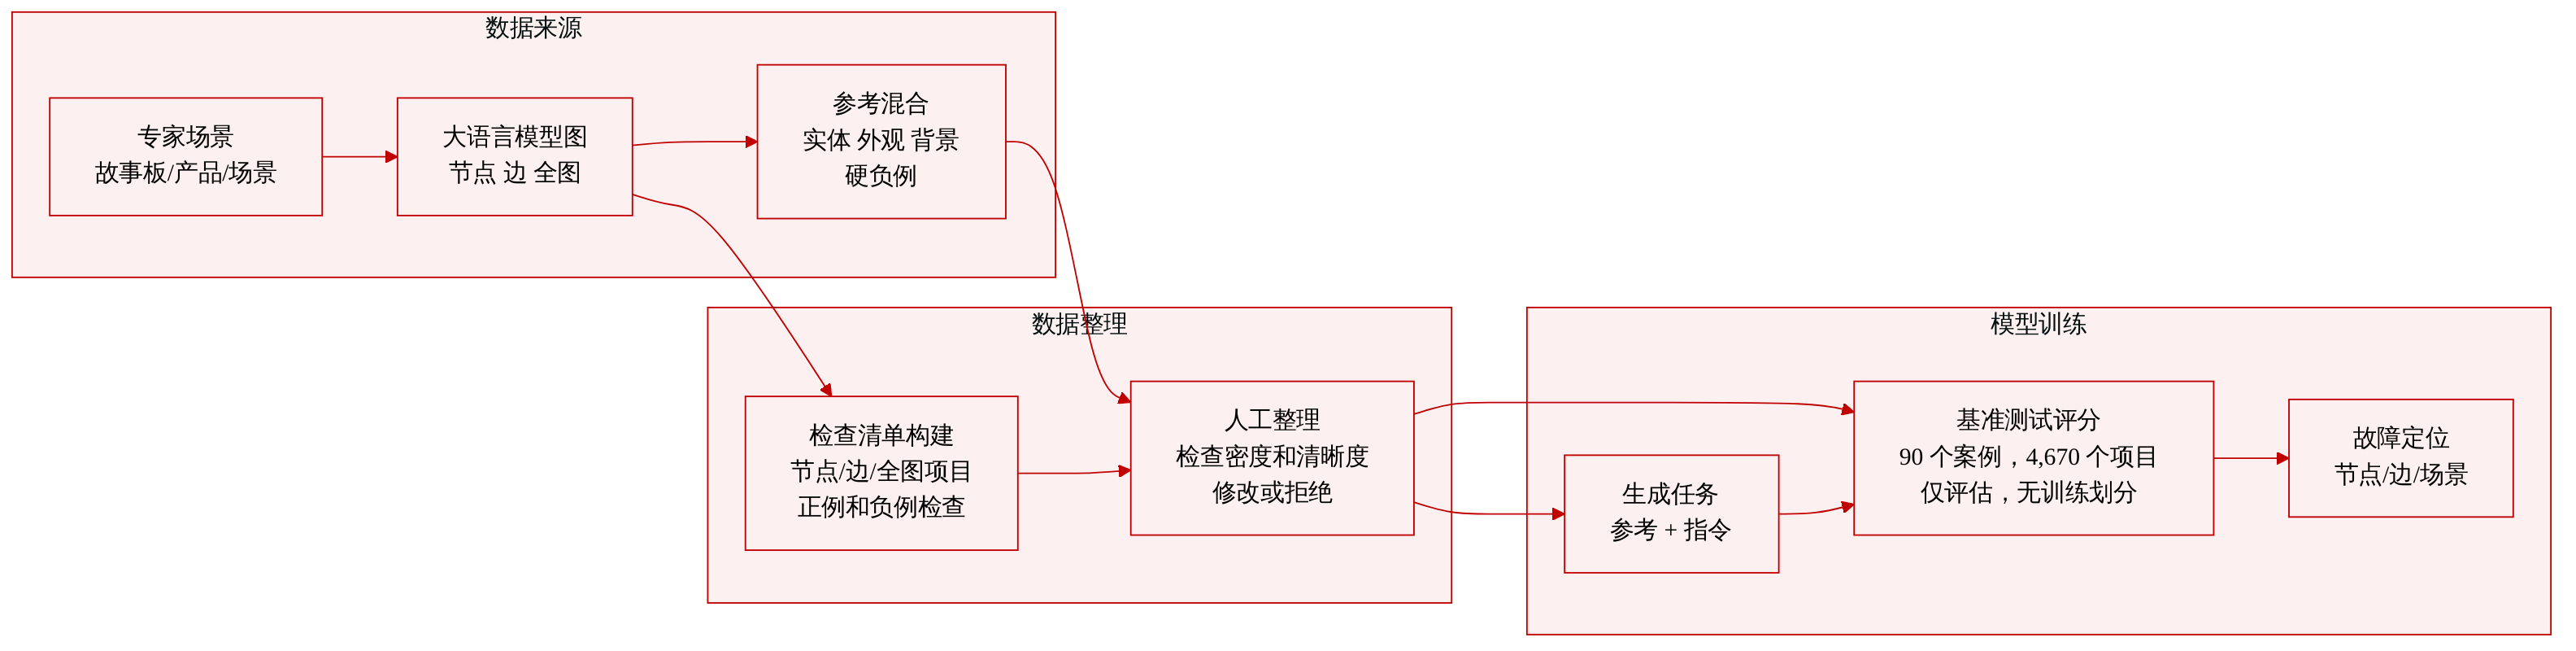
作者围绕一个共享的实体关系图构建每个案例,该图将合成指令、参考图像和评估清单连接起来。构建流程从场景描述开始,到结构化约束,再到视觉参考和指令,最后到用于评估的清单,如下图所示:
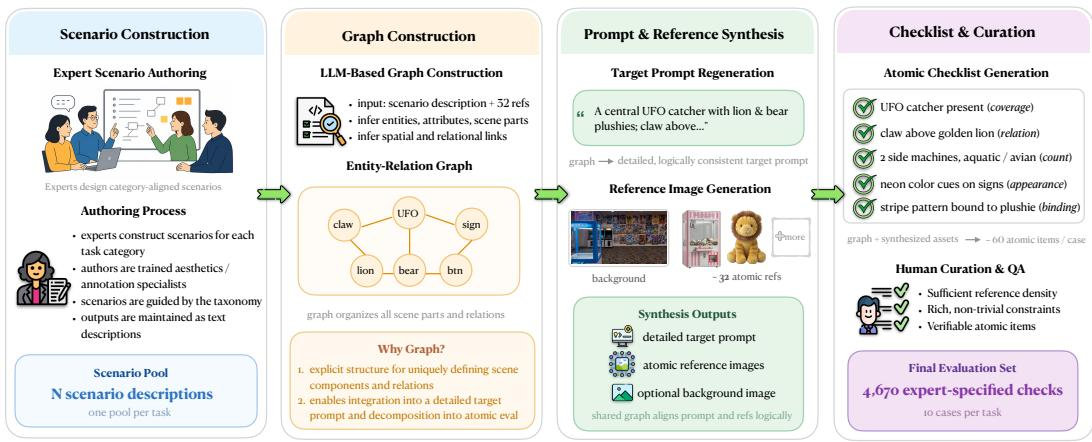
专家作者首先设计与任务分类法一致的场景,明确最终图像应描绘的内容,以及必须保留哪些实体、视觉属性和交互。随后,一个 LLM 将场景结构化为实体关系图。节点表示实体及其属性,边编码空间关系、交互和局部外观绑定,全图约束则规定构图和数量等要求。这种表示使依赖关系变得明确,为任务合成和清单推导提供了指导。
随后,图指导目标指令和参考图像的创建,包括实体参考、外观参考和可选背景参考。指令表达所要求的构图和关系,而参考图像提供视觉身份、局部细节和外观线索。判别性视觉属性保留在参考图像中,并尽可能从文本中省略。为评估干扰项泄漏,至少有 30 个案例包含视觉上看似合理但与所需输出无关的硬负参考。
接着,图约束被转换为原子清单项。节点级项目检查所需实体和属性,边级项目检查关系和外观绑定,全图项目检查布局和数量等场景级要求。每个项目记录可观察条件、被评估的图单元、相关参考图像和评分标准。正项测试所需条件是否满足,负项检查干扰内容是否不存在。人工审核者会一起审核指令、参考图像和清单,以确保在收录前与任务图一致、视觉上可行且可验证。
在评估方面,作者提出 LONGBANANA-Eval,它根据由图导出的清单评估生成图像。agentic 清单评审器会准备针对具体项目的参考证据,将每项检查路由到对应维度的评估器,并将判断结果合并为维度级分数和总体分数,如下图所示:
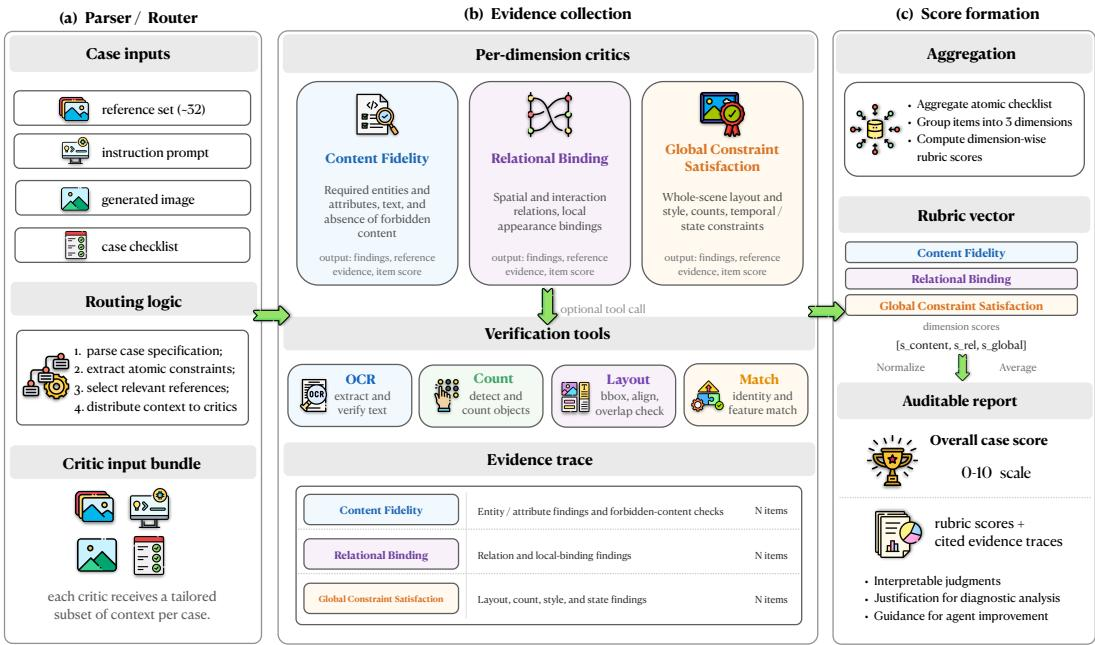
评估流程从解析器开始,解析器读取需要验证的条件、其评分维度、参考标识符和评分标准。它将生成图像和相关参考图像组装成一个证据包,并可选择进行裁剪以定位被检查区域。负面内容检查还会接收适用硬负参考的标识符和角色。路由器将证据包分配给与该项目的评分维度相对应的评估器。
三个面向不同维度的评估器执行检查。内容保真度评估器检查所需实体、属性和文本,以及禁用内容是否不存在。关系绑定评估器检查空间关系和交互关系,以及局部外观线索的分配。全局约束满足评估器检查场景级要求,包括布局、全局风格、数量以及时间或状态约束。每个评估器将输出与项目的参考证据进行比较,并可调用验证工具,例如用于可读文本的 OCR、用于多重性的检测或计数、用于空间约束的布局例程,以及用于一致性的身份或特征匹配。
每项检查产生一个标签 sj∈{0,1,2},其中 2 表示要求已满足,1 表示部分满足或证据不确定,0 表示要求未满足。对于负项,完全没有禁用内容得 2,出现不明确的泄漏得 1,明显错误地出现得 0。证据轨迹将标签与相关参考、评估器发现和工具观察结果关联起来。
最后,对分数进行聚合。对于具有 N 个清单项的生成图像,总体分数是项目标签的平均值,并缩放到 0-10 区间。维度分数对分配给维度 d 的项目集合 Jd 应用相同计算:
Soverall=N5j=1∑Nsj,Sd=∣Jd∣5j∈Jd∑sj.维度分数提供诊断性画像,而总体分数总结整个清单。
实验
实验使用 LONGBANANA 评估长周期多参考图像合成,该基准包含 90 个案例和图导出的清单,并首先在 900 个输出上将 agentic 清单评审器与经过审核的人工标签进行验证。与单遍 VLM 评审器相比,agentic 评审器能更好地跟踪专家分数和项目级决策。生成结果表明,注入图信息的直接基线具有竞争力,但自适应 agentic 工作流带来更广泛的提升,其中检索、规划和反思的组合产生最强的总体配置,而 Nano Banana 2 在图像后端中领先。这些发现表明,静态任务结构有帮助,而检查中间图像和修正证据使用对于可靠的参考引导合成至关重要。
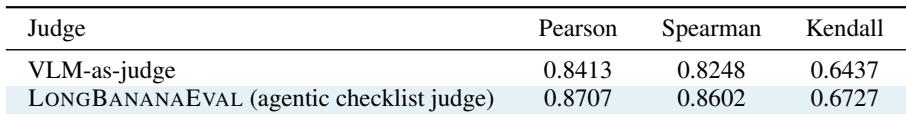
在完全覆盖的审计池上,agentic 清单评审器与经过审核的人工总体分数的一致性高于单遍 VLM 作为评审器。它改善了所有报告的输出级相关性指标,并加强了项目级决策。这些结果支持将其用于机器评分评估和诊断报告。agentic 清单评审器在与经过审核的人工总体分数的 Pearson、Spearman 和 Kendall 相关性上均优于单遍 VLM 作为评审器。项目级一致性也有所提高,与基线评审器相比,精确三值一致率更高,反向端错误更少。
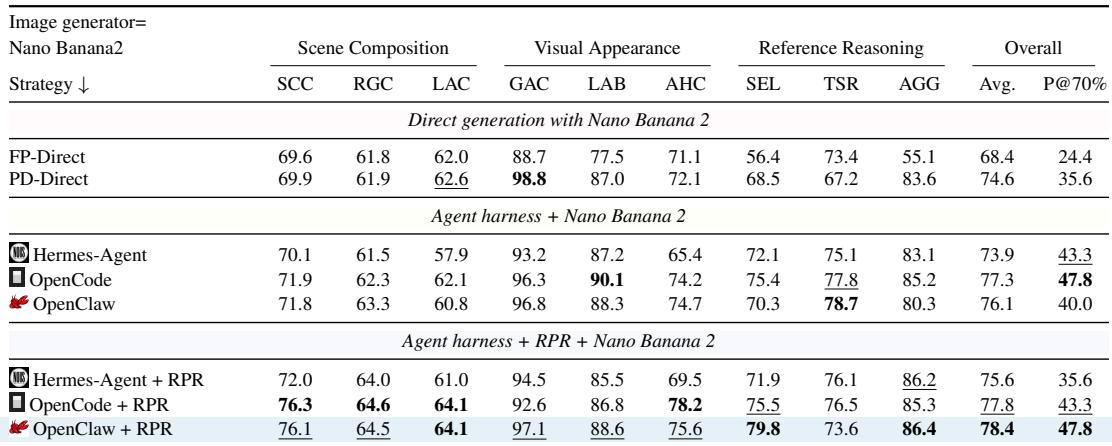
在固定 Nano Banana 2 的情况下,PD-Direct 是一个很强的非 agentic 基线,在总体平均分和大多数子类上优于 FP-Direct,并在参与比较的系统中取得最佳的全局外观条件化和第二好的布局安排一致性。agentic 工作流在总体平均分上通常超过 PD-Direct,而 OpenClaw + RPR 在九个子类中的八个上更强,具有最高的总体平均分和并列最佳的任务通过率。RPR 也提高了 OpenCode 和 Hermes-Agent 的平均分,但它们的任务通过率有所下降。PD-Direct 在总体平均分和大多数子类上显著优于 FP-Direct,并在所有比较系统中具有最佳的全局外观条件化和第二好的布局安排一致性。OpenClaw + RPR 在九个子类中的八个上超过 PD-Direct,在总体平均分和并列最佳任务通过率方面领先于其他 agentic 配置。RPR 在场景构图、参考选择和聚合方面为 OpenClaw 带来最明显提升,而最小 OpenClaw 框架在时间和状态推理上仍然更强。OpenCode 和 Hermes-Agent 在使用 RPR 后平均分提高,但任务通过率降低。
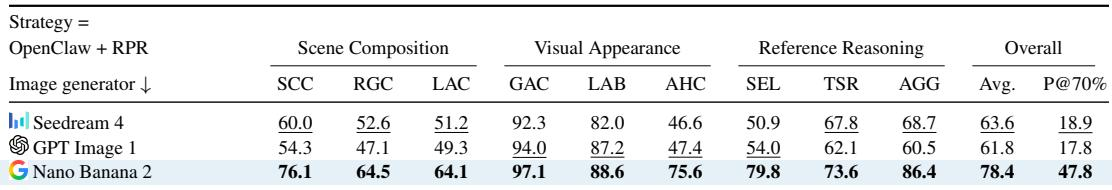
在固定 OpenClaw + RPR 工作流的情况下,Nano Banana 2 是 LONGBANANA 基准上最强的图像后端,在总体平均分、任务通过率以及每个报告的子类指标上均取得最佳结果。Seedream 4 和 GPT Image 1 在总体分数和任务通过率上明显更低,它们表现出不同的次要优势,但都未能接近领先模型的覆盖广度。Nano Banana 2 在所有报告指标上领先,包括场景构图、视觉外观、参考推理、总体平均分和任务通过率。Seedream 4 和 GPT Image 1 彼此表现更接近,GPT Image 1 在全局外观上相对更强,而 Seedream 4 在时间状态推理和聚合上相对更强。图像后端选择在任务通过率上造成很大差距,在相同工作流下,Nano Banana 2 远远领先于两个替代后端。
实验评估了评估与生成流程的三个组成部分。首先,与单遍 VLM 作为评审器相比,agentic 清单评审器与经过审核的人工分数一致性更高,同时改善了输出级相关性和项目级一致性。其次,在固定 Nano Banana 2 图像后端的情况下,agentic 工作流通常优于很强的非 agentic PD-Direct 基线,而采用 RPR 的 OpenClaw 取得最佳总体平均分和任务通过率,同时 RPR 也提高了其他 agent 的平均分,尽管任务通过率较低。第三,在固定 OpenClaw 加 RPR 工作流的情况下,Nano Banana 2 在所有指标上都是最强的图像后端,远远领先于 Seedream 4 和 GPT Image 1,后两者表现出不同的次要优势,但总体性能较低。