Command Palette
Search for a command to run...
轮次至关重要:通过轮次级信用分配推进流式视频强化学习
轮次至关重要:通过轮次级信用分配推进流式视频强化学习
摘要
流式视频理解要求模型反复决定是作出响应还是继续观察。近期,分组相对策略优化(GRPO)已被应用于该场景,现有方法强调奖励设计,但仍在各轮次之间保留单一的轨迹级优势。这种共享信用可能在先前成功之后强化冗余回复,并在先前失败之后抑制有用的后续响应。我们提出 TurnWise,一个轮次级 GRPO 框架,将学习与每个流式决策对齐。TurnWise 解决了轨迹级反馈与轮次级交互之间的错配,促进信息性响应并减少冗余。具体而言,轮次级信用分配使用静默完成前缀评分,从每个决策的剩余回报中构造组相对优势,将其学习信号与先前奖励分离。Turn-mean 策略优化先对每个轮次内的 token 损失取平均,再跨轮次取平均,使响应决策和等待决策无论输出长度如何都具有相等权重。这些互补设计在无需学习到的 critic 或额外 rollout 的情况下改善了流式策略学习。大量实验表明,我们的方法在流式视频理解上优于先前 RL 方法。
一句话总结
来自复旦大学、上海创新研究院、京东等机构的研究者提出 TurnWise,一种用于流式视频理解的 turn 级 GRPO 框架,结合用于信用分配的静默补全前缀评分与 turn 均值策略优化,将每个决策的学习信号与早期奖励分离,促进有信息量的响应,减少冗余,并在无需学习型 critic 或额外 rollout 的情况下优于现有强化学习方法。
核心贡献
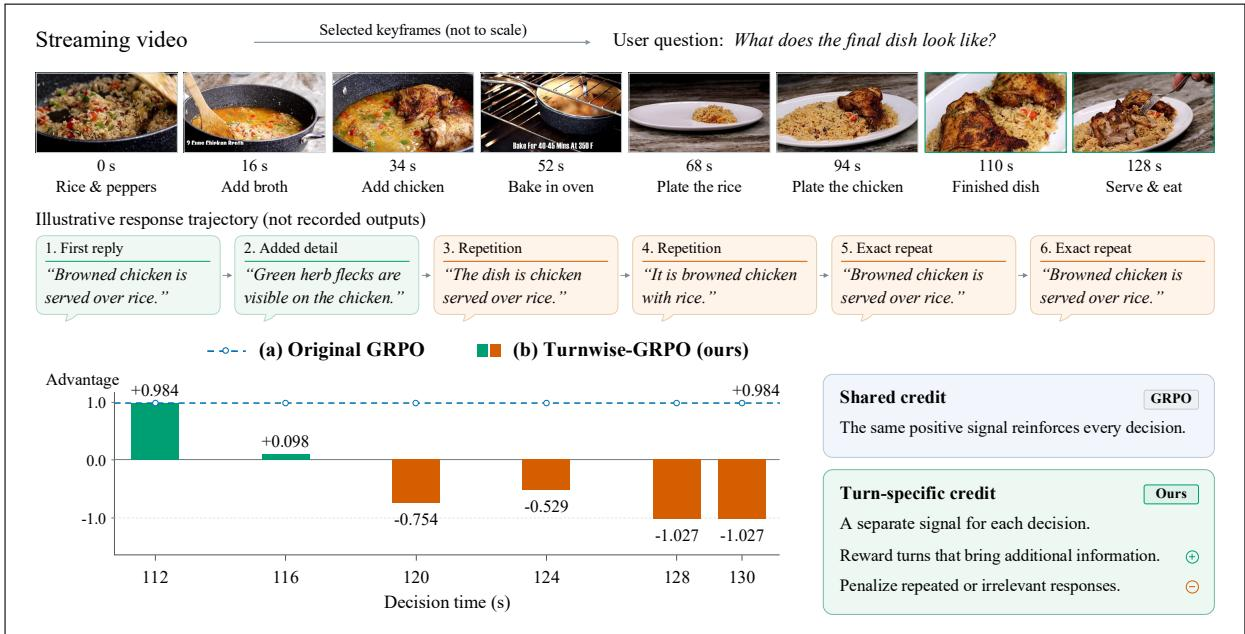
- 本文指出流式视频强化学习中的粒度不匹配问题:共享轨迹优势可能掩盖后续决策的价值,而 token 均值损失聚合使 turn 权重依赖响应长度。
- TurnWise 将用于 turn 特定剩余回报优势的静默补全前缀评分与 turn 均值损失聚合相结合,无需学习型 critic 或额外 rollout。
- TurnWise 在两个 Qwen 主干网络上均取得 ProactiveVQA、OVO-Timing 和 StreamingBench 的最佳综合分数,并且相对于仅信用分配优化,turn 均值聚合改善了响应时机并减少了重复。
引言
流式视频理解要求模型在观测仍不断到达时决定是回答还是继续观察,因此每次响应或等待的价值既依赖于当前证据,也依赖于先前的交互。先前基于 GRPO 等强化学习方法使用轨迹级奖励和共享优势,可能给冗余的后续回复分配正向信用,或在早期错误后给有用的补充回复分配负向信用;token 均值聚合进一步使 turn 权重依赖于响应长度。作者提出 TurnWise,一种 turn 级 GRPO 框架,对轨迹前缀进行评分并将所有剩余 turn 置为静默,将完整轨迹奖励转换为 turn 特定的剩余回报优势,并使用 turn 均值损失聚合来同等加权响应决策和等待决策。TurnWise 无需学习型 critic 或额外 rollout,并在 ProactiveVQA、OVO-Timing 和 StreamingBench 上以两个 Qwen 主干网络取得最佳综合结果。
方法
作者提出 TurnWise,一个旨在将策略优化与视频对话系统中的流式决策对齐的框架。TurnWise 通过两个耦合机制实现这一点:用于精确时间信用分配的组相对剩余回报优势,以及用于确保决策加权不受长度影响的 turn 均值策略优化。
如下图所示:
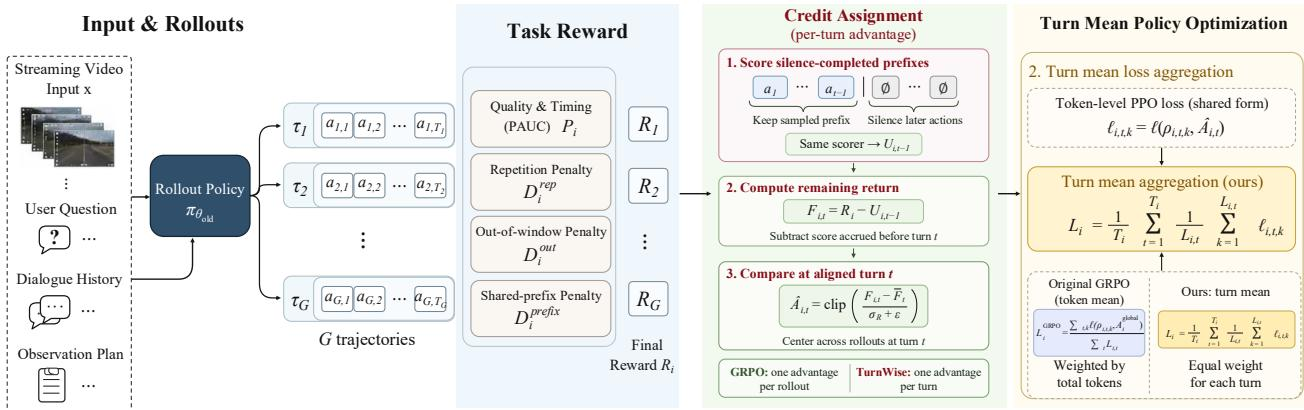
该框架处理一个流式实例,包括视频输入 x、用户查询、初始对话历史 h0 和观测计划。在每个决策 turn t,策略 πθ 生成文本响应或表示为 ∅ 的显式等待动作。为了学习这些序列决策,作者从 rollout 策略中采样 G 条轨迹 τi。每条完整轨迹使用基于 PAUC 的奖励 Ri 评估,该奖励衡量响应质量和及时性,同时惩罚重复、窗口外响应以及共享前缀违规。
标准 Group Relative Policy Optimization (GRPO) 将该轨迹分数转换为单一全局优势,无法区分在某个 turn 之前获得的奖励与之后获得的收益。为解决这一时间不匹配问题,TurnWise 在无需 critic 模型的情况下引入 turn 级信用分配。作者利用顺序观测流,对轨迹前缀在所有后续动作置为静默时所能取得的分数进行评分。具体而言,通过保留前 t 个采样动作并将后续动作替换为 ∅,计算静默补全前缀分数 Ui,t。turn 级奖励增量由剩余回报 Fi,t=Ri−Ui,t−1 导出,从而将早期累积奖励排除在当前决策的信用之外。这些剩余回报在每个 rollout 组内进行比较,以计算 turn 特定优势:
A^i,t=[σR+ϵFi,t−Fˉt]−amaxamax其中 Fˉt 是剩余回报的组内均值,σR 是终止奖励的标准差,运算符将归一化优势裁剪到 [−amax,amax]。为了在训练期间从共享信用平滑过渡到 turn 特定信用,插值参数 α 对累积奖励修正进行缩放,并在初始训练更新中从 0 线性增加到 1。
虽然 turn 级优势为各个决策分配信用,但标准 token 均值损失聚合仍按响应长度对这些决策加权,导致长响应压过短等待动作。作者提出 turn 均值策略优化,使每个流式决策无论输出长度如何都获得相等的聚合权重。他们使用裁剪概率比代理 ℓi,t,k(θ) 将修正后的组相对优势应用于其 turn 内的每个 token。最终轨迹损失先在每个 turn 内对 token 损失求平均,再对所有 turn 求平均:
Li(θ)=Ti1t=1∑TiLi,t1k=1∑Li,tℓi,t,k(θ)其中 Ti 是决策 turn 数,Li,t 是 turn t 生成的 token 数。
统一的 TurnWise 目标将 turn 特定剩余回报优势与长度无关的决策权重相结合。训练流程首先在多样化的视频指令示例语料上进行监督微调,并冻结视觉塔。随后进行 GRPO 风格强化学习优化,策略使用统一目标、turn 均值聚合以及由大型语言模型判定的基于 PAUC 的奖励进行更新。
实验
实验在流式指令数据上微调 Qwen2.5-VL-3B 和 Qwen3-VL-4B,然后使用基于 PAUC 的奖励进行 GRPO 风格强化学习优化,并在 ProactiveVQA、OVO-Timing 和 StreamingBench 上评估,以覆盖主动回答质量、事件触发时机和实时视觉理解。与 SFT 和 GRPO 基线相比,TurnWise 在两个主干网络的所有三个基准上均取得最佳综合分数。消融和轨迹分析表明,turn 级信用分配与 turn 均值聚合是互补的:信用分配提供不同的逐 turn 学习信号,包括针对冗余回复的负信号,而 turn 均值聚合对这些信号进行加权,从而产生更具选择性的响应、更高奖励、更低重复和更少窗口外回复。
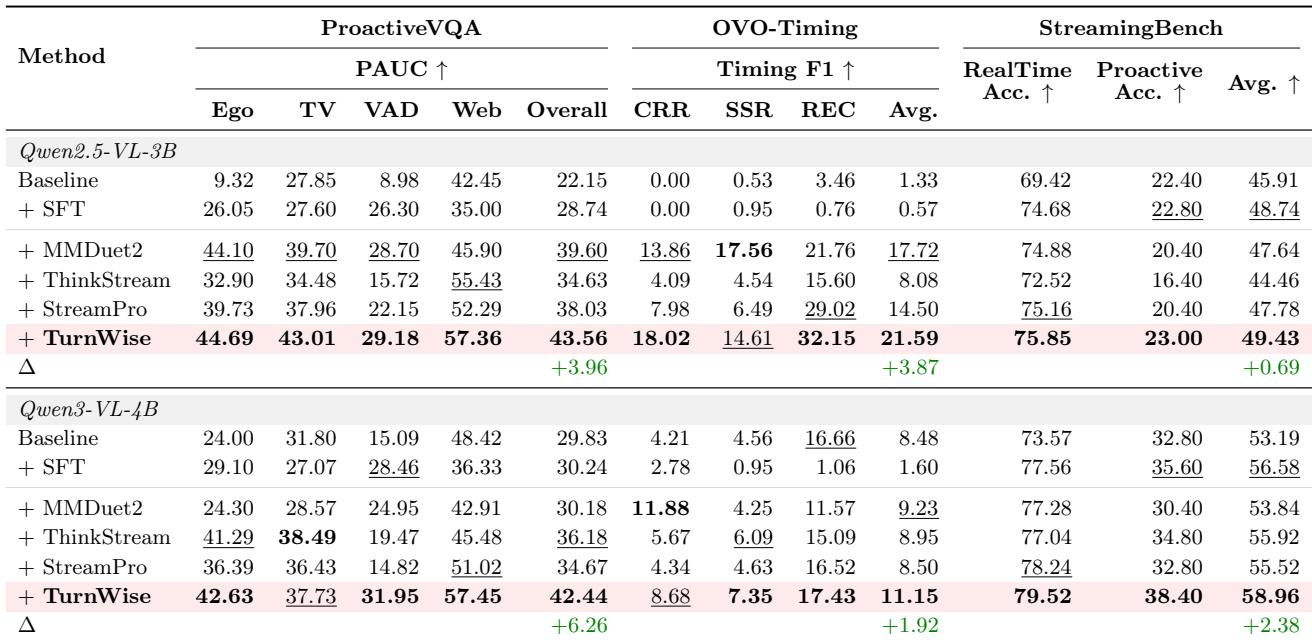
TurnWise 在两个测试主干网络上的 ProactiveVQA、OVO-Timing 和 StreamingBench 中均取得最佳综合结果。相对于最强的非 TurnWise 方法,其提升在主动交互、响应时机和实时视觉理解方面保持一致。各类别结果显示广泛优势,尤其在 ProactiveVQA 和 StreamingBench 上。TurnWise 在 Qwen2.5-VL-3B 和 Qwen3-VL-4B 的三个综合指标上均优于所有 SFT 和基于 GRPO 的强化学习基线。在 ProactiveVQA 上,TurnWise 使用 3B 主干网络在全部四个类别中领先,使用 4B 主干网络在四分之三类别中领先,其中 4B 模型在 VAD 和 Web 上提升明显。TurnWise 在两个主干网络上的 StreamingBench 中取得最高的实时准确率和主动准确率,将 4B 主动准确率从 35.60 提升到 38.40,相对于最强基线。
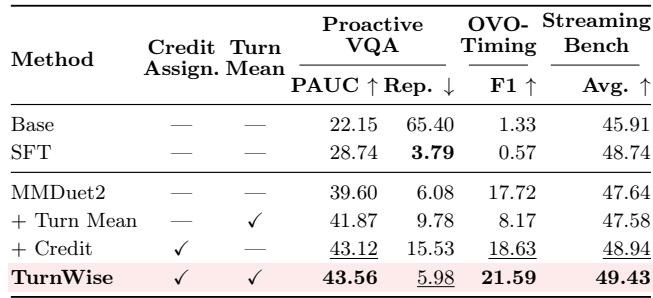
在 Qwen2.5-VL-3B 上,将 turn 级信用与 turn 均值聚合结合,在所有评估配置中取得最高的 ProactiveVQA、OVO-Timing 和 StreamingBench 分数。与仅信用分配和仅聚合变体相比,该组合改善了 Timing F1 和任务准确率,同时大幅减少重复。turn 级信用设定每个决策的学习方向,而 turn 均值聚合控制其策略更新权重,使完整配置强于任一单独组件。在仅信用分配优化中加入 turn 均值聚合可大幅减少重复,同时改善 Timing F1 和 StreamingBench 平均准确率。相对于仅 turn 均值聚合,加入 turn 级信用可大幅改善 Timing F1 并进一步减少重复。完整 TurnWise 配置在组件比较中取得最高的 ProactiveVQA PAUC、OVO-Timing F1 和 StreamingBench 平均准确率。
在 turn 均值聚合下,完整修正设置在 Qwen2.5-VL-3B 上测试的修正强度中取得最佳结果。它在 ProactiveVQA PAUC、OVO-Timing F1、StreamingBench 准确率和重复率上均排名第一。这支持将完整累积奖励修正作为该框架的工作点。当使用 turn 均值聚合时,完整修正在所有四个评估指标上均优于部分修正强度。在该配置下,较低修正强度在任何指标上均未超过完整修正。完整累积奖励修正被确定为首选工作点。
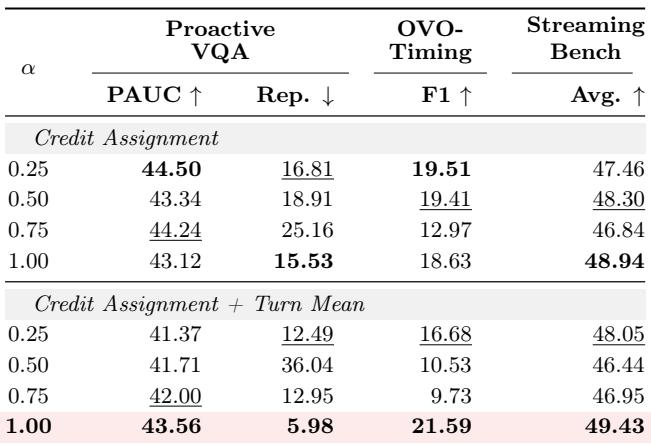
实验使用 Qwen2.5-VL-3B 和 Qwen3-VL-4B,在 ProactiveVQA、OVO-Timing 和 StreamingBench 上将 TurnWise 与 SFT 和基于 GRPO 的强化学习基线进行比较,覆盖主动交互、响应时机和实时视觉理解。TurnWise 在两个主干网络下均取得最佳综合结果,并显示广泛的逐类别提升。消融表明,将 turn 级信用与 turn 均值聚合结合可取得最高分数,同时大幅减少重复;修正强度实验确定完整累积奖励修正为首选工作点。