Command Palette
Search for a command to run...
多轮强化学习究竟提升了 LLM 智能体的哪些能力?
多轮强化学习究竟提升了 LLM 智能体的哪些能力?
Kejian Zhu Zhuoran Jin Shangqing Tu Tianyi Men Yupu Hao Jiachun Li Kang Liu Jun Zhao
摘要
尽管多轮智能体强化学习(RL)在长时程任务上表现优异,但其性能增益仍对交互约束高度敏感。通过在采样广度 K 和交互深度 T 上以 Pass@(K,T) 进行评估,我们表明轨迹级 RL 的优势依赖于足够的轮次预算,当预算收紧时优势会显著减弱。此外,智能体 RL 并不会均匀提升单步决策质量;其优势主要集中在错误恢复和长时程韧性上。为降低这种预算依赖性带来的部署风险,我们对过程监督信号的收益与局限进行了初步讨论,并提出 BudgetMix RL 作为替代方案,在训练期间改变交互预算。实验表明,BudgetMix RL 在多种执行设置下均能取得稳健性能。
一句话总结
来自中国科学院自动化研究所、中国科学院大学和清华大学的研究人员使用 Pass@(K,T) 表明,多轮 agentic RL 的收益依赖于足够的交互预算,并且主要增强错误恢复和长程韧性,而不是单步决策质量;他们还提出了 BudgetMix RL,该方法在训练期间改变交互预算,从而在不同的执行设置下实现稳健性能。
核心贡献
- 论文使用跨采样广度 K 和交互深度 T 的 Pass@(K,T) 评估,表明轨迹级多轮 RL 的收益依赖于足够的轮次预算,并在预算收紧时显著下降。
- 分析表明,这些收益主要来自长程执行和错误恢复,而非始终更强的单步决策,并且发现多轮 RL 下单步动作质量可能下降。
- 论文提出了 BudgetMix RL,一种在训练期间改变交互预算的训练策略;实验表明,它提高了不同执行设置下的鲁棒性,同时缓解了单步动作质量的下降。
引言
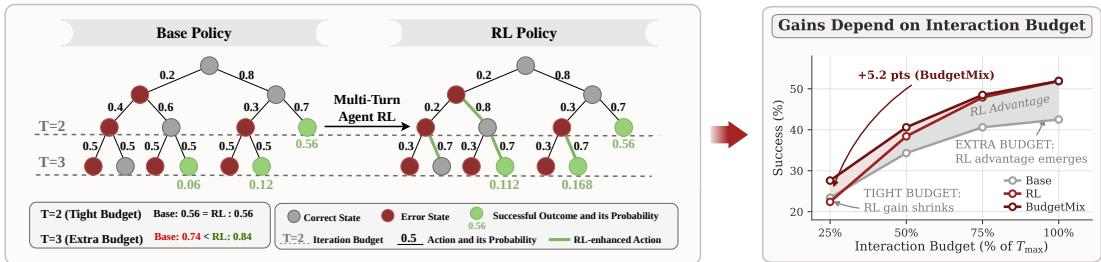
多轮 agentic 强化学习已成为在编程和工具使用等任务中改进长程 LLM agents 的重要方法,但目前仍不清楚具体提升了哪些能力,以及在现实部署预算下得到的 agent 是否保持可靠。先前评估主要关注轨迹级任务成功率或单轮 Pass@K 采样广度,忽略了在 agentic 场景中至关重要的交互深度维度和单步动作质量。作者引入了二维 Pass@(K,T) 评估和单步层面分析,表明 agentic RL 的收益依赖于足够的交互预算,主要来自更强的长程执行和错误恢复,而非始终更好的单步动作。他们进一步将这种预算依赖性识别为一种隐藏的部署风险,并提出 BudgetMix RL,以在不同预算下提升性能,同时缓解单步动作质量下降。
方法
多轮 Agentic 强化学习
作者将 agent 学习形式化为策略与环境之间的多轮交互。对于任务 x∼D,agent 维护一个交互历史
ht=(x,o1,a1,…,ot−1,at−1,ot).在每个轮次 t,agent 从其策略中采样一个动作,
at∼π(⋅∣ht),环境根据下式返回下一观测
ot+1∼P(⋅∣ht,at).动作可以表示工具调用、终止操作或代码执行。在最多 T 轮的交互预算下,一个 episode 会产生一条轨迹
τ≤T=(x,o1,a1,…,oT,aT),该轨迹由终端验证器通过奖励 R(τ≤T) 进行评分。该形式化既支持仅结果奖励的强化学习方法,如 GRPO,也支持过程级信用分配方法,如 GiGPO。
Pass@(K, T):采样广度与交互深度
为了在采样广度和交互深度两个维度上评估 agent 性能,作者引入了指标 Pass@(K,T)。传统 agent 评估通常报告轨迹成功率。相比之下,单轮强化学习通常使用 Pass@K,它衡量 K 个独立样本中至少一个成功的概率。这对应采样广度。
交互式 agent 引入了另一个正交维度:每条轨迹可用的最大交互预算 T,它控制交互深度。指标 Pass@(K,T) 同时刻画这两个维度:
Pass@(K,T)=τ(1),…,τ(K)∼π(⋅∣x)Pr[∃i∈{1,…,K}:R(τ≤T(i))=1].根据这一定义,K 控制广度,T 控制深度。将总采样预算固定为常数 C 并对 T 进行扫描,可得到轨迹级指标 Pass@T=Pass@(K=C,T),它单独刻画交互深度轴。
BudgetMix RL:跨交互预算优化
作者提出的主要训练方法是 BudgetMix RL。该方法旨在保持长程执行能力和轨迹级收益,同时鼓励更谨慎的单步决策,并减少为下游错误恢复而依赖额外交互预算。
BudgetMix RL 保持与传统多轮 agentic 强化学习相同的奖励机制,但在不同训练轨迹之间改变交互预算。它可以与现有 agentic RL 算法结合,包括 GRPO、PPO 和 GiGPO。
标准多轮 agentic RL 在固定最大预算 Tmax 下采样轨迹,并优化结果奖励或逐步奖励。然而,该目标不会显式区分需要不同交互量的解,只要它们在允许预算内完成即可。BudgetMix 对此过程只做一处修改。对于具有完整预算 Tmax(x) 的任务实例 x,作者以 10% 为间隔构造候选预算,并按任务组均匀采样一个预算:
T(x)=Unique({⌈10kTmax(x)⌉:k=1,…,10}), T(x)∼Uniform(T(x)).在训练期间,总预算和剩余预算会在 prompt 中提供。任何超出其分配预算且未完成任务的轨迹都会获得零奖励。奖励信号设计与传统多轮 RL 保持一致。
BudgetMix 的核心思想是将交互预算 T 从 Pass@(K,T) 中的评估维度转变为训练维度。交互预算改变了获得相同奖励的条件。更紧的预算限制了重试机会,因此对更早的决策提出更高要求;而充足的预算则保留了长程执行的机会。通过在训练期间采样不同预算,策略会接触到这两种情形,并被鼓励生成在不同交互约束下仍然有效的轨迹。
实验
作者使用跨采样广度和交互深度的二维 Pass@(K,T) 度量来评估多轮 agentic 强化学习,并在 DeepCoder-MT、BFCL、InterCode-SQL 和 FrozenLake 上使用 GRPO。他们发现 agentic RL 可以将轨迹级成功率推向超出基础模型能力边界,但收益依赖于足够的交互预算,并非由始终更好的单步动作驱动;相反,RL 改善了错误恢复和后期执行,而单个动作质量可能下降。似然和训练分析将其归因于轨迹级策略偏移的累积,而非更强的局部决策;过程监督或预算混合可以部分稳定这些权衡。
在 FrozenLake、DeepCoder-MT、BFCL-v3 和 InterCode-SQL 上,受限交互预算下,BudgetMix 相比基础模型和标准全预算 RL 提升了 Pass@8。相比全预算 RL 的平均优势在最紧预算下最大,并随着预算增加而缩小,同时全预算性能保持可比。这表明 BudgetMix 增强了跨预算的性能稳定性,而没有牺牲长程执行。在最大交互预算的 25%、50% 和 75% 下,BudgetMix 在全部四个任务上均优于基础模型和全预算 RL,且在最紧预算下平均增益最大。在 100% 交互预算下,BudgetMix 与全预算 RL 保持相当,保持了长程任务性能。
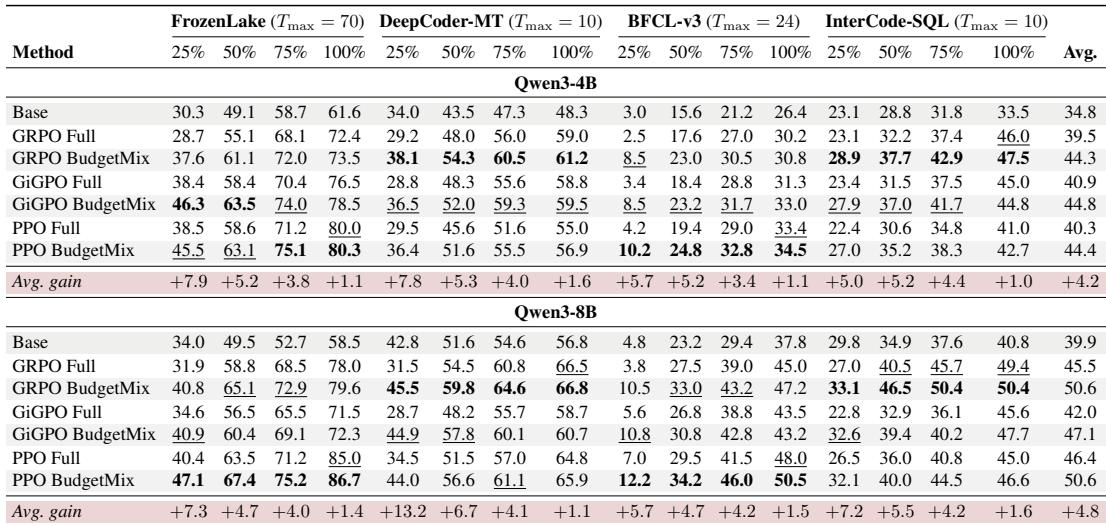
BudgetMix 在 FrozenLake、DeepCoder-MT、BFCL-v3 和 InterCode-SQL 上受限交互预算下进行评估,测量相对于基础模型和标准全预算强化学习的 Pass@8。在最大交互预算的 25%、50% 和 75% 下,它相比两个基线均提升了性能,在最紧预算下平均增益最大,并随着预算增加优势缩小。在 100% 预算下,BudgetMix 与全预算 RL 保持可比,表明它能在有限预算下稳定性能,而不会牺牲长程任务执行。