Command Palette
Search for a command to run...
DREAMX:视频扩散模型是一种通用潜在动作学习器
DREAMX:视频扩散模型是一种通用潜在动作学习器
Jisoo Kim Chaehyun Kim Junsu Kim Jiho Park Seongchan Kim Eunbeen Hong Soowon Son Fu-En Yang Seungryong Kim
摘要
从视频中学习通用动作表示,需要对动态进行建模,使动态在同一动作的不同执行之间保持一致,同时对具身和外观的变化保持不变。现有的潜在动作模型从视觉状态转移中推断动作,但其表示常常将底层动作与无关的视觉变化纠缠在一起,限制了跨具身的迁移。我们提出 DreamX,将预训练的视频扩散模型重新用作通用潜在动作学习器。我们的方法从视频模型丰富的时空特征中提取紧凑的潜在动作,将每个潜在视频帧压缩 300×(1,200 → 4 个 token)。此外,通过利用视频模型的生成先验,这些潜在动作能够捕捉与动作相关的动态,并将其与视觉外观解耦。由此得到的潜在空间可作为跨具身(人类与机器人)、环境以及动作参数化的共享动作接口。在 LARY-Bench 上,DreamX 在潜在动作模型中取得了最先进的性能。此外,在一种设定中编码的动作在另一种设定中仍然有效:该潜在空间支持任意到任意的视频迁移,以及跨不同具身和环境的零样本动作迁移。进一步地,该共享接口还支持在紧凑的潜在动作空间中学习策略,从而降低基于视频扩散模型的策略的计算成本。
一句话总结
来自 KAIST 和 NVIDIA 的研究人员提出了 DreamX,它通过从预训练视频扩散模型丰富的时空特征中提取紧凑潜在动作,将每个潜在视频帧压缩 300×,从 1,200 个 token 压缩到 4 个 token,并利用该模型的生成先验来捕获与视觉外观解耦的动作相关动态,从而在 LARY-Bench 上取得潜在动作模型中的最先进性能,并实现跨本体、环境和动作参数化的零样本迁移。
核心贡献
- DreamX 将预训练视频扩散模型重新用作通用潜在动作学习器,从模型的时空特征中提取紧凑潜在动作,并将每个潜在视频帧压缩 300 倍,从 1,200 个 token 压缩到 4 个 token。
- 通过使用视频模型的生成先验进行未来帧重建,学习到的潜在动作捕获了与视觉外观解耦的动作相关动态,并提供跨人类和机器人本体、环境及动作参数化的共享动作接口。
- 在 LARY-Bench 上,DreamX 在潜在动作模型中达到了最先进性能,支持任意到任意视频迁移和跨不同本体与环境的零样本动作迁移,无需成对的源-目标训练数据,并支持在紧凑潜在动作空间中进行策略学习,从而降低计算成本。
引言
通用机器人策略需要多样化的操作数据,但机器人演示成本高昂,且动作标签无法在不同本体之间干净地迁移。人类第一视角视频是一种可扩展的替代方案,但同一行为对不同身体或控制空间可能对应不同的低层动作,因此需要一种共享动作表示。先前的潜在动作模型从视觉转移中学习动作编码,但仅靠重建会使其编码外观或视角信息,并产生与训练本体绑定的表示。作者提出了 DreamX,这一框架使用可学习查询 token 直接从预训练视频扩散模型中读取潜在动作。DreamX 将帧间变化压缩为四个潜在 token,并通过未来帧重建进行监督,在 LARYBench 上取得了最先进的潜在动作表现,并实现无需成对训练数据的人到机器人迁移。
方法
作者在 Cosmos-Predict2.5 这一预训练视频扩散 Transformer 上构建 DreamX。因果视频自编码器将视频片段压缩为 N 个潜在帧 V=(V0,…,VN−1)。模型通过流匹配学习未来视频生成,最小化以下目标:
Lvideo=Ex,c,ϵ,τ[∥vθ(xτ,τ;c)−(ϵ−x)∥22]其中 vθ 预测流速。该生成先验捕获空间上下文和时间关系。
DreamX 将这一预训练骨干网络适配为将观测动态编码为潜在动作,并通过未来帧重建进行监督。
参见框架图。
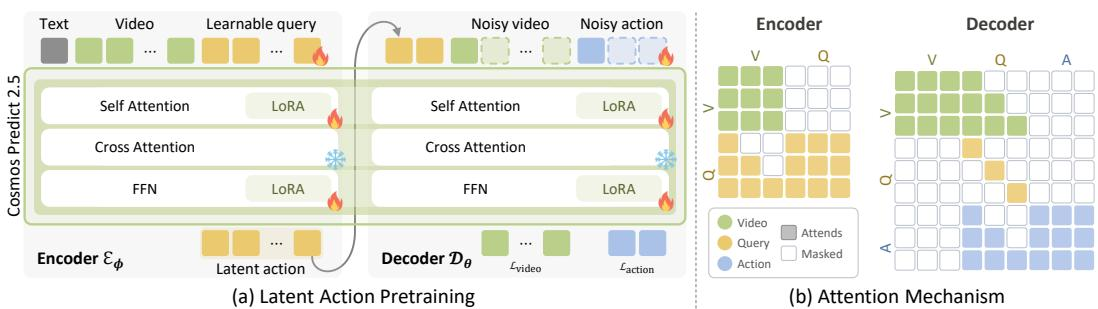
在编码器中,作者将可学习查询 token q 附加到视频 token 序列中。每个潜在帧 Vg 分配一组 K 个查询 token qg。它们通过骨干时空注意力联合处理后,输出特征形成潜在动作组 Qg。提取过程表示为:
Q=Eϕ(q;V,ℓ)其中 ℓ 是语言指令。注意力机制对查询到视频的交互采用帧因果方式,使 Qg 可以关注 V0:g,而查询到查询的注意力保持不受限制。
对于解码器,同一个预训练骨干网络以 Q0:N−1 和初始帧 V0 为条件重建未来帧,不使用文本条件。这迫使潜在动作编码运动信息而不是视觉线索。当动作标签可用时,解码器还根据本体感受状态 p0 预测动作块 A^:
V^,A^=Dθ(Q0:N−1,V0,p0)训练目标结合视频生成和动作生成:
L=Lvideo+λLaction学习到的潜在动作捕获可跨本体迁移的运动。给定源视频,冻结的编码器提取潜在动作 Qsrc。
如下图所示:
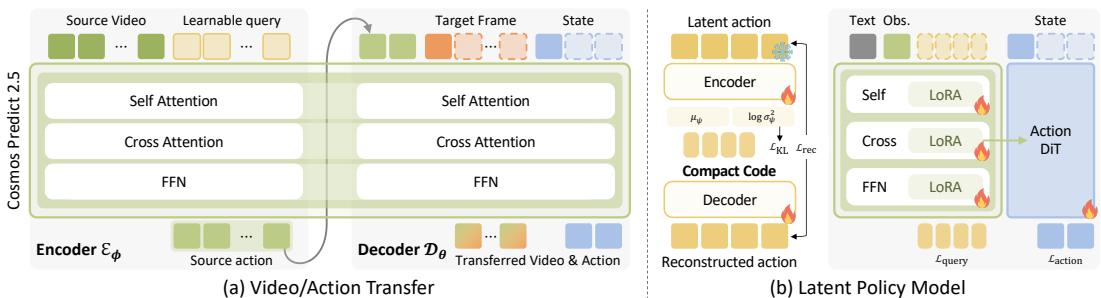
对于视频迁移,将 Qsrc 与目标初始帧 V0tgt 结合,生成目标视频。对于动作迁移,将 Qsrc 与目标机器人状态 p0tgt 结合,解码出可执行的低层动作:
V^tgt=Dθ(Qsrc,V0tgt),A^tgt=Dθ(Qsrc,p0tgt)对于下游策略学习,作者使用变分瓶颈将潜在动作压缩为低维编码 Z,将维度从 D 降低到 d≪D,同时保留 token 布局。该瓶颈通过特征重建和 KL 正则化训练。随后,DreamX 策略 π(⋅) 根据当前帧 V0 和指令 ℓ 生成这些紧凑编码。单独的 DiT 动作头以潜在动作特征、观测、指令和状态 p0 为条件预测低层动作:
π(Z,A∣V0,ℓ,p0)策略训练使用:
Lpolicy=Llatent+λLaction实验
实验在表示质量、跨场景和跨本体迁移、下游策略学习以及消融等方面评估 DreamX,这是一种基于 Cosmos-Predict2.5 构建并在机器人和人类混合视频上预训练的潜在动作模型。DreamX 在运动回归和分类上优于基线,零样本地将人类运动迁移到机器人,并实现开环动作迁移,可再现演示动作。在真实世界关抽屉策略测试中,它实现了 96.7% 的平均子目标成功率,消融表明辅助动作标签带来的提升很小,注意力分析证实潜在动作关注手部和夹爪以指定运动。
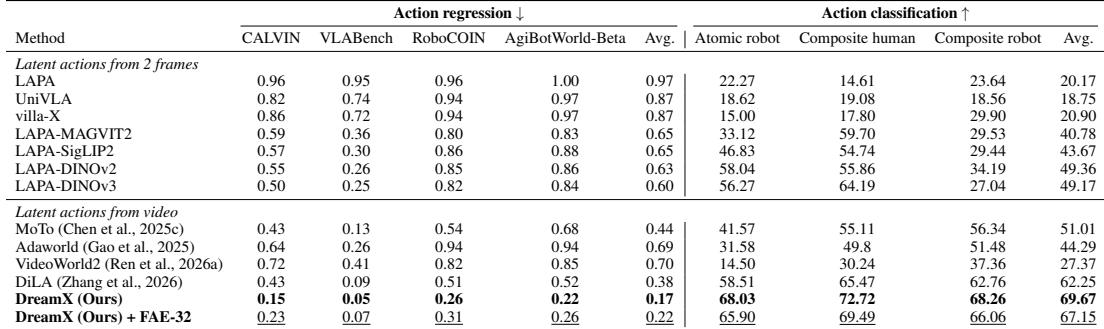
在 LARYBench 上,DreamX 提供了最强的动作表示质量,优于编码帧对或视频片段的潜在动作模型。它在所有报告的基准上实现了更低的归一化动作回归误差和更高的动作分类准确率。与最强基线 DiLA 相比,DreamX 将回归误差降低一半以上,并将分类准确率提高约七个百分点。DreamX 在 LARYBench 的动作回归和动作分类上都取得了最佳报告结果。与 DiLA 相比,DreamX 将回归误差降低一半以上,并将分类准确率提高约七个百分点。在所比较的帧对潜在动作方法中,LAPA-SigLIP2 最强,其平均回归误差低于其他列出的帧对方法,平均分类准确率更高。
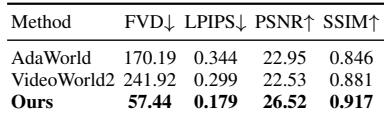
在零样本人类到机器人视频迁移中,DreamX 在所有报告的指标上都取得了比 AdaWorld 和 VideoWorld 2 更好的生成质量。它取得了最低的 FVD 和 LPIPS 值,同时获得最高的 PSNR 和 SSIM,表明更强的运动迁移和视觉保留。这一优势无需成对的人机训练数据即可实现。DreamX 取得了最低的 FVD 和 LPIPS,表明与基线相比视频保真度和感知相似性更好。DreamX 获得了最高的 PSNR 和 SSIM,反映出更好的重建质量和结构一致性。AdaWorld 在分布外设置下出现视觉退化,而 VideoWorld 2 尽管设计了外观解耦,偶尔仍会引入人手。
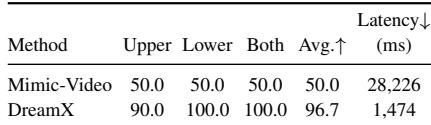
在真实世界关抽屉评估中,DreamX 在所有测试的抽屉配置上都达到比 Mimic-Video 更高的成功率,在 Mimic-Video 表现较差的任务上提升最大。DreamX 还实现了显著更快的推理,通过预测紧凑潜在动作而非未来视频,将每次调用延迟从数十秒降低到约 1.5 秒。DreamX 在每种评估的抽屉配置上都优于 Mimic-Video,尤其在下层抽屉和双抽屉任务上提升显著。DreamX 的推理延迟约低十九倍,从每次策略调用数十秒降至约 1.5 秒。更高的成功率和更低的延迟归因于 DreamX 生成紧凑潜在动作和低层动作,而不是生成未来视频。
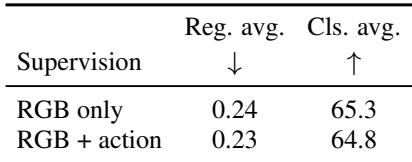
对编码器监督进行消融表明,添加动作标签只会略微改变回归和分类性能。回归 MSE 在动作监督下略有改善,而分类准确率小幅下降。接近的结果表明 DreamX 仅从视频中学习运动和动作语义,无需动作标签。添加动作监督带来较小的回归 MSE 改善,但分类准确率也会略有下降。仅 RGB 的性能接近 RGB+动作的性能,表明仅视频足以学习动作语义。
实验在动作表示质量、零样本人类到机器人迁移、真实世界操作和编码器监督方面评估 DreamX。DreamX 在 LARYBench 上优于潜在动作基线,在没有成对人机数据的情况下实现了比 AdaWorld 和 VideoWorld 2 更好的运动迁移和视觉保留,并以显著更低的推理延迟获得了更高的真实世界关抽屉成功率。消融显示添加动作标签只会略微改变性能,表明仅视频就足以学习动作语义。