Command Palette
Search for a command to run...
PyRUA-DataFarm:LLM 智能体作为面向真实就绪机器人数据的高成本效益遥操作员
PyRUA-DataFarm:LLM 智能体作为面向真实就绪机器人数据的高成本效益遥操作员
摘要
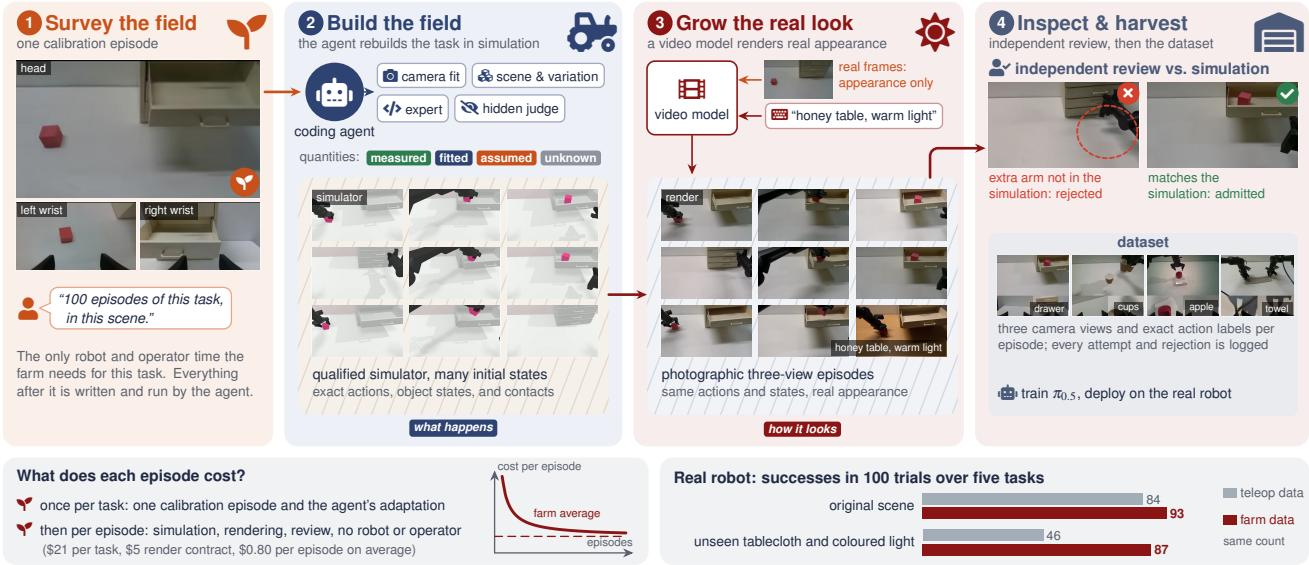
遥操作仍是采集机器人演示的默认方式,但每个回合都要消耗机器人和操作员的时间,且每个新任务都从零开始。我们探讨编码智能体能否接替遥操作员的工作。在我们的 DataFarm 中,智能体接收数据请求以及机器人在目标场景中的一段标定回合,并在仿真中重建任务:它编写场景、专家控制器和成功判定器。仿真器提供精确动作,以真实图像为条件的视频模型将每次 rollout 渲染为照片级视频,并同时一致地生成所有相机视图。输出是真实就绪的数据:带有机器人动作标签的同步相机视图,策略可在其上直接训练并部署到真实机器人。独立评审者在准入前对专家控制器和每个渲染回合进行认证。在五个真实机器人任务上,仅用农场数据训练的策略与用同样数量遥操作回合训练的策略表现相当(100 次试验中成功次数为 93 比 84);在未见过的桌布和彩色光照条件下,前者保持 87 次成功,而遥操作训练的策略降至 46 次。任务适配完全自动化,平均花费 21 美元的 API 使用费,每个任务一次性支付,另加 5 美元的渲染合同;此后每个回合平均花费 0.80 美元用于仿真、渲染和审查,无需机器人或操作员。一个任务的一小时三视图数据平均成本为 107 美元(含上述费用),略低于中国遥操作 117 美元的报价,也低于北美仅人工成本 290 美元。
一句话总结
北京大学与 NVIDIA 团队提出了 PyRUA-DataFarm,一个 LLM coding agent,它使用一个标定片段在仿真中重建任务,并由视频模型渲染可直接用于真实场景的多视角带动作标签数据,得到的策略在五项真实机器人任务上与遥操作训练的策略表现相当(100 次试验中 93 次对 84 次成功),并在未见条件下泛化更好(87 次对 46 次成功);适配一项任务平均花费 21,之后每个额外片段平均花费0.80。
核心贡献
- 论文介绍了 DataFarm,一个系统,其中 coding agent 将数据请求和一个标定片段转换为包含场景、专家控制器和成功判定器的仿真流水线,然后使用以真实图像为条件的视频模型渲染同步的、带动作标签的多视角机器人数据。
- 该方法引入了独立的准入流程,其中隐藏判定器、合格的仿真器和独立审核员在准入之前对专家和每个渲染片段进行认证,因此生成的数据不依赖于信任该 agent。
- 在五项真实机器人任务上,仅用 DataFarm 数据训练的策略与遥操作训练的策略表现相当,100 次试验中分别为 93 次和 84 次成功;在未见桌布和彩色光照条件下仍保持 87 次成功,而遥操作训练的策略降至 46 次。适配任务完全自动,平均 API 使用成本为 21,另加5 的渲染合同;之后每个额外片段平均成本为 $0.80。
引言
遥操作提供忠实的机器人训练数据,因为每个记录的动作都由机器人执行,每张图像都显示部署场景;但它成本高,且无法跨新任务、新场景或新视角扩展。先前的合成数据流水线降低了采集成本,但仍需为每项任务进行人工工程,并面临视觉差距:仿真重建难以处理可变形物体和发光显示屏,而视频生成模型会丢失精确的动作标签。作者提出了 DataFarm,一个 agentic 数据农场,其中 coding agent 从单个标定片段编译任务,仿真器提供精确的动作和状态,以真实图像为条件的视频模型提供逼真的多视角外观,认证与生产分离。由此以低成本生成同步、带动作标签、可直接用于真实场景的机器人数据;仅在农场数据上训练的策略在原始场景中与遥操作数据策略表现相当,同时对未见外观的泛化更好。
数据集
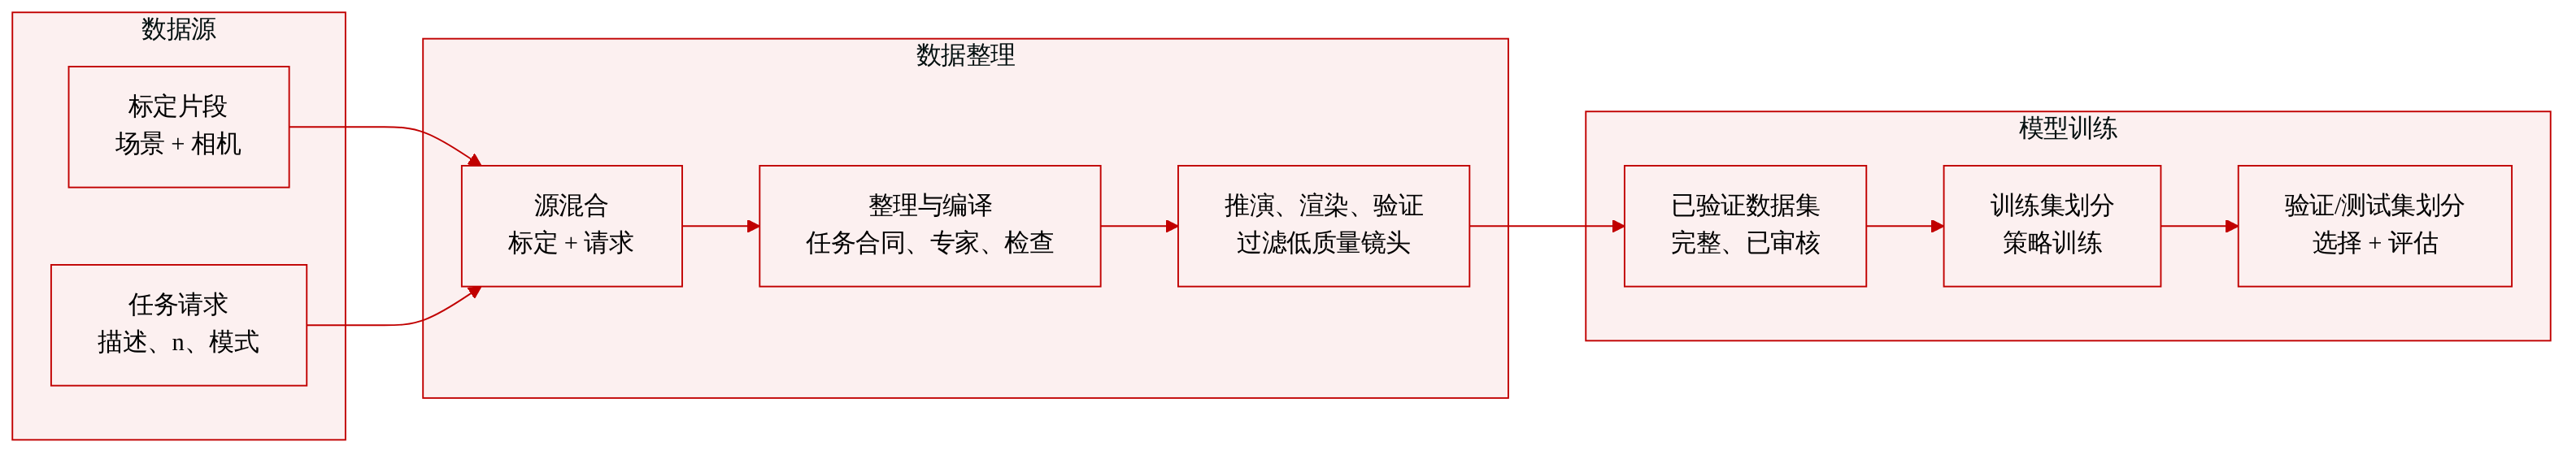
作者描述了 DataFarm,一个将数据请求和一个标定片段转换为经过验证、带动作标签的数据集的系统。
请求与数据模式
- 请求定义为 ρ=(ec,ℓ,n,μ),其中:
- ec 是一个标定片段:目标场景的短多视角记录。
- ℓ 是自然语言任务描述和成功条件。
- n 是请求的片段数量。
- μ 是数据模式。
- 标定片段用于识别场景和相机,但绝不会用作动作来源。
- 支持两种数据模式:
- sim2real:复现所记录的场景。
- ood(V):额外允许外观变化,例如更换桌布。
- 在请求之前,不存在任何适配器、判定器或任务特定的提示词。
片段结构
每个交付的片段 di 包含:
- oi:照片级多视角观测。
- ai:仿真器动作。
- xi:仿真器状态。
- ki:接触事件。
- yi:任务标签。
- qi:准入证据。
数据集还包含账本 L,记录每次尝试及其结果,包括失败的尝试。
构建流水线
DataFarm 通过若干个中间表示来编译每项任务:
- Grounding:产生场景描述 G。
- Simulator qualification and task compilation:产生任务合同 T 和专家 C。
- Rollout:在采样的变化 z 下执行一个片段 E。
- Rendering:使用视频模型 p 产生观测 O。
- Verification:在带有证据 q 的情况下准予最终片段 d。
每个表示由一个阶段生成,并由不同于生成者的组件检查,以避免语言模型自我评估。如果发现缺陷,拒绝结果会被发回最早的责任阶段。
任务与专家规则
- 任务合同列出任务阶段、完成条件和禁止的捷径,例如瞬移物体或放宽成功标准。
- 一个独立角色在专家编写之前将合同转换为冻结的判定器。
- 专家在跨任务共享的沙盒 harness 中开发。
- 在开发期间,专家作者可以在开发种子数据上请求 rollout 并查看判定器结论,但不能读取判定器,也不能运行留出的准入种子。
- 被准入的轨迹必须是单次连续执行,由 harness 全新运行并通过判定器。
- 每个生成的片段采样物体和传感器变化,默认包括桌面高度和倾斜的轻微变化。
- 记录关节占用情况,以便动作标签在真实机器人上仍然可执行。
过滤与准入
自动检查包括验证渲染视频:
- 包含正确的物体,没有多余物体。
- 在仿真器指示的时间显示事件。
- 在块之间时间稳定且连续。
- 具有静态背景。
- 与真实场景外观匹配。
- 不从参考帧复制布局。
判定器规范使用被接受的片段的故意破坏版本进行校准。破坏包括删除、复制或放大物体、偏移事件、交换视角和改变颜色。每种破坏都必须由相应检查捕获。
自动检查之后,独立审核员将解码视频与真实参考帧和仿真状态进行比较,然后为每项结论记录证据。
在模型训练中的使用
策略训练只从准入记录已被验证的数据集开始。交付的数据集必须完整、未修改、有完整的尝试记录作为依据,并逐片段进行审核。所提供的章节未明确给出数据集大小或训练划分比例;数据集大小由请求参数 n 控制。
方法
作者介绍了 DataFarm,一个 agentic 数据农场,将数据请求和单个标定片段转换为经过验证、带动作标签的片段流。系统将跨任务共享的部分与每个任务生成的部分分开。共享部分是能力层 K,包括各阶段的技能、角色指令、任何任务都不能覆盖的渲染模板,以及执行和检查工作的 harness、账本和验证器。每次运行都固定到 K 的特定版本。对于每个请求,agent 生成任务工件:
Aρ={G,T,S,C,J,R,B}即 grounding 记录 G、任务合同 T、场景与初始状态采样器 S、专家控制器 C、判定器规范 J、渲染合同 R,以及批次和数据集配置 B。这种分离确保缺少适配器永远不会成为缺少输入,因为 agent 会自己生成所有工件。
DataFarm 通过固定的中间表示序列编译每项任务,就像编译器将程序逐级降低一样。Grounding G 描述场景,任务合同 T 和专家 C 定义任务如何解决,片段 E 记录在采样变化 z 下的一次执行,观测 O 是视频模型 p 对它的渲染结果,准入记录 q 认证交付的片段 d。每个表示由一个阶段生成,只有在其生成者以外的组件检查后才被接受,因为语言模型是自身输出的不可靠判断者。拒绝结果被发回最早造成缺陷的阶段,每次失败的尝试都被保留,因此最终数据集带有其获取过程的完整记录。
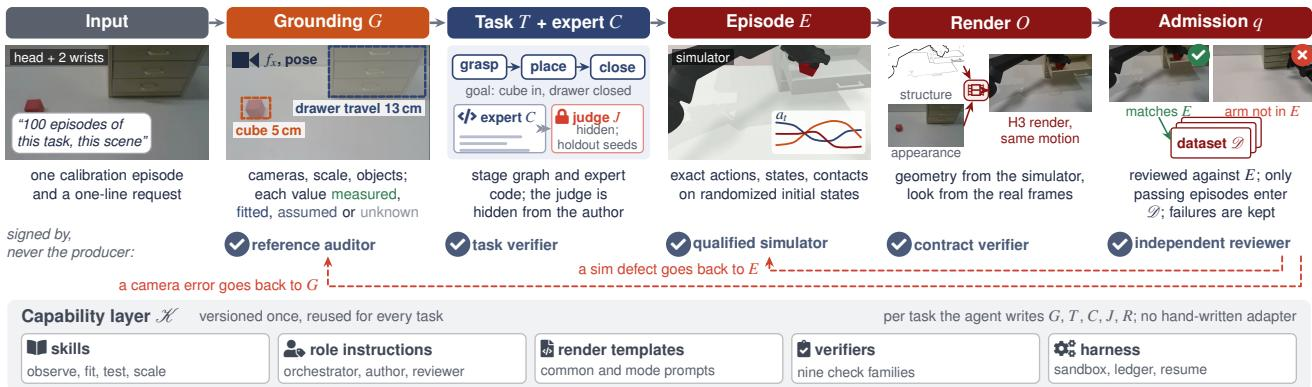
流程从 Grounding 开始,将标定片段转换为仿真器可以复现的场景描述。从完整片段中,agent 识别机器人和物体,估计它们的几何形状和关节结构,并拟合相机和公制尺度。短视频无法确定的物理量(如质量或摩擦)不会被猜测;每个量都被标记为已测量、已拟合、已假设或未知,不确定量由仿真器中的随机化覆盖。
在 agent 编写专家之前,它会执行 Simulator Qualification,检查仿真器能否复现任务所需的技能。DataFarm 对候选仿真器变体运行这些技能的短探测,这些变体调整材料、接触或执行器参数,并选择通过每个探测且改动最少的变体。
接下来是 Task Contract and Expert Compilation。agent 指定任务并编写解决该任务的专家。DataFarm 防止专家自行拟合检查以避免奖励欺骗。任务合同 T 列出任务阶段、完成条件和被禁止的捷径。一个独立角色将合同转换为判定器,判定器在专家编写之前冻结。专家在所有任务共享的沙盒 harness 中开发。作者将控制器编写为程序,并在开发种子上请求 rollout,获得判定器对每个 rollout 的结论,但既不能读取判定器,也不能运行用于最终准入的留出种子。
Rendering 随后将每个仿真片段转换为照片级视频,同时保持其动作、物体和时间不变。数据要么复现所记录的场景,要么沿请求授权的轴改变外观。对于每项任务,agent 编写渲染合同,说明目标外观、允许的变化以及每个相机的真实参考帧。默认渲染器是 MiniMax-H3 的 reference-to-video 模式。仿真器视频的边缘图驱动 ControlNet,固定手臂姿态、物体位置和时间,真实帧和真实机器人照片提供外观。一次生成中的所有相机被平铺在一块画布上,并生成为单个视频,因此它们共享光照和材质。长片段生成为独立块,并在相邻块差异最小处连接,以避免漂移。
最后,Verification、Independent Review 和 Admission 确保数据质量。只有自动检查后独立审核员接受,片段才会进入数据集。验证器是所有任务共享的单个程序,并由任务特定规范配置。它检查渲染视频包含正确物体、事件发生在仿真所指出的时间,以及视频在时间上稳定。规范使用前,会在一个被接受片段的故意破坏版本上进行校准。每个片段还会由独立审核员检查,这是一个单独的 agent,将解码视频与真实参考帧和仿真状态进行比较。最终交付检查确认数据集完整、未修改、有完整尝试记录作为依据,并逐片段进行审核。策略训练只从准入记录已被验证的数据集开始。
实验
评估使用双臂 PiPER 机器人上的五项双手操作任务,每项任务从一个标定片段开始生成 100 个训练片段,并比较在真实遥操作、带域随机化的仿真以及 DataFarm 渲染数据上训练的策略。农场训练的策略在原始场景中达到或超过遥操作,并且对未见桌布和光照的迁移效果更好,而传统仿真基线迁移效果较差,这表明对精确仿真轨迹进行照片级渲染是关键贡献因素。成本结果表明,在少量片段之后,农场数据比遥操作采集更便宜,渲染检查确认所有相机视角都忠实于仿真运动并看起来真实,不同于直接视频模型调用,同时以低成本改善难以仿真的物体外观。
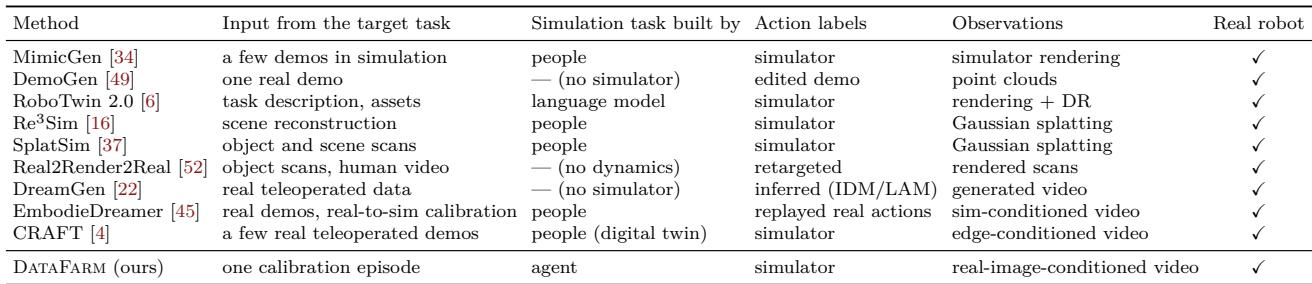
大多数被比较的流水线依赖精心准备的输入,例如多个演示、任务描述、重建场景或遥操作数据,其仿真任务通常由人或语言模型构建。DataFarm 则从真实场景的单个标定片段开始,不复用其中的任何动作,并让 agent 构建仿真任务。它在仿真中保留动作和状态,同时以该片段自身图像为条件生成照片级多视角观测。DataFarm 是唯一一个从单个标定片段构建仿真任务且不复用其任何动作的被比较流水线。与观察仿真器渲染、点云、高斯溅射或渲染扫描的方法不同,DataFarm 使用标定片段自身图像作为照片级多视角视频的外观参考。
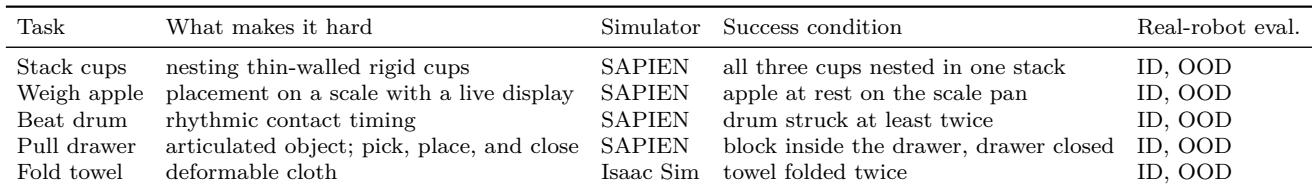
评估涵盖五项双手操作任务,针对不同挑战:嵌套刚性杯子、将苹果放在带实时显示屏的秤上、敲鼓、使用抽屉以及折叠毛巾。所有任务均在双臂 PiPER 机器人上进行评估,包括分布内的原始场景和分布外场景,后者使用未见桌布并改变彩色光照。成功条件因任务而异,包括完全嵌套并稳定放置、重复敲击鼓面、将块留在抽屉内并关闭抽屉,以及将毛巾折叠两次。该任务集涵盖不同仿真需求:刚性和关节任务在 SAPIEN 中运行,可变形毛巾在 Isaac Sim 中运行。每项任务都在原始和分布外条件下测试,分布外试验增加未见桌布和改变室内光照。
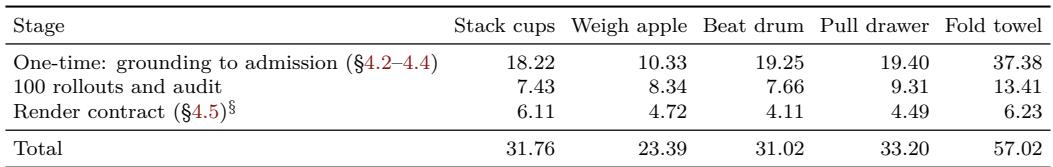
在五项任务中,将一项任务从标定到准入和渲染合同,再到 100 个仿真片段,按标准 API 定价费用约在 23到57 之间。一次性 grounding 和资格确认阶段是大多数任务中最大的成本部分,fold towel 最贵,weigh apple 最便宜。设置完成后,经常性的 rollout 和审计成本显著降低,平均每个被准入片段不到 1 美元。fold towel 在五项任务中总成本最高,而 weigh apple 最低。一次性 grounding 到准入阶段主导每项任务成本,100 个片段的 rollout 和审计阶段对每项任务均低于 $14。
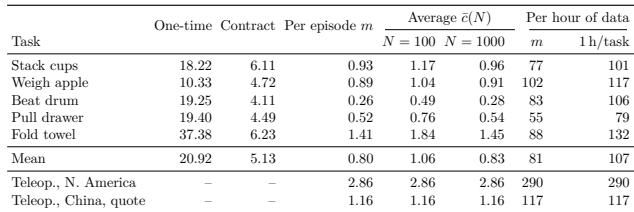
自动农场数据采集的每片段运行成本低,固定的任务适配和渲染合同成本会随着生成更多片段而摊薄。在 100 个片段时,平均每片段成本略高于 1 美元,并在 1,000 个片段时趋向每片段运行成本。首个一小时的同步多视角数据比后续小时更贵,在所述假设下农场通常比基于遥操作的采集更便宜。在五项任务中,平均每片段运行成本低于 1 美元,fold towel 最贵,beat drum 最便宜。将一次性和合同成本分摊到 1,000 个片段上,使平均每片段成本接近每片段运行成本,从 100 个片段时略高于 1 美元下降。每项任务一小时的同步三视角数据在第一个小时比每个额外小时更贵,因为固定的任务适配和合同成本前置。估计的北美遥操作劳动力每可用小时比农场数据成本昂贵得多,而来自中国的全包报价仅略高于农场第一小时平均值。农场的成本优势依赖于自托管渲染;已发布的托管渲染器价格会使每片段渲染成本大幅上升。
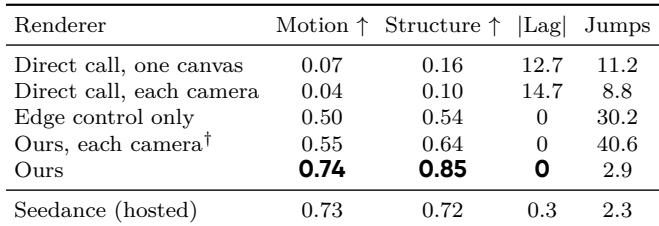
在三项任务中,直接调用视频模型难以跟随仿真运动和结构,滞后更高且跳跃更频繁。使用完整流水线将所有相机一起渲染可大幅改善运动和结构一致性,消除滞后并显著减少跳跃。完整的自托管渲染器与托管的 Seedance 模型性能相当,同时避免了多视角不一致。直接单画布和逐相机生成的运动和结构一致性远低于完整渲染器,滞后更高且跳跃更频繁。独立渲染每个相机会降低多视角一致性,即使在 stack cups 任务上使用完整渲染器也会产生更差的相关性和更多跳跃。仅使用边缘控制可以改善运动跟踪,但仍会留下许多跳跃,而包含参考、提示词和块拼接的完整流水线可将其减少到极少。完整渲染器实现零滞后、低跳跃次数,以及与托管 Seedance 渲染器相当的运动和结构一致性。
实验评估了 DataFarm,一个从单个真实标定片段构建仿真任务且不复用动作的流水线,覆盖原始场景和分布外场景中的五项双臂 PiPER 操作任务。实验发现,一次性 grounding 和准入主导设置成本,而经常性的 rollout 和审计成本仍然较低;当渲染为自托管时,自动采集比遥操作更便宜。消融实验表明,完整的多视角渲染流水线对于强运动和结构一致性至关重要,可消除滞后并减少跳跃,同时达到托管视频生成质量且不出现多视角不一致。