Command Palette
Search for a command to run...
你不需要长上下文
你不需要长上下文
摘要
后续 token 的生成成本高于前序 token。在前沿开放权重模型上,成本差异可能高达 7x。通过频繁压缩,我们在广泛的长程任务和长输入任务上表明,前沿语言模型在保持短上下文时几乎不会牺牲任务准确率,甚至完全没有损失。我们进一步证明,即使在每个上下文中最多采取一个动作的情况下,LLM 在长程软件工程任务上的性能也不会崩溃;基于此,我们概述了语义状态空间模型(SSSM)的概念。我们的研究结果对长上下文语言模型的必要性提出了质疑。
一句话总结
Project Moonshot: Local Frontier Intelligence 的研究人员表明,频繁压缩能让前沿语言模型在长程任务和长输入任务上保持短上下文,并且几乎没有准确率损失;软件工程性能即使在每个上下文最多只执行一次操作时也不会崩溃;这些结果为语义状态空间模型(SSSM)提供了动机,同时挑战了长上下文语言模型的必要性,因为靠后的 token 成本最高可达 7x.
核心贡献
- 频繁的上下文压缩使前沿开放权重模型能够在短上下文下解决广泛的长期任务和长输入任务,同时几乎不牺牲任务准确率。
- 针对长期软件工程任务的每次上下文单操作设置表明,仅携带紧凑语义状态时性能不会崩溃,从而勾勒出语义状态空间模型(SSSM)。
- 对话结束压缩与带压缩的选择性输入读取通常与全上下文基线持平或更优,支持长上下文对于所测试工作负载并非必要的结论。
引言
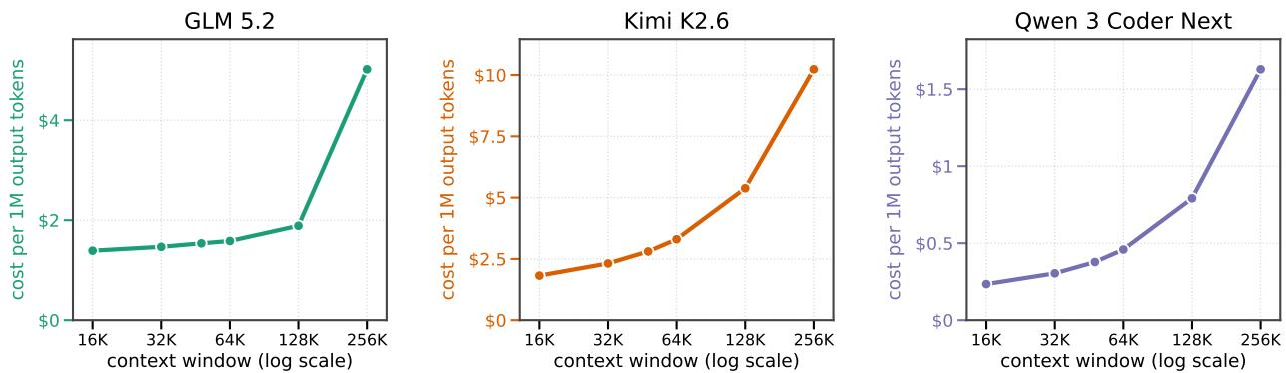
作者考察了长输入上下文成本高昂的原因:token 生成延迟、吞吐量和内存占用随上下文长度增长;即使零售 token 定价掩盖了这一点,较短上下文下的云服务成本也可降低 3.6 到 7 倍。尽管存在这些成本,当代语言模型仍将上下文窗口扩展到远超许多实际工作负载的长度,优化更大的可能输入而非效率。作者挑战了长上下文的标准理由,这些理由来自长程对话任务和长输入任务,并表明并非每一步都固有地需要完整上下文。他们的贡献是证明压缩和选择性输入读取可以在保持活跃上下文较短的同时达到或优于全上下文基线,从而支持长上下文对于许多长上下文任务并非必要的结论。
数据集
数据集描述:长上下文基准
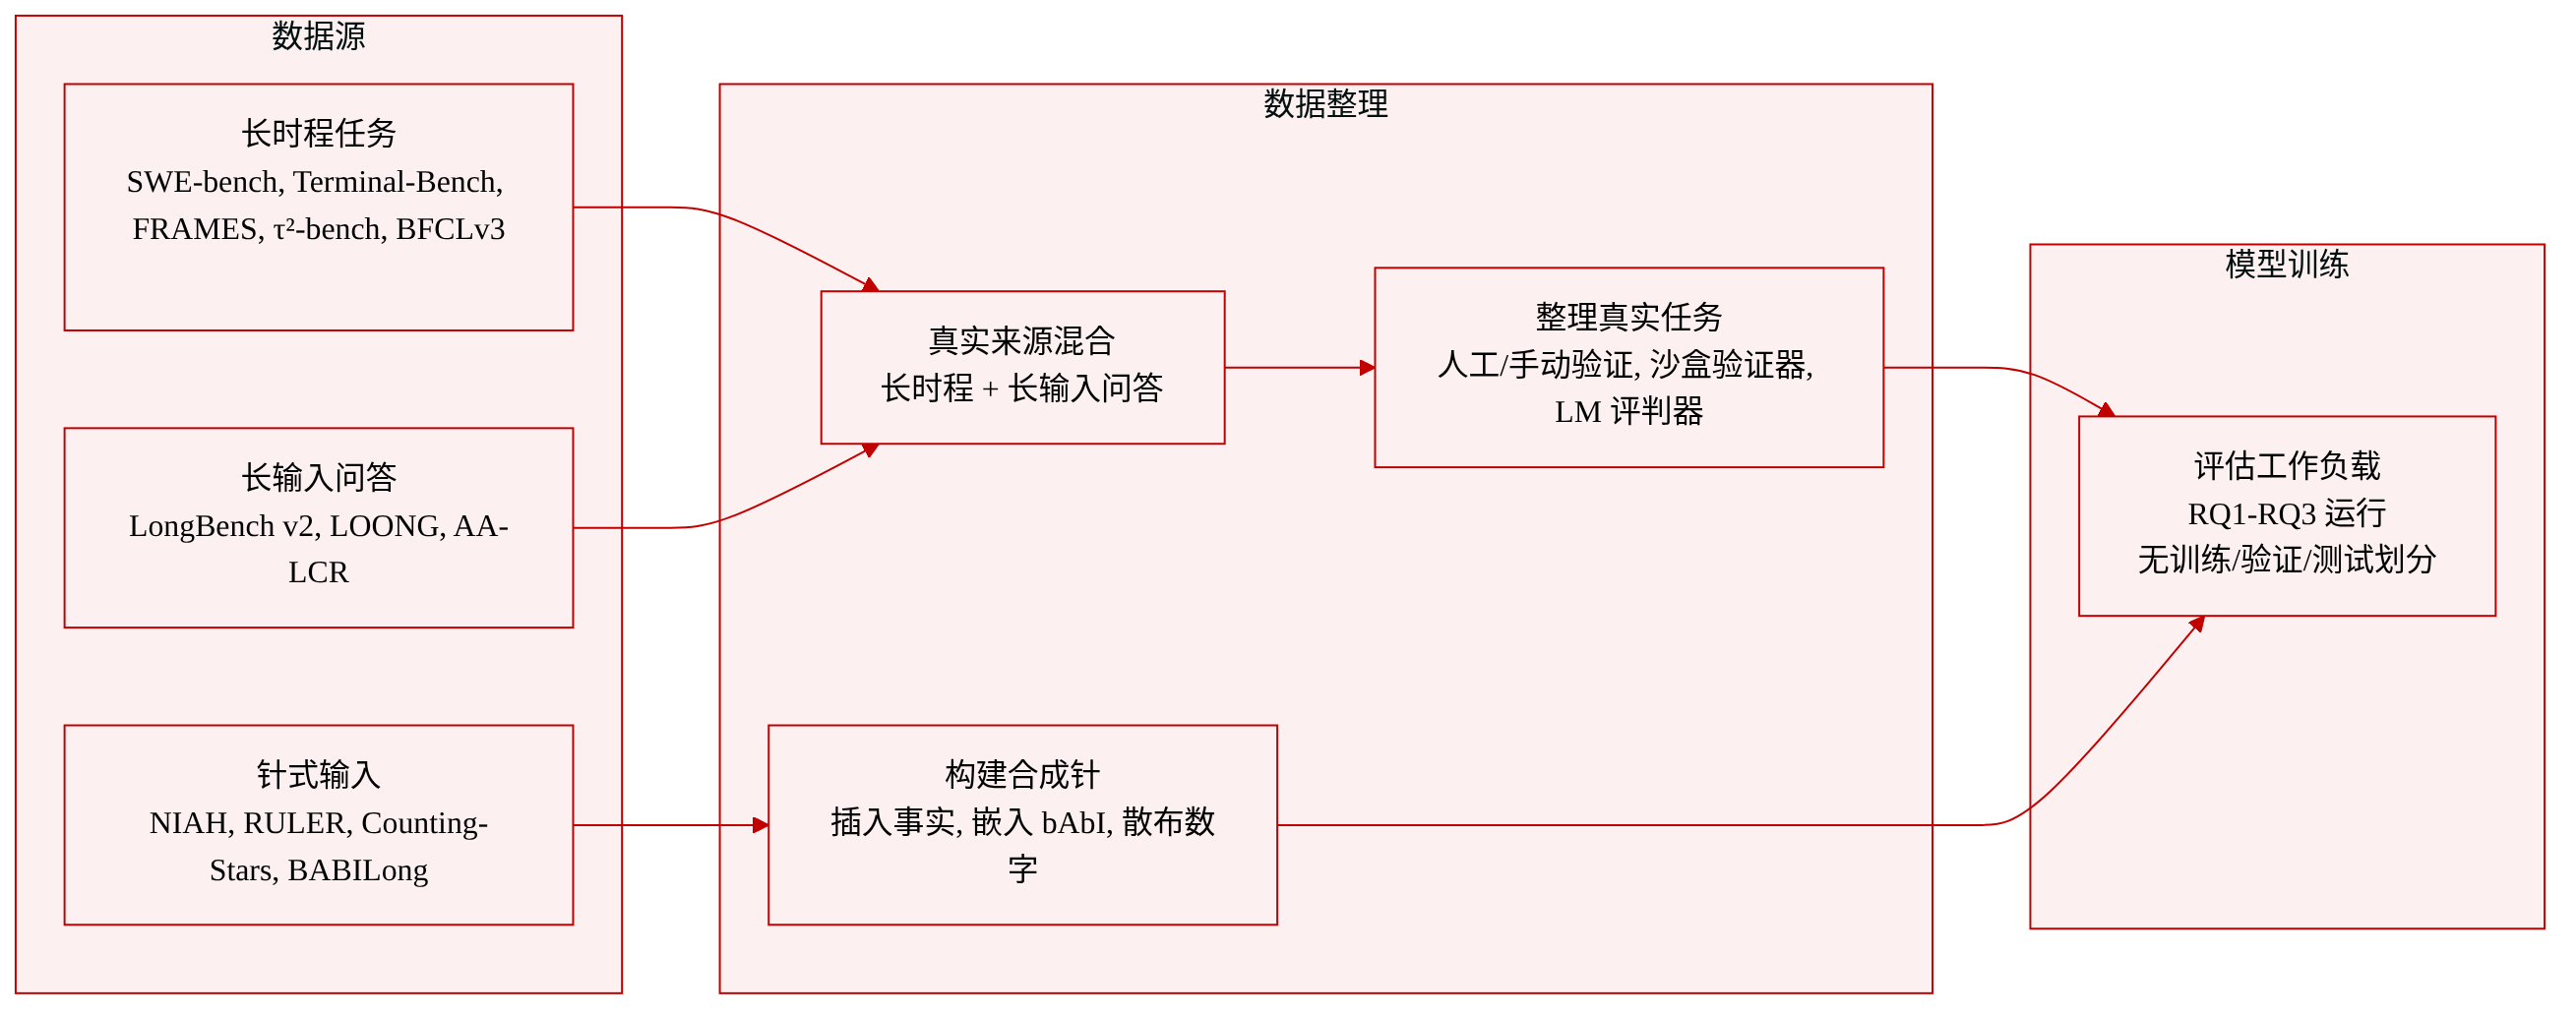
作者根据长上下文的来源将评估数据分为两组基准:长程任务基准,其中交互历史随着 agent 的行动而增长;长输入任务基准,其中源材料可能填满或超过上下文窗口。
长程任务基准
- SWE-bench Verified:500 个经人工验证的真实 GitHub issue 解决任务,来自热门仓库。agent 必须生成能通过仓库保留测试套件的补丁。
- SWE-bench Multilingual:300 个手动整理的 issue 解决任务,来自九种编程语言的仓库。它测试跨语言生态的仓库探索、实现和验证。
- Terminal-Bench 2.1:89 个在沙箱容器中执行的真实命令行任务,按任务验证器评分。
- FRAMES:824 个具有挑战性的多跳问题,需要来自 2 到 15 篇维基百科文章的信息。agent 在固定维基百科语料库中搜索,逐步打开相关文章,并提交由 LM judge 评估的自由形式答案。
- τ²-bench:横跨零售、航空和电信的 184 个任务黄金集。agent 在策略约束下操作领域特定工具,与模拟用户对话。成功需要满足用户请求并使环境达到正确的最终状态。
- BFCLv3:200 个用于多轮工具调用的长上下文片段。agent 必须在多轮用户对话中保留信息,并安排会改变状态的工具调用。
长输入任务基准
- LongBench v2:503 个具有挑战性的多项选择题,输入从 8K 到约 200 万词不等。六个任务族覆盖单文档和多文档问答、长上下文内学习、长对话、代码仓库理解和结构化数据理解。
- LOONG:1,600 个多文档问题,其答案通常依赖多份完整的英文或中文财务报告、法律案例或学术论文。任务包括定位、比较、聚类和推理链,证据分布在多个文档中。
- Artificial Analysis Long Context Reasoning (AA-LCR):100 个人工设计的问题,需要在平均约 100K 输入 token 的真实文档集上进行推理。七类文档包括公司与行业报告、政府咨询、学术和法律文件、营销材料和调查报告。
- Needle in a Haystack (NIAH):将目标句子插入到受控深度的长篇不相关文章文本中。125 个实例网格变化插入深度和文档长度,上下文从 16K 到约 500K token。
- RULER:合成长上下文套件,包含十三个任务:八个检索针变体、变量跟踪、常见词和频繁词提取,以及两个多跳问答任务。所有十三个任务均在 256K 和 500K token 下评估,并按所需答案集的召回率评分。
- Counting-Stars:32 个标记数字散布在长文本中。完整公开集有 192 个问题,涵盖英文和中文、获取与推理变体,以及从 4K 到 128K token 的文档。推理变体包含最初错误但后来被纠正的计数。
- BABILong:将来自 bAbI 推理任务的短事实嵌入书籍文本。它包含 550 个问题,跨越全部十种任务类型和从 64K 到 1M token 的五种输入长度。回答需要定位相关陈述,然后执行事实链、计数、否定或集合跟踪等操作。
整理与处理细节
- 不同基准的整理方式各异:SWE-bench Verified 使用人工验证,SWE-bench Multilingual 使用手动整理,Terminal-Bench 使用沙箱执行和验证器,FRAMES 使用 LM judge,若干套件使用固定的公开或黄金评估集。
- 针式处理包括在 NIAH 中于受控深度插入事实,在 RULER 中构建合成检索与推理任务,在 Counting-Stars 中散布标记数字,以及在 BABILong 中将 bAbI 事实嵌入书籍文本。
- 作者指出,针式基准通常不只依赖简单的词汇重叠。它们需要聚合、变量跟踪或对多个检索事实进行推理。
本文中的用途
- 这些基准用于评估论文的研究问题 RQ1 至 RQ3。
- 该节仅描述评估工作负载。没有为模型训练指定训练划分、训练混合比例、源自基准的训练集或裁剪策略。
方法
作者建立了一套基础方法来评估和管理 agent 式工作流中的上下文,使用两个密切相关的底层框架:mini-swe-agent 和 mini-agent。两个框架都实现了一个最小 ReAct 循环,其中任务在初始用户消息中提供,模型每次发出一个 Bash 操作,每个操作及其结果都会追加到对话中。mini-swe-agent 框架专为软件工程和终端任务定制,提供任务仓库或容器。mini-agent 框架通过保留相同的 agent 循环和接口,并使用特定于基准的指令和提交规则,将此方法推广到其他基准。
为应对长对话上下文的挑战,作者引入了三种不同的上下文管理机制,决定如何将交互历史呈现给模型。第一种是完整历史累积(Full-History Accumulation),作为基线,将所有模型操作和环境观察追加到一个对话中,不删除或替换任何历史。第二种是对话结束压缩(End-of-Conversation Compaction)。在该方法中,模型遵循完整历史 ReAct 循环,直到对话上下文超过预定义的压缩阈值。随后模型被要求生成一个长度受限且与任务相关的状态压缩。较高的总上下文限制为这一压缩回合预留空间,随后框架开始一个包含原始任务和压缩状态的新对话。第三种是单操作压缩(Single-Action Compaction),在几乎没有对话历史的情况下维护紧凑语义状态。每次对话接收任务和当前语义状态,执行恰好一次环境操作,观察结果,更新语义状态,然后丢弃该对话并为下一次操作开始新对话。
对于涉及长输入的任务,框架支持选择性输入读取,将长输入作为文档存储在 agent 的文件系统环境中,而不是将其完整内容放入初始对话。任务消息会指明可用文档,agent 使用标准 Bash 工具进行选择性读取。此方法明确将选择性输入读取作为环境操作,从而有效将长输入工作负载转化为长程工作负载。
基于这些观察,作者提出了语义状态空间模型(Semantic State Space Model)的概念。该模型经过后训练,能够理解对话状态的输入语言描述,推理合适的下一步操作,执行该操作,记录结果,并更新该状态的语言描述。与在 token 生成之间维护黑箱神经状态的传统状态空间模型(State-Space Model)不同,语义状态空间模型在持续对话的各轮之间维护可解释的自然语言状态。这种设计允许不同的推理实例无缝地继续对话直至完成。
该架构的实用价值在于更高的 token 效率和数据效率。通过保持短上下文,模型避免了长上下文窗口带来的计算和金钱成本。
如下图所示:
数据展示了在现有输入 KV 缓存上生成一百万个输出 token 的美元成本随上下文窗口大小变化的情况。在多种模型上,以 256K 而非 16K 的上下文窗口大小提供模型服务时,每生成一个 token 的成本显著更高。这一可观的成本优势凸显了通过单操作压缩和语义状态空间模型等机制保持短上下文的实际优势,使其成为完整历史累积模型的高效替代方案。
实验
实验评估了是否可以在模型中不保持长上下文的情况下解决长程 agent 式任务和长输入推理任务,采用频繁的上下文压缩和选择性输入读取,在一系列基准上使用封闭权重模型,如 Claude Opus 4.5 和 GPT 5.6 Sol,并辅以开放权重及延迟和吞吐量测量。对于长程工作负载,一旦 agent 历史达到限制性阈值就进行压缩,总体上能保持任务准确率,同时带来可观的估计成本节省,尽管某些任务可能仍需选择性访问过去信息。对于长输入工作负载,选择性读取和压缩可保持短上下文,并且通常与基线准确率持平或更优,对话长度随着文档大小增长仍大致有界。最后的单操作压缩实验表明,即使将每次交互减少为一次操作和一个紧凑语义状态,Claude 的准确率也能保持或提高,GPT 仅出现小幅下降,这支持长上下文对于这些任务并非必要的结论。
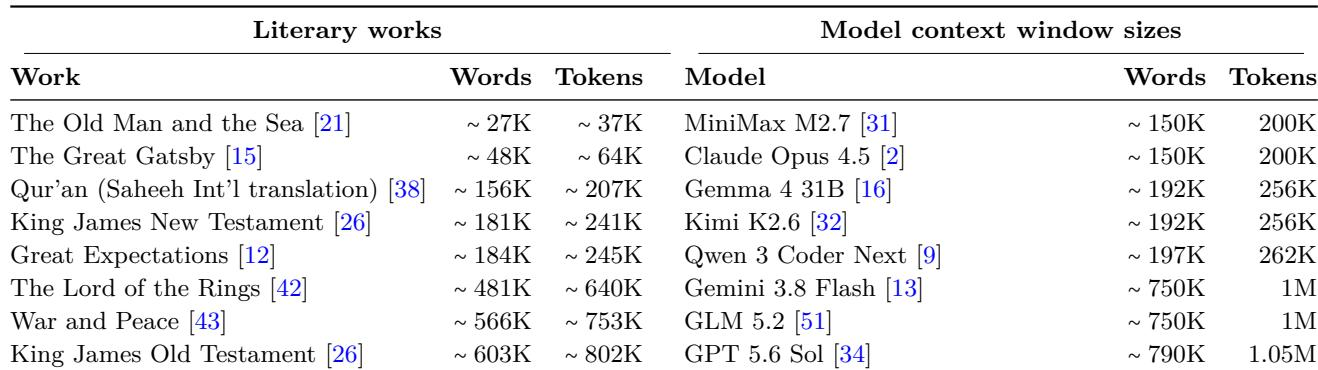
该比较显示,知名文学作品从数万到数十万 token 不等,而模型上下文窗口从数十万到一百万 token 不等。大多数较短作品在所列最小模型上下文中即可容纳,但若干较长文本超过这些限制,最长作品需要最大上下文窗口。由于近似换算因子,token 估计值比单词数大约三分之一。文学作品跨度从短篇小说到史诗长篇,而模型上下文范围从数十万到一百万 token。最长作品只能容纳在最大模型上下文中,而若干较长作品,包括宗教文本和长篇小说,超过了所列最小模型上下文。
最佳 EoCC 配置在所有列出的基准和模型组合上均比完整历史基线提高了准确率,同时大幅降低了最大峰值上下文。SAC 进一步将峰值上下文降至最小值,并在很大程度上保持准确率,Claude Opus 4.5 达到或超过基线,GPT 5.6 Sol 仅出现小幅下降。这表明选择性输入读取和单操作压缩可以在没有完整历史上下文的情况下保持性能。最佳 EoCC 准确率在每一组列出的模型和基准对上都超过 mini 基线,而其最大峰值上下文在所有情况下都远低于 mini 基线。SAC 在所有列出的情况下具有最小的中位数和最大峰值上下文长度,并保持 Opus 4.5 的准确率接近或高于基线,而 GPT 5.6 Sol 仅产生适度的准确率下降。
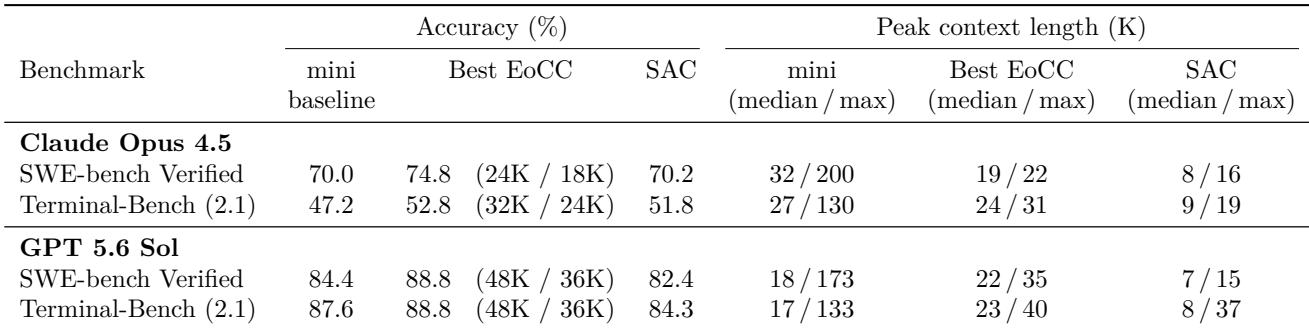
第一项比较评估了知名文学作品的 token 长度与当前模型上下文窗口的关系,显示大多数较短文本可容纳在较小上下文中,而最长作品需要最大窗口,并且 token 估计值比单词数大约三分之一。第二项实验在多个基准和模型上测试 EoCC 和 SAC 配置,发现最佳 EoCC 设置相比完整历史基线提高了准确率,同时大幅降低最大峰值上下文,而 SAC 进一步最小化上下文,仅在一个模型上出现小幅准确率下降。这些结果验证了选择性输入读取和单操作压缩是在没有完整历史上下文的情况下保持性能的有效方法。