Command Palette
Search for a command to run...
Route Anything:面向通用 AI 系统的模型与策略路由研究
Route Anything:面向通用 AI 系统的模型与策略路由研究
Pengfei Zhou Yixing Ma Hexin Wang Weidong Tang Zhenglin Wan Wangbo Zhao Yang You
摘要
通用人工智能(AGI)需要一种能够跨多领域、多模态进行理解、生成、推理和行动的方法。与其依赖单一模型掌握所有能力,当前通往 AGI 的一条有前景的路径是将由专门模型、工具和策略(候选对象)组成的异构生态系统编排为一个统一的 AI 系统。这一愿景的核心问题是:AI 系统如何在性能与计算成本之间取得平衡,同时为每个任务动态选择并协调能力最强的候选对象?本文提出 Route Anything,一个用于研究通用 AI 系统中模型与策略路由的统一框架。我们建立了统一的理论基础,刻画质量-成本权衡下的最优路由,并阐明路由器可获得的信息如何决定其可达到的性能。为系统地研究跨多种能力的路由,我们首先构建了一个全模态轨迹矩阵,涵盖语言理解、图像、视频与语音生成、编程与办公智能体以及机器人操作等 25 个基准,包含来自 452 个候选配置的 374,401 次评分运行。基于该框架,我们训练并测试了不同的路由器,以研究全模态模型路由的潜力、学习式路由器的能力以及路由提升效率的条件。我们的结果揭示了能力编排的巨大机会:逐输入 oracle 路由比最佳固定候选高出 5.4 分;学习式路由器在 16 个基准上比最佳固定候选高 0.3 分,在视频生成上高 2.1 分,在机器人操作上高 1.1 分且策略时间减少 24%。更重要的是,与参考模型相比,路由将效率平均提高 8.82 倍,其中编程任务提高 25.5 倍,文本问答提高 7.1 倍。
一句话总结
新加坡国立大学、加利福尼亚大学伯克利分校和香港科技大学的研究人员提出了 Route Anything,一个面向通用 AI 的统一模型与策略路由框架,将质量-成本最优路由理论与涵盖 25 个基准、共 374,401 次运行的全模态轨迹矩阵相结合,并表明学习到的路由器将视频生成提高 2.1 分,将机器人操作提高 1.1 分,同时策略时间减少 24%,且相对参考模型平均效率提升 8.82 倍。
核心贡献
- Route Anything 是一个用于研究通用 AI 系统中模型与策略路由的统一框架,其理论基础刻画了质量-成本权衡下的最优路由,并将路由器信息与可达到的性能联系起来。
- 全模态轨迹矩阵跨越文本与图像理解、图像、视频和语音生成、编程和工作场所 agent、机器人操作等 25 个基准,包括来自 452 个候选配置的 374,401 次评分运行。
- 逐输入 oracle 路由比最佳固定候选高 5.4 分,学习到的路由器在 16 个基准上比其高 0.3 分,在视频生成上高 2.1 分,在机器人操作上高 1.1 分,同时策略时间减少 24%。路由还使效率相对参考模型平均提高 8.82 倍,其中编程提高 25.5 倍,文本问答提高 7.1 倍。
引言
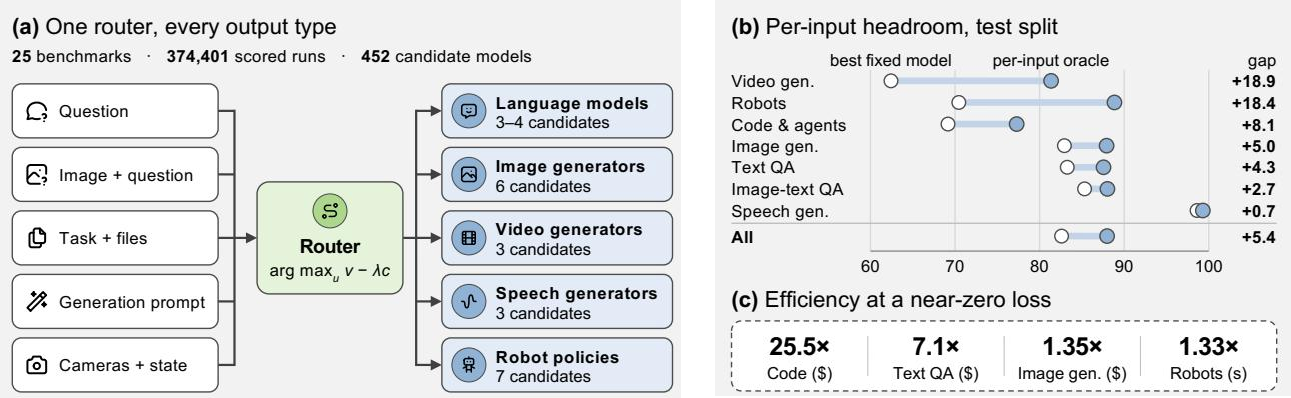
Agentic AI 系统越来越多地编排许多专门模型、工具和策略,例如语言模型、图像或视频生成器、语音模型和机器人策略,而不是依赖单一模型提供所有能力。由于给定输入上的最佳候选会变化,路由可以以更低成本匹配强固定候选,或通过将每个输入发送到最合适模块而超越它。先前路由研究主要集中在语言模型上,跨模态路由的价值在很大程度上仍未解决。作者引入 Route Anything,这是一个用于研究文本、图像、视频、语音、代码、agent 和机器人操作中模型与策略路由的统一框架。他们构建了一个全模态轨迹矩阵,在 25 个基准上对 452 个候选配置在同一输入上进行评估,共 374,401 次评分运行,并将路由决策与价格化成本和高质量约束相连。
方法
作者将路由问题形式化为对给定输入从有限候选中选择最优候选。每个候选产生一个期望值并消耗特定数量的资源。路由器观察状态并选择候选以最大化价值-成本目标。
Jλ(g)=E[Vg]−λE[Dg]在给定资源价格 λ 下,路由器在质量与成本之间取得平衡。为确保可靠性,该框架引入了相对于参考策略的质量下限约束,要求质量变化保持在负容忍阈值以上。
对于学习到的路由模型,作者利用微调后的 Qwen3.5-4B 骨干网络,处理任务文本、输出要求以及可选的多模态输入,例如相机帧或机器人状态。作者提出了两种主要路由架构。结果路由器使用 sigmoid 头对每个输入和候选对进行评分。该模块通过交叉熵针对候选的归一化结果进行训练,直接优化期望价值。类型路由器则把输入分类为具体能力类型,并从预先拟合的表中选择最佳候选。作者明确指出,相较于赢家标签分类,更倾向于结果回归,因为后者会丢弃平局和失败中的有价值信息,并可能遭受显著的价值损失。
为在未见测试输入上保证质量下限,系统沿价格路径采用顺序认证工作流。随着价格参数从零增加到拟合的最大效率,将评估一系列路由器。
如下图所示:
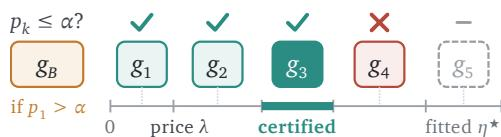
认证过程按顺序测试路由器,针对质量变化低于负容忍度的原假设计算有效 p 值。工作流在第一个未通过统计检验的路由器处停止,并返回最后一个通过认证的路由器。如果第一个路由器就未通过检验,系统回退到基线参考策略,从而在不需要多重性校正的情况下保证经过认证的质量下限。
实验
这些实验评估了跨多模态基准、机器人操作以及成本敏感的代码和路由器测试平台上的模型路由,在匹配输入上比较固定最佳候选、oracle 和学习到的路由器。结果表明,大部分路由提升空间位于任务类型内部而非类型之间,学习到的路由器仅带来适度质量增益;当基于结果的机器人路由器读取场景并节省推理时间时,收益更明显。成本感知研究进一步表明,更便宜的路由通常已足够好,而重试、验证器和更细粒度状态只有在新增价值超过其全部成本时才值得采用;在相同输入上进行匹配比较对于避免因缺失分数回退而产生人为增益至关重要。
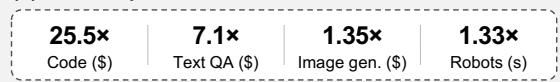
路由在保持质量损失较小的同时,相对参考模型提高了跨模态效率,其中代码和文本问答的收益最大,图像生成和机器人策略推理的收益较为适度。逐输入候选选择相比任何固定候选提供明显的提升空间,图像生成路由可以在少量质量损失下换取有意义的成本节省。然而,拟合的零损失保证若不经过认证可能很脆弱;更丰富的候选或更细粒度状态只有在净价值超过其所替代内容时才值得。代码和文本 QA 的路由效率提升最大,而图像生成和机器人策略路由的改进相对较小。按基准测试,oracle 候选选择优于最佳固定候选,图像路由可以在最小质量损失下降低成本,但拟合保证需要认证才能可靠成立。
在测试划分上,逐输入 oracle 的得分明显高于最佳固定候选,但该差距在不同任务组之间差异很大。最大潜在收益出现在视频生成和机器人操作中,而语音生成几乎没有提升空间。事后选择最佳固定候选相比训练中选定的固定候选几乎没有增加,因此大部分机会位于任务类型内部。最大的 oracle 到固定候选差距出现在视频生成和机器人操作中,其中没有候选占主导地位,差距约为 18 到 19 分。语音生成候选几乎完美,固定候选与 oracle 得分之间的差距远低于 1 分。
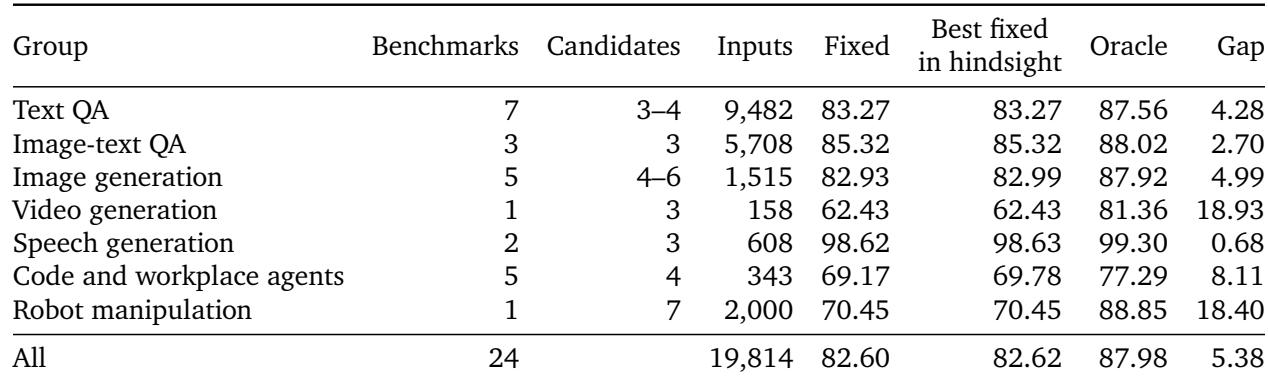
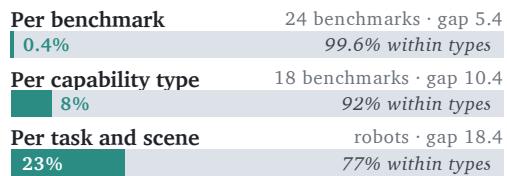
更细的分组揭示了选择最佳候选可带来更大潜在收益。差距在基准层面最小,在能力类型层面增大,在任务和场景划分中最大,尤其是机器人。在较粗粒度层面,大部分收益位于类型内部,但在任务和场景划分中,类型内份额下降。随着分组从基准层面到能力类型层面再到任务和场景层面,潜在路由收益逐渐增加。机器人显示出最大的差距和最低的类型内份额,表明类型层面选择之外的潜在收益更多。路由器开销相对图像和视频生成成本仍然较小。
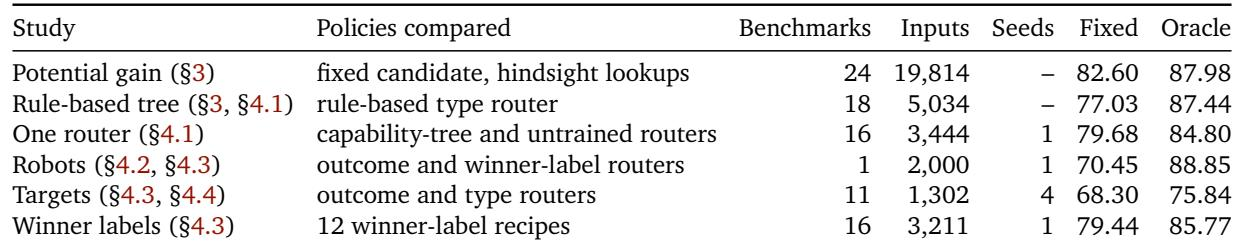
在报告的各个面板中,oracle 策略始终优于固定候选,但固定候选得分和增益大小因设置而异;机器人面板显示出最大提升空间。绝对得分仅在每一行内可比,因此这些差距是研究内部的关键信号。相关路由实验显示了成本-质量权衡,包括在较小分数损失下大幅降低测试成本的图像路由,以及在不降低成功率的情况下节省时间的机器人路由。在列出的每项研究中,oracle 得分都超过固定候选得分,表明更好的候选选择可带来一致的潜在收益。机器人面板具有最大的固定候选到 oracle 差距,表明在该设置下学习路由器有更多提升空间。一些多基准面板显示固定候选到 oracle 差距相对较小,而机器人和基于规则的树面板显示更大的绝对增益。图像路由实验表明,适度质量损失可将测试成本降低约四分之一,而机器人路由在不降低成功率的情况下节省时间。
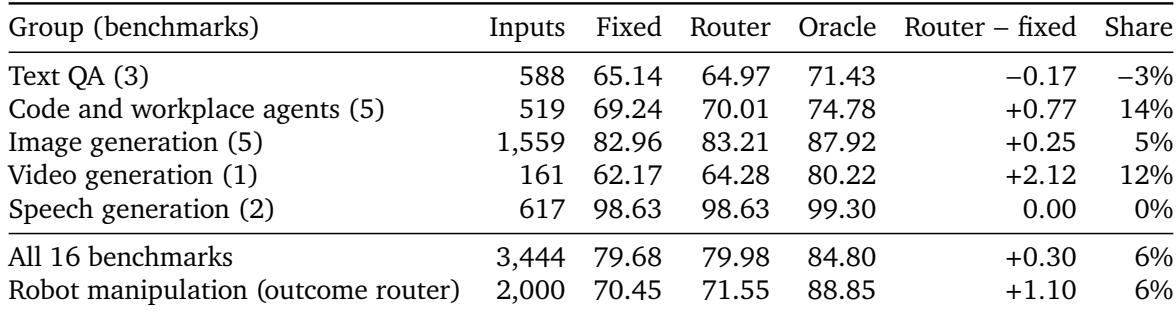
在 16 个基准上,学习到的路由器相对固定候选仅略微提高平均得分,并只捕获了 oracle 提升空间的一小部分。收益并不均衡:代码和工作场所 agent 以及视频生成受益最大,文本 QA 略微下降,语音生成没有变化,图像生成仅显示出适度提升。机器人操作结果路由器也优于其固定候选,但大部分 oracle 差距仍未获取。代码和工作场所 agent 以及视频生成相比固定候选显示出最大改进,而文本 QA 是唯一路由器得分低于固定候选的组别。语音生成没有变化,图像生成仅捕获了可能 oracle 收益的一小部分,机器人操作有所改善,但占 oracle 差距的比例也同样较小。
这些实验在基准、模态和分组粒度上比较了学习到的逐输入路由与固定候选选择及 oracle 候选选择。路由在质量损失通常较小的情况下提高了效率,其中代码、文本问答、视频生成和机器人操作的收益最大,而语音和图像生成显示有限提升空间或适度改进。更细的任务和场景分组提高了潜在路由收益,尤其对机器人而言,但学习路由器仅捕获 oracle 差距的一小部分,拟合的零损失保证需要认证才能可靠。