Command Palette
Search for a command to run...
视频生成背后:来自 Kling 的多模态理解观察与洞见
视频生成背后:来自 Kling 的多模态理解观察与洞见
摘要
视频生成已从孤立片段发展到连贯的短视频音视频序列,瓶颈正从渲染转向语义控制。本报告总结了从 Kling 历代版本中获得的关于多模态理解的观察与洞见。我们认为,生成质量是多模态理解贯穿整个数据—条件化—对齐—评估链的投影,并逐模块考察该链条。Kling-MLLM 是一个统一处理图像、视频、音频、同步音视频和交错输入的共享多模态基础模型,并针对每个下游模块进行专门化。由于 DiT 的训练样本数量远少于语言模型,我们将描述生成视为一种最大化描述密度的语义契约,并将其扩展为参考引导的描述生成,使参考绑定显式化。提示增强将用户意图转化为这种描述分布:基础 PE 源自优质视频的描述,并通过文本级强化学习和生成器在环强化学习进行优化;而智能体式 PE 则细化故事并检索优质示例。我们表明,可靠的文本编码器来自感知训练而非更强的语言能力,候选模型可以在端到端训练之前仅凭文本进行筛选。奖励建模将用于可解释、局部化批评的通用奖励模型与用于快速多维评分的决策奖励模型相结合,并将感知带宽视为一等设计参数。最后,我们回顾了任务特定的自动评估,重点关注能暴露评分捷径并帮助将失败追溯到上游来源的评估协议。我们希望这些经验能为构建可控视频生成背后的理解栈提供实用指导。
一句话总结
Kling 团队提出了 Kling-MLLM,一个统一图像、视频、音频、同步音视频和交错输入的多模态基础模型,并通过引入参考约束字幕生成、基于生成器在环强化学习的提示增强、感知训练的文本编码器以及成对奖励模型来分析数据-条件-对齐-评估链路,以改进可控视频生成。
核心贡献
- Kling-MLLM 是一个统一图像、视频、音频、同步音视频和交错输入的多模态基础模型,并针对数据-条件-对齐-评估链路中的每个下游模块进行专门化。
- 参考约束字幕生成将字幕生成扩展为具有显式参考绑定的稠密语义契约,使用指针、补充说明和范围化的保留或变更记录。提示增强将用户意图转换到该字幕分布中,基础提示增强通过文本级和生成器在环强化学习进一步优化,Agentic 提示增强则改进故事并检索有吸引力的示例。
- 可靠的文本编码器来自感知训练,而不是更强的语言能力,并且可以在端到端训练前仅通过文本来筛选。奖励建模将用于可解释局部批评的通用奖励模型与用于快速多维评分的决策奖励模型配对,任务特定的自动评估协议揭示评分捷径并向上游追踪失败。
引言
作者们审视视频生成从片段级保真度向序列级控制的转变,其中镜头语言、身份持续性、参考绑定和时间连续性必须在多个镜头间成立。先前工作通常将多模态理解视为广泛的基准表现,但 VQA 风格分数不能可靠表明正确语义是否到达生成器,失败可能来自字幕遗漏、条件瓶颈、奖励捷径或评估器薄弱。基于 Kling 1.0 到 4.0 及相关系统,作者们认为视频生成质量是多模态理解在整个数据-条件-对齐-评估链路上的投影。作者们将 Kling-MLLM 专门化为字幕生成器、提示增强模型、文本编码器、奖励模型和评估器,以使该链路显式且可追踪。
数据集
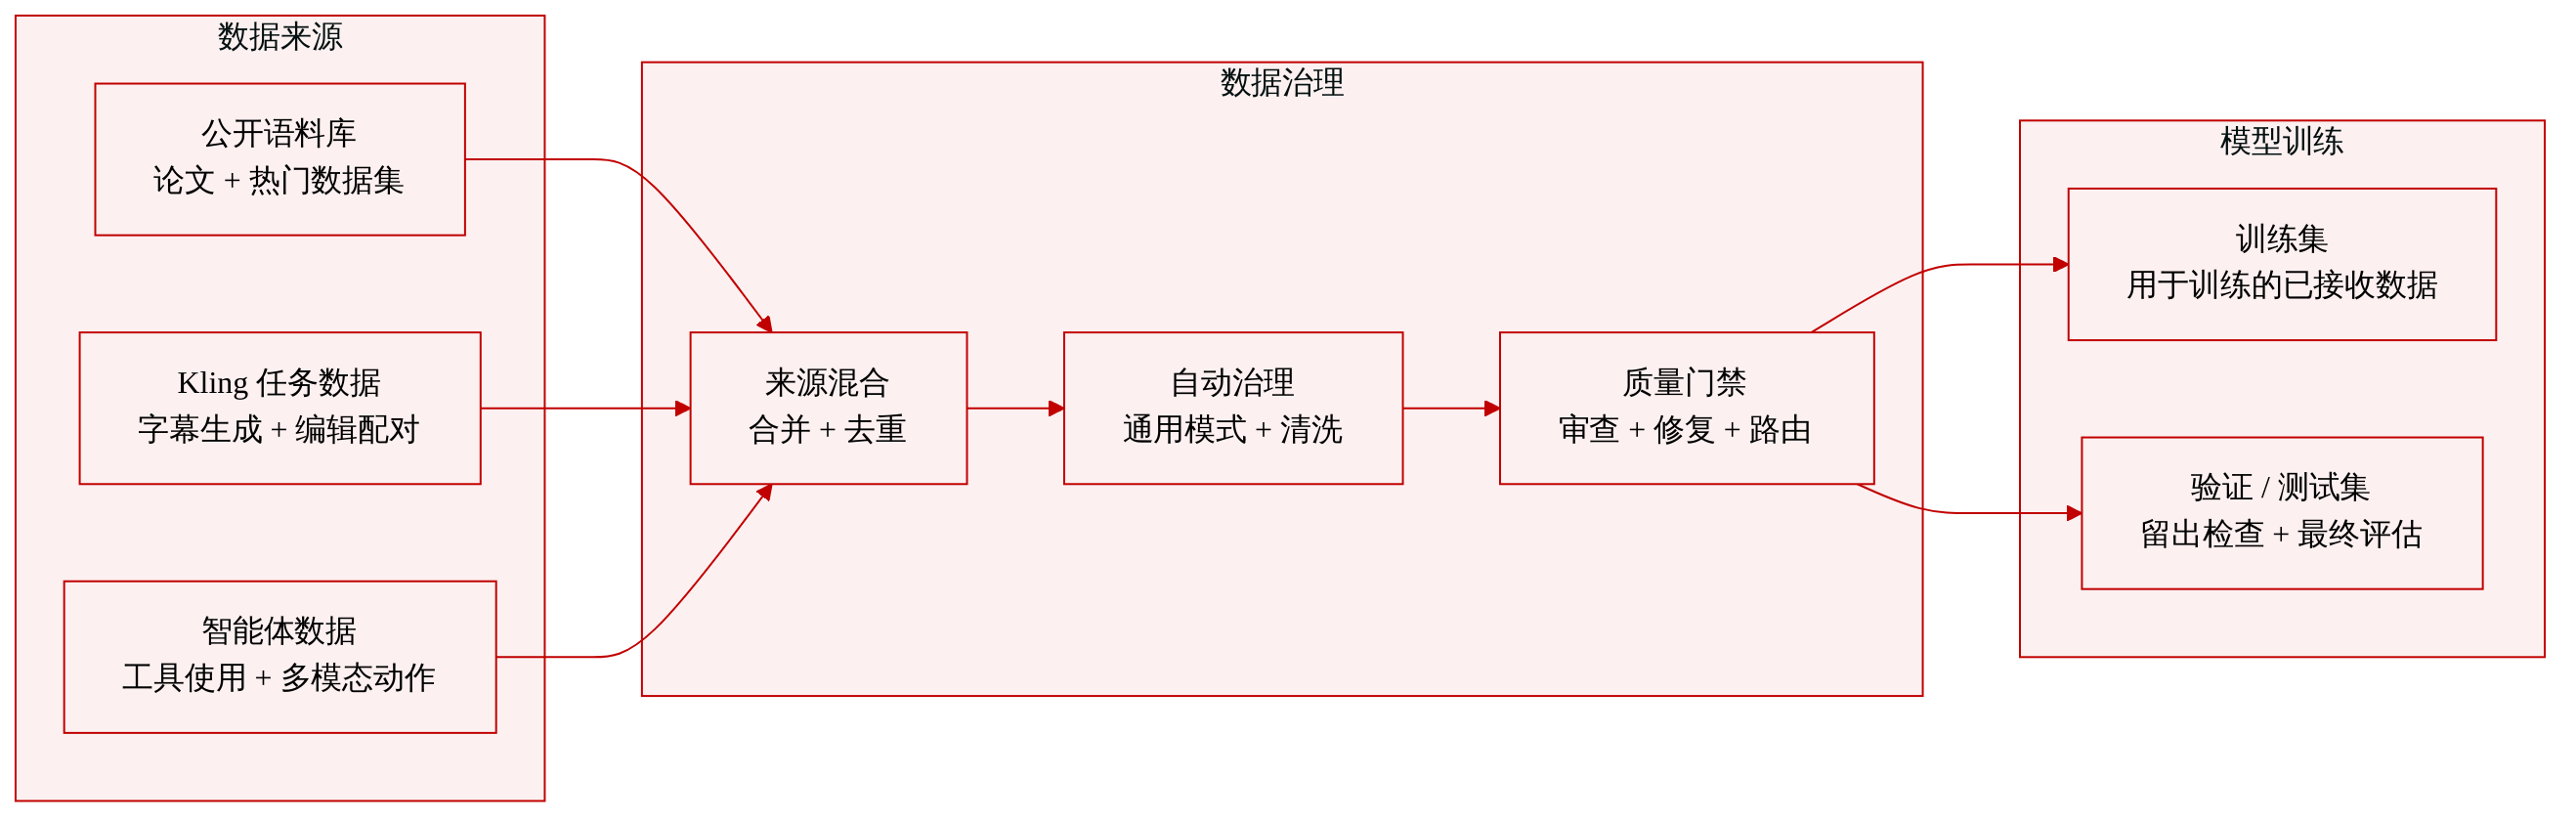
数据来源与构成
- 公开数据: 作者们通过监控 Hugging Face Daily Papers 和 Hugging Face 热门数据集持续收集公开语料。候选数据集从文本、图像、视频、音频、音视频和多模态基础模型相关工作中抽取。来源合并后相互去重,并与历史注册表去重。
- Kling 专用任务数据: 内部数据针对图像和视频生成与编辑需求。这些数据包括交错图像文本世界知识、双语 OCR、计数、定位、元数据感知描述、姿态理解、密集图像和视频字幕生成,以及带有成对源-目标图像或视频的编辑或参考示例。
- 多模态 agent 数据: 混合数据覆盖通用工具使用和多模态感知到动作任务。示例包括 API 和事务性工作流、网络研究、软件工程、终端交互、数据转换、安全辅助、基于图像的检索、GUI 交互、Agentic 视频理解和基于 Blender 的 3D 任务。监督范围从完整工具使用循环到部分轨迹和直接响应,部分示例由模型生成并经过一致性检查。
处理与模式
- 所有异构来源通过一个通用的面向对话的模式来表示。媒体元数据和模态边界被保留,因此单一加载器可以构建图像、视频、音频、同步音视频和交错示例。
- 公开数据遵循 AutoResearch、Auto Data Process、Auto Revise 工作流。AutoResearch 发现并筛选候选数据集。Auto Data Process 下载数据集并应用模态特定转换。Auto Revise 执行粗格式化和多样性检查、使用 Qwen3-Omni 进行精细困惑度检查、使用 Gemini 进行多模态审查,以及人工审查。接受的数据被分配到训练阶段;低质量数据被删除或修复并重新验证。
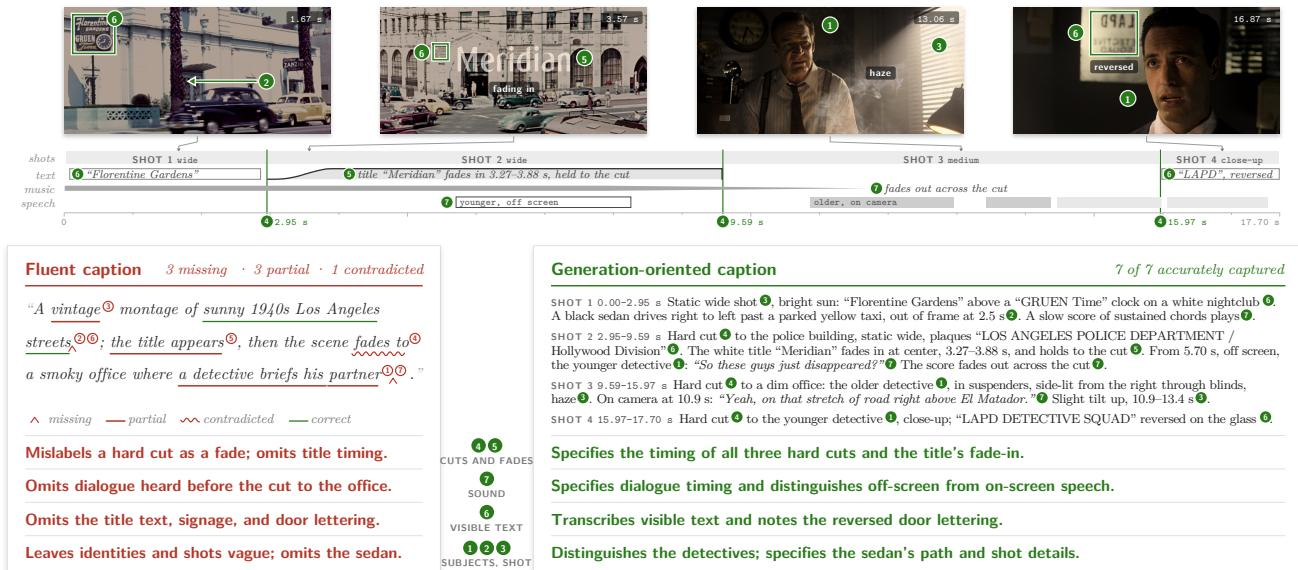
- 字幕生成遵循语义契约,强调显式实体命名、镜头边界时间戳、忠实的 OCR 转录和音频的时间整合。字幕监督流程包括检查与路由、感知证据保留、路由专家声明、整合与冲突解决,以及质量门控。
- 对于参考约束字幕,作者们将具有足够视觉或声学相似性的视频配对。一个视频作为参考,另一个作为目标。字幕说明共享内容和必须变化的内容,这使得任意相似视频对即使没有原始编辑指令也能成为训练示例。
- 提示增强数据从真实字幕反向构建。教师模型编写一个本可以生成某字幕的用户提示,系统学习从提示到字幕的映射。提示按长度、语言混合、语域、拼写错误率、省略槽位、参考、多镜头请求和排除项进行采样。泄露字幕结构的提示会被拒绝。源字幕使用美学、运动和生动性分数从有吸引力的视频中选择,并带有领域和长度配额。
数据使用方式
- 公开数据、Kling 专用任务数据和多模态 agent 数据被合并到训练语料中,并分配到适当的训练阶段。
- 标准字幕和参考条件示例一起使用。单个目标视频可以通过与不同参考配对贡献多个参考条件示例。
- 真实字幕作为提示增强的训练目标,帮助将用户提示与字幕格式、词汇和句式对齐。
- 提供的摘录未报告确切数据集数量或混合比例;其构建被描述为生产规模且持续进行。
方法
作者们利用多模态理解基础模型 Kling-MLLM 作为共享感知和推理骨干。模型家族包含稠密和混合专家变体。在输入接口处,每个支持的流都被映射到由单一大型语言模型消费的公共序列。
参见框架图:
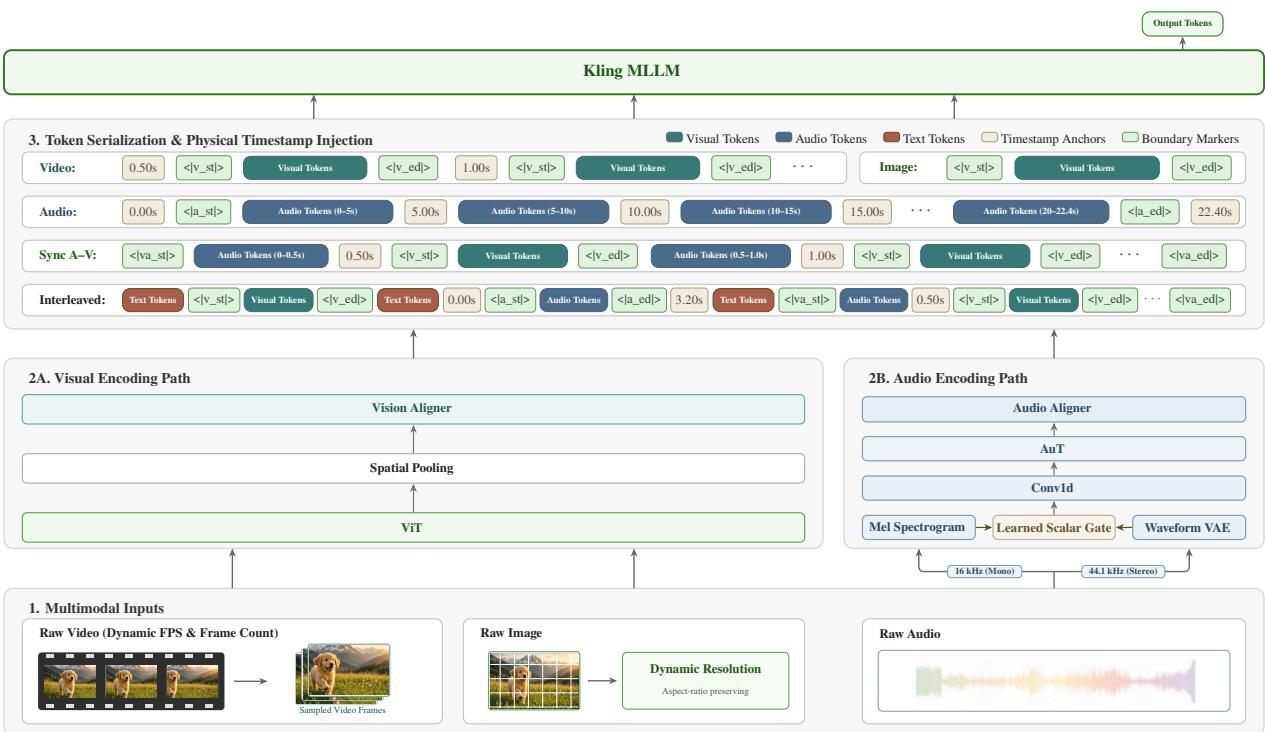
视觉路径由 Vision Transformer、空间池化和视觉对齐器组成。图像以动态分辨率处理,同时保留宽高比。视频使用动态选择的帧率和帧数,每个视觉 token 块与其帧物理时间戳关联。音频路径使用尺度相关塔。较大变体采用双分支塔,融合 Mel 频谱和 waveform-VAE 特征。学习到的标量门将对齐的 VAE 特征残差地加到 Mel 特征上,输出投影到 LLM 隐藏宽度。模态特定的边界 tokens 使每个片段自定界,绝对时间戳提供时间锚点。同步音频和视频在一个元素内联合序列化,保持各模态内的原始顺序。
为弥合用户请求与生成器训练所用的密集字幕分布之间的差距,作者们设计了分为两个模块的提示增强系统:Basic Prompt Enhancement 和 Agentic Prompt Enhancement。
如下图所示:
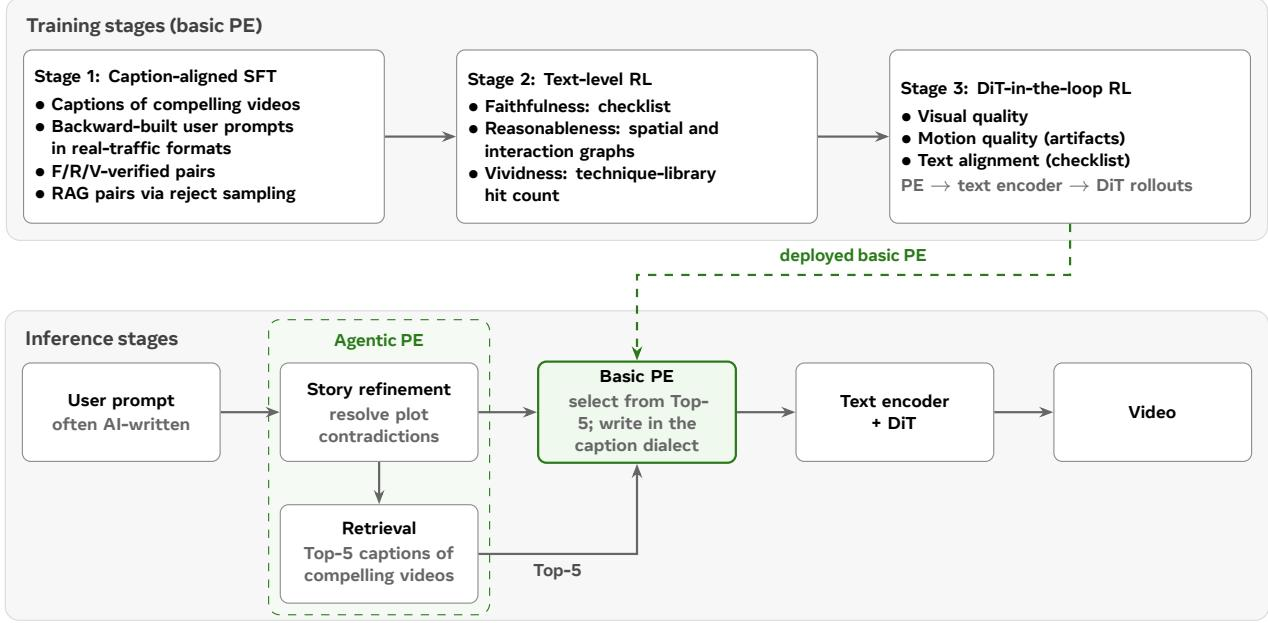
Basic Prompt Enhancement 是一个经过训练的重写器,生成字幕方言中的最终条件。它通过三个阶段训练。第一阶段使用与字幕对齐的监督微调,提示由有吸引力的视频反向构建。第二阶段应用文本级强化学习以优化忠实性、合理性和生动性。第三阶段在环中使用扩散 transformer 进行强化学习,采用视频级奖励。为确保输出与生成器训练分布匹配,需要在格式、词汇和句式层面进行对齐。
参见框架图:
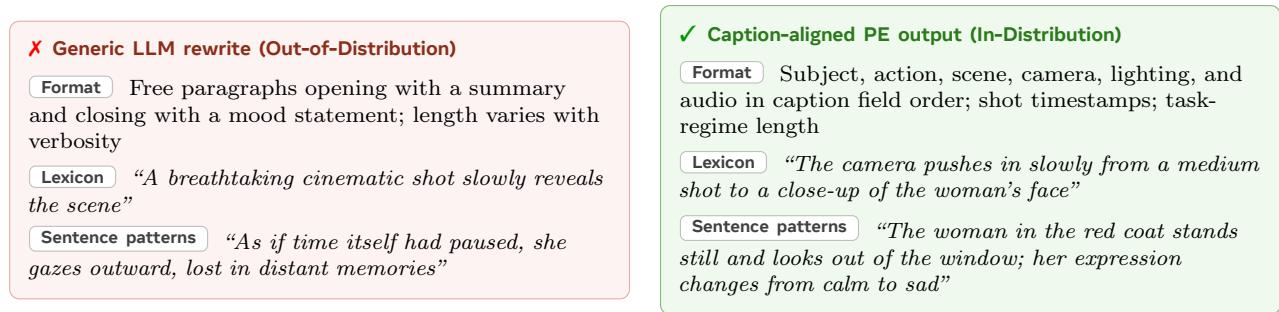
Agentic Prompt Enhancement 在推理时运行在基础模块之前。它执行故事细化以解决用户提示中的情节矛盾,并检索有吸引力视频的顶部字幕作为创意证据。基础模块随后编写最终条件,将检索到的字幕视为可选证据。
为提供后训练和推理时选择的优化信号,作者们构建了奖励模型,分为用于可解释评估的 General Reward Model 和用于快速多维评分的 Decision Reward Model。训练流程分为三个阶段。
如下图所示:
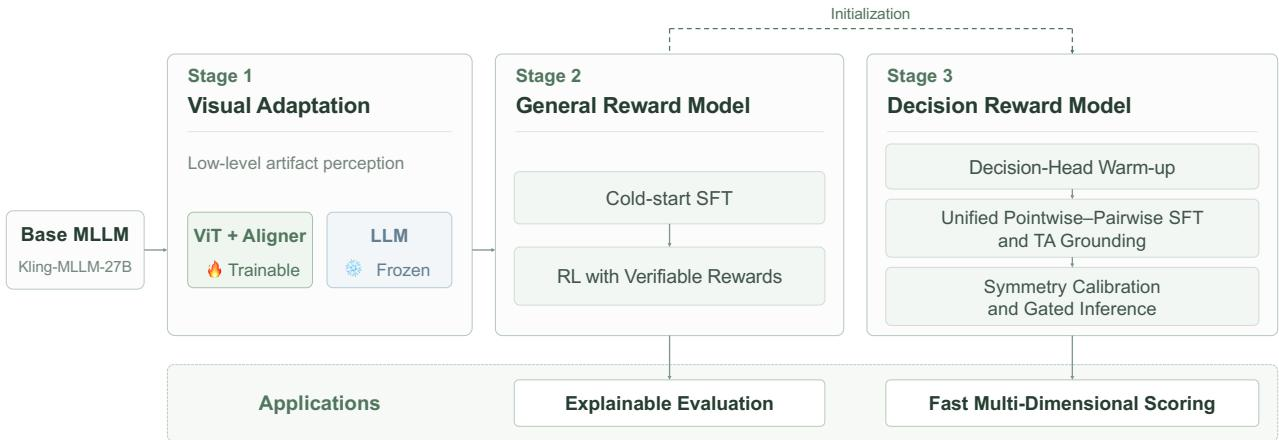
阶段 1 侧重视觉自适应以实现低层伪影感知,冻结语言模型并优化视觉编码器和对齐器。阶段 2 使用冷启动监督微调和带可验证奖励的强化学习训练 General Reward Model,以生成结构化批评和局部缺陷证据。阶段 3 从 General Reward Model 初始化 Decision Reward Model。该阶段训练模型在单次 prefill 中回答多个细粒度问题,使用决策头预热、统一逐点和成对监督微调以及对称校准,以实现快速推理。
实验
实验评估了多模态理解、字幕生成、参考约束生成、提示增强、文本编码器、奖励模型和自动评估协议。Kling-MLLM-397B-A17B 在视频感知、时间理解、音频时间定位和音视频字幕生成方面表现出最明显提升,而图像、语音识别和交错结果仍好坏参半。Kling-Captioner 和 Kling-RGC 在下游字幕生成和参考绑定任务上优于基线,文本编码器的累积改进提升了偏好、指令遵循和美学。该工作进一步认为,评估应依赖原子来源绑定标准、下游生成有效性和按维度的诊断可靠性,而不是表面词汇分数。
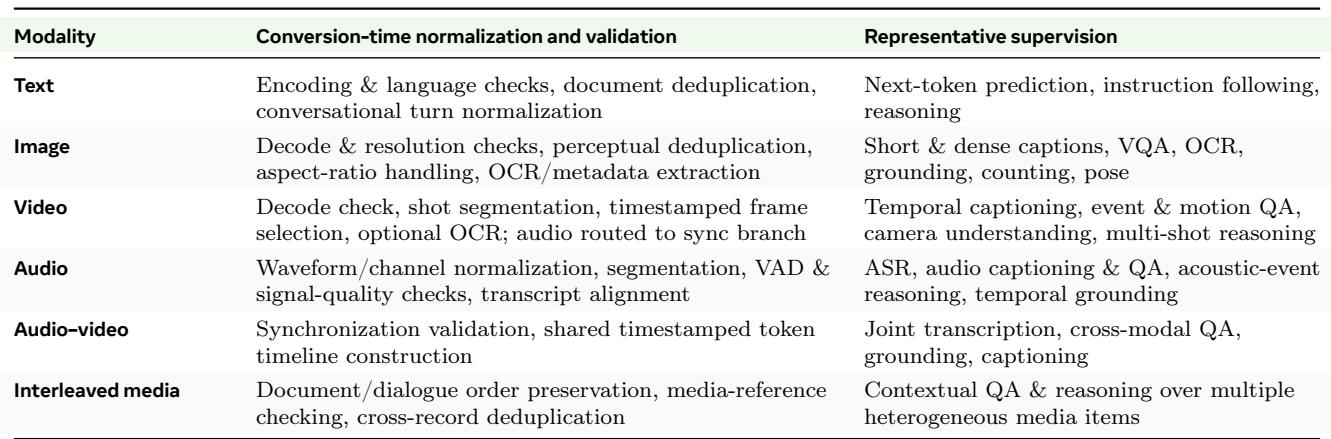
数据流水线定义了针对文本、图像、视频、音频、音视频和交错媒体的模态特定归一化和验证检查,以及代表性监督目标。验证范围从文本的语言和去重检查到音视频和交错内容的同步和媒体参考检查。监督同样涵盖 next-token 预测、字幕生成和 VQA、时间和声学事件推理,以及跨多个媒体项的上下文 QA。文本和图像流水线侧重编码、去重和媒体级检查,而视频和音频流水线增加时间分割、信号质量检查以及时间戳或转录对齐。监督目标从单模态任务(如文本指令遵循和图像 VQA)转向跨模态任务(如联合转录、音视频定位和交错媒体上的上下文推理)。
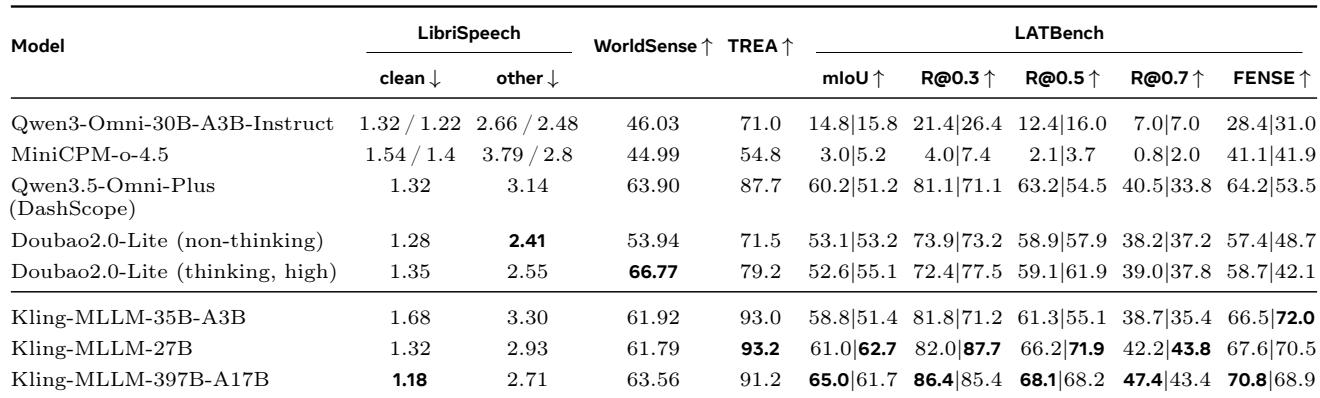
音频评估显示在语音识别、音频理解和时间定位方面排行榜表现不一。Kling-MLLM 变体在 clean LibriSpeech、中文 LATBench、TREA、英语时间定位和英语 FENSE 上领先,而 Doubao2.0-Lite 在 LibriSpeech other 和 WorldSense 上领先。LATBench 中文和英语结果在单个模型内常常出现分化。Kling-MLLM-397B-A17B 在评估模型中取得最低的 LibriSpeech clean 词错误率和最强的中文 LATBench 结果。Kling-MLLM-27B 取得最强的 TREA 和英语 LATBench 时间定位结果,Kling-MLLM-35B-A3B 在英语 LATBench FENSE 上领先。Doubao2.0-Lite 变体在 LibriSpeech other 和 WorldSense 上取得最佳分数,表明在这些领域表现更强。
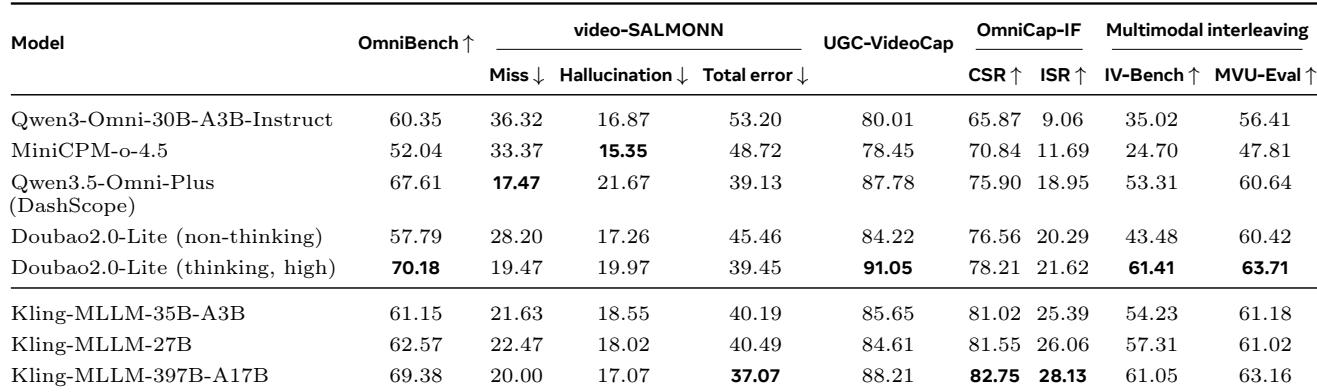
同步音视频基准上的表现分布在多个模型之间:Qwen3.5-Omni-Plus 的 video-SALMONN 漏检率最低,MiniCPM-o-4.5 的幻觉率最低,Kling-MLLM-397B-A17B 的总错误最低,同时在 OmniCap-IF 上领先。Doubao2.0-Lite (thinking, high) 在 UGC-VideoCap 上领先,Kling-MLLM-397B-A17B 是多模态交错方面最强的 Kling 变体,其 IV-Bench 和 MVU-Eval 结果与最佳报告分数相差约半个点以内。Qwen3.5-Omni-Plus 的 video-SALMONN 漏检率最低,而 MiniCPM-o-4.5 的幻觉率最低。Kling-MLLM-397B-A17B 的 video-SALMONN 总错误最低,并在 OmniCap-IF 两项指标上领先。Doubao2.0-Lite (thinking, high) 在 UGC-VideoCap 上领先。Kling-MLLM-397B-A17B 是 IV-Bench 和 MVU-Eval 上最强的 Kling 模型,与最佳报告结果分别相差 0.36 和 0.55 分。
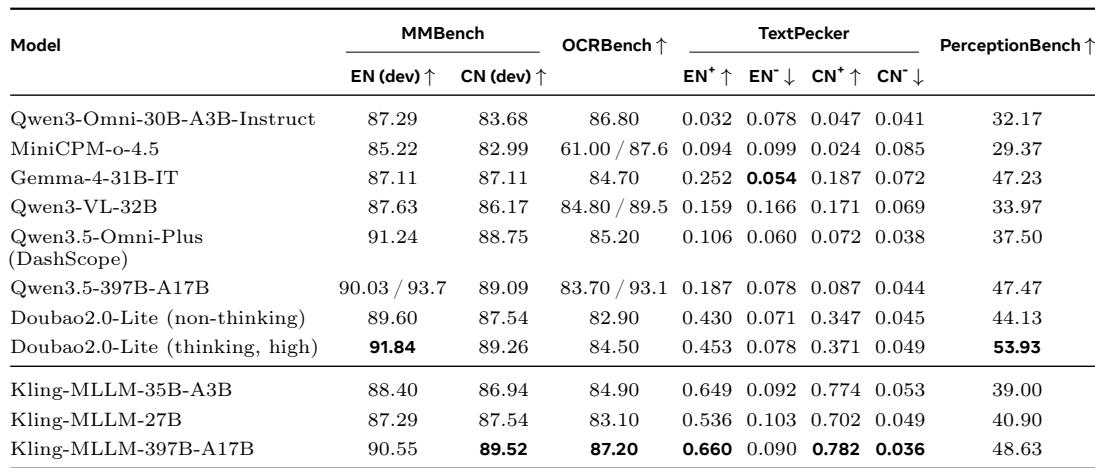
在所列图像模型中,Qwen3.5-Omni-Plus 在内部评估的 MMBench 上领先,Qwen3.5-397B-A17B 在 OCRBench 上领先,Qwen3-Omni-30B-A3B-Instruct 在内部 TextPecker 上领先。PerceptionBench 子指标在英语和中文上仍好坏参半,MiniCPM-o-4.5 在 MMBench、OCRBench 及其内部 TextPecker 结果上落后。Qwen3.5-Omni-Plus 具有最高的内部评估 MMBench 分数,而 Qwen3.5-397B-A17B 具有最高的 OCRBench 分数。Qwen3-Omni-30B-A3B-Instruct 在内部评估的 TextPecker 上领先,MiniCPM-o-4.5 在所列模型中记录了最低的 MMBench 和 OCRBench 分数。
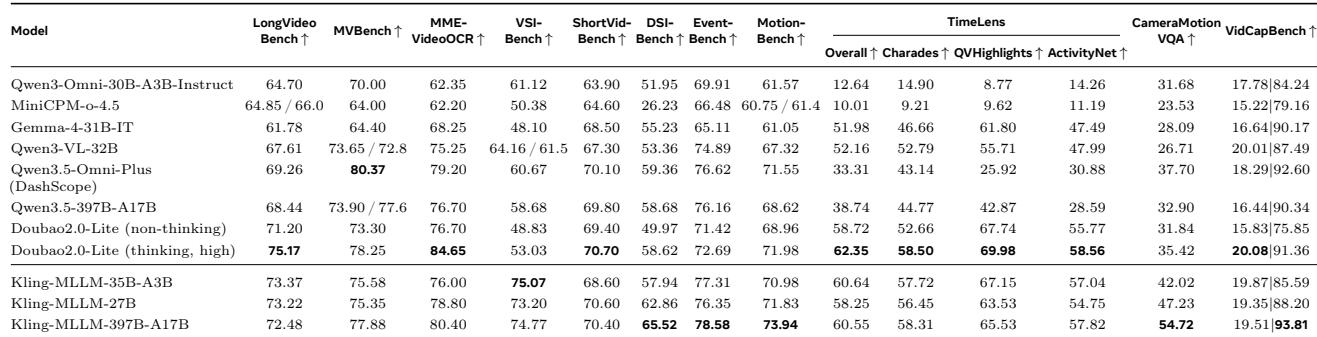
在视频基准上,Qwen3.5-Omni-Plus 是最一贯强大的模型,在 LongVideo Bench、MVBench、MME-VideoOCR、ShortVid-Bench、DSI-Bench、Event-Bench 和 Motion-Bench 上领先。Qwen3-VL-32B 在 VSI-Bench、TimeLens 和 CameraMotion VQA 上最强,其余模型整体竞争力较弱。Qwen3.5-Omni-Plus 在大多数视频理解指标上领先,包括 MVBench、MME-VideoOCR 和 Motion-Bench。Qwen3-VL-32B 在 VSI-Bench、TimeLens 和 CameraMotion VQA 上领先,表明其在时间和相机运动任务上具有相对优势。
实验在文本、图像、视频、音频、音视频和交错媒体上评估多模态数据流水线,使用模态特定验证检查和监督目标,范围从语言去重到时间对齐和跨模态推理。音频和同步音视频排行榜仍好坏参半:Kling-MLLM 变体在语音识别、时间定位和若干音视频指标上表现强劲,而 Doubao2.0-Lite 在鲁棒性相关音频任务上领先,Qwen3.5-Omni-Plus 和 MiniCPM-o-4.5 在特定错误和幻觉度量上表现出优势。图像评估显示 Qwen3.5-Omni-Plus 和 Qwen3.5-397B-A17B 分别在 MMBench 和 OCRBench 上领先,MiniCPM-o-4.5 落后;视频评估则认为 Qwen3.5-Omni-Plus 是最一贯强大的模型,Qwen3-VL-32B 在时间和相机运动任务上最强。