Command Palette
Search for a command to run...
少思考,局部地:面向推理压缩的局部偏好学习
少思考,局部地:面向推理压缩的局部偏好学习
Muyao Yuan Liyan Xu Weizhan Zhang Muyan Jiao Jiangnan Li Jinchao Zhang Jie Zhou
摘要
大型推理模型在挑战性任务上表现强劲,但其长思维链往往在已获得充分信息后仍继续推理,从而带来可观的推理成本。现有推理压缩方法主要作用于推理轨迹,而对在当前状态下是否需要继续推理的局部决策关注较少。本文提出 LoCo,一种面向推理压缩的局部偏好学习方法。LoCo 从模型自身的推理轨迹中检测候选的过度思考状态,冻结相应的推理前缀,从相同状态重新生成经过验证的更短后续推理,并利用由此得到的以状态为条件的偏好对进行 DPO 训练。这种形式化方式教会模型何时继续推理、何时结束,而不是简单地在整体上鼓励更短的推理轨迹。训练数据完全由自生成的数学推理轨迹构建,并在五个数学基准和三个代码生成基准上评估 LoCo。LoCo 在数学任务上将生成长度减少 41.7%–45.4%,在代码任务上减少 23.4%–36.3%,同时保持或提高准确率,并在所有代码基准上取得了最佳 AUC。尽管仅在数学数据上训练,LoCo 仍能持续改善数学任务上的准确率-效率权衡,并有效迁移到代码生成任务,表明用于推理压缩的局部偏好学习具有跨领域通用性。代码与模型将公开发布于 https://github.com/MuyaoYuan/LoCo。
一句话总结
来自西安交通大学 MOEKLINNS、微信 AI 和腾讯公司的研究人员提出了 LoCo,这是一种局部偏好学习方法,可检测候选的过度思考状态,重新生成更短的经过验证的续写,并应用状态条件化 DPO 来教导模型何时结束,在数学任务上将补全长度缩短 41.7–45.4%,在代码任务上缩短 23.4–36.3%,同时保持或提升准确率。
核心贡献
- LoCo 是一种局部偏好学习方法,通过检测候选过度思考状态、冻结相应推理前缀,并从相同状态重新生成更短的经过验证的续写,完全基于自生成的数学推理轨迹构建训练数据。
- LoCo 将推理压缩形式化为利用 DPO 学习状态条件化的继续或结束偏好,教导模型在特定推理状态判断何时结束或继续,而不是全局性地偏好更短的轨迹。
- 在五个数学基准和三个代码生成基准上,LoCo 在数学任务上将补全长度减少了 41.7% 到 45.4%,在代码任务上减少了 23.4% 到 36.3%,同时保持或提升准确率,并在所有代码基准上取得了最佳 AUC。LoCo 还能从纯数学训练迁移到代码生成,表明其具有跨领域泛化能力。
引言
大型推理模型通过扩展思维链推理在复杂数学和编程任务上取得了优异成绩,但这会带来较高的推理延迟和内存开销,而且更长的推理并不总能提高准确率,因为模型在已经达到充分状态后往往会过度思考。先前的压缩方法要么比较完整轨迹,这会给出对更短解决方案的全局偏好,但无法定位不必要的推理,要么应用细粒度编辑来删除或缩短内容,却没有直接建模从当前状态出发是否需要进一步推理。作者提出了 LoCo,一种局部偏好学习方法,它在自生成轨迹中识别过度思考状态,通过对比来自相同推理前缀的经过验证的续写来构造状态条件化偏好,并利用 DPO 学习继续或结束行为。在数学推理和代码生成基准上的评估表明,LoCo 改善了效率与性能权衡,并通过重塑推理偏好而非添加任务特定知识实现跨领域迁移。
方法
作者利用名为 LoCo 的方法,将推理模型自身的过度思考轨迹转换为状态锚定的偏好监督。该过程包含三个连续阶段:局部过度思考检测、经过验证的续写生成和局部偏好学习。
如下图所示:
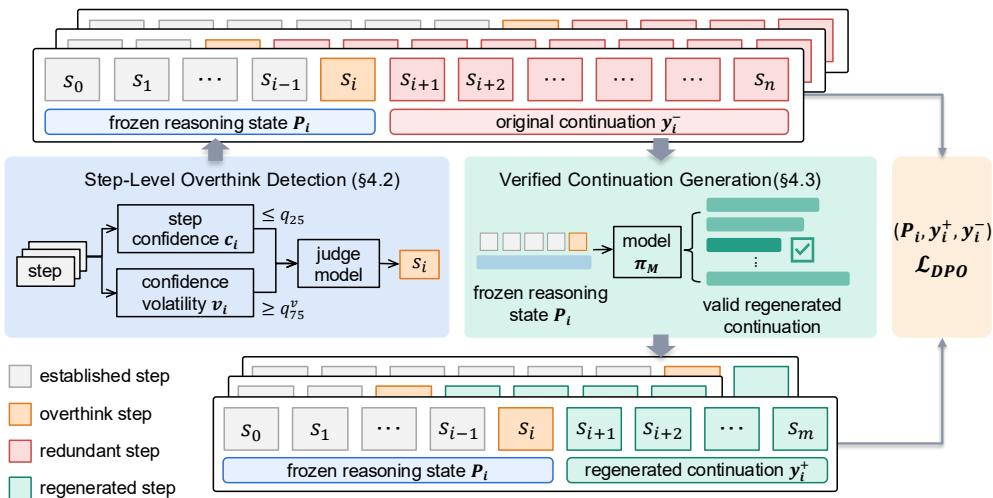
第一阶段是步骤级过度思考检测,通过分析模型的预测置信度来识别模型开始过度思考的推理状态。作者将完整思维链反馈给模型,并在其自身的下一个 token 分布下评分。对于每个步骤,他们通过计算该步骤内所有 token 的最大下一个 token 概率的平均值来得到步骤置信度。他们还测量最近若干步骤滑动窗口上的置信度波动性。过度思考状态被识别为同时表现出低置信度和高波动性的状态,具体来说是步骤置信度低于模型自生成轨迹的第 25 百分位数,且波动性超过第 75 百分位数。为确保可靠性,一个更强的评判模型会重新检查每个被标记的状态。评判模型评估当前推理状态和后续步骤,将其分类为冗余过度思考、正常推进或最终答案。只有被确认为冗余过度思考的状态才会被保留,从而确保有用的进展或最终答案格式不会被丢弃。
在第二阶段,即经过验证的续写生成中,作者冻结每个被保留检测点的推理状态,并从模型采样多个独立续写。如果一个续写完整填充了推理模板,并生成与标准答案符号等价的答案,则该续写被视为有效。在所有有效续写中,选择最短的一个作为偏好续写。来自相同状态的原始续写被指定为拒绝续写。只有在重新生成的续写严格短于原始续写时,该检测点才会被保留。
最后一个阶段是局部偏好学习,从剩余的检测点构造偏好三元组。作者进一步过滤以确保高质量训练数据。只有当 token 节省量达到最低阈值,并且提示和续写都满足特定的 token 长度约束时,配对才会被保留。此外,为防止具有大量检测点的问题主导数据集,每个问题最多保留固定数量的具有最大 token 节省量的配对。
在过滤后的数据集上,作者优化 Direct Preference Optimization 目标。由于所选续写和拒绝续写共享完全相同的冻结前缀,偏好比较严格地以相同推理状态为条件。损失函数定义如下:
LDPO=−E(x,y+,y−)∼D[logσ(β[logπref(y+∣x)πθ(y+∣x)−logπref(y−∣x)πθ(y−∣x)])]其中 πref 是冻结的参考策略,对数似然按相应续写上的 token 对数概率之和计算。该公式教导模型一种局部继续或结束偏好,引导模型在到达特定状态后以更短且有效的续写终止,而不是继续进行冗余推理。
实验
论文在数学推理和代码生成基准上评估了 LoCo,该方法基于自生成的数学推理轨迹和局部压缩切分点,用 DPO 训练 LoRA 适配器。主要评估表明,LoCo 从数学迁移到编码,在保持或提升准确率和 AUC 的同时大幅减少生成的 token,在更困难任务上增益最大,而这些任务中保留困难推理最为重要。消融实验证实,局部切分点对压缩至关重要,自生成续写由于更好的分布对齐而优于外部续写,并且检测器选择的压缩点比随机或均匀替代方案更能保持准确率。
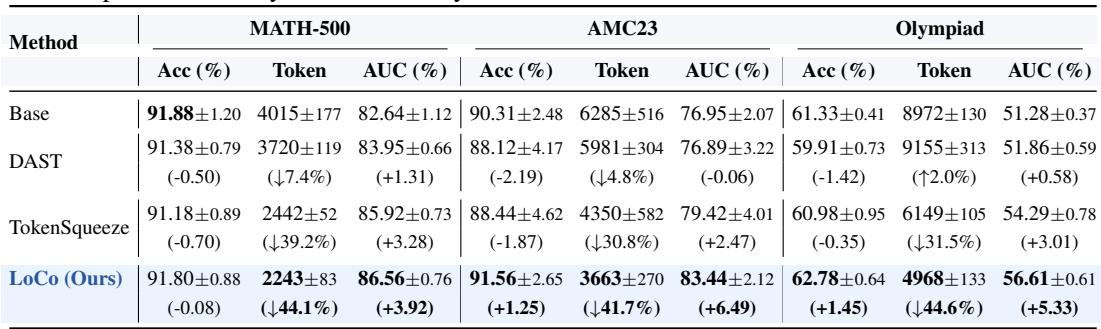
LoCo 在所报告的数学推理基准上实现了最强的 token 缩减,同时相对于基础模型保持或提升准确率。其优势在更难任务上更加明显,在这些任务上,尽管补全长度缩减超过 40%,它仍同时提升准确率和 AUC。与 DAST 和 TokenSqueeze 相比,LoCo 提供了最佳的总体压缩与准确率权衡。在所报告的基准上,LoCo 将生成的 token 减少了超过 40%,是所有方法中缩减幅度最大的。在更困难的基准上,LoCo 在压缩的同时提升了相对于基础模型的准确率和 AUC,而 DAST 可能增加补全长度,TokenSqueeze 则随着难度上升容易损失准确率。
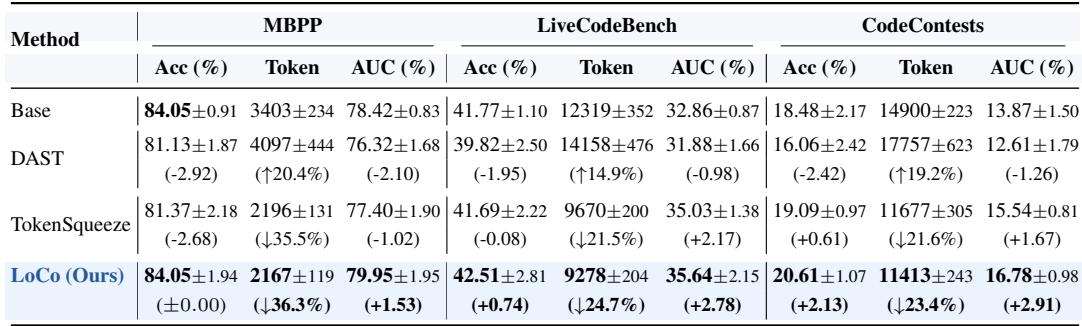
LoCo 将其学习到的压缩偏好从纯数学训练迁移到代码生成。它在 MBPP 上达到与基础模型相当的准确率,同时生成显著更短的补全并提升 AUC;在更困难的编码基准上,它在准确率和 AUC 上优于所有基线,同时使用更少的 token。这一模式与 DAST 形成对比,后者增加 token 使用量并损失准确率;也与 TokenSqueeze 形成对比,后者虽然压缩,但准确率收益较为有限。LoCo 在 MBPP 上达到与基础模型相当的准确率,同时生成显著更短的补全并提升 AUC。在更困难的 LiveCodeBench 和 CodeContests 基准上,LoCo 在减少 token 使用的同时,准确率和 AUC 均优于所有基线。
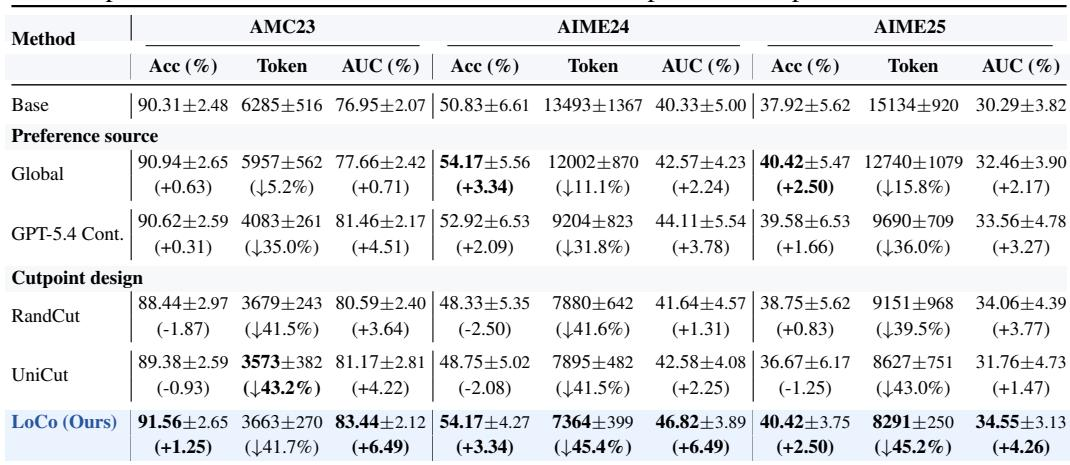
消融实验表明,局部偏好构造和检测器选择的切分点共同促成了 LoCo 更强的压缩能力,同时保持准确率。将局部状态条件化偏好替换为全局轨迹级偏好只会带来适度的 token 缩减。随机切分点可以缩短推理,但在更困难基准上会损失准确率,而自生成续写比外部续写更对齐。局部偏好构造带来了大幅 token 缩减;全局轨迹级偏好在准确率相似的情况下压缩幅度小得多。检测器选择的切分点避免了随机切分点带来的准确率损失,自生成续写优于外部续写。
实验在数学推理和代码生成基准上评估 LoCo,并对其压缩组件进行消融。在数学任务上,LoCo 在所比较方法中实现了最大的 token 缩减,同时保持或提升准确率和 AUC,且在更难基准上收益更加明显。它还能迁移到代码生成,在 MBPP 上以更短的输出达到与基础模型相当的准确率,并在更困难的编码任务上以更少 token 优于基线。消融实验表明,局部偏好构造和检测器选择的切分点在保持准确率的同时推动压缩,自生成续写比外部续写对齐得更好。