Command Palette
Search for a command to run...
CoworkOS:面向真实世界自动化扩展智能体同事
CoworkOS:面向真实世界自动化扩展智能体同事
摘要
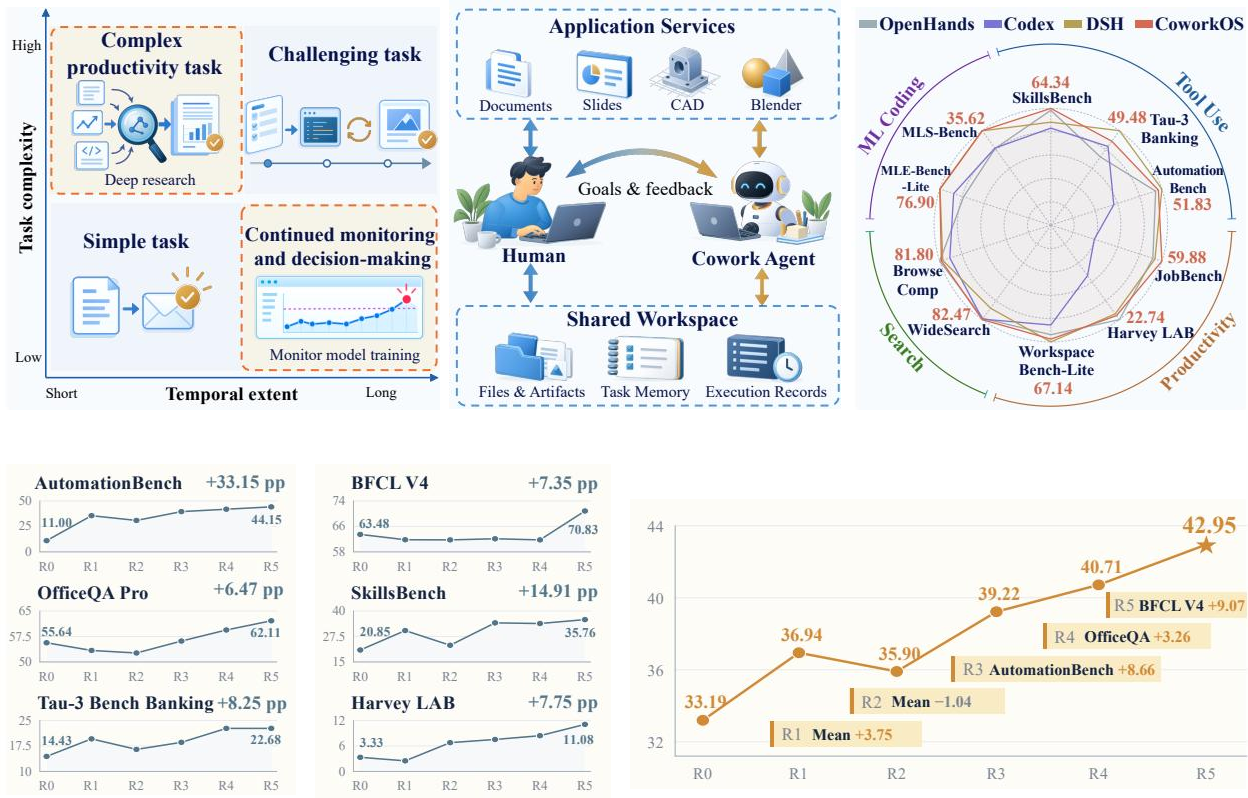
同事型智能体(cowork agent)的快速发展正在推动人类与 AI 的协作向真实世界自动化转变,交付软件、设计和其他工件。然而,此类生产力工作既要求在复杂生产力任务上高质量交付,也要求长周期内的持续监控与决策,这一组合仍然是一个开放挑战。我们提出 CoworkOS,一个面向长周期工作的通用框架,将任务策略与执行管理分离:模型决定动作、委派和验收,运行时维护状态和反馈。其三层架构支持在稳定的职责划分下,以同步或异步方式直接执行或委派给 Subagents(子智能体)。通过共享应用层,人类和智能体可以查看和修改同一组不断演进的文档、演示文稿、CAD 模型和 Blender 场景,因此人在回路(human-in-the-loop)的参与既可以通过对话实现,也可以通过直接修改工作内容来实现。为保持跨智能体和会话的连续性,CoworkOS 进一步引入分层工作区和持久语义记忆,使工作文件、关键决策和长时间运行的 Job 日志在中断后仍可共享、可复用和可恢复。在 12 个基准和 6 类真实世界应用中,CoworkOS 与 Codex、DeepSeek Harness 等前沿智能体应用相比表现出很强的竞争力。作为一项持续性工作案例研究,CoworkOS 以 GLM-5.3 为骨干,对 Qwen3.6-35B-A3B 进行 RSI 驱动的自动化后训练。经过 5 轮,该模型在 8 个基准上的平均得分从 33.19 提高到 42.95(+9.76)。展望未来,我们相信 CoworkOS 为通用协作智能体智能开辟了一条有意义的道路。
一句话总结
中国人民大学、复旦大学、北京大学等机构推出 COWORKOS,一种通用、长程的 agent 运行框架,通过三层架构、分层工作区和持久语义记忆,将任务策略与执行管理分离,使人类和 agents 能够检查并修改同一个持续演化的文档、演示文稿、CAD 模型和 Blender 场景。该框架在 12 个基准上表现出与 Codex 和 DeepSeek Harness 的高度竞争力,并以 GLM-5.3 为骨干,对 Qwen3.6-35B-A3B 开展 RSI 驱动的自动化后训练,在五轮训练中把该模型在八个基准上的平均得分从 33.19 提升至 42.95(+9.76)。
核心贡献
- COWORKOS 是一个面向长程人与 agent 协作的通用运行框架,它将任务策略与执行管理分离:模型决定行动、委派和验收,运行时维护状态与反馈。
- 其共享应用层使人类和 agents 能够检查并修改同一个持续演化的文档、演示文稿、CAD 模型和 Blender 场景,而分层工作区和持久语义记忆使工作文件、决策和作业日志可共享、可复用,并可在中断后恢复。
- 在 12 个基准和六类真实世界应用中,COWORKOS 相较于 OpenHands、Codex 和 DeepSeek Harness 取得了有竞争力的表现;在一个 RSI 驱动的后训练案例研究中,它在八个基准上经过五轮训练,把 Qwen3.6-35B-A3B 的平均得分从 33.19 提升到 42.95。
引言
Agent 系统正走向终身自主,运行框架与模型能力同样重要,因为运行框架决定模型如何调用工具、管理状态、解释反馈并利用可用资源。近期 agent 框架已从工作流级推理和工具使用,发展到助手式持久交互,再到与人类在持续演化的工件上协作的 cowork agents。然而,现有系统通常只面向复杂生产力任务或长时间运行的监控与决策,而不是提供一种统一设计,在两类需求中始终让人类保持参与。作者提出 COWORKOS,一个 cowork 运行框架,通过由 Main Agent、Coordinator Runtime 和 Subagents 组成的三层框架,将模型驱动的任务策略与运行时执行管理分离。它还增加了人在环的应用生态,具备共享工件、持久分层工作区、语义记忆和长时间运行的 Jobs,并在通用基准和真实 cowork 场景中接受评估。
方法
作者提出 COWORKOS,一个为长程和人在环任务执行设计的 cowork 运行框架。该框架由三个主要部分组成:分层 agent 运行时架构、面向人与 agent 协作的可扩展应用生态,以及用于持久 agent 工作区的状态管理。
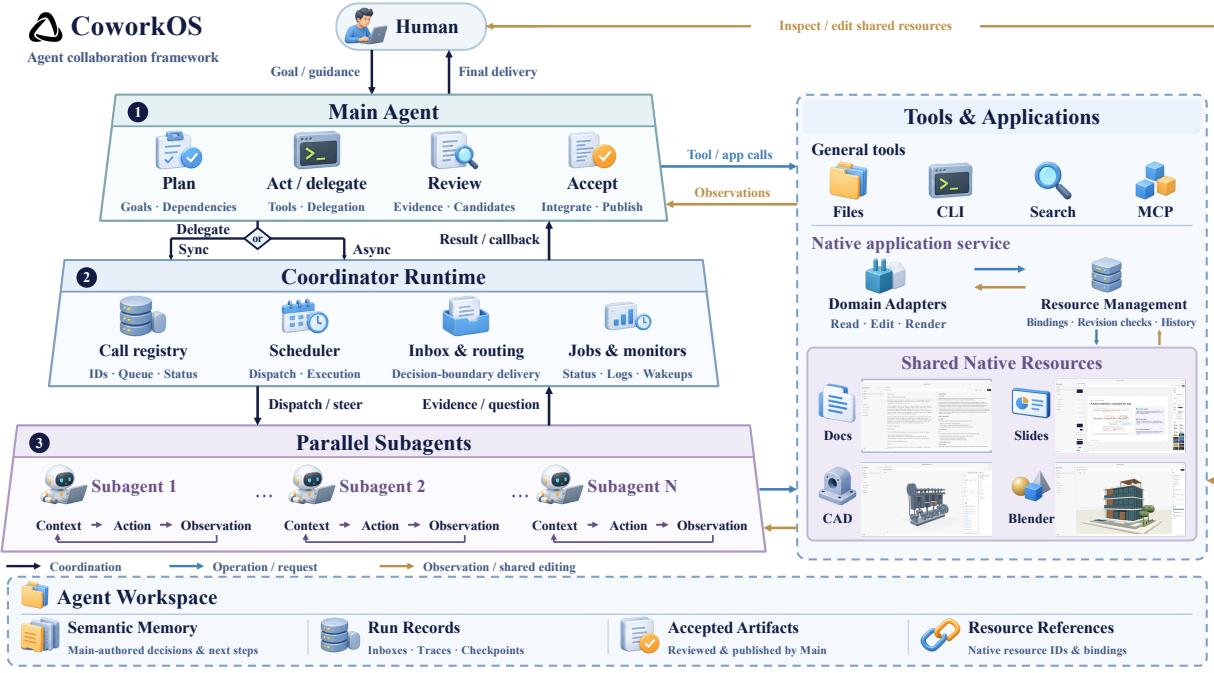
分层 agent 运行时架构通过将权威与执行分离,解决全局一致性与局部执行之间的张力。Main Agent 作为面向用户的界面和总体规划器。在决策步骤 t,它根据 atM∼πM(⋅∣g,htM,Ft) 选择动作,其中 g 是用户目标,htM 是交互历史,Ft 包含新可用的反馈。Main Agent 可以将限定范围的工作委派给 Subagents。对于任务分配 di,Subagent 的初始上下文构造为 ci,0=ΦS(di,b(htiM),Γi,Si),其中提取函数检索有界的近期背景,Γi 指定被授予的工具,Si 是可用技能目录。Coordinator Runtime 作为控制平面边界,在持久程序状态中维护分配和执行状态,状态更新为 ξk+1=FC(ξk,ek+1),其中 ek+1 表示委派请求、执行更新、消息或终止结果。
信息沿层级中的三个方向流动:Main-to-Subagent、Subagent-to-Subagent 和 Subagent-to-Main,表示为通信图 Gt=(Vt,Ethier∪Etpeer)。工作区暴露选定的引用和已接受的工件,而不授予工作者不受限制的写访问权限。
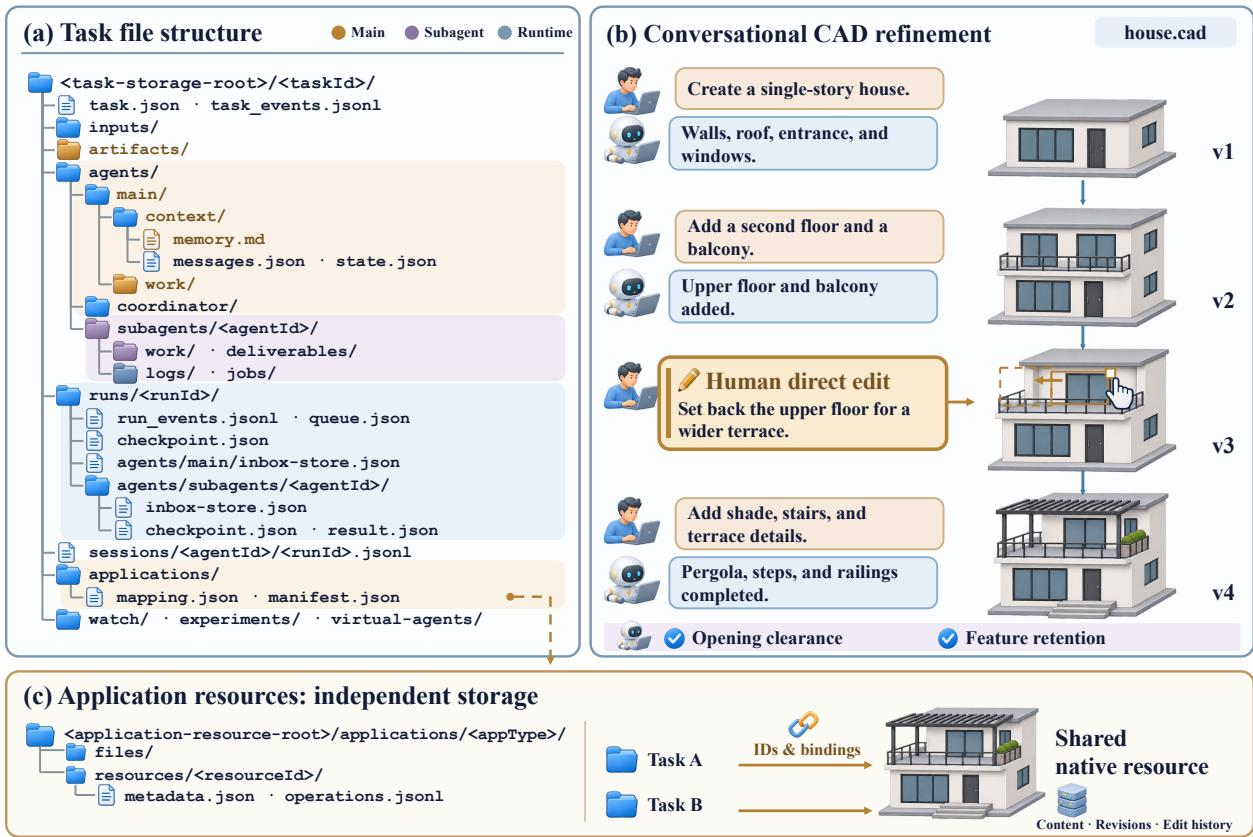
为支持跨多个应用的长程 coworking,作者围绕通用资源协议构建应用生态。平台管理的资源表示为 r=(ι,κ,x,ν),其中 ι 是资源身份,κ 是资源类型,x 是应用拥有的内容,ν 是已提交的修订。对于通过领域验证的新操作 α,提交规则定义如下:
Commit(r,u,v^,α)={(ι,κ,Tκ(x,u,α),v+1),conflict,v^=v,v^=v,其中 v^ 是操作的基准修订,u 标识人类或 agent 操作者。原生应用将资源保持在平台控制之下,使直接的人类编辑能够与 agent 动作参与同一个协调循环。agent 的应用上下文包括当前资源和未确认更改:ct,appa=Φκ(rt,st,Δνa:νt¬a),其中 νt 是当前修订,νa 是 agent 最后确认的修订,st 是已保存的选择。
状态管理确保长程 Task 在多次执行之间保留进度。保留的 Task 状态表示为 zk=(Wk,Pk,Rk),其中 Wk 包含工作对象,Pk 记录进度和证据,Rk 记录正在进行的执行和待处理反馈。agent 在有界决策上下文中使用持久 Task 状态和可用历史:ck=Φ(g,hk,zk),且 tokens(ck)≤L。为了在历史增长时重建 Main 的上下文,运行时将持久记忆中的目标与重要决策同当前运行时状态结合。在阶段边界,任务上下文构造为 ct,taskM=Φctx(mT,ρT(t),dT(t))⊕ht,recentM,其中 mT 是语义记忆,ρT(t) 投影运行时状态,dT(t) 总结已记录的实验。工作区将工作对象与进度记录保留在一起,agent 工作材料、Run 记录和已发布工件在 Task 下占据不同作用域。
实验
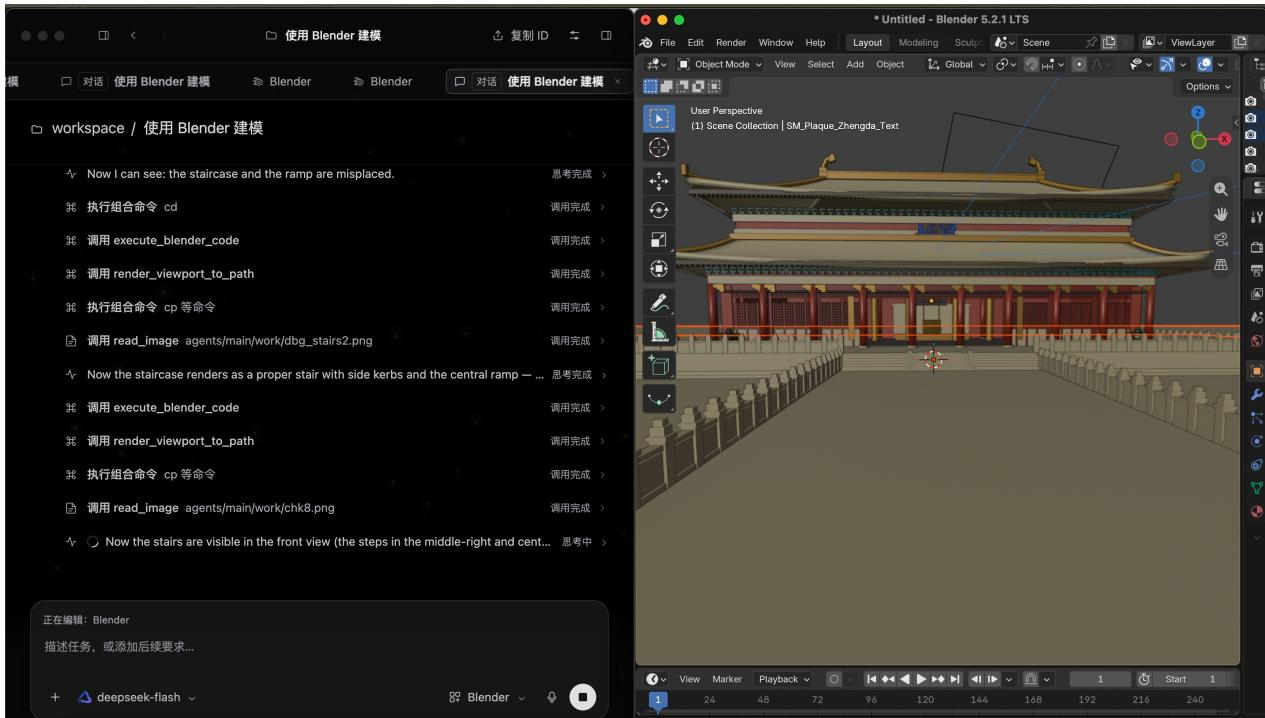
COWORKOS 在涵盖工具使用、生产力、搜索和机器学习编码的十二个基准上接受评估,并与 OpenHands、Codex 和 DeepSeek Harness 进行比较,在多个领域取得最佳结果,整体表现最强。针对真实世界任务的定性实验,包括前端网站、游戏、办公工件、交互式可视化、CAD 和 Blender 渲染,表明 COWORKOS 产出更清晰的分组、更丰富的细节和更易读的交互式交付物。在 AI 自动化后训练实验中,COWORKOS 使用 GLM-5.3 指导针对 Qwen 模型的五轮反馈驱动训练,将平均基准得分从 33.19 提高到 42.95,展示了持续的长程模型改进。
COWORKOS 在每个领域平均得分中均位列前两名运行框架,在生产力与机器学习编码平均得分上领先,并在工具使用与搜索上与领先者接近。它在 SkillsBench、JobBench、WideSearch 以及两个机器学习编码基准上取得最佳分数,表明其在工具执行、知识工作、信息检索和机器学习实验中具有广泛优势。总体而言,COWORKOS 在该基准集的被评估运行框架中表现最强。
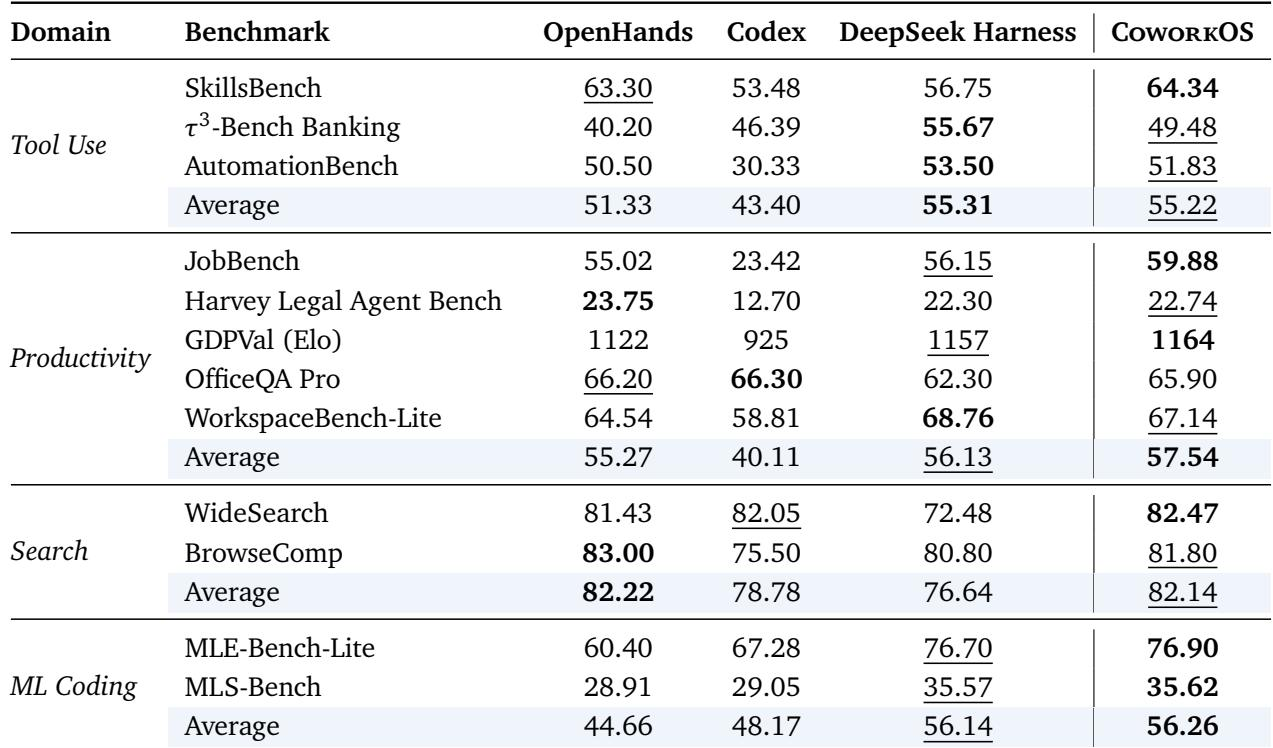
COWORKOS 在每个领域平均得分中均位列前两名运行框架,在生产力与机器学习编码上平均得分最高,并在 SkillsBench、JobBench、WideSearch 以及两个机器学习编码基准上取得最佳分数。它在工具使用上与 DeepSeek Harness 接近,在搜索上与 OpenHands 接近,同时领先 JobBench,并在 Harvey Legal Agent Bench、WorkspaceBench-Lite 和 GDPVal 上位列前两名。这些结果表明其在工具执行、知识工作、信息检索和机器学习实验中具有广泛优势,使 COWORKOS 成为该基准集中整体表现最强的运行框架。