Command Palette
Search for a command to run...
MoviEdit:让长视频多镜头视频编辑变得简单
MoviEdit:让长视频多镜头视频编辑变得简单
Suhyeon Lee Zhengang Li Soo Ye Kim Peihao Zhu Jong Chul Ye Chun-Hao Paul Huang Duygu Ceylan Yan Kang Hyeonho Jeong
摘要
长视频多镜头视频编辑要求预期编辑在场景、视角和主体外观发生突然变化时保持连贯一致,同时需要处理比传统单镜头编辑器显著更长的视觉上下文。我们提出了 MoviEdit,一个用于可扩展长视频多镜头视频编辑的端到端框架,联合应对数据、建模和评估方面的挑战。为了大规模提供跨镜头监督数据,我们开发了自动数据生成流水线,涵盖同步多视角素材、真实世界多镜头视频和生成的多镜头内容,无需人工标注即可得到 87K 个成对编辑视频。在架构上,MoviEdit 采用级联式双向–自回归设计:轻量级双向阶段首先在时空压缩表示上建立全局连贯的编辑草稿,该草稿随后在全视频上以自回归方式传播并细化。我们还进一步引入了 MoviEdit-Bench,一个专门用于系统评估长视频多镜头视频编辑的基准。大量实验表明,MoviEdit 在文本引导和图像引导编辑中显著优于现有开源模型,并与业界前沿模型表现相当。请访问我们的项目页面以获取完整结果并访问基准:multi-shot-edit.github.io
一句话总结
来自 Adobe 和 KAIST 的研究者提出了 MoviEdit,一个用于长视频多镜头视频编辑的端到端框架,该框架结合了可自动生成 87K 成对编辑视频的数据生成流水线、级联双向自回归设计以及 MoviEdit-Bench,在文本引导和图像引导编辑上大幅超越开源模型,并达到业界前沿编辑器的水平。
核心贡献
- 本文提出了自动数据生成流水线,结合同步多视角素材、真实世界多镜头视频和生成的多镜头内容,在无需人工标注的情况下创建 87K 成对编辑视频。
- MoviEdit 采用级联双向自回归设计,其中轻量级双向阶段先在时空压缩表示上建立全局一致的编辑草稿,随后自回归阶段将该草稿在全视频上传播并细化。
- 本文贡献了 MoviEdit-Bench,用于系统化评估长视频多镜头编辑;实验表明,MoviEdit 在文本引导和图像引导编辑上大幅超越现有开源模型,并与业界前沿模型表现相当。
引言
长视频编辑之所以重要,是因为视觉叙事的意义来自镜头之间的关系,因此编辑必须在场景、视角、运动和外观发生变化时仍能在剪辑之间保持连贯。此前的视频编辑方法大多针对短单镜头片段设计;独立编辑各个镜头会丢失跨镜头依赖,而随着时长增加,联合处理完整源序列和目标序列在计算上变得难以承受。作者指出已有系统中三个相互耦合的瓶颈:带有明确跨镜头主体对应关系的成对训练数据稀缺,在 token 拼接和全局自注意力下建模内存开销大,以及缺少面向跨镜头定位和一致性的专用基准。为解决这些问题,他们提出 MoviEdit,一个端到端框架,包含可扩展的数据生成流水线(结合多视角感知图像编辑、单镜头视频编辑和基于 VLM 的过滤)、级联双向自回归扩散架构(先建立全局一致的编辑草稿,再进行因果传播),以及 MoviEdit-Bench,一个带有自动化指标的长视频多镜头编辑专用基准。这为将视频编辑从孤立片段推进到连贯的长视频叙事提供了监督、架构和评估基础设施。
数据集
训练成对数据
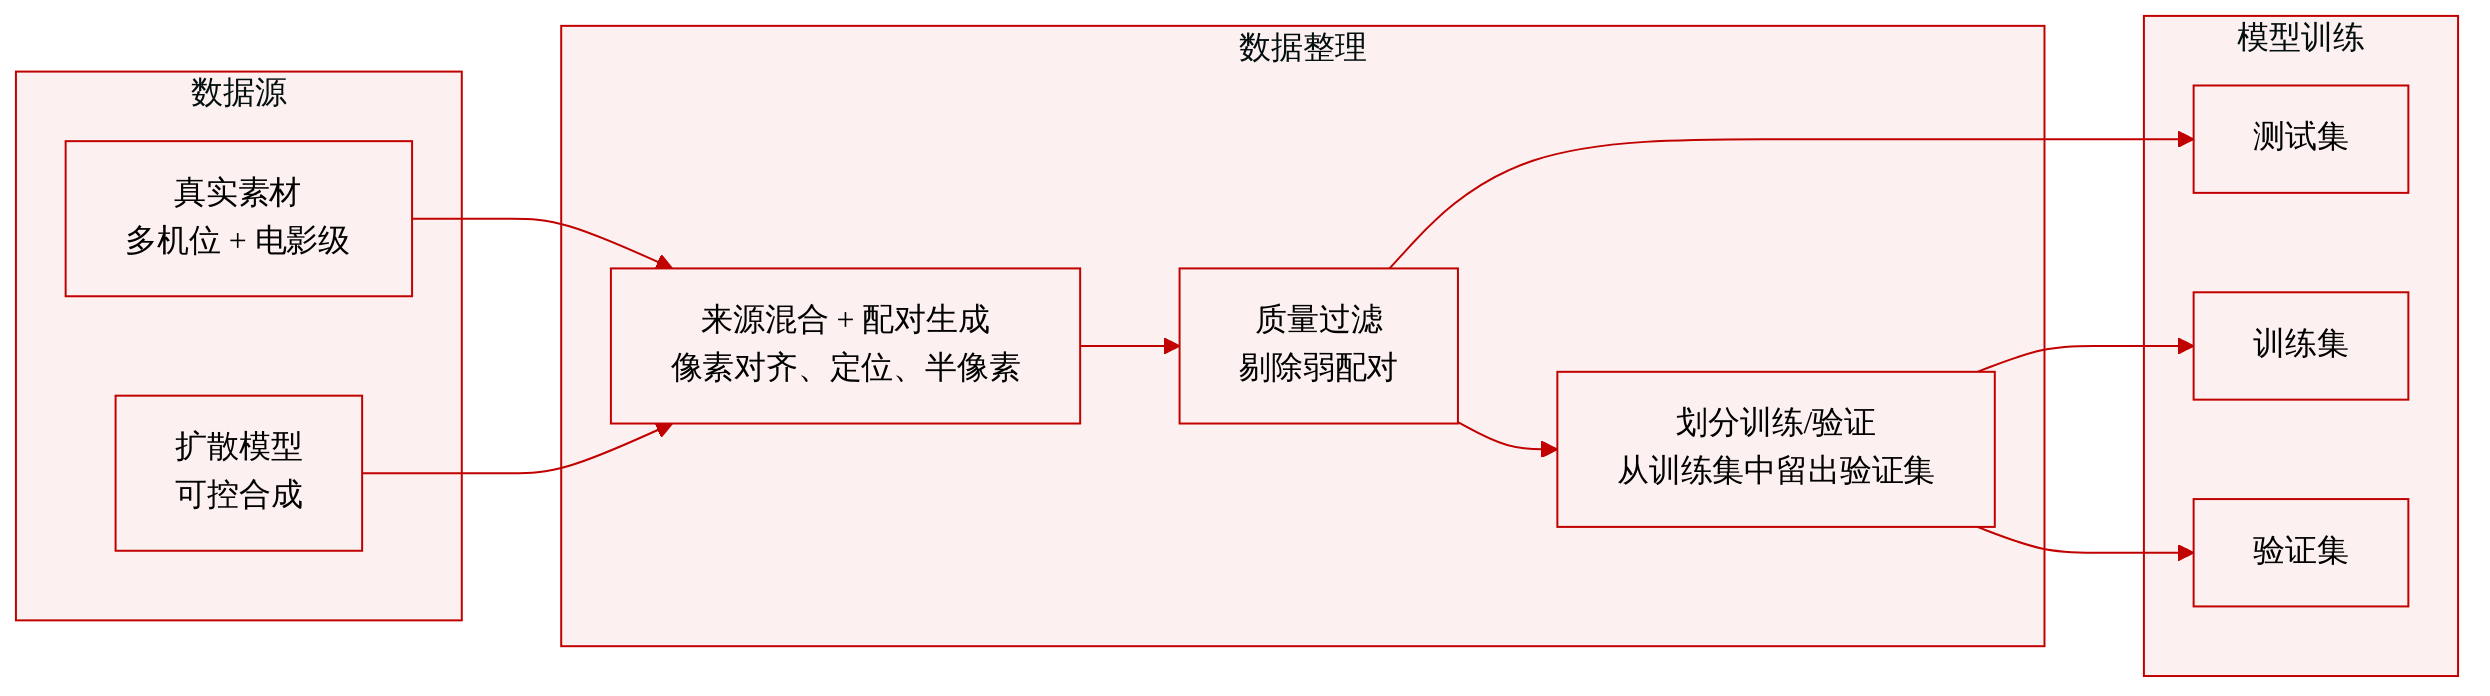
- 作者在无需人工标注的情况下从三个来源生成成对监督:内部同步多摄像机素材、真实世界电影镜头片段,以及预训练的多镜头文本到视频扩散模型。
- 这些来源支持三种监督形式:像素对齐编辑、主体定位和半像素对齐编辑。
- 多摄像机素材提供跨视角对应关系,电影镜头片段提供真实感,扩散模型提供可控合成。
像素对齐编辑对
- 片段通过镜头检测和场景分组从电影来源采集,或通过摄像机视角选择和时间剪辑从同步多摄像机素材中采集。
- 视觉语言模型提出候选主体查询,并合并同一实体在不同镜头中的观测。
- 支持的编辑包括对象级更改,例如添加、移除、替换和外观更改,以及全局更改,例如环境更改和风格化。
- 所有镜头的首帧被排列成单个图像网格并联合编辑,然后每个编辑后的首帧在其所属镜头内传播。
- 质量过滤在首帧阶段拒绝 17% 的多摄像机对,在传播阶段拒绝 38%。对于电影镜头对,拒绝率分别为 32% 和 47%。
主体定位对
- 视频分割模型在所有出现查询主体的镜头中跟踪该主体,并生成逐帧密集掩码。
- 支持的局部效果包括高亮、描边和颜色填充。
- 视觉语言模型过滤拒绝 24% 的生成对。
半像素对齐编辑对
- 使用预训练的文本驱动多镜头视频生成器进行环境更改、媒介更改和角色外观更改。
- 源生成和目标生成共享每镜头描述和初始噪声,同时 LLM 创建仅修改目标属性的不同全局描述。
- 对于角色外观更改,源和目标共享去噪轨迹直到分叉时间步。
- 对于环境更改和媒介更改,目标通过 ControlNet 以从源中提取的 HED 边缘图或深度图为条件。
- 视觉语言模型质量控制拒绝 66% 的对。对于基于 ControlNet 的对,在构建训练对时会交换源和目标。
用途
- 像素对齐编辑任务是主要训练设置。
- 生成的多镜头片段和主体查询用于为编辑模型构建成对的源-目标监督。
- 详细的训练数据统计见附录,数据配方消融实验另行报告。
MoviEdit-Bench
- 该基准包含 64 个生成的多镜头视频和 128 个编辑场景。
- 视频分为八个类别,具有不同的跨镜头主体绑定难度,从单个重复出现的主体到拥挤的多主体和混合人兽场景。
- 支持文本引导视频编辑和编辑帧引导传播,并包含首帧和非首帧参考场景。
- 局部编辑包括添加、移除、外观更改和替换。全局编辑包括环境更改和风格化。
- 评估覆盖七个维度:非主体保留、编辑定位、主体保留、跨镜头编辑一致性、编辑提示对齐、视频质量,以及传播中的编辑帧保真度。
- 源视频和编辑后视频在空间和时间上对齐,时间指标在每个镜头内独立计算。
- 该基准结合像素级指标、基于嵌入的相似度和视觉语言模型判断。
方法
作者开发了一个用于长视频多镜头视频编辑的端到端框架,首先构建可扩展的成对数据生成流水线,在无需人工标注的情况下构造监督。这些流水线利用多样化的视频来源支持三种不同的监督形式:像素对齐编辑、主体定位和半像素对齐编辑。
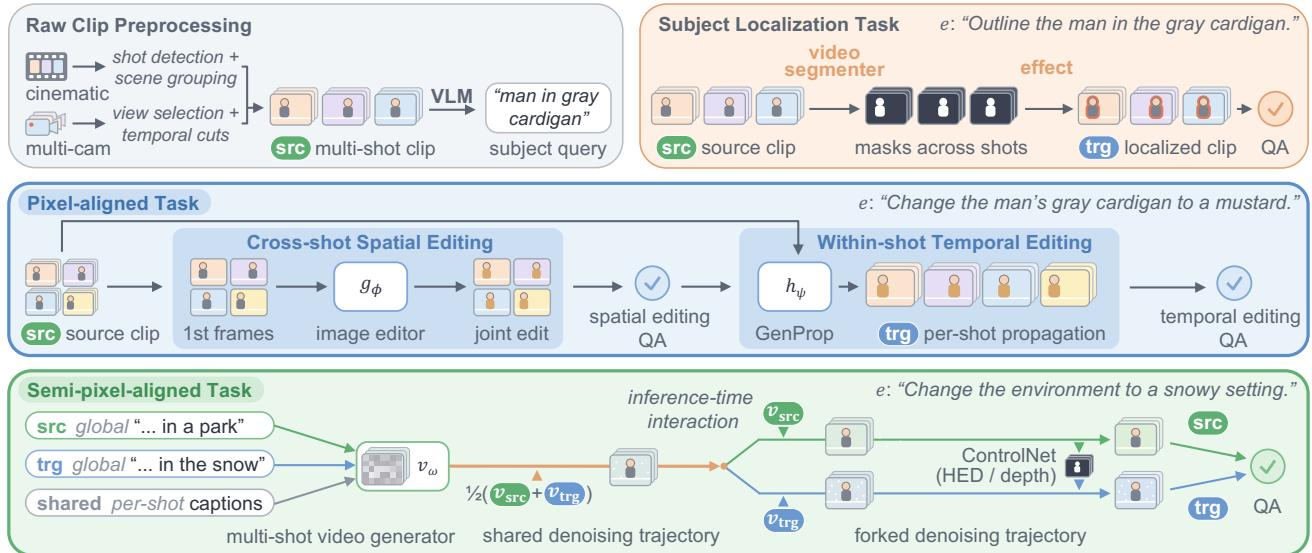
对于像素对齐编辑任务,作者通过将过程分解为两个子问题来应对跨镜头一致性的关键挑战:跨镜头空间编辑和镜头内时间编辑。所有源镜头的首帧被排列成单个图像网格,并使用现成的文本引导图像编辑模型 gϕ 一次性联合编辑。然后,每个编辑后的首帧使用预训练的首帧条件单镜头视频编辑模型 hψ 在对应镜头内独立传播:
y~1:S1=[y~11;…;y~S1]=gϕ([y11;…;yS1],e),xs=hψ(y~s1,ys,e),s=1,…,S其中 e 表示编辑指令。两个阶段均应用质量过滤,以确保编辑成功和一致性。主体定位流水线利用视频分割模型在镜头间跟踪查询主体并生成逐帧密集掩码,并应用高亮或描边等局部视觉变换。半像素对齐编辑流水线生成保持空间结构和叙事对应关系但不需要严格像素级对齐的对。它通过共享每镜头描述和初始噪声来耦合源生成和目标生成。对于角色外观更改,源和目标共享共同的去噪轨迹直到分叉时间步 tfork,在该时间步使用平均速度预测更新共享潜变量:
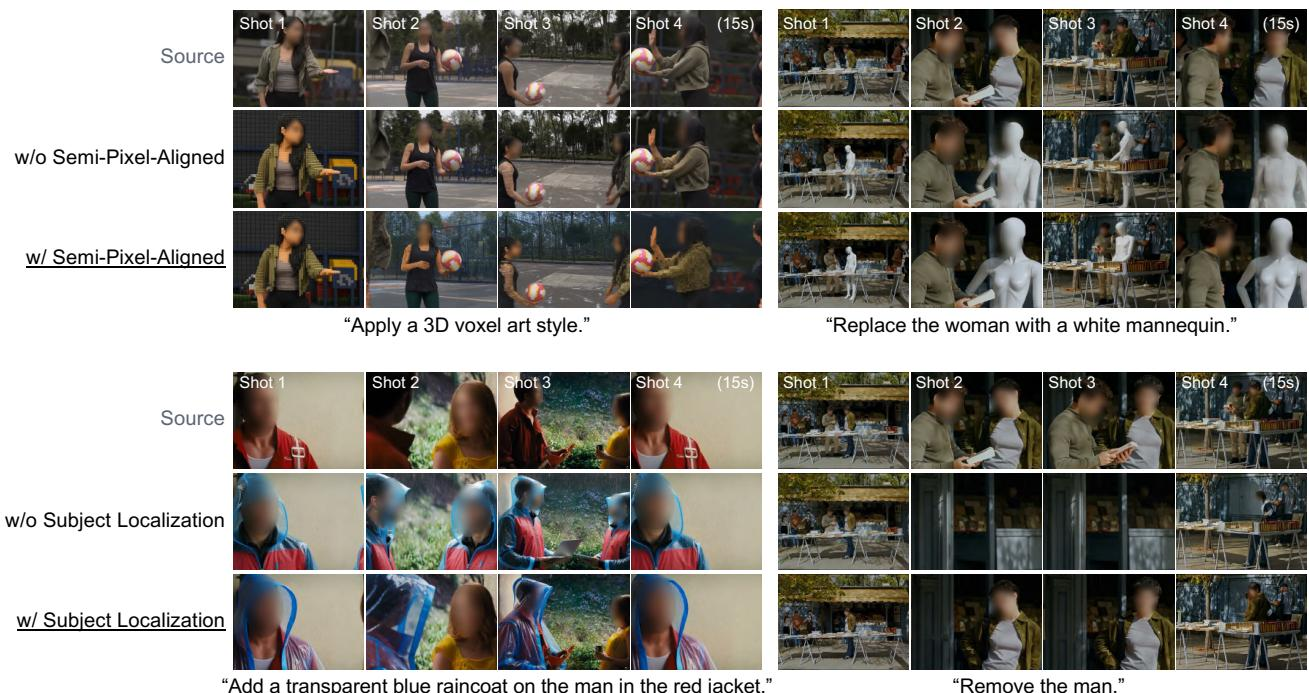
v~(zt,t)=(vω(zt,esrc,t)+vω(zt,etgt,t))/2对于环境和媒介更改,目标生成通过 ControlNet 以从源视频中提取的结构图为条件。作者证明,纳入这些特定数据配方能显著提升模型泛化能力和编辑定位能力。
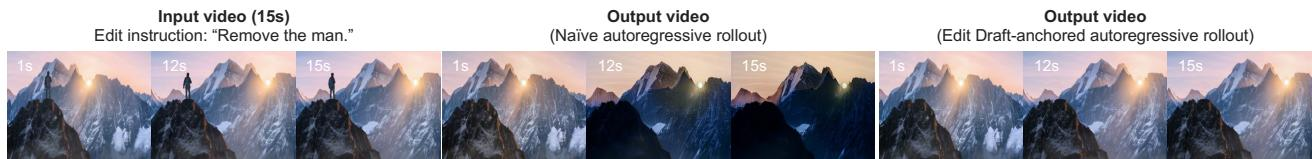
为建模长视频,作者采用级联架构,以缓解标准逐块自回归扩散中固有的累积外观漂移和过饱和问题。朴素的自回归推演通常在长时间范围下出现视觉质量下降,而引入全局编辑草稿可有效解决该问题。
该架构由 Draft Editor 和 Render Editor 组成,二者共享模型权重,但注意力模式和时空分辨率不同。Draft Editor 将标准 DiT 去噪器 fθ 双向应用于经过空间和时间下采样的视频序列,生成全局一致的编辑草稿。该草稿作为稳定的外观锚点,建立跨镜头一致性。随后,Render Editor 以该草稿为条件执行全分辨率逐块因果扩散。
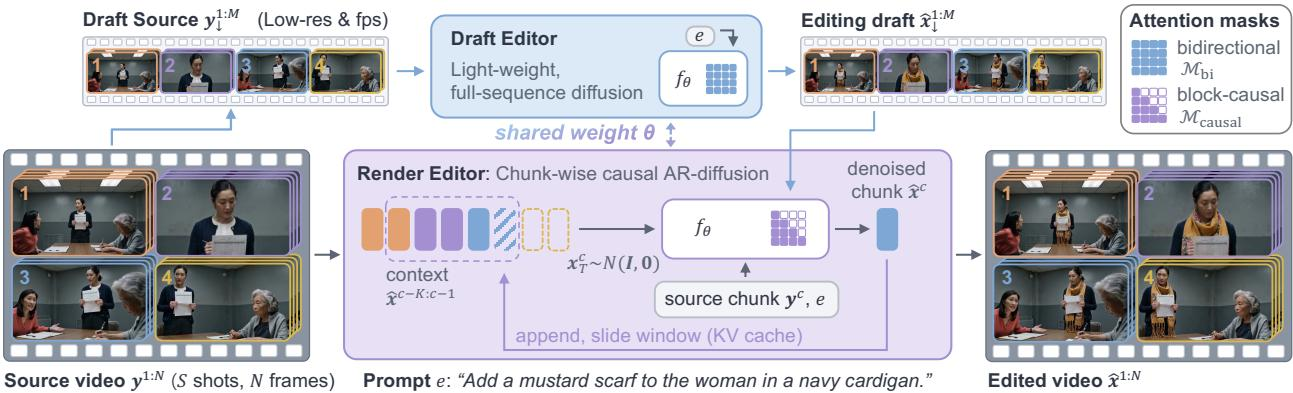
训练期间,Render Editor 使用因果扩散强制(CDF)目标进行优化:
LCDF(θ)=Ex,t,ϵ[c=1∑C[fθ(xt1:C;Mcausal)]c−vtcc22]其中因果自注意力掩码 Mcausal 确保每个块仅使用自身和上下文窗口内先前的块进行预测。推理期间,Render Editor 以最近生成的上下文、全局草稿和对应源块为条件自回归地生成各个块。
为降低推理延迟,作者采用非对称步数调度的统一蒸馏。按照速度矩匹配方法,Draft Editor 被蒸馏到 12 个去噪步骤,而计算量更大的 Render Editor 被蒸馏到 4 个步骤。此外,自回归形式和因果注意力掩码自然支持 KV 缓存,使系统能够缓存可复用 token 的键值状态,并在渲染阶段消除冗余计算。
实验
该工作提出了 MoviEdit-Bench,一个长视频多镜头视频编辑基准,用于在多样化主体、局部和全局编辑以及多个一致性维度上评估文本引导和编辑帧引导编辑。实验表明,MoviEdit 在文本引导整体性能上最强,在编辑帧引导成功率上最高,并且在源保留、编辑定位和提示对齐方面优于公开和专有基线,而后者往往会传播伪影或偏离源运动和时序。规模与效率研究表明,更多数据和训练带来持续提升,优化注意力和蒸馏大幅降低推理延迟,消融实验确认半像素对齐数据有助于结构化编辑,主体定位监督可改善目标识别。其他应用展示了在多参考编辑、视频集合到集合编辑和更长序列上的泛化能力,但相似的模糊主体和部分目标可见性仍是主要失败场景。
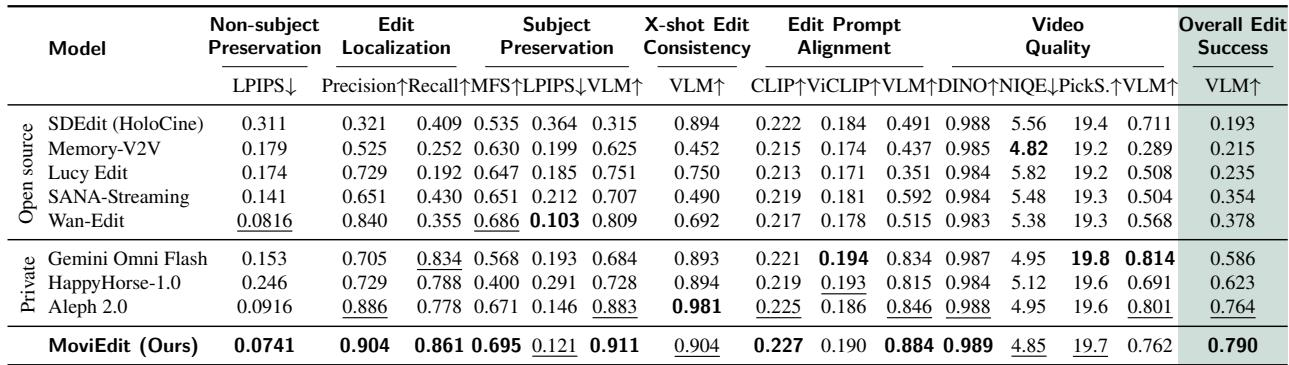
MoviEdit 在长视频多镜头文本引导视频编辑上取得最强整体性能,在整体编辑成功率上超越 Runway Aleph 2.0,并在大多数评估指标上领先。在所列基线中,Gemini Omni Flash 显示出最高的整体编辑成功率和较强的主体保留,Wan-Edit 在开源模型中的非主体保留和编辑定位上领先。公开基线通常出现传播伪影、跨镜头编辑定位错误和源一致性差等失败。MoviEdit 在 15 秒多镜头 V2V 编辑上优于公开和专有系统,在整体编辑成功率上超越 Runway Aleph 2.0。Wan-Edit 取得开源模型中最佳的非主体保留和编辑定位分数,Gemini Omni Flash 则在所列基线中记录最高的整体编辑成功率。
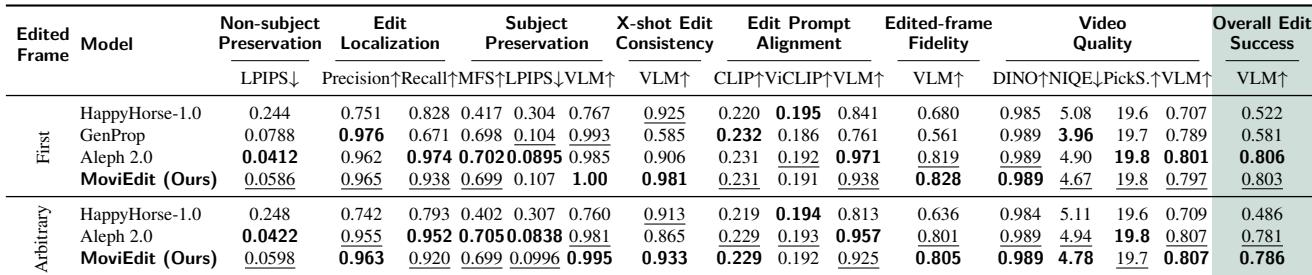
在编辑帧引导传播上,MoviEdit 在整个基准上取得最高整体成功率,并在各项指标上与 Aleph 2.0 表现相当,各维度优势互补。Aleph 2.0 是整体最强的基线,而 HappyHorse 在非主体保留、编辑定位和跨镜头编辑一致性上持续较弱。GenProp 展现出较强的定位精度,但在召回率和保真度指标上落后。MoviEdit 在编辑帧引导传播的整体编辑成功率上领先,并在各个评估维度上与 Aleph 2.0 相当。HappyHorse 在非主体保留、编辑定位和编辑一致性上落后,而 GenProp 显示高精度但召回率和编辑帧保真度较低。
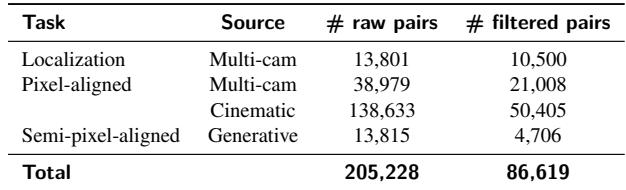
训练集结合了多摄像机定位、多摄像机像素对齐、电影镜头像素对齐和生成式半像素对齐编辑对,视频为 540p、时长为 10 到 15 秒,每个视频包含 4 到 6 个镜头。过滤将约 205K 原始对减少到约 87K 对,其中电影镜头像素对齐数据占比最大,生成式半像素对齐数据占比最小。不同流水线的保留率不同,主体定位对的保留率最高。电影镜头像素对齐对贡献了最终过滤数据集的过半数据。主体定位对保留率最高,保留了超过四分之三的原始对。生成式半像素对齐对是最小的一组,在过滤中减少约三分之二。总体而言,过滤后约每五个原始对中保留两个。
推理延迟消融显示,每个优化步骤都降低了总去噪时间,其中 render editor 贡献了大部分成本。滑动窗口注意力和 KV 缓存带来逐步加速,加入少步蒸馏产生最大收益,使总时间低于输入视频时长。全时间注意力基线最慢,render editor 时间占总时间主导。滑动窗口注意力降低 render editor 延迟,KV 缓存进一步以更大幅度降低延迟。将少步蒸馏与注意力和缓存结合,带来约 31 倍总加速,并将总时间减少到约 12 秒。
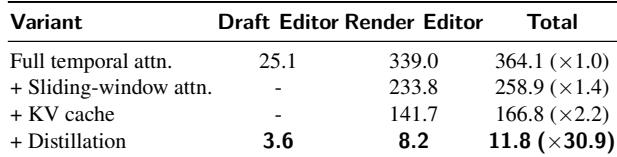
MoviEdit 在长视频多镜头文本引导视频编辑和编辑帧引导传播上进行了评估,取得最强的整体编辑成功率,并在各项指标上与专有系统 Runway Aleph 2.0 表现相当。公开基线通常存在传播伪影、跨镜头编辑定位错误和源一致性差的问题,而 Wan-Edit 在开源模型中的非主体保留和编辑定位上领先。训练流水线将约 205K 原始多镜头编辑对过滤到约 87K,其中电影镜头像素对齐数据贡献最大份额,主体定位对保留率最高。推理消融显示,滑动窗口注意力、KV 缓存和少步蒸馏逐步降低去噪时间,带来约 31 倍总加速,总时间约为 12 秒。