Command Palette
Search for a command to run...
解耦式预测决策:一种面向智能体的共享条件预测器
解耦式预测决策:一种面向智能体的共享条件预测器
Lang Mo Xingxuan Zhang Qi Wang Mingchao Hao Hao Yuan Chunjing Gan Wang Lu Peng Cui
摘要
智能体的决策依赖于部署观测所揭示的经验关系,而仅凭任务描述可能无法确定这些关系。学习这些关系需要一种将历史证据转化为预测的机制。我们通过通用条件推断来形式化智能体决策,提出解耦预测决策(DPDM),在该架构中,一个共享的预训练学习器服务于异构决策角色。语言模型提供当前记录和历史记录的语义表示,而通用条件预测器根据表示后的证据预测任务定义的目标。预训练提供可复用的推断能力;部署证据在无需更新任一模型神经参数的情况下实例化问题特定的预测。因此,工具判断、候选偏好和推理评估共享统一的证据-查询接口,预测结果经决策规则映射为选择。该架构建立了互补的智能体能力来源:通过语言预训练获得的语义知识,以及通过结构化数据预训练获得的经验推断能力。我们使用在结构化数据上预训练的 LimiX-2 实例化条件预测器,并在所有被评估的决策角色之间共享该预测器。在五个任务类别中,DPDM 接受来自 Qwen3.5 等语义编码器的表示。以 Qwen3.5-27B 作为语义编码器,DPDM 将 50 个基准上的平均准确率从少样本提示下的 78.80% 提升至各自评估历史预算下的 84.92%,并在相同历史和查询条件下达到 82.33%。在 ToolPRMBench 的 BFCL 和 ToolSandbox 任务上,在各自方法的评估历史预算下,绝对准确率增益分别为 34.26% 和 28.87%。准确率随历史增加而提高。在相同的不平衡历史条件下,在五个推理步骤评估任务和四个编码器上,平均平衡准确率的绝对增益为 14.51%。DPDM 使从经验中学习成为一项可独立改进的基础模型能力,为条件预测的进步改善各类智能体任务决策提供了一条共享路径。
一句话总结
来自 Stable AI 和清华大学的研究人员提出了 Decoupled Predictive Decision Making (DPDM),一种将共享 LimiX-2 条件预测器与 Qwen3.5 等语义编码器相结合的架构。该架构在无需更新模型参数的情况下实现经验推理,将 50 个基准上的平均准确率从 78.80% 提升到 84.92%。
核心贡献
- 本文提出了 Decoupled Predictive Decision Making (DPDM),一种通过语义编码器、共享预训练条件预测器和决策规则,将任务定义的 agent 决策重新表述为条件预测问题的架构。
- 条件预测器使用 LimiX-2 实例化,使工具判断、候选偏好和推理评估等异构决策角色可以共享同一个证据与查询接口,而不需要针对具体任务更新神经参数。
- 使用 Qwen3.5-27B 作为语义编码器时,DPDM 在各自评估的历史预算下将 50 个基准上的平均准确率从少样本提示的 78.80% 提升到 84.92%,并在 ToolPRMBench BFCL 和 ToolSandbox 任务上分别获得 34.26% 和 28.87% 的绝对提升;准确率随历史增长而提高。
引言
通用 agent 需要将语义解释与基于反馈的学习结合起来,因为最优的工具选择、检索策略或推理分配可能取决于问题条件。先前以语言模型为中心的系统通常在同一个预训练模型内完成语义解释、经验推理和答案生成,使学习部署相关关系的机制无法被单独替换或独立改进。作者提出了 Decoupled Predictive Decision Making (DPDM),将任务定义的 agent 决策重新表述为条件预测问题。语言模型编码决策上下文和候选对象,共享条件预测器根据历史反馈估计未知目标,决策规则将预测转换为选择。该方法使用结构化数据基础模型 LimiX 2 实例化,并证明单个冻结的条件预测器可以在不进行任务特定神经参数更新的情况下,提高跨任务和跨语义编码器的决策准确率。
方法
作者提出了一种架构,将决策问题的语义理解与利用历史反馈求解该问题解耦。整体框架包括:一个语义编码器,用于表示当前上下文和候选选择;一个共享条件预测器,根据表示后的历史示例估计决策目标;以及一个决策规则,用于选择最终答案。
如下图所示:
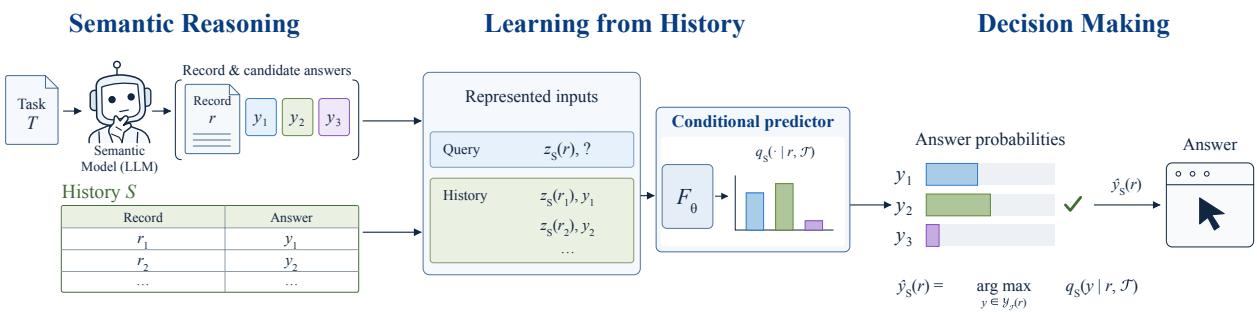
流程首先将决策制定形式化为历史条件下的预测问题。任务规范定义了可观察输入字段、预测目标的含义,以及给定记录 r 的候选答案集 YF(r)。系统维护记录及其观测目标的历史,记为 S={(ri,yi)}i=1M,而查询记录 r 描述当前决策,其目标 y 未知。主要目标是估计候选答案上的条件概率分布 qS(y∣r,F)。
为实现这一目标,作者使用共享条件预测器 Fθ,它接受三个输入:表示后的历史记录、其观测目标以及表示后的查询。冻结的语义编码器 Jϕ 首先在目标问题和候选描述的上下文中表示每条记录。该接口将决策相关结构置入表示后的输入和历史证据中,使共享条件预测器能够推断答案,而无需更新其神经参数以适配具体任务。然后,特征适配器将这些输入映射为结构化表示:
zS(r)=AψS(Jϕ(r;T),bT(r))这里,ψS 表示从历史输入中拟合出的任意状态,例如特征变换。同一个拟合映射被一致地应用于历史记录和查询记录。历史目标不参与语义记录编码,而是作为监督信号单独提供。条件预测器接收表示后的历史 S~={(zS(ri),yi)}i=1M 和表示后的查询 zS(r),以计算输出概率:
qS(⋅∣r,T)=Fθ(S~,zS(r))作者使用 LimiX-2 实例化条件预测器 Fθ。LimiX-2 是一个针对结构化数据条件预测预训练的模型,其预训练独立于所评估的决策任务。语义编码器参数 ϕ 和条件预测器参数 θ 在部署期间均保持固定。
在适应新观测时,系统更新提供给条件预测器的历史。新获得的标签或观测结果提供额外记录 ΔS,从而得到扩展历史 S+=S∪ΔS。核心模型参数保持不变,即 ϕ+=ϕ 和 θ+=θ。但是,依赖历史的适配器状态 ψS+ 及由此产生的预测 qS+ 可能发生变化。任何必要的输入变换都会在更新后的历史输入上重新拟合,并被一致地应用;如果编码器和记录规范保持不变,语义表示可以重用。最后,决策规则在预测的候选概率上取 argmax 来选择答案。
实验
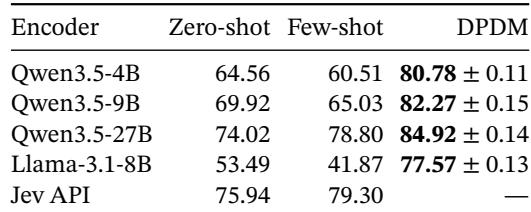
在 50 个基准和五个任务类别中,实验将带有 Qwen 和 Llama 语义编码器的共享冻结条件预测器(DPDM)与直接零样本提示和少样本提示进行对比,包括匹配历史设置和受控消融设置。结果表明,DPDM 提高了所有编码器和任务类别的决策准确率,能够从增长的历史和不同的带标签观测中受益,并且比少样本提示更少受到多数标签偏差的影响。干预实验确认,历史输入与目标配对以及语义特征都对性能有贡献,而成本测量表明历史的重复语义处理有所减少。
对于全部四个语义编码器,DPDM 在每个类别中都优于少样本提示,较小模型的整体准确率提升尤为显著。在单个基准上的提升非常广泛,取决于编码器,DPDM 在 50 个数据集中几乎全部或全部取得改进。外部 API 少样本提示的准确率高于其零样本设置,但未报告针对该 API 的 DPDM 对比结果。对于全部四个语义编码器,DPDM 均优于零样本提示和少样本提示,包括少样本提示不如零样本提示的情况。取决于编码器,DPDM 在 50 个基准中几乎全部或全部提高了准确率,其中从提示到 DPDM 的最大提升出现在 Llama-3.1-8B 上。
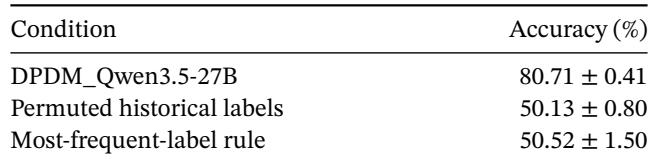
正确历史输入与目标配对显著提高了六项评估任务上的决策准确率。在保持类别计数不变的情况下打乱历史标签,会使性能下降到大致相当于始终预测最常见历史类别的水平。原始配对在所有六项任务上均优于两种对照。原始历史输入与目标配对相比打乱标签具有明显准确率优势。打乱标签与最常见标签规则达到相似的准确率,表明仅靠类别频率几乎无法解释这些性能。正确配对的优势在全部六项评估任务中均成立。
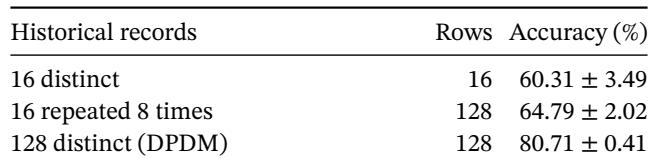
在六项任务中,使用 128 个不同的历史示例比将相同的 16 个示例重复使用八次获得显著更高的准确率。重复示例相比较小的 16 行历史仅带来有限提升,而扩展到不同记录则带来明显收益。因此,在相同总历史规模下,不同观测比重复行提供更有用的历史证据。与使用 16 个不同示例相比,将 16 个示例重复八次仅能轻微提高准确率。在相同的 128 行预算下,128 个不同观测比重复示例高出 15.92 个百分点,且在全部六项任务上均有提升。
在所有测试的历史规模和任务上,完整的 DPDM 模型都取得了最高准确率。移除语义特征会在每个历史规模下降低准确率,而打乱历史标签会导致更大的下降。更大的历史会改善所有条件,但当语义特征和正确的输入与目标配对得以保留时,收益最大。DPDM 在每个测试的历史上限下均优于两种消融条件。在所有历史规模下,打乱历史标签比移除语义特征更具破坏性。在最高历史上限下,DPDM 在全部八项任务上均超过两种消融条件。所有条件下准确率都随历史规模增加而提高,但完整模型获益最大。
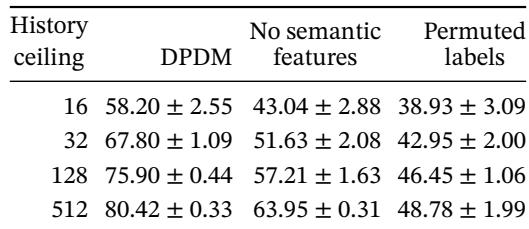
实验在四个语义编码器和多个基准上将 DPDM 与零样本提示和少样本提示进行评估,然后通过受控消融探究历史信息的作用。DPDM 一致优于提示基线,对较小编码器的提升尤为明显;结果表明,正确的历史输入与目标配对至关重要,因为打乱标签会将性能降低到多数类别水平。使用不同的历史示例而非重复一小组示例也能带来显著的准确率提升。进一步消融确认,具备语义特征和正确配对的完整 DPDM 模型从更大的历史中获益最多,而移除语义特征会降低准确率,打乱历史标签则会导致更大的下降。