Command Palette
Search for a command to run...
智能体化计算机图形学的进展
智能体化计算机图形学的进展
摘要
计算机图形学构建于代码之上。大语言模型(LLM)智能体如今能够生成图形代码,并通过多种反馈对其进行迭代优化。这一能力为计算机图形学的一种潜在新范式打开了大门:图形算法越来越多地围绕智能体化系统构建,以自动化日益复杂的任务。近年来,智能体化图形学的研究在多种任务上迅速扩展。这种快速增长使得人工文献综述越来越难以跟上新进展。与此同时,相似的思想在这些任务中常常使用不同的术语来描述,进一步增大了系统性理解该领域的难度。在本报告中,我们通过两项贡献来应对这些挑战。第一,我们提出了一种统一分类体系,用于刻画跨多种计算机图形学任务的智能体化系统。第二,我们开发了一个智能体化文献系统,能够辅助人类研究人员对已有论文和新发表论文进行大规模分析。基于这些贡献,我们分析了新兴研究趋势,并讨论了开放挑战,包括跨图形任务协调智能体与工具、设计面向人类与智能体协作的界面与表示、维持长程规划与迭代优化,以及可靠地评估交互式图形系统。
一句话总结
来自德克萨斯大学奥斯汀分校、斯坦福大学、西蒙弗雷泽大学、加利福尼亚大学伯克利分校和剑桥大学的研究人员提出了一种统一分类体系,用于刻画跨多种计算机图形任务的agentic系统,并提出了一个用于大规模分析论文的agentic文献系统;同时考察了新兴研究趋势和开放挑战,涉及跨图形任务协调agent与工具、设计面向人机agent协作的界面与表示、维持长时程规划与细化,以及可靠评估交互式图形系统。
核心贡献
- 提出了一种针对agentic计算机图形系统的统一分类体系,按照用户输入、基础模型、harness以及图形界面与工具来组织相关工作。
- 开发了一个agentic文献系统,该系统发现候选论文、使用该分类体系对其进行标注,并自适应地保留记录,以支持对已有和新发表论文的大规模分析。
- 利用该分类体系和系统分析跨2D图形、静态3D资产和动态3D资产的agentic图形方法,同时识别规划、人机agent协作和可靠评估中反复出现的设计模式、评估实践和开放挑战。
引言
大语言模型的近期进展使得agentic图形系统成为可能,这类系统利用代码生成、工具使用和环境反馈来自动化复杂图形工作流,例如3D资产创建、动画和模拟。这之所以重要,是因为它将图形创作从手动指定流程转向面向视觉内容的语言引导迭代控制。然而,快速增长的文献横跨多个社区,这些社区对功能相似的规划与反馈组件使用不同术语,使得综合与比较变得困难。作者通过引入一种跨越规范说明、基础模型、harness以及图形界面与工具的统一分类体系来解决这一问题,并构建了一个agentic文献调查系统,该系统搜索、阅读并使用该分类体系标注论文,以支持结构化比较和趋势分析。
数据集
作者将本节作为agentic图形评估基准的调查,而非单个新训练数据集的描述。
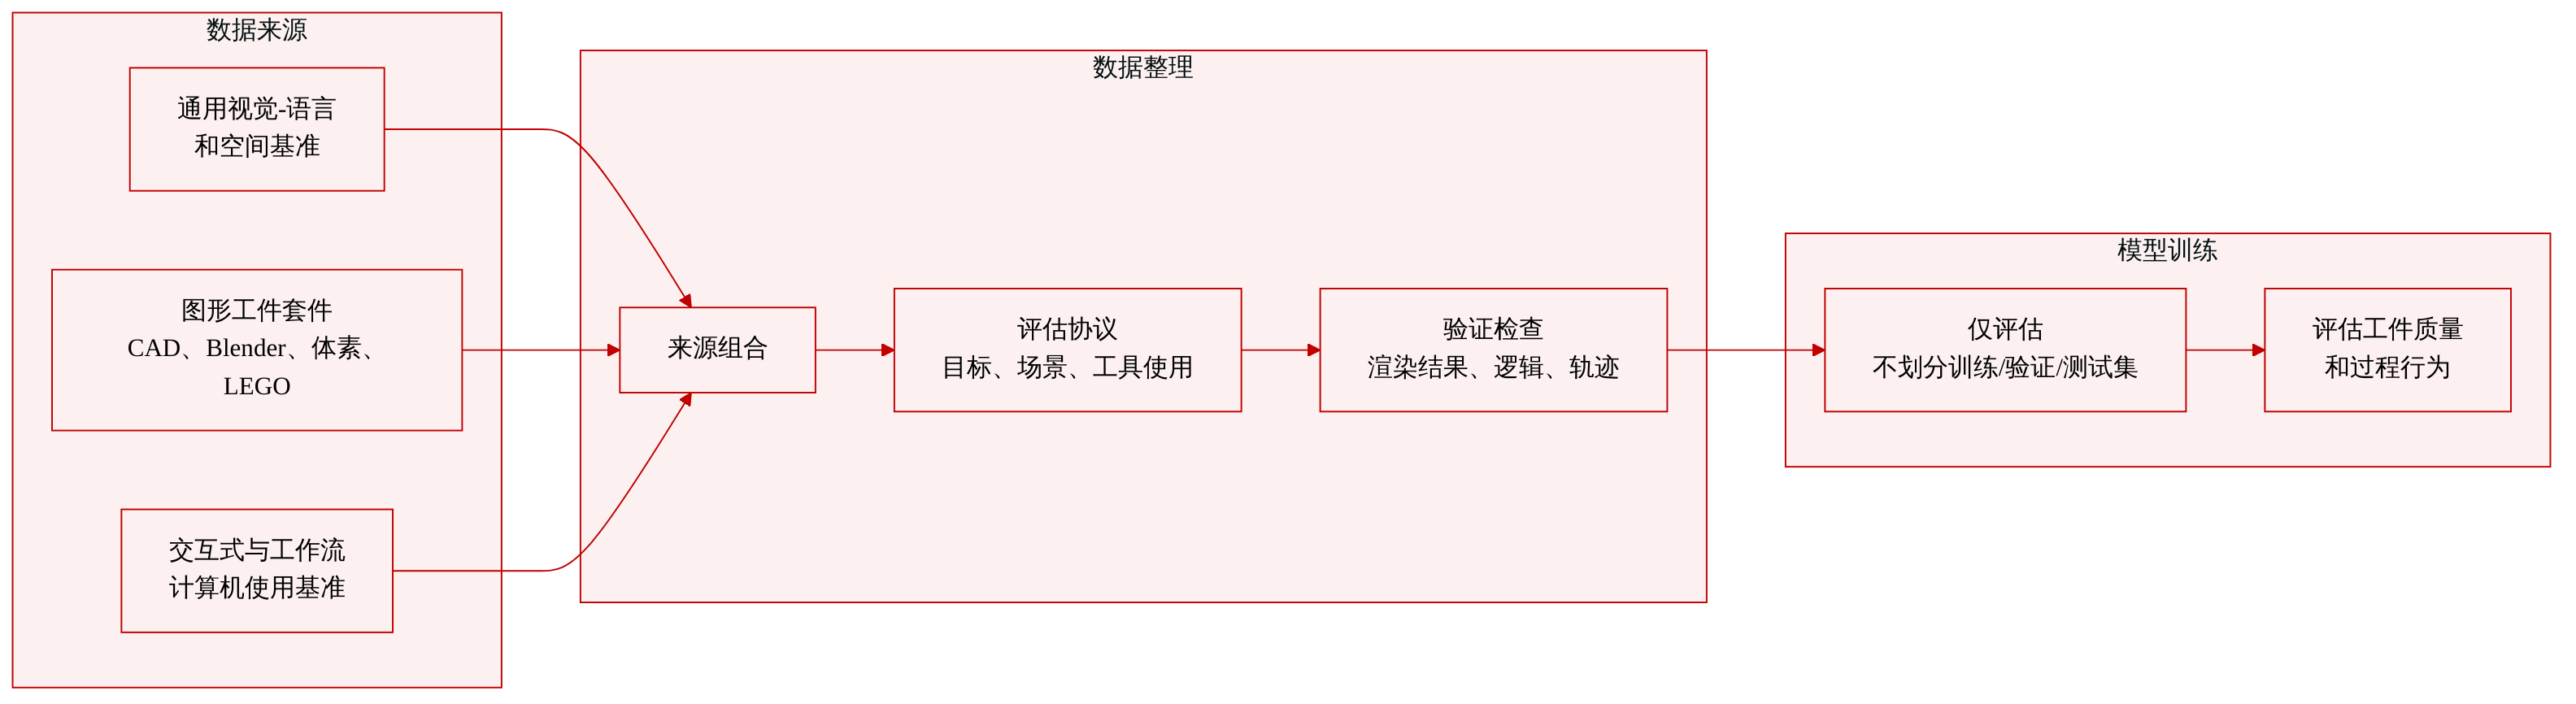
- 组成与来源:这些基准来自通用视觉语言与空间理解数据集;图形产物评估套件;CAD、程序、运动与重建基准;顺序编辑与工作流基准;以及交互式computer-use基准。
- 主要基准组:
- 空间理解:基准考察相对位置、距离与方向、有限视角推理、多视图整合、3D定位、几何推理、语义理解和3D场景中的多步动作规划。
- 图形产物评估:CAD-Assistant评估多输入条件下的CAD生成;3DCodeBench、Voxel-CodeBench和BrickBench评估将文本与视觉规范翻译为Blender程序、体素表示和乐高装配体;MoVer通过时空逻辑谓词验证运动图形;IR3D-Bench评估用于定位、外观和语义的图像到3D重建。
- 顺序与工作流评估:BlenderGym评估场景编辑(如物体放置、光照、材质和几何),每个阶段都进行验证;Op-CAD评估长CAD操作序列;VIGA评估迭代式代码-渲染-检查细化;BVB和4DCodeBench通过感知相似度和时空一致性评估视频到3D。
- Agentic交互与协调:ALE和OSWorld评估computer-use agent在长时程GUI和软件任务上的表现;3DHarnessBench和SceneActBench评估单视图、多视图、任意视角和全3D交互设置下的重建;CADWorld评估机械CAD工作流中的computer-use agent。
- 处理与格式:作者描述的是评估协议而非数据预处理。agent解释图形目标,推理当前场景或状态,使用图形专用工具或程序,并产生产物或动作序列。验证可以在每次编辑阶段进行,也可以通过渲染结果、逻辑谓词或分析交互轨迹来进行。
- 数据使用方式:这些基准仅用于评估,不作为训练数据。它们评估最终产物质量和过程级行为,包括几何有效性、材质正确性、艺术质量、语义理解和动作规划或协调。
- 缺失的数据集统计信息:文中未报告数据集规模、训练/验证/测试划分、混合比例、过滤规则、裁剪策略或元数据构建细节。
方法
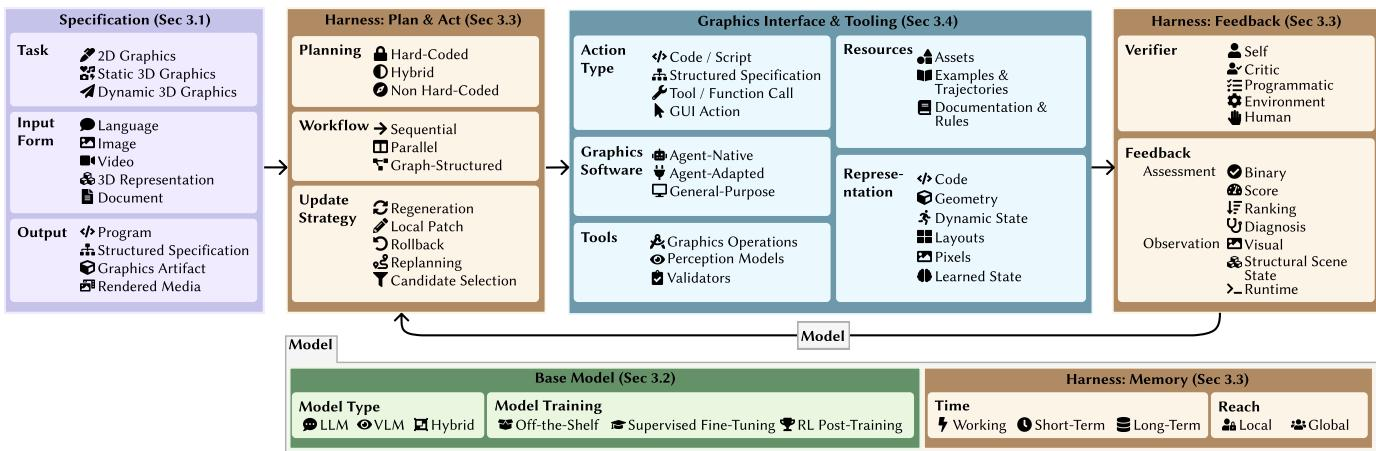
作者提出了一种统一分类体系,将agentic图形系统的共享结构组织为一个设计空间,包含四个维度:规范说明、基础模型、harness以及图形界面与工具。
规范说明维度描述任务需求、可用输入(如语言、图像或3D表示)以及预期输出(如程序或渲染媒体)。给定这些需求后,基础模型充当决策组件。它可以是大型语言模型、视觉语言模型或混合系统,可以现成使用,也可以通过有监督微调或强化学习进行适配。harness将基础模型连接到图形界面,协调规划、执行、反馈和记忆。它管理工作流(可以是顺序、并行或图结构)、更新策略(如重新生成或局部修补)以及验证机制(包括自验证或程序化检查)。最后,图形界面与工具维度提供必要的操作、资源和表示。动作可以采取代码脚本、结构化规范说明、工具调用或GUI操作的形式,在agent原生、agent适配或通用软件环境中执行。
为了应对该领域研究的快速增长,作者还开发了一个agentic文献调查系统,该系统使用所提出的分类体系自动识别、分类和整理相关论文。
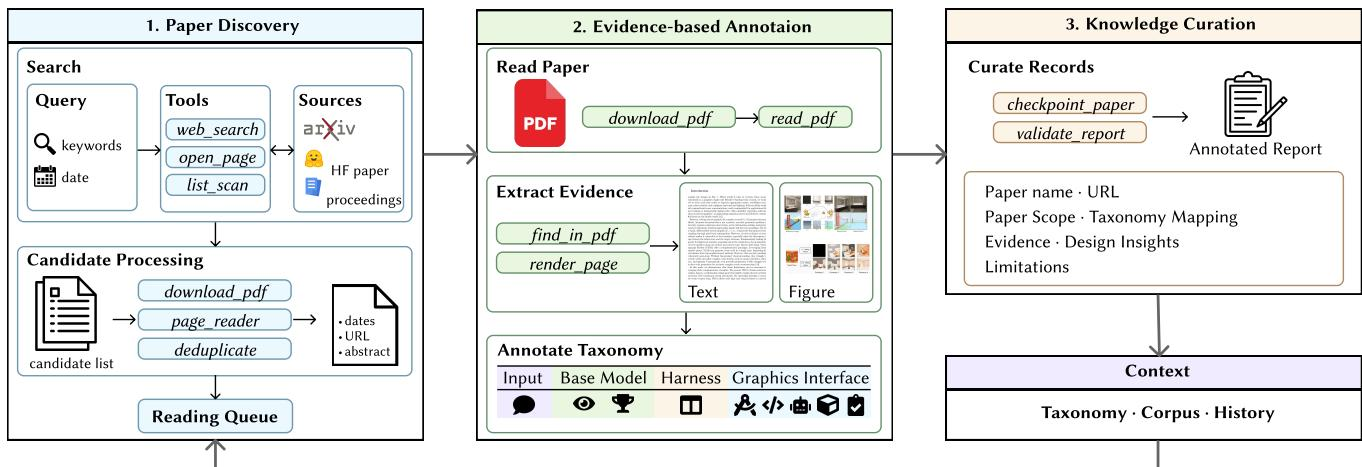
该系统通过三个主要阶段运行。首先,在论文发现阶段,agent扫描出版物列表并搜索网络以构建候选列表,迭代优化查询并优先进行全文阅读。其次,在基于证据的标注阶段,agent阅读文本并查看选定论文中的图表以收集支持证据,然后分配分类标签。最后,知识整理阶段维护论文版本和标注的整理记录,验证必需字段是否存在以及标签是否符合分类体系,使后续运行能够从未解决的候选中恢复。
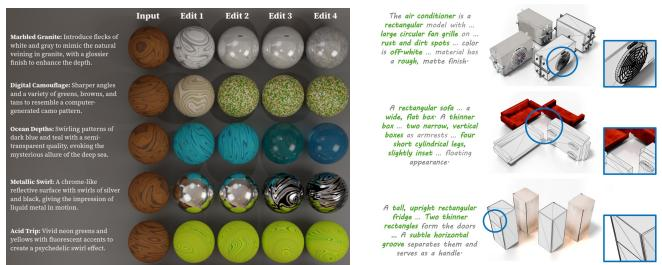
作者阐述了这些设计选择如何在具体系统架构中体现。对于几何构建,LL3M方法采用迭代式编程工作流,规划器将请求划分为子任务,编码器使用检索到的API文档实现这些子任务。
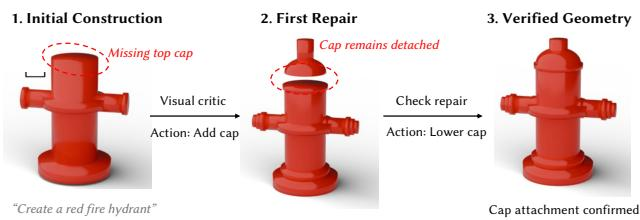
来自多视图评判的视觉反馈指导代码编辑,验证器检查缺陷是否已解决。在纹理与材质建模中,BlenderAlchemy等系统使用视觉结果通过参数和结构编辑修订材质程序,而ShapeCraft利用物体组件结构指导纹理生成。
对于资产编辑,ViSculpt方法将语言请求分解为对现有网格的局部编辑,在GUI内使用雕刻原语。
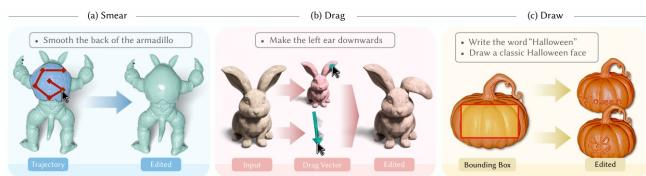
视图选择与目标蒙版约束操作,编辑前后的视觉反馈指导局部化和笔刷参数的精化。
实验
评估使用一个agentic文献调查系统,在中等推理强度下使用GPT-6 Astra编制并手动验证2024年至2026年9月的350篇论文,捕获分类标签、设计见解、局限性和来源位置。SubDGuide和PLAYGROUND等案例对比验证了修订策略与编辑限制之间的关系,而系统性调查发现视觉反馈占主导但通常与其他方式结合,更新策略和支持资源在CAD与场景生成之间存在差异,并且近期工作转向局部修订、更丰富的反馈和文档。数据集与基准部分验证了agentic图形评估在空间理解、产物质量、多步编辑工作流和交互式协调方面的表现,表明从仅评估最终产物转向同时分析过程级动作轨迹。
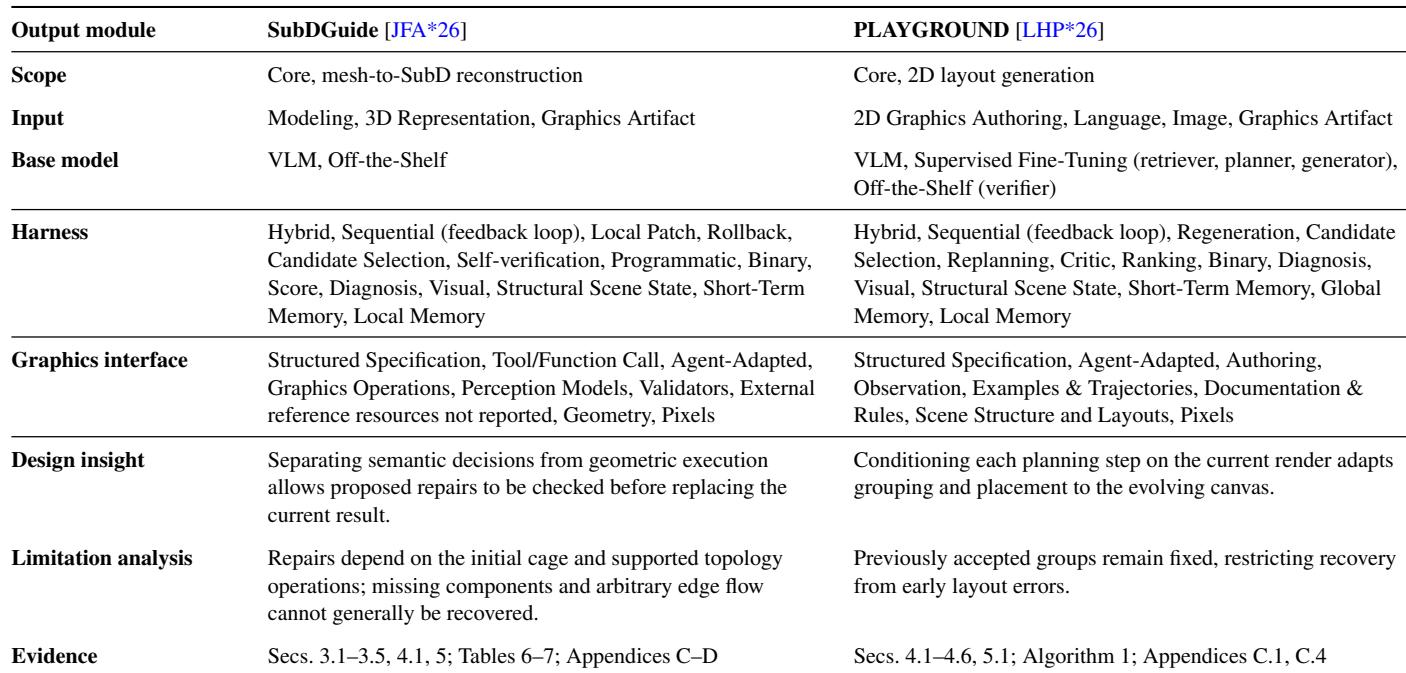
对比涉及两个agentic图形系统:用于网格到SubD重建的SubDGuide和用于2D布局生成的PLAYGROUND。两者都使用具有视觉和结构化场景状态的混合顺序反馈循环,但在模型适配和早期决策后可修订的程度方面存在差异。它们的局限性直接映射到各自的编辑范围:SubDGuide受限于其初始控制笼,PLAYGROUND受限于先前接受的组。SubDGuide将语义决策与几何执行分离,以便在替换当前结果之前检查提议的修复,而PLAYGROUND使每个规划步骤以当前渲染为条件,使分组和放置适应不断演变的画布。两个系统共享具有候选选择和诊断的混合顺序harness,但SubDGuide使用现成的VLM,而PLAYGROUND使用有监督微调的检索、规划和生成模块,并搭配现成的验证器。局限性分析反映了编辑行为:SubDGuide验证局部修复但通常无法恢复缺失组件或任意边流,PLAYGROUND修订当前组但无法重新访问先前接受的组。
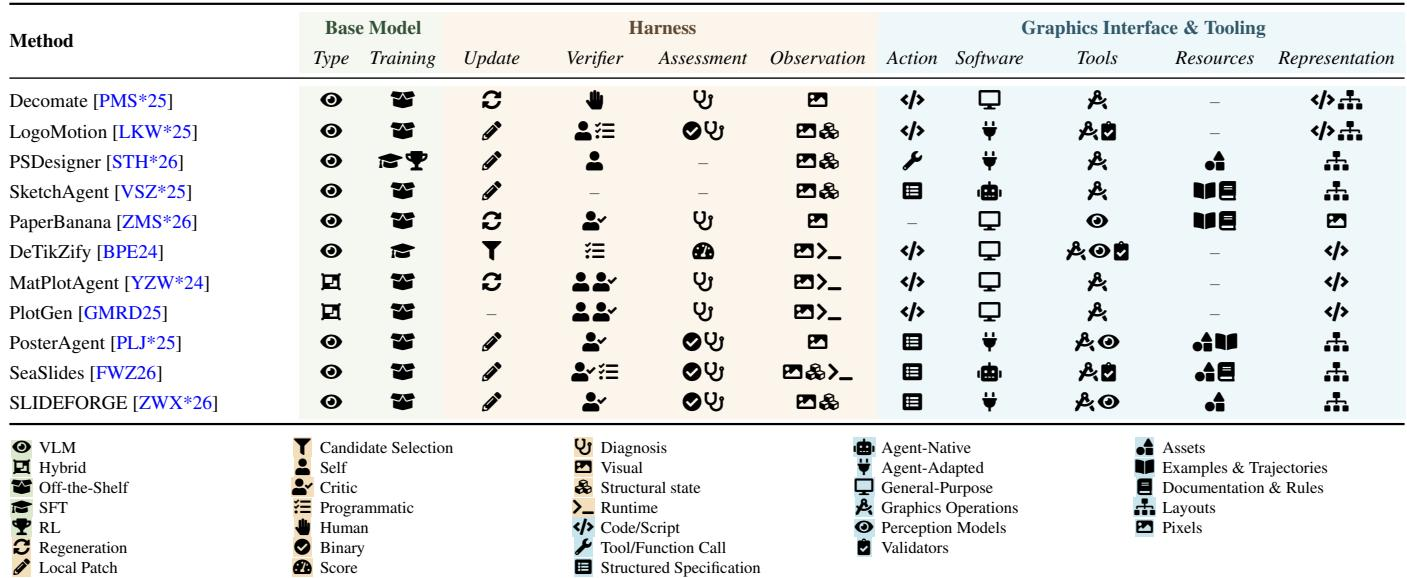
代表性2D图形系统集中在结构化矢量图形、交互式视觉设计以及科学图形或示意图生成方面。这些系统倾向于保留可编辑结构,并使用渲染或交互式反馈进行迭代细化。这组系统涵盖语义矢量动画、基于工具的设计、顺序草图绘制和技术图表工作流。Decomate和LogoMotion将矢量元素组织为语义组,并通过代码合成制作动画。PSDesigner和SketchAgent通过Photoshop工具使用和顺序语言驱动的草绘动作支持可编辑的视觉工作。PaperBanana被引用为通过专用agent生成方法学图表和科学图形的系统。
调查比较了物体、CAD和场景任务中的静态3D资产建模方法,重点关注它们如何生成、细化和验证输出。迭代细化配合执行或视觉反馈很常见,但CAD和场景方法更常添加确定性检查、约束或求解器以保持几何有效性和空间一致性。该对比突出了从纯视觉评判转向混合反馈信号(如边界框观察、核测量和学习型评判器)的转变。物体几何构建方法在落地方面有所不同:有些使用多视图视觉评判,而另一些依赖边界框观察、连接性检查或显式装配关系。材质建模方法通过渲染输出指导图构建或程序编辑,并且若干方法在结构决策确定后通过优化细化参数或纹理。CAD和场景建模方法倾向于通过确定性几何检查、约束或求解器来增强视觉检查,以保持有效性和空间一致性。
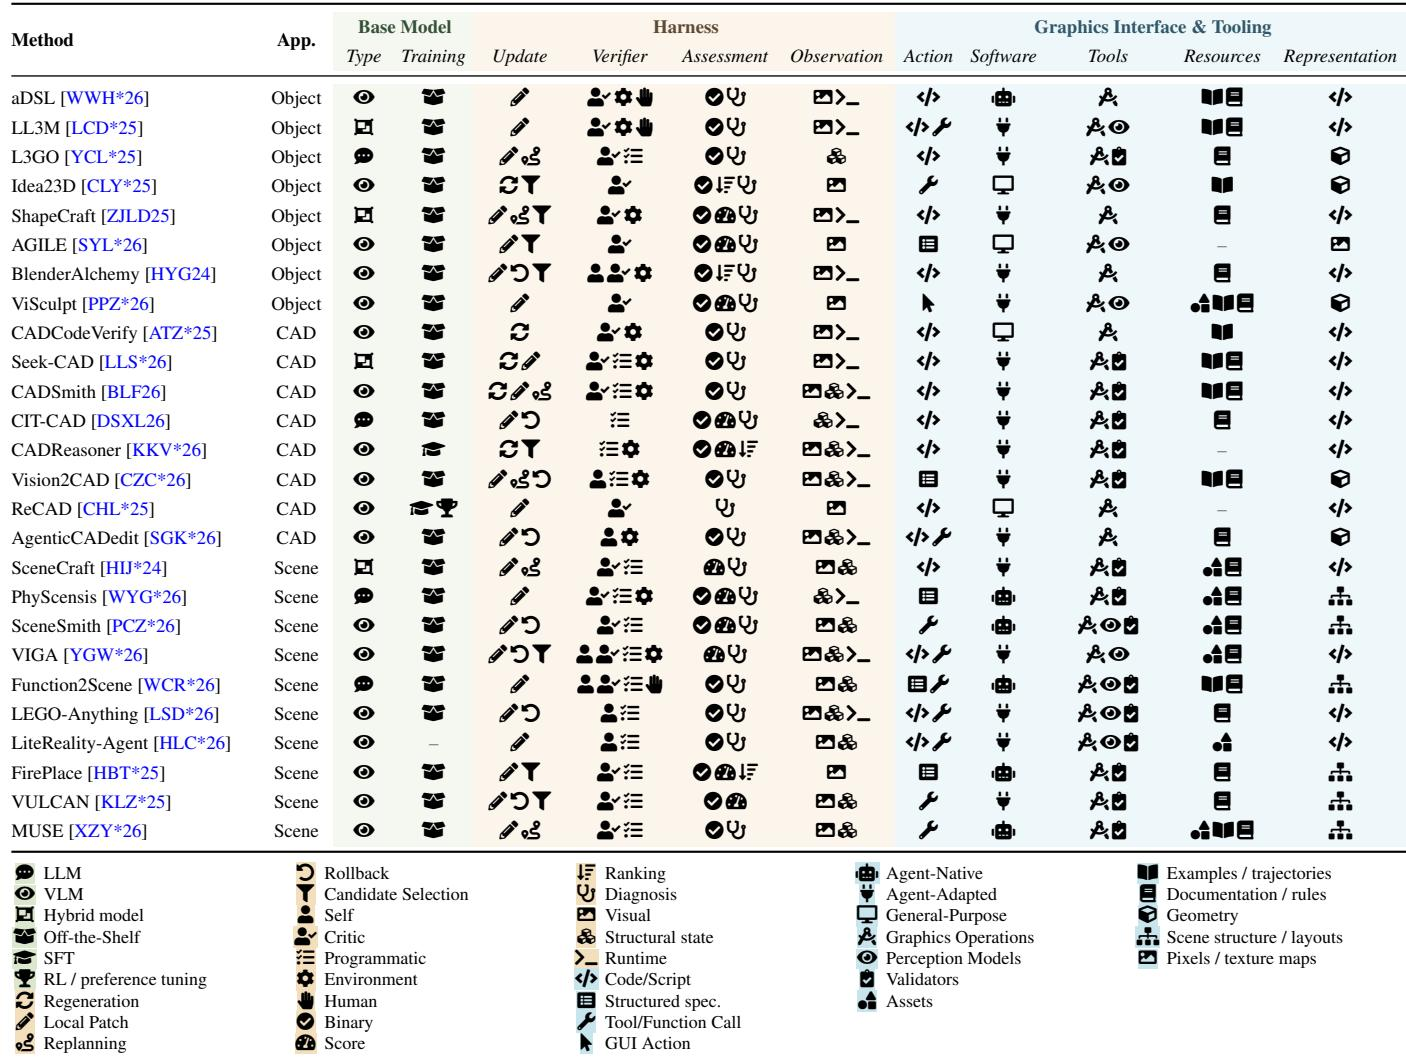
动态3D资产建模系统共享可编辑的、通常是程序化的表示,但主要在如何落地意图以及反馈如何驱动修订方面存在差异。关节方法依赖构建检查、视觉运动参考或物理模拟,而动画方法在时间结构和渲染反馈所针对的控制方面各不相同。以关节为重点的方法通过可执行API构建部件和关节,评估证据涵盖显式装配测试、视觉参考和基于物理的碰撞反馈。动画系统使用不同的时间表示(如协调轨道或持久物体状态),并将渲染反馈引向布局、相机轨迹或关节运动等控制。持久物体身份本身并不能确保连续物理动力;有些系统使用离散状态替换,而另一些则添加物理属性和模拟检查。
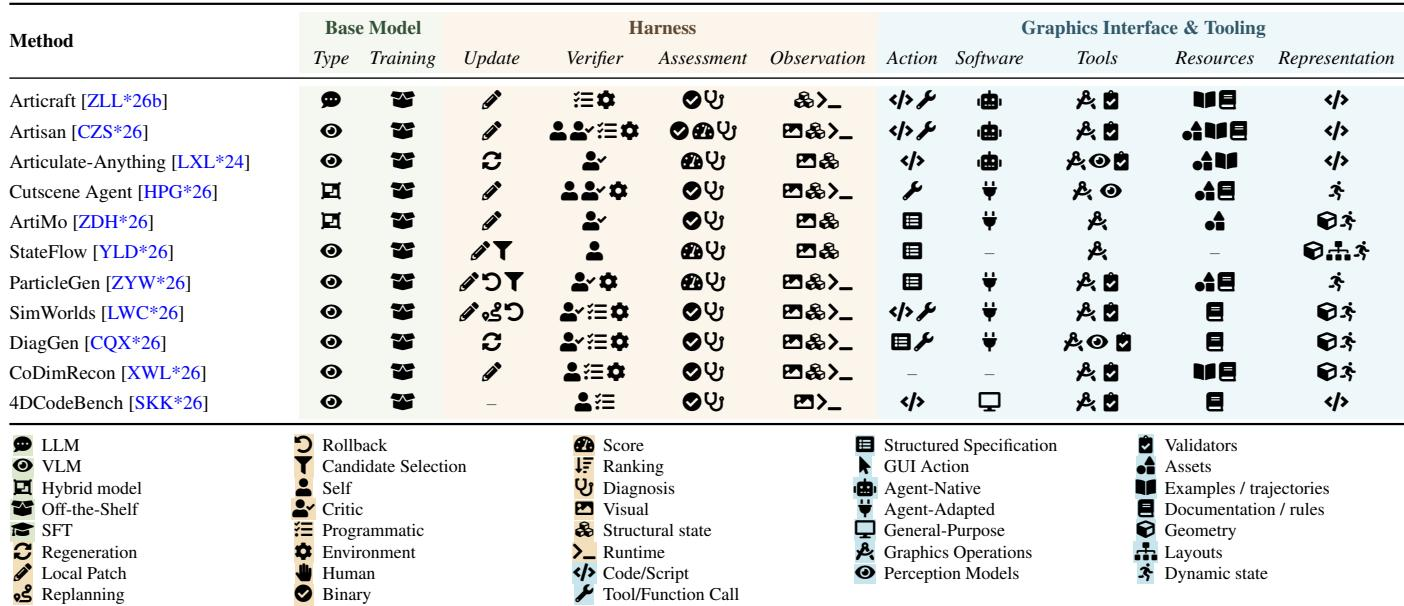
实验比较了2D布局生成、静态3D资产建模和动态3D资产建模中的agentic图形系统,重点关注每个系统如何组织反馈、修订和验证。这些系统通常使用混合顺序循环,将渲染或视觉观察与结构化场景状态相结合,但在依赖现成模型还是有监督微调模块以及早期决策可修订的程度方面存在差异。主要定性发现是:修订限制直接映射到每个系统的编辑范围(如SubDGuide固定的初始控制笼或PLAYGROUND先前接受的组),而CAD、场景和关节方法越来越多地添加确定性检查、约束或求解器以保持几何有效性和物理一致性。