Command Palette
Search for a command to run...
推动机器人使用智能体普及化:一种基于开放模型的统一框架
推动机器人使用智能体普及化:一种基于开放模型的统一框架
摘要
机器人使用智能体(RUA)已展现出有前景的零样本操控能力,但对前沿专有模型的依赖限制了对进一步训练的研究。为推动 RUA 研究的普及,我们提出了 uni-robot-agent,这是一个面向具有竞争力的开放权重机器人使用且支持进一步训练的统一框架。在不使用特权输入的情况下,开箱即用的 Qwen3.8-Flash-Next 取得了 31.39 的 RoboDojo 分数,超过了已发布的 GPT-6 Astra–RoboProbe 的 28.97 分结果以及多个 VLA/WAM 基线,并在 19 个真实世界任务上表现出竞争力。我们跨模型代次、系列和规模的分析将有效的机器人使用与四项通用能力联系起来,表明未来的 RUA 训练应共同培养这些能力。
一句话总结
清华大学和加州大学伯克利分校提出 uni-robot-agent,这是一个面向开放权重机器人使用 agent 的统一 harness,支持进一步训练;结果表明,在没有特权输入的情况下,Qwen3.8-Flash-Next 取得了 31.39 的 RoboDojo Score,超过已发布的 GPT-6 Astra-RoboProbe 结果 28.97 和多个 VLA/WAM 基线,并在 19 个真实世界任务上表现具有竞争力;相关分析跨越模型代际、系列和规模,将有效的机器人使用与四项通用能力联系起来,这些能力应在未来 RUA 训练中联合培养。
核心贡献
- 论文提出 uni-robot-agent,这是一个统一且模块化的机器人使用 agent harness,将共享机器人工具与模型运行时和环境适配器分离,协调工具执行和反馈,并支持高效执行和进一步训练。
- 结果表明,开放权重模型 Qwen3.8-Flash-Next 在没有特权输入的情况下取得了 31.39 的 RoboDojo Score,超过已发布的 GPT-6 Astra-RoboProbe 结果 28.97 和多个 VLA/WAM 基线,并在 19 个真实世界任务上表现具有竞争力。
- 论文提供了跨模型代际、系列和规模的分析,以及对特权信息、成本和执行效率的分析,并将有效的机器人使用与四项通用能力联系起来,这些能力应在未来机器人使用 agent 训练中联合培养。
引言
GPT-6 Astra 和 Opus 5.5 等近期前沿模型展示出令人意外的零样本机器人操作能力,使机器人使用 agent 成为将通用问题求解能力迁移到机器人领域的一条有前景的途径。然而,这些模型是专有且受 API 约束的,将研究人员限制在 harness 设计上,无法进行微调、低成本大规模交互和模型级优化。开放权重替代方案在空间理解和 agent 能力方面一直落后,因此此前工作往往依赖特权模拟器状态或任务特定技能,而不是系统性地测试这些模型。作者提出 uni-robot-agent,这是一种通用机器人使用 harness,具有统一工具与反馈、可互换组件和重叠执行,使开放权重 agent 具有竞争力,并支持未来机器人特定训练。
方法
作者提出 uni-robot-agent,这是一个统一且模块化的 harness,旨在将多种 agent 运行时连接到面向仿真机器人和实体机器人的共享工具包。该系统围绕四个核心原则组织:统一交互、高效执行、真实部署约束和模块化。
模块化架构由五个具有明确接口的逻辑层组成。
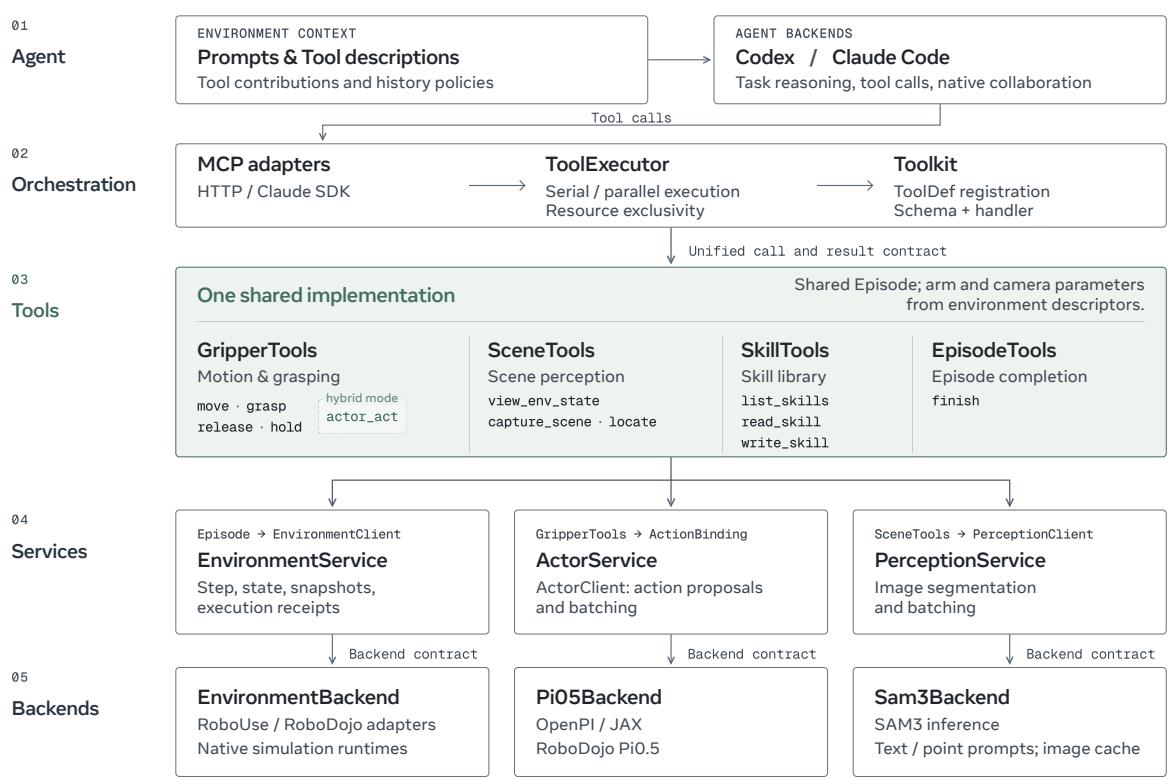
在最上层,agent 层管理模型交互和上下文,将工具请求传递给编排层。编排层负责调度和分发,利用 MCP 适配器和 ToolExecutor 管理串行或并行执行以及资源互斥。工具层实现共享机器人操作,例如用于运动和抓取的 GripperTools、用于感知的 SceneTools、用于技能库的 SkillTools,以及用于 episode 完成的 EpisodeTools。这些工具通过服务层访问环境、感知和动作模型能力,服务层通过 EnvironmentService、ActorService 和 PerceptionService 管理运行时资源。最后,后端层提供具体实现,例如用于仿真运行时的 EnvironmentBackend、用于实体机器人的 Pi05Backend,以及用于推理的 Sam3Backend。
为了确保跨不同环境的统一交互,作者为 agent 提供了一组共享的运动、感知、技能和 episode 控制工具。这些工具使用统一的参数、单位和反馈格式。环境适配器将共享工具请求转换为原生命令。
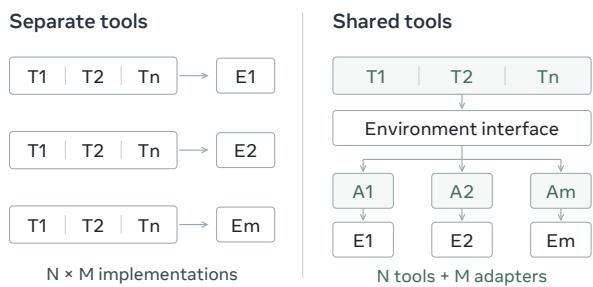
这种设计允许共享工具通过通用接口访问观测、机器人状态和原始动作,无需为每个工具环境单独实现。添加新环境只需要一个适配器及其配置。
在高效执行方面,编排层将后台工具调用与资源感知调度相结合,形成 agent 推理与工具执行之间的流水线。
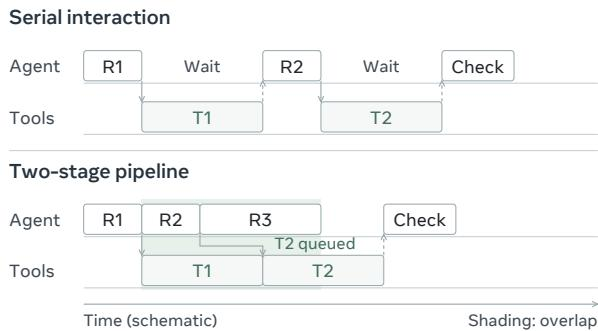
系统支持两级并发。在 agent 与工具之间,后台调用返回一个任务句柄,使 agent 能够继续独立推理。在工具调用之间,共享独占资源的操作按提交顺序执行,而并行调用则在该队列之外运行。这形成两阶段流水线,使 agent 能够在先前提交的调用执行时继续提交后续调用,即使工具串行运行,也能重叠推理和执行。
作者还强调在无特权输入下的真实交互,确保 agent 仅依赖物理部署中可用的信息,例如避免使用模拟器提供的深度或任务验证器反馈。若干关键设计选择进一步提升了可靠性。通过将图像、相机标定和机器人状态绑定到不可变快照,保持观测和状态一致。为防止通信失败后重复执行动作,系统记录请求标识和执行状态以拒绝重复请求。运动和夹爪控制被协调以允许同时动作,并通过生成中间目标并在每步后检查进展来监控进度。通过在图像旁返回数值运动反馈,使动作结果可诊断;不断增长的视觉历史通过滑动窗口管理,将旧图像替换为文本占位符。
实验
实验在 42 个 RoboDojo 仿真任务和一个 19 个任务的真实世界基准上评估开放权重机器人使用 agent,结果表明,采用 uni-robot-agent harness 的 Qwen3.8-Flash-Next 等模型可以在零样本设置中达到或超过经过微调的 VLA/WAM 基线,甚至超过一个前沿闭源模型。分析表明,成功的机器人使用取决于视觉理解、空间定位、几何编码和具身推理等通用能力,而这些能力与现有基础模型基准相关,而不是取决于特权深度输入或任务特定技能库。成本和速度结果进一步表明,开放权重模型提供了有利的性能成本权衡,将模型推理与物理执行流水线化也显著缩短了 episode 时长。总体而言,这些发现支持开源机器人使用 agent 在与适当设计的 harness 搭配时具有可行性。
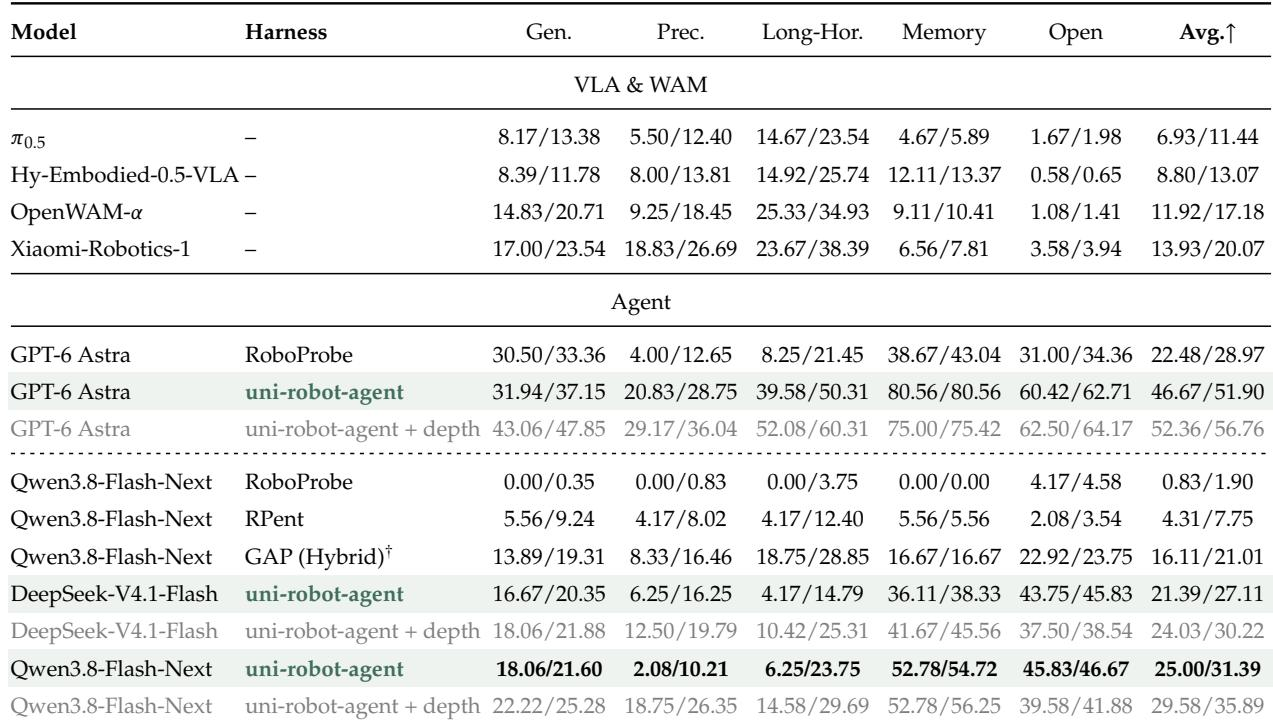
在 RoboDojo 上,使用 uni-robot-agent harness 的开放权重模型在平均成功率和得分方面优于列出的 VLA 和 WAM 基线,其中一个开放权重模型还超过了使用 RoboProbe 的 GPT-6 Astra 配置。uni-robot-agent harness 似乎很重要,因为在最强基线上替换它会显著降低性能。配备 uni-robot-agent 的 GPT-6 Astra 取得最佳总分,而开放权重模型提供了更具成本效率的性能权衡。使用 uni-robot-agent 的开放权重模型平均优于 VLA 和 WAM 基线,Qwen 还略微超过与 RoboProbe 搭配的 GPT-6 Astra。机器人使用 agent 在记忆和开放词汇能力上的得分通常高于 VLA 和 WAM 基线,但开放权重 agent 在长周期任务上相对于 Xiaomi-Robotics-1 和 OpenWAM 表现不佳。Harness 选择影响很大:将最强基线从 uni-robot-agent 移开会导致成功率和得分显著下降。配备 uni-robot-agent 的 GPT-6 Astra 达到最佳性能,但开放权重模型提供了一条以更低成本获得相当分数的路线。
在真实世界评估中,搭载 Qwen3.8-Flash-Next 的 uni-robot-agent 与经过微调的 π0.5 性能相当,并优于零样本 Dream-1;而搭载 GPT-6 Astra 的 uni-robot-agent 则以较大幅度领先所有基线。该方法在组合任务和未见任务上往往表现更好,而 VLA 和 WAM 基线在物体泛化方面相对更强。这些结果支持将 uni-robot-agent 应用于真实世界机器人任务。搭载 Qwen3.8-Flash-Next 的 uni-robot-agent 在真实世界评估中与经过微调的 π0.5 性能相当,并超过零样本 Dream-1。搭载 GPT-6 Astra 的 uni-robot-agent 以较大幅度优于所有其他基线。机器人使用 agent 在组合任务和未见任务上表现更好,而 VLA 和 WAM 模型在物体泛化方面表现良好。
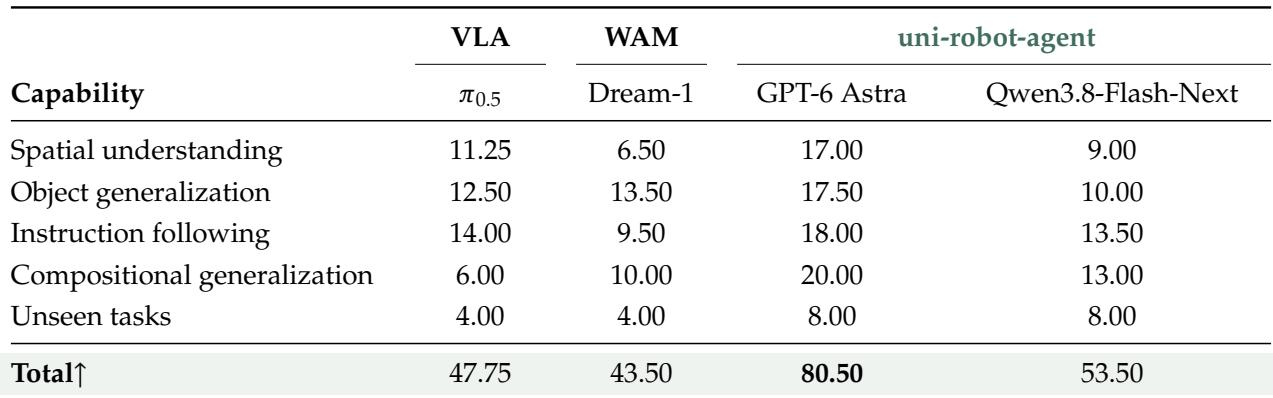
RoboDojo 基准使用 uni-robot-agent harness 对机器人使用 agent 与 VLA 和 WAM 基线进行评估,表明该 harness 能显著提升性能,并且使用它的开放权重模型平均优于基线。配备该 harness 的 GPT-6 Astra 取得最佳总分,而开放权重模型提供了一条以更低成本获得相当结果的路线。在真实世界评估中,该方法达到或超过经过微调和零样本基线,在组合任务和未见任务上提升最大,而 VLA 和 WAM 模型在物体泛化方面仍相对更强。