Command Palette
Search for a command to run...
随机采样几乎就足够了吗?——基于 BestRand 的稳定且低成本基准压缩
随机采样几乎就足够了吗?——基于 BestRand 的稳定且低成本基准压缩
George Ling Shanshan Zhong Lijin Yang Hao Yang Nanxiang Li Zhongzhan Huang
摘要
基准压缩通过在一个与完整基准结果高度一致的小型基准子集上评估模型,来降低模型评估通常难以承受的时间与成本。为了量化估计误差,我们对从子集估计完整基准分数时的误差分布推导了一个精确的解析近似,并表明大多数子集产生的误差较小,而少数子集产生的误差大得多,从而形成长尾分布。这意味着仅靠随机采样就能以较高概率取得令人惊讶的良好性能,但由于罕见的大误差,它仍然不稳定。我们进一步表明,这种不稳定性是现代基础模型所固有的,并且即使评估更多模型,这种不稳定性仍然存在。基于这些发现,我们提出了 BestRand,一种稳定且低成本的基准压缩方法,它在保持随机采样高效性的同时,大幅减少了其高误差尾部。我们在 70 多个文本、多模态和智能体基准上验证了 BestRand,并将其进一步扩展到 VLA 评估。与竞争性方法相比,BestRand 将高误差风险平均降低了 50.2%,将估计误差平均降低了 16.4%,而所需构建成本仅为竞争性方法的 51.3%。在分数范围偏移、模型族偏移和时间偏移条件下,BestRand 进一步将分布外(OOD)估计误差平均降低了 21.8%。总体而言,我们的理论为理解和预测基准压缩的准确性与可靠性提供了实用指导,而 BestRand 则能以低成本实现稳定且准确的压缩。代码和数据已在 GitHub 上公开提供。
一句话总结
博世研究院和卡内基梅隆大学的研究者提出 BestRand,这是一种稳定且低成本的基准压缩方法,其依据是一个解析近似,该近似显示子集估计误差呈长尾分布;该方法保持随机采样的效率,同时将高误差风险降低 50.2%,估计误差降低 16.4%,分布外误差降低 21.8%,覆盖 70 多个文本、多模态、agent 和 VLA 基准,构建成本仅为竞争方法的 51.3%。
核心贡献
- 针对基准压缩的误差分布推导了一个解析近似,表明基于子集的估计呈现长尾分布:大多数子集产生较小误差,但少数子集产生大误差;这种不稳定性源于基础模型之间的相似性。
- 提出 BestRand,一种稳定且低成本的基准压缩方法,该方法生成多个随机子集,并使用少量探针模型选择最佳候选,既保持随机采样效率,又降低高误差尾部。
- 在 70 多个文本、多模态和 agent 基准以及 VLA 评估上的实验表明,BestRand 平均将高误差风险降低 50.2%,估计误差降低 16.4%,构建成本仅为竞争方法的 51.3%;在分数范围、模型家族和时间偏移下,分布外估计误差进一步降低 21.8%。
引言
评估大型语言模型和视觉语言模型在基准上的表现可能成本高昂,因为基准通常包含大量或冗余样本,因此基准压缩对于从小规模子集近似完整结果很有价值。此前研究未能精确刻画这些近似的准确性和可靠性,而随机采样虽然通常有效,但由于基础模型之间的相似性会引发罕见的大误差,仍然不稳定。作者推导了基准压缩误差分布的解析近似,解释了随机子集在高概率下的有效性及其尾部不稳定性。他们还提出了 BestRand,一种由探针引导的随机选择方法,以低构建成本降低高误差风险和估计误差,并在 70 多个文本、多模态、agent 和视觉语言动作基准上进行了验证。
方法
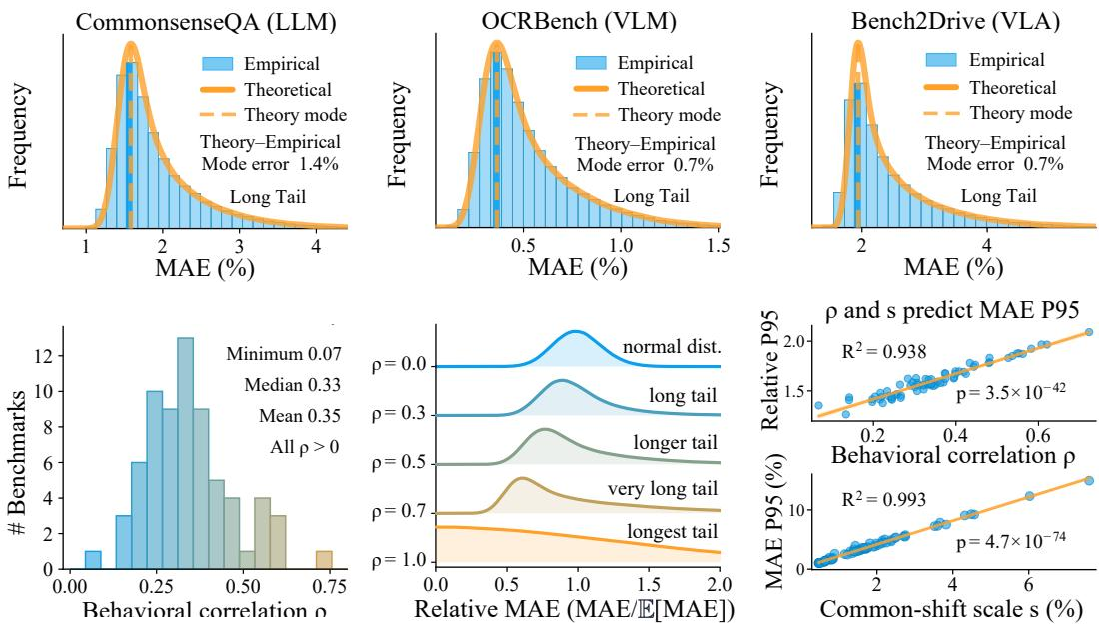
作者观察到,虽然随机采样在基准压缩中非常高效,但由于高误差率的长尾,它存在不稳定性。这种不稳定性的根源在于基础模型之间的行为相关性,它们共享相似的骨干网络和训练语料。为了形式化这一问题,作者将估计误差向量建模为近似服从零均值多元正态分布。大误差的主要来源被识别为公共偏移,它衡量被采样子集整体上比完整基准更容易或更难。
如下图所示:
理论分析表明,公共偏移的方差与行为相关性成比例。因此,即使被评估模型数量增加,共享误差也不会被平均掉,仍存在不可忽略的高误差抽取风险。这一洞察确立了所提方法的核心目标:保持随机采样的低计算成本,同时主动降低选择具有较大公共偏移的子集的风险。
为了实现稳定且低成本的基准压缩,作者提出了 BestRand。其核心机制利用一小组低成本探针模型,对更大池中的候选子集进行评估并选择最具代表性的子集。该过程分为四个不同步骤。
第一,算法从完整基准中无放回地均匀抽取一个项目池。然后,仅在该池上评估探针模型,记录每个项目的探针分数。第二,计算表示整个池中平均探针分数的参考向量。该池均值用作完整基准均值的代理,无需对所有项目运行探针。
第三,该方法从池中无放回地均匀抽取目标大小的多个候选子集。对每个候选,计算平均探针分数,并衡量不平衡程度,定义为候选均值与池参考之间的平方距离 dj=∥hj−H∥2。最后,BestRand 选择使该不平衡最小化的候选子集,并仅在该选定子集上评估所有目标模型。
该设计的有效性建立在公共偏移的正交分解之上。作者证明,公共偏移可以拆分为探针可解释分量和残差分量。通过选择最匹配参考探针均值的候选,BestRand 直接最小化公共偏移方差中由探针解释的分量。
由于候选搜索复用初始池遍历时缓存的探针分数,计算开销很小。搜索过程本身可以作为单个批量张量操作执行,因此选择几乎是瞬时的。池大小控制参考近似的准确性,候选数量控制搜索质量。
如下图所示:
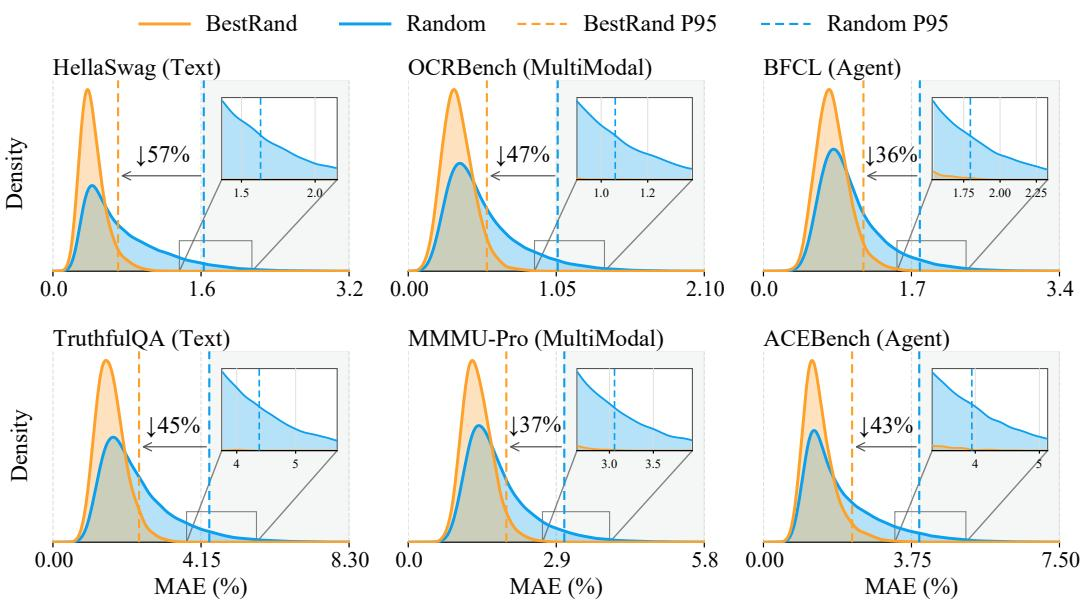
通过针对探针可解释方差,该方法成功抑制了误差分布的上尾部。实证结果表明,与标准随机采样相比,BestRand 将平均绝对误差集中在接近零的区域,并显著降低高误差结果的出现概率,从而提供了高度稳定且高效的压缩流程。
实验
在 70 个文本、多模态和 agent 基准上,以 2% 至 50% 的保留比例对 BestRand 进行评估,并与随机采样以及基于学习或聚类的基线进行比较,评估指标为平均绝对误差和高误差风险。主要实验表明,由探针引导的候选选择在准确性和稳定性上优于随机采样,同时所需的构建数据更少。消融实验表明,随着探针模型数量、候选数量和池大小增加,性能会提升但收益递减;在构建模型有限以及分数范围、模型家族和时间偏移下,BestRand 仍保持有竞争力或更好;并且该方法对探针选择和匹配范数具有鲁棒性。总体而言,结果支持 BestRand 作为一种低成本、稳定的基准压缩方法,在准确性-成本权衡上优于现有方法。
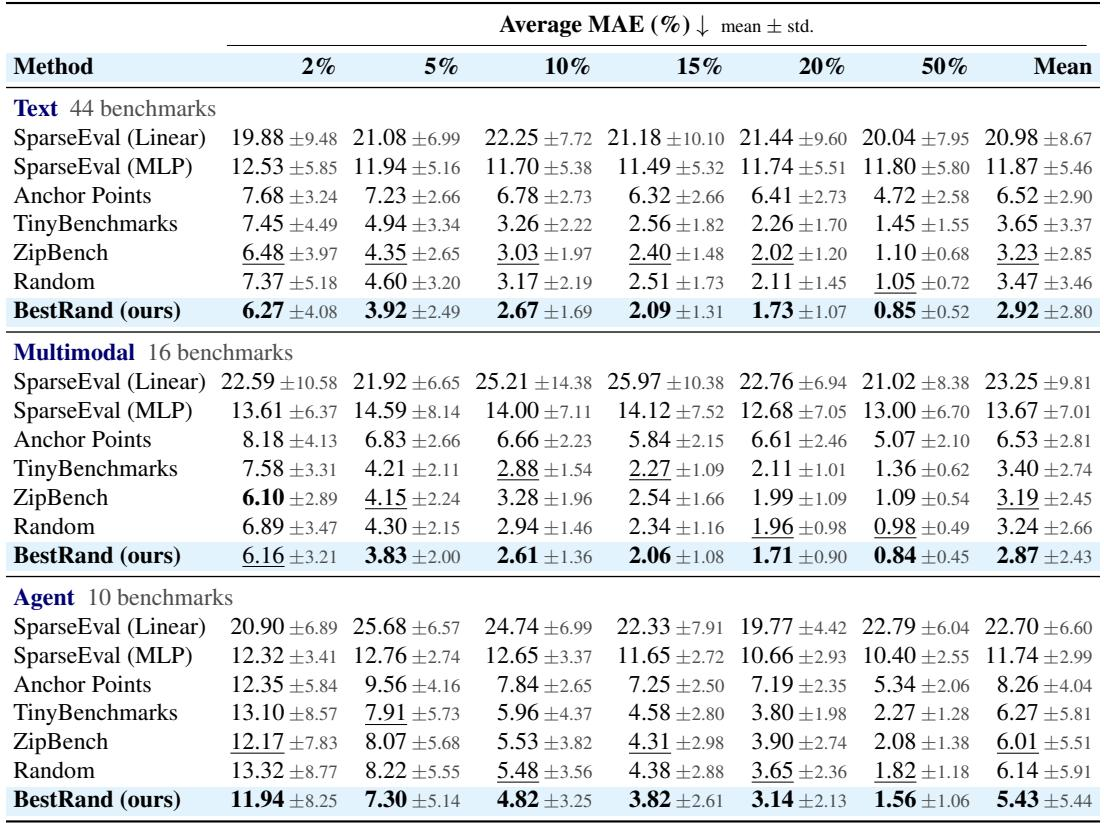
在文本基准组中,ZipBench 和 TinyBenchmarks 是所列方法中最强的,随着保留比例增加,平均误差大幅下降。Anchor Points 在较大保留比例下也有所改善,但准确性仍然较低;SparseEval 预测器在不同预算下误差持续较高且变化较大。ZipBench 和 TinyBenchmarks 在文本基准上取得所列方法中最低的平均误差,其中 ZipBench 在整体及多数保留比例下领先。更高保留比例对 Anchor Points、TinyBenchmarks 和 ZipBench 的误差降低最为明显,而 SparseEval 方法在不同预算下相对平坦且误差较高。
BestRand 在所有评估的分布外偏移中均取得最低平均误差,包括分数范围、模型家族和时间变化。相比之下,拟合历史性能记录的方法在这些偏移下表现不如 Random。BestRand 在每个 OOD 设置中均获得最低误差:中段到尾段、低到高、高到低、留出家族以及过去到未来的偏移。使用历史性能记录的基于学习的方法在所有测试的分布偏移下均不如 Random。BestRand 相对于竞争基线将平均 OOD 误差降低 21.8%。
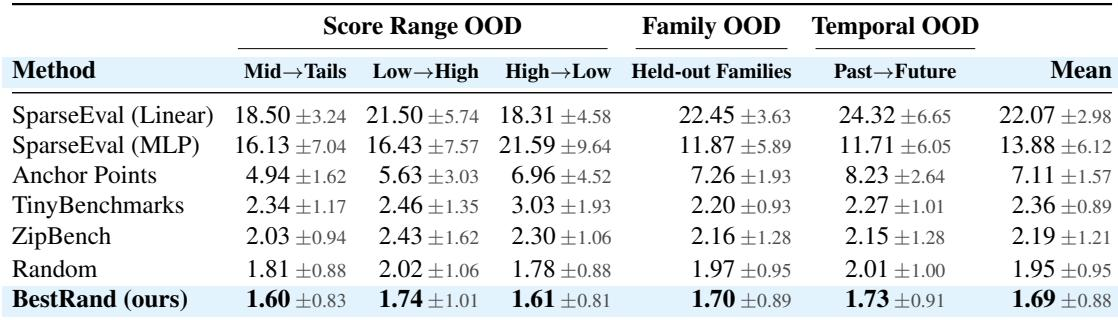
文本基准评估在不同保留比例下比较了预测方法,结果表明 ZipBench 和 TinyBenchmarks 实现最低误差,并随保留比例增加而改善最大;Anchor Points 有所改善但仍不够准确,SparseEval 保持平坦且误差较高。在覆盖分数范围、模型家族和时间偏移的分布外测试中,BestRand 在每个设置下均持续获得最低误差;拟合历史性能记录的方法在所有偏移下均不如 Random,BestRand 相对于竞争基线大幅降低了平均 OOD 误差。