Command Palette
Search for a command to run...
Wave Forcing:迈向光速级流式视频生成
Wave Forcing:迈向光速级流式视频生成
Yijie Jin Yuxuan Liu Jiajun Xu Ye Huang Chuzhi Wang Jiayang Li Ruiyang Chen Chenling Hong Xu Wang Zhijie Deng
摘要
实时长视频生成需要连续输出,并保持一致的外观和自然的运动。现有的逐块自回归方法在生成效率和长视频质量方面都面临挑战:即使采用单步去噪,串行去噪与历史缓存刷新也需要两次前向传播;更长的生成过程可能降低质量并导致镜头漂移。我们提出 Wave Forcing(WF),协同设计生成、训练与执行,以支持采用多步去噪的连续视频输出。WF 使用逐块因果注意力,在较早且更干净的块尚未完成去噪时即可访问它们,并将交错去噪与缓存刷新阶段分配到完整模型副本上,以实现 1F1C:在流水线填充后,每轮并发前向计算输出一个块。为了使模型适应这一连续生成过程,我们开发了一种三阶段训练流程,依次引入混合噪声去噪、运动监督和基于自生成历史的因果适应。为高效执行该过程,Wave Runtime(WaveRT)利用 Wave Parallelism(WP)实现 K/V 提前传递和通信与计算重叠,并结合优化内核与流水线化 VAE 解码。在 Wan2.1-T2V-1.3B 上的实验表明,5 步 WF 在保持与 Rolling Forcing 相当的总体质量的同时,在短视频和长视频上均实现了更高的 Dynamic Degree。我们的系统效率实验表明,4 步 WF 在 8 块 H200 GPU 上实现了 147.6 DiT FPS 和 134.8 端到端 FPS,端到端吞吐量是单 GPU 的 7.07 倍。在匹配 SageAttention+W8A8 后端、去噪步数与 GPU 数量的 DiT-only 测试中,WP 在六种模型规模(1.3B–14B)上提供的吞吐量最高可达 Ulysses 和 Ring 上下文并行基线中较快者的 2.53 倍。
一句话总结
上海交通大学、西安交通大学、北京大学、华东师范大学和台湾清华大学的研究者提出 Wave Forcing,一种用于连续视频生成的生成-训练-执行协同设计,利用分块因果注意力和跨模型副本的错峰去噪,实现每轮前向一个输出块;其 Wave Runtime 达到 147.6 DiT FPS,吞吐量最高可达 Ulysses 和 Ring 上下文并行基线中较快者的 2.53×。
核心贡献
- Wave Forcing(WF)是一种生成、训练与执行协同设计,利用分块因果注意力在去噪完成前访问更早的更干净块,并跨全模型副本分布错峰去噪与缓存刷新阶段,流水线填充后每轮并发前向产生一个输出块。
- 三阶段训练流程依次引入混合噪声去噪、运动监督,以及使用自生成历史的因果适应,使模型适应连续生成过程。
- Wave Runtime(WaveRT)利用 Wave Parallelism(WP)实现提前 K/V 交付和通信-计算重叠,并采用优化内核和流水线 VAE 解码。在 Wan2.1-T2V-1.3B 上,5 步 WF 在保持与 Rolling Forcing 相当的整体质量的同时获得更高的 Dynamic Degree;4 步 WF 在 8 个 H200 GPU 上达到 147.6 DiT FPS 和 134.8 端到端 FPS。在匹配的 DiT-only 测试中,WP 的吞吐量最高可达 Ulysses 与 Ring 上下文并行基线中较快者的 2.53 倍。
引言
实时流式视频生成需要在保持可播放输出的同时维持一致外观和自然运动,因此 Self Forcing、Causal Forcing 等分块自回归扩散方法对条件生成十分重要。然而,在干净历史缓存约定下,这些方法需要额外的 store 前向过程来刷新键值历史,因此顺序执行每个块需要多次前向过程,即使一步去噪也需要两次前向,限制了流式吞吐量。作者引入 Wave Forcing,一种因果波前生成方法,将去噪阶段和 store 跨全模型副本流水化,使较新块能在前序块完成前以更早、更干净的块为条件,并在流水线填充后每轮并发前向产生一个完成块。该方法由分阶段训练和 Wave Runtime 支撑,Wave Runtime 提供重叠的键值交付和优化执行。
方法
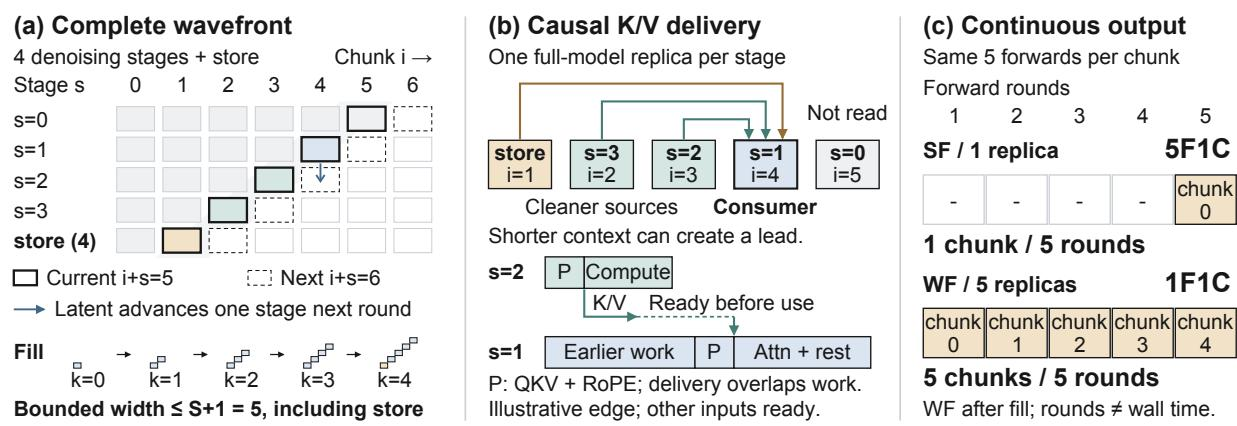
作者引入 Wave Forcing(WF),使后续块在其前序块完成去噪前即可推进。WF 构成一个因果波前:较新、噪声较多的块读取较早、较干净的状态,反之则不行。该机制通过有界宽度因果波前实现,波前按由 k=i+s 定义的轮次更新单元。该方法在每个块内保留全注意力,并在视频时间维上使用分块因果注意力。注意力掩码 MWF(s,j)=1[j≥s] 在自身及所有更干净的前序块上形成下三角结构,移除了 Rolling Forcing 中存在的反向细化。
如下图所示:
为了使模型适应该因果波前推理,作者采用三阶段训练过程。因果掩码移除了对更晚、噪声更大的活动块的访问,从而改变学习到的条件信息。
框架图如下:
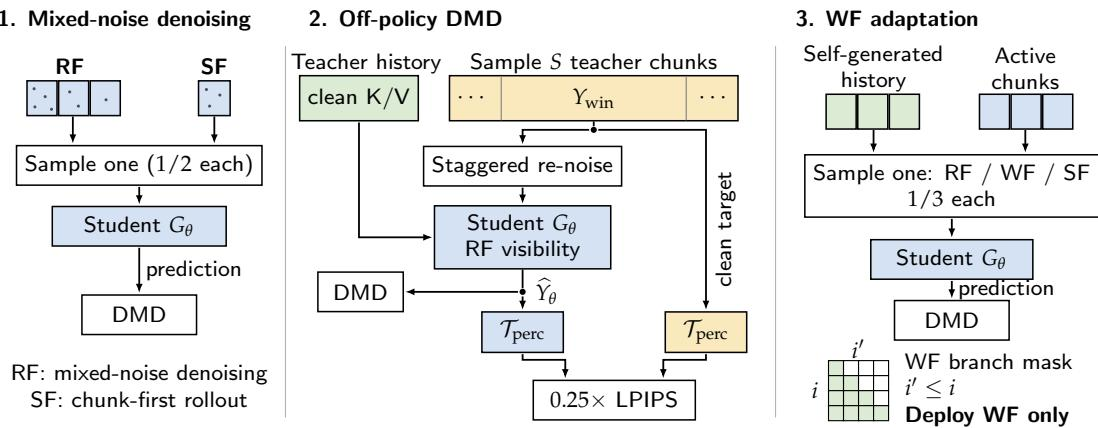
阶段 1 涉及混合噪声初始化。作者采用混合噪声联合去噪设置,在具有不同噪声水平的块之间使用双向注意力。作者以相等概率采样 Rolling Forcing(RF)rollout 或 Single-Frame(SF)rollout,并用分布匹配蒸馏(DMD)训练学生模型。阶段 2 是离线策略 DMD。遵循 LPM 1.0,连续教师块在错峰时间步重新加噪,前序教师块作为干净的 K/V 历史。该阶段保留双向注意力,以提供更强的运动和主体引导。损失函数结合 DMD 与 LPIPS 监督:
L2=E[DDMD(Yθ;c)+λpLPIPS(Tperc(Yθ),Tperc(Ywin))],λp=0.25阶段 3 引入因果上下文和自生成历史。每次迭代均匀采样自生成的 RF、WF 或 SF rollout,用于在线策略 DMD。WF 使用因果上下文,包括来自自身输出的 store 刷新历史。分支目标为 L3=31LRF+31LWF+31LSF。
Wave Runtime(WaveRT)通过让阶段所属副本提前发布 K/V,并让交付与计算重叠,实现 Wave Parallelism(WP)。每个去噪阶段和 store 持有一个全模型 GPU 副本。在一轮内,局部投影可以不等远程 K/V 直接进行,但注意力必须等待 store 和所有合法且更干净的 rank 提供其 K/V。
如下图所示:
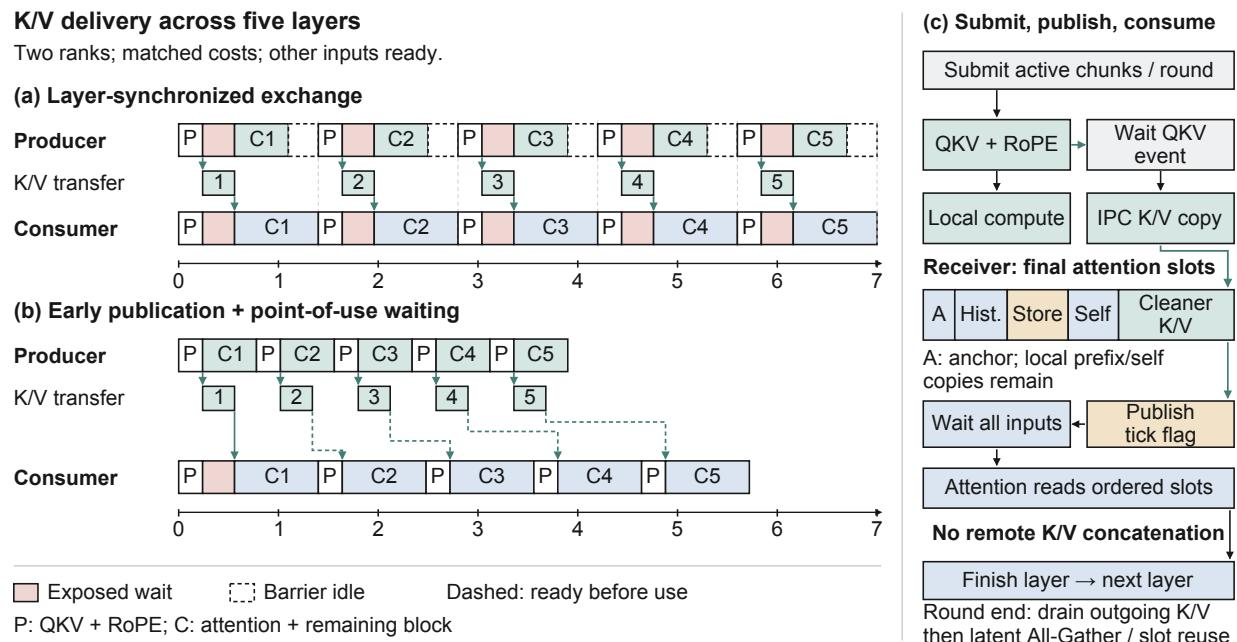
WaveRT 在 QKV 投影和 RoPE 后发布 K/V,并在注意力前立即检查就绪状态。这种提前发布隐藏了后续等待。在统一时间基准上,消费者的暴露等待是对所需输入等待的最大值。分页交付将 K/V 直接写入有序注意力槽,并在使用前发出就绪信号,避免了远程拼接。
局部计算与 K/V 交付需要联合优化。异步解码将 VAE 与 DiT 重叠,但较慢的流水线会限制端到端吞吐量。作者使用性能分析得到的流式时间,在专用 GPU 之间均衡连续的 VAE 分区,同时保留请求局部的因果缓存。
框架图如下:
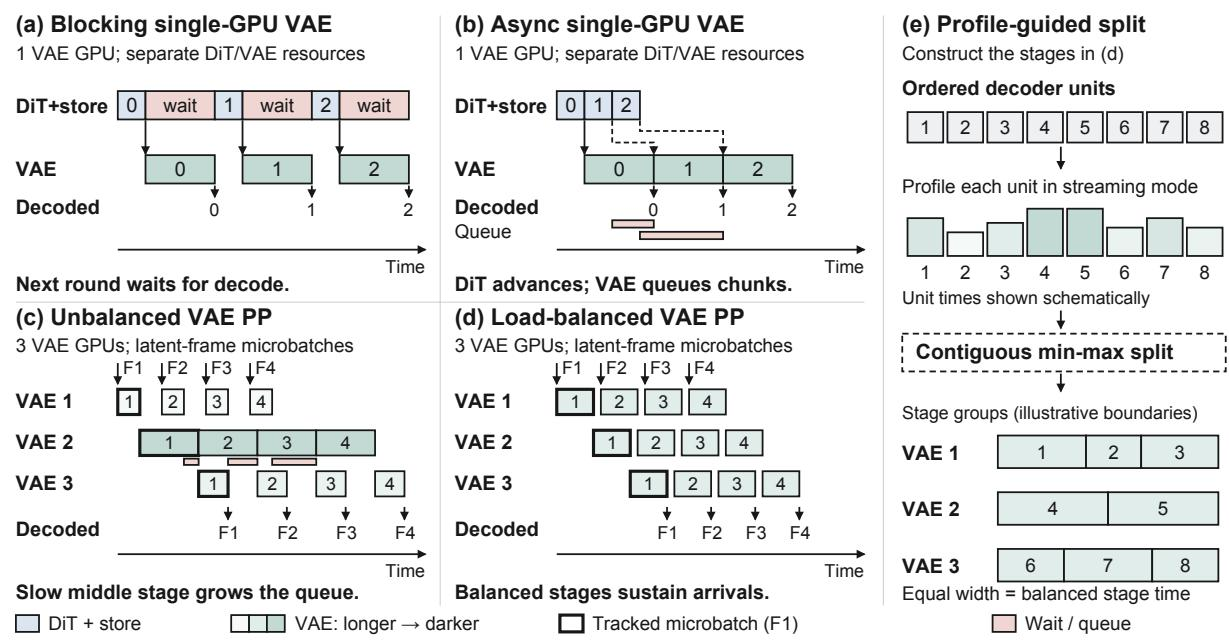
解码和阶段间传输必须维持 DiT 输出速率。WP 使用全模型副本,执行宽度由去噪步数决定。目标是让 K/V 在每层注意力前就绪,从而减少暴露的通信和同步等待。
实验
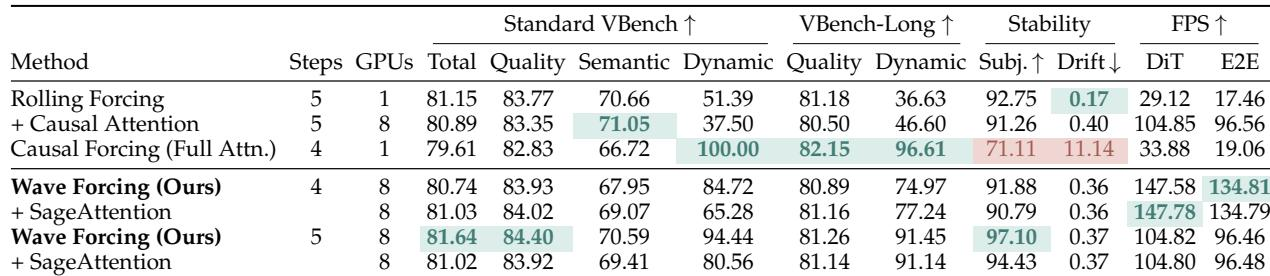
实验基于 Wan2.1-T2V-1.3B 构建 4 步和 5 步 Wave Forcing,并与 Rolling Forcing 和 Causal Forcing 在短、长视频生成基准以及主体保持和相机漂移诊断上比较。Wave Forcing 在视觉质量、运动和长视频稳定性方面取得最佳整体平衡;Causal Forcing 运动和视频质量较高,但主体丢失和相机漂移严重;Rolling Forcing 保持主体但运动很少。训练消融显示,离线策略 DMD 和组合训练分支对这种平衡必不可少。推理和系统实验进一步表明,WaveRT 和波前并行执行提高了吞吐量,分页内存和 W8A8 在更大规模下有所帮助,而 VAE 容量、训练复杂度、固定条件评估和推理服务延迟仍是待解决的局限。
在比较方法中,Wave Forcing 在短视频质量、运动和长视频稳定性方面取得最佳整体平衡。其 5 步配置在 VBench Total 和 Quality 上领先,同时保持近乎完美的主体保持和极低相机漂移。Causal Forcing 达到最高的长视频 Quality 和 Dynamic Degree,但其主体保持较低、相机漂移较高,表明长格式输出不稳定。Wave Forcing 的 5 步变体获得最高的 VBench Total 和 Quality,同时保持最高 Subject Preservation 和非常低的 Camera Drift。Causal Forcing 获得最高的 VBench-Long Quality 和 Dynamic Degree,但其低得多的 Subject Preservation 和高得多的 Camera Drift 使高运动不可用。4 步 Wave Forcing 配置提供比 rolling 和 causal 基线显著更高的 DiT 和端到端 FPS,且没有 Causal Forcing 下的稳定性崩溃。
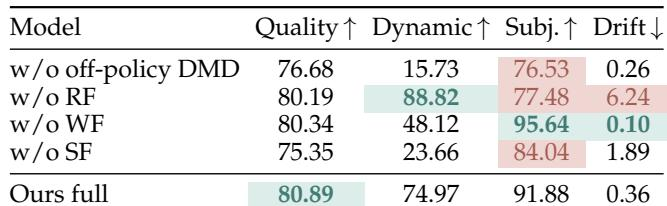
完整训练配置在质量、运动、主体保持和相机漂移方面取得最强的整体平衡。移除离线策略 DMD 或 SF 会导致动态运动显著下降,而移除 RF 尽管运动较高,却会大幅增加相机漂移。完整配置具有最高质量分数,并将相机漂移保持在相对较低水平。移除离线策略 DMD 会大幅削弱动态运动并降低主体保持。移除 RF 会产生最高的动态运动,但相机漂移也大幅增加。
评估在短视频质量、运动、主体保持、相机漂移和长视频稳定性方面比较 Wave Forcing 与 rolling 和 causal 基线。5 步 Wave Forcing 变体取得最佳整体平衡,而 Causal Forcing 产生高运动和长格式质量,但主体和相机行为不稳定。4 步 Wave Forcing 提升推理速度,且没有 Causal Forcing 下的稳定性崩溃。消融显示完整训练配置是必要的:移除离线策略 DMD 或 SF 会降低动态运动和主体保持,移除 RF 会显著增加相机漂移。