Command Palette
Search for a command to run...
面向统一多模态模型的连续空间潜在推理
面向统一多模态模型的连续空间潜在推理
Byungwoo Jeon Yoonwoo Jeong Hyunseok Lee Minsu Cho Jinwoo Shin
摘要
统一多模态模型(UMMs)在多种多模态理解与生成任务上取得了显著成功,但在图像生成中仍难以有效利用基于语言的思维链推理。因此,现有增强推理的 UMMs 往往无法继承在大语言模型中观察到的测试时扩展能力和细粒度可控性。我们将这一不足归因于根本性的模态不匹配:推理在离散 token 空间中进行,而图像生成在连续空间中运行。为弥合这一差距,我们提出了连续空间潜在推理框架(LARC),通过在连续隐藏状态上进行推理来缓解 token 级瓶颈。具体来说,该训练框架由两个阶段组成:(i)课程式监督微调(SFT),以及(ii)信息增益强化学习(RL)。首先,课程式 SFT 阶段逐步将 token 级推理转化为潜在推理。随后,信息增益 RL 阶段在无真值监督的情况下使潜在推理自我进化。在多个文本到图像生成基准上的实验表明,LARC 持续提升了生成质量、提示遵循性和组合保真度。值得注意的是,LARC 在 GenEval 上取得了最优性能,较 BAGEL 提升 7%p,并展现出明显的测试时扩展行为,在并行和串行测试时扩展策略下均优于基于 token 的生成。
一句话总结
来自 KAIST、POSTECH 和 RLWRLD 的研究人员提出了连续空间潜在推理(LARC),这是一个两阶段框架,结合课程监督微调和信息增益强化学习,将多模态推理从离散 token 空间转移到连续隐藏状态,从而提升文本到图像生成质量、提示遵循和组合保真度,同时在 GenEval 上取得最先进性能,比 BAGEL 高出 7%p。
核心贡献
- LARC 是一个潜在推理框架,在连续隐藏状态而不是离散 token 上进行推理,弥合了统一多模态模型中离散推理 token 与连续图像生成之间的模态差距。
- 训练流程结合了课程监督微调与信息增益强化学习阶段:课程监督微调逐步将 token 级推理转换为潜在推理,信息增益强化学习阶段在没有真实监督或外部评价器的情况下自我演化潜在推理。
- 文本到图像生成基准上的实验表明,LARC 提升了生成质量、提示遵循和组合保真度,并在 GenEval 上取得最先进性能,比 BAGEL 高出 7%p。LARC 是首个具备清晰测试时扩展能力的推理增强 UMM,用于图像生成,在并行和顺序测试时扩展策略下均优于基于 token 的生成。
引言
统一多模态模型(UMM)将图像生成与大语言模型结合,以处理复杂视觉语义的语言级规划,但尚未继承大语言模型中的测试时扩展行为。作者将其归因于模态不匹配:推理在离散 token 上进行,而图像生成需要稠密、空间对齐的连续潜在表示。因此,额外的推理计算往往退化为浅层提示操作,而不是有意义的规划。为解决这一问题,作者提出了 LARC,一个在与图像生成对齐的连续潜在空间中直接进行推理的框架。LARC 使用课程监督微调逐步将 token 推理替换为随机连续隐藏状态,随后使用带信息增益奖励和防坍缩奖励的强化学习,无需真实推理链或外部评价器。由此得到首个具备清晰测试时扩展能力的推理增强 UMM,可用于文本到图像生成。
数据集
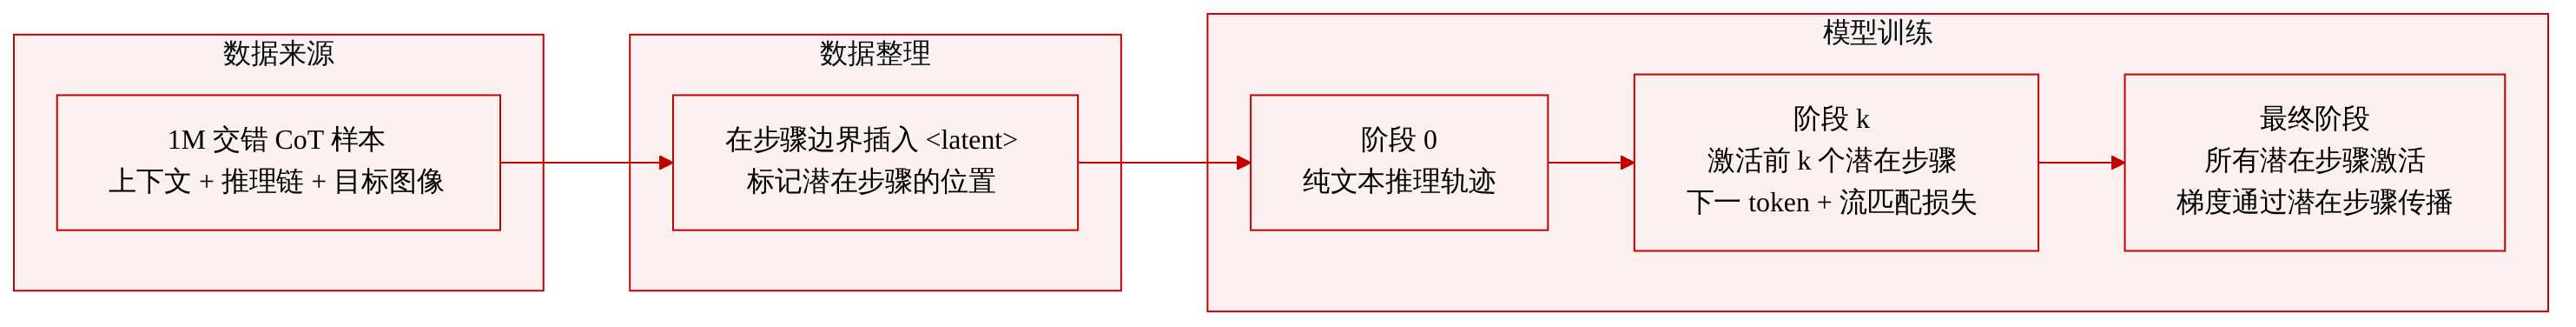
- 数据集组成与来源:作者收集了 100 万条交错思维链样本。每个样本包括输入上下文、逐步推理链和目标图像。本摘录未进一步说明来源细分、混合比例或训练/验证划分。
- 数据格式与预处理:每条推理链通过在步骤边界插入特殊 token
<latent>进行处理。这标定了可引入潜在步骤的位置,并创建交错的文本与潜在轨迹。 - 基于课程的使用方式:数据用于课程监督微调。最初,所有潜在步骤被抑制,模型在纯文本推理轨迹上训练;后续阶段逐步激活前 k 个潜在步骤,每个新增潜在步骤都建立在已训练的稳定前缀之上;最后阶段激活所有潜在步骤。
- 该数据的训练目标:模型通过文本段上的 next-token 预测损失和目标图像上的流匹配损失进行优化。潜在步骤没有显式监督目标;梯度穿过它们传播,使它们能自动学习有用表示。
- 其他处理:本文该部分未描述裁剪策略或额外元数据构建。
方法
作者提出 LARC,一个使统一多模态模型(UMM)能够通过连续空间中的潜在推理进行图像生成的框架。该方法围绕两阶段训练流程构建。阶段 1 使用课程监督微调将 token 级推理转换为交错潜在推理,阶段 2 使用带信息增益奖励的自我演化强化学习来细化潜在推理轨迹,无需外部评价器。
交错潜在推理
为使连续空间推理与策略梯度优化兼容,LARC 将推理轨迹形式化为交替的文本段和连续潜在步骤序列,两者均由 UMM 骨干生成。给定输入上下文 c=(c1,…,cT),包含文本提示和可选源图像,模型生成推理轨迹,随后生成目标图像 x。
轨迹在两种模式之间交替。在语言模式下,模型通过随机采样生成文本 token,这使轨迹在策略优化期间暴露于梯度信号。在潜在模式下,模型生成绕过文本解码的连续推理步骤,从而保留内部表示的语义信息。
形式上,UMM 骨干首先处理输入嵌入 ET=[e(c1),…,e(cT)],生成隐藏状态 HT=Transformer(ET)。当模型在位置 t 生成特殊 token <latent> 时,潜在模式开始,下一位置的嵌入被设为 ht,即最终 transformer 层中位置 t 的隐藏状态。下一位置嵌入更新定义为
其中
Ht+1=Transformer(Et+1).在推理时,模式交替持续到模型生成 <eos> token。每个 <latent> token 标记从语言模式片段到下一个潜在步骤的转换。终止后,完整轨迹的隐藏状态 h(τ) 由图像模块通过交叉注意力读取,以生成目标图像 x。所得轨迹形式为
其中 sn 表示第 n 个语言模式片段,ln 表示第 n 个潜在模式隐藏状态。轨迹长度和片段长度由模型何时生成 <eos> 和 <latent> token 决定,而不是由外部计划决定。
阶段 1:课程学习监督微调
从训练一开始就引入所有潜在步骤往往不稳定,因为潜在流缺乏直接监督,且模型尚未学会基本推理格式。为解决这一问题,LARC 使用课程逐步将 token 级推理转换为潜在推理。
在数据构建方面,作者收集了 100 万条交错思维链样本,每个样本包含输入上下文 c、逐步推理链和目标图像 x。特殊 token <latent> 被插入到推理步骤边界,以标记引入潜在步骤的位置。
课程从纯文本轨迹开始
τ(0)=(s1,…,sN),它在标准 next-token 预测下建立推理格式。在阶段 k(k=1,…,N−1)中,仅激活前 k 个潜在步骤,因此每个新引入的潜在步骤都建立在稳定前缀之上。最后阶段激活所有潜在步骤,并在每次阶段转换时降低学习率。
SFT 目标结合了文本段上的 next-token 预测损失与目标图像上的流匹配损失:
LSFT(k)=−n=1∑Nlogπθ(sn∣c,s<n,l<min(n,k+1))+Lflow(x∣c,s1:N,l1:k).这里,s<n 和 l<min(n,k+1) 表示在阶段 k 中位于 sn 之前的文本段和活跃潜在步骤。梯度穿过潜在步骤传播,没有显式监督目标,使潜在表示能够编码有用信息而无需外部偏置。
阶段 2:自我演化强化学习
仅靠监督微调在细化潜在推理方面存在局限,因为潜在标注无法直接获得。因此,LARC 引入自我演化强化学习阶段,其内在奖励来自 UMM 本身,从而避免任何外部评价器。
奖励定义为推理轨迹为冻结参考模型提供的信息增益。令 πref 表示阶段 1 模型,pπref(x∣⋅) 表示图像模块密度,则采样轨迹 τ 的信息增益奖励为
rIG(τ;x,c)≜logpπref(x∣c,h(τ))−logpπref(x∣c).当轨迹提高目标图像在参考模型下的似然时,该奖励为正;当轨迹在上下文之外没有提供额外信息时,该奖励为零。在期望上,它对应于给定上下文时潜在推理轨迹与目标图像之间的条件互信息。
由于图像模块不直接提供对数似然,奖励被估计为共享噪声下条件流匹配损失的配对差值:
rIG(τ;x,c)≈Lflowπref(x,c)−Lflowπref(x,c,h(τ)).为防止潜在坍缩,LARC 添加了步间多样性正则项,鼓励不同潜在步骤之间的差异:
rdiv(τ)=N(N−1)1n=n′∑(1−cos(ln,ln′)),其中 cos(⋅,⋅) 表示潜在模式隐藏状态之间的余弦相似度。因此总奖励为
R(τ;x,c)=rIG(τ;x,c)+λdiv⋅rdiv(τ).策略通过最大化采样轨迹上的期望奖励来优化:
πθmaxE(c,x)∼D[Eτ∼πθ(⋅∣c)[R(τ;x,c)]].作者采用 GRPO 作为优化算法,该算法从分组采样中估计优势,无需显式价值模型。这使得相同的优化设置能够跨基准迁移,同时保持训练稳定。
实验
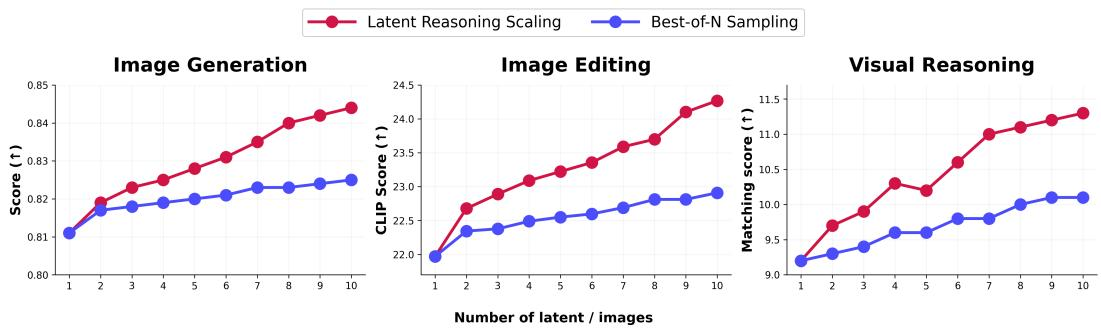
评估在文本到图像生成、图像编辑和多模态理解任务上考察 LARC,使用 GenEval、DPG-Bench、OneIG-Bench、CompBench、MME、MMB 和 MIRA 等基准,并与统一多模态模型和专用生成模型进行比较。LARC 持续提升生成质量、提示遵循、编辑保真度和视觉推理,最大收益出现在对组合要求较高和多步推理场景中。测试时扩展表明,增加潜在推理预算可在各任务上单调提升性能,并优于 best-of-N 采样;消融实验确认潜在推理、交错文本段以及带自我演化强化学习的两阶段训练均对整体收益有贡献。
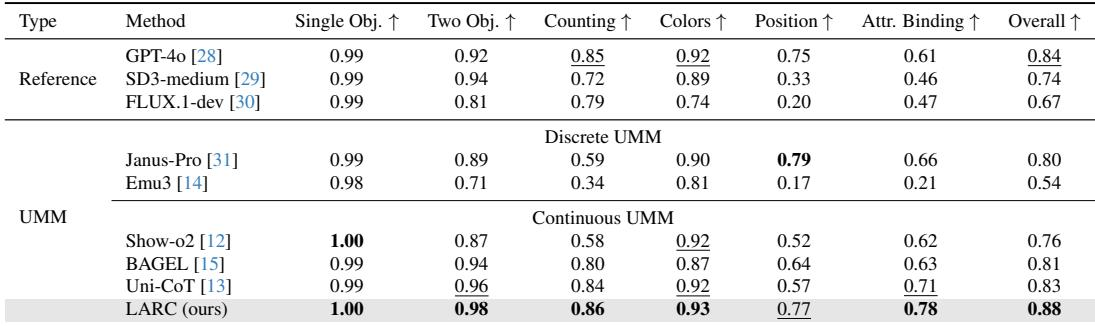
LARC 在 GenEval 上取得强文本到图像生成性能,在大多数子类别上优于或匹配参考模型和离散统一多模态模型。相较基线的最大提升出现在属性绑定上,表明对物体属性的组合处理有所改善。整体结果显示,提示遵循生成有广泛提升。LARC 在 GenEval 各子类别和总分上优于或持续匹配竞争基线。属性绑定相较基线的改进最为显著,提升 15 个百分点。对组合要求较高的生成收益最大,而其他子类别仍具竞争力。
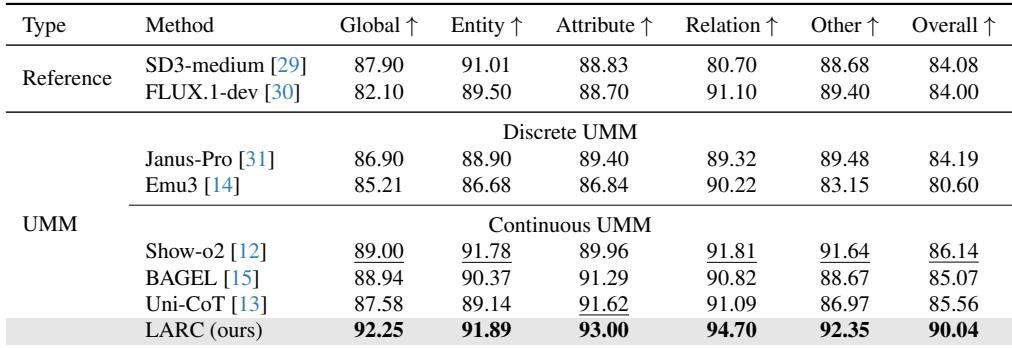
在 DPG-Bench 上,LARC 相较其基础模型 BAGEL 提升了提示遵循保真度,总分从 85.07 提高到 90.04。报告的增长在全局、实体、属性、关系和其他类别上保持一致,表明跨提示类型的广泛泛化。在所列基线中,连续统一多模态模型 Show-o2 取得最高总分,领先于离散统一多模态基线。LARC 在 DPG-Bench 上总分达到 90.04,比基础模型 BAGEL 的 85.07 相对提升 5.8%。在每个子类别上,LARC 均相较竞争基线表现出稳定提升,包括全局、实体、属性、关系和其他提示类型。在所提供的基线行中,连续 UMM Show-o2 取得最高总分 86.14,优于 Janus-Pro 和 Emu3 等离散 UMM。
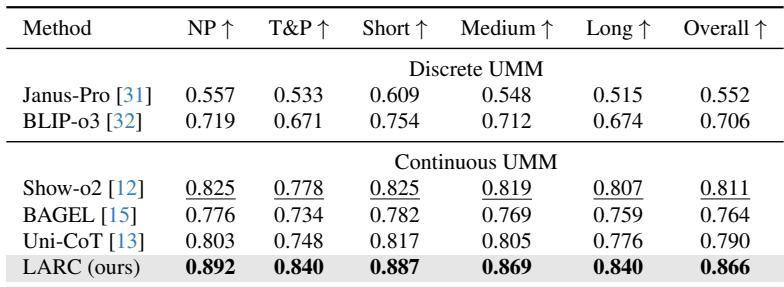
在 OneIG-Bench 上,连续统一多模态模型优于离散模型,自然语言提示的得分持续高于基于标签和基于短语的提示。随着提示长度从短到中再到长增加,得分普遍下降,但对最强的连续模型而言降幅不大。LARC 相较 BAGEL 基线整体提升 10.2 个百分点,并在提示类型和长度上保持稳定改进。在自然语言和标签/短语提示类别中,连续统一多模态模型得分高于离散模型。LARC 将 OneIG-Bench 总分相较 BAGEL 提升 10.2 个百分点,并在提示类型和长度上均有提升。
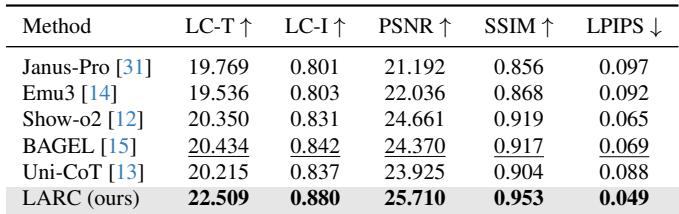
LARC 在 CompBench 上取得最强的图像编辑结果,在文本对齐、图像相似度、像素质量和感知相似度上优于所有列出的基线。相较 BAGEL 的提升在指令遵循和感知质量方面尤其明显,而竞争统一多模态模型普遍落后。LARC 在所有比较方法中取得最佳的 LC-T、LC-I、PSNR、SSIM 和 LPIPS。与 BAGEL 相比,LARC 在编辑指令遵循方面有显著提升,感知误差明显降低。
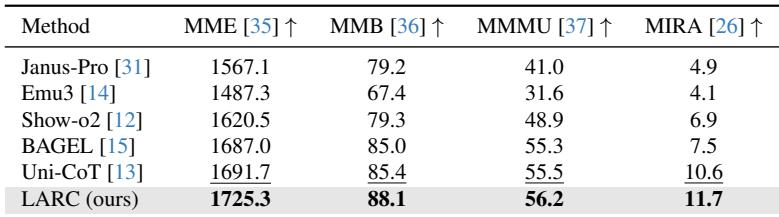
LARC 在 MME、MMB、MMMU 和 MIRA 上取得所比较方法中最高分。它在全部四个基准上均优于 BAGEL 和 Uni-CoT,其中 MIRA 视觉推理的提升最显著。MME 和 MMB 上的提升表明,更强的多模态理解迁移到了感知密集型任务,而没有牺牲一般视觉理解。LARC 在 MME、MMB、MMMU 和 MIRA 上优于 BAGEL 和 Uni-CoT。最大改进出现在 MIRA 上,LARC 超过 BAGEL 和离散推理模型 Uni-CoT。
评估涵盖 GenEval 和 DPG-Bench 上的文本到图像生成、OneIG-Bench 上的提示遵循和长度泛化、CompBench 上的图像编辑,以及 MME、MMB、MMMU 和 MIRA 上的多模态理解。LARC 相较其 BAGEL 基线持续提升,在属性绑定、指令遵循和视觉推理方面收益显著,同时匹配或超过竞争的离散和连续统一多模态模型。结果表明,LARC 的改进可泛化到生成、编辑和感知任务,而不会牺牲一般视觉理解。