Command Palette
Search for a command to run...
Flide:通过精确状态分叉加速决策推理
Flide:通过精确状态分叉加速决策推理
Bobo Li Jiajia Song Hao Fei Wynne Hsu Mong Li Lee
摘要
决策模型(如 Jev)已成为 LLM 智能体系统中极具前景的范式,能够为快速 System One 执行提供轻量且可靠的类别推理。然而,现有面向生成的推理引擎无法有效支持这些工作负载,存在严重的前缀重计算开销或输出概率失真问题。为应对这一挑战,我们提出 Flide,一种高效且精确的推理引擎,将决策请求的逻辑树结构与其在单一扁平 token 流中的物理执行解耦。通过 ForkAttention,Flide 在标准注意力层和循环 Gated DeltaNet 层中利用 GPU 驻留索引导航请求依赖,并在精确算术意义上保证每个查询分支的计算结果与独立前向传播完全一致。通过将分支拓扑直接表示为 GPU 驻留元数据,Flide 能够以一组紧凑的预录制执行图适应多样化的请求混合,同时支持不断增长的智能体历史从先前执行遍中保存的检查点恢复执行。在公开混合模型和决策模型上的广泛评估表明,Flide 回答查询的速度比 vLLM 和 SGLang 最高快 9.5 倍,同时在总变差距离上最接近 float32 参考结果。通过将物理执行吞吐量与数学精确性统一起来,Flide 为智能体系统中可扩展、延迟关键的决策智能奠定了原则性基础。
一句话总结
新加坡国立大学和牛津大学的研究者提出 Flide,一种精确决策推理引擎,将逻辑请求树与扁平化 token 执行解耦;其中 ForkAttention 在标准 attention 和循环 Gated DeltaNet 层上使用 GPU 常驻索引,确保分支与独立 forward pass 完全一致,在 agent 决策智能中比 vLLM 和 SGLang 最快达 9.5 倍,同时最接近 float32 参考结果。
核心贡献
- Flide 是一种面向决策模型的高效且精确的推理引擎,将请求的逻辑树结构与其在单个扁平化 token 流中的物理执行解耦,消除了冗余的前缀重复计算和分隔符引起的输出失真。
- ForkAttention 使用 GPU 常驻索引在标准 attention 与循环 Gated DeltaNet 层中导航请求依赖,保证在精确算术下每个 query 分支的计算结果与独立 forward pass 完全相同。
- 通过将分支拓扑表示为 GPU 常驻元数据,并使用一组紧凑的预录制执行图,Flide 支持混合请求工作负载,并允许不断增长的 agent 历史从先前 pass 中保存的 checkpoint 恢复。在混合架构与全 attention 架构、决策基准和真实 agent 轨迹上的评测显示,查询回答速度比 vLLM 和 SGLang 最高快 9.5 倍,同时在总变差距离上最接近 float32 参考。
引言
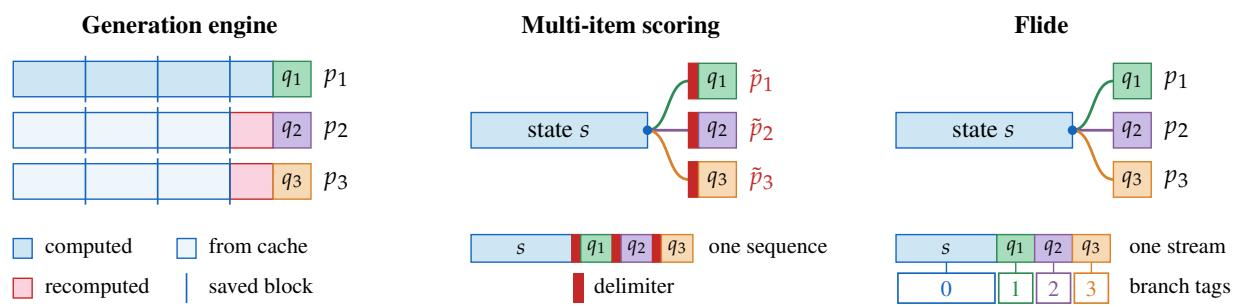
大语言模型越来越作为决策引擎用于路由、评估响应和选择 agent 动作,它们输出的是离散选项上的概率分布,而不是长文本。现有服务系统针对单序列生成进行了优化:要么为每个问题重复计算共享上下文,要么追加分隔符 token,从而改变隐藏状态并偏移概率;混合循环状态也只能在粗粒度边界恢复,并且依赖 batch 的归约顺序可能改变决策。为弥合这一差距,作者提出 Flide,一种推理引擎,将每个请求作为 GPU 元数据中的逻辑树保留,但将所有分支作为单个扁平 token 流一起执行。其 ForkAttention 机制传播 attention 与 Gated DeltaNet 状态,使每个问题都精确计算其单独运行时的结果,避免分隔符污染和重复的前缀工作,同时支持可选的 batch 不变浮点行为。
方法
作者提出 Flide,一种旨在高效处理决策请求的系统,其中每个请求包含一个共享状态和多个关联问题。Flide 不将每个问题作为独立序列处理,而是将每个请求的树结构作为逻辑基础,同时在 GPU 上把每轮请求作为单个扁平 token 流执行。这种方法最大限度地减少共享状态的重复计算,并显著降低 GPU 启动开销。
如下图所示:
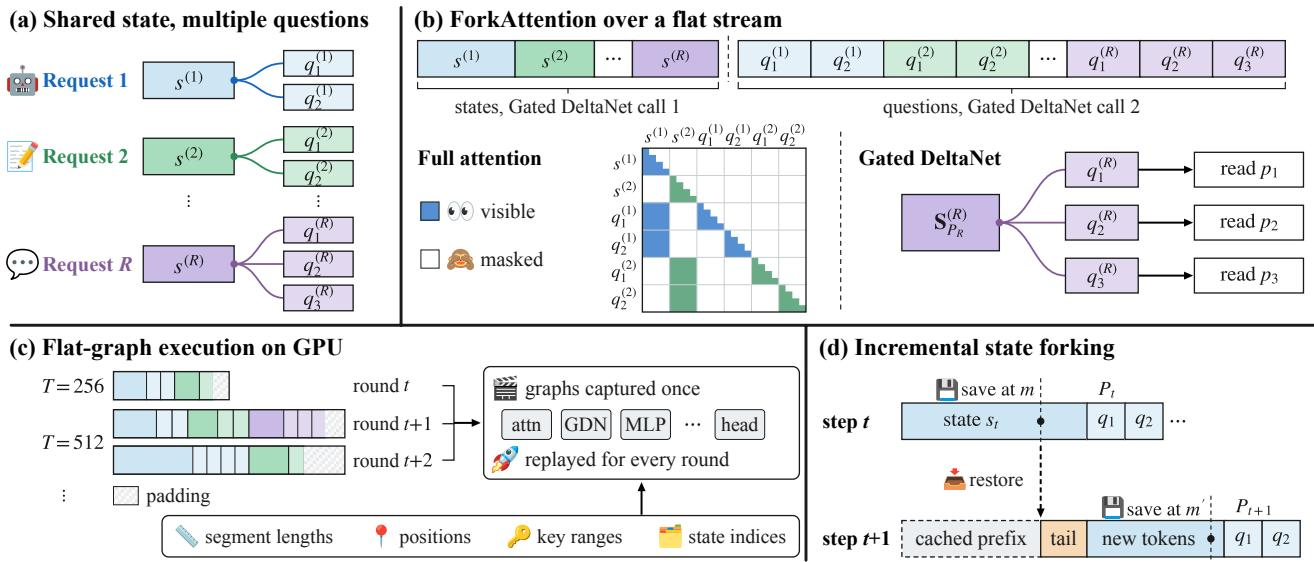
为确保每个问题在不修改 prompt 的情况下保持其精确的独立计算结果,作者设计了一个名为 ForkAttention 的模块。该模块将每个决策请求构建为一棵计算树,其中共享状态构成公共主干,问题作为独立分支分叉。通过将一整轮请求扁平化为连续 token 流而不进行填充,Flide 将此逻辑树映射到物理 GPU 布局上。每个 token 携带元数据,指示其请求索引、分支索引和顺序位置,从而确保问题的位置编码与独立序列中的位置编码一致。
对于全 attention 层,Flide 强制执行严格的可见性规则。一个 query token 只在以下条件满足时 attend 到一个 key token:它们属于同一请求,该 key 位于共享状态或该 query 的特定问题内,且该 key 不出现在序列中较后位置。这保证每个问题只 attend 其主干和自身。
混合模型通常用 Gated DeltaNet 层替代 attention,该层通过门控 delta 规则将所有先前 token 压缩为固定大小的单矩阵循环状态 St:
St=αtSt−1(I−ηtktkt⊤)+ηtvtkt⊤,ot=Stqt,其中 qt、kt 和 vt 是 token 的 query、key 和 value 向量,衰减 αt 和写入强度 ηt 由该 token 计算得到。由于该循环状态天然包含所有先前 token,简单 mask 无法隔离兄弟分支。为解决这一问题,Flide 在扁平化流上以两次独立调用执行每个 Gated DeltaNet 层。第一次调用处理所有请求的状态段,输出每个请求的循环状态和卷积窗口。第二次调用同时处理所有问题段,每个问题通过索引从自身请求的循环状态继续递推,避免任何状态复制。
为应对处理请求数量和长度高度可变的轮次时最小化 GPU 启动开销这一挑战,作者实现了 Flat-Graph Execution。虽然 CUDA graphs 可以消除顺序 kernel 启动,但通常会固定每次启动的形状。Flide 通过将轮次的树结构完全作为 GPU 常驻元数据保留,包括段长度、位置索引和 key 范围,来协调这一矛盾。系统在初始化时捕获一组按流容量索引的 flat graph。执行期间,Flide 选择能够容纳扁平化流及其元数据的最小 graph,使不同请求组合共享同一执行 graph,而无需改变启动配置。此外,选择性读出机制确保输出头只对每个问题的最后一个 token 计算最后一层操作,跳过不必要的工作。
最后,为处理 agent 状态在连续步骤中的增量增长,Flide 采用 Incremental State Forking。连续步骤通常共享大部分状态主干。Flide 利用这一重叠,在内部位置对请求状态进行 checkpoint。每个 checkpoint 存储每个 Gated DeltaNet 层的循环状态和卷积窗口,以及全 attention 层的 key 和 value。在前向 pass 中生成 checkpoint 时,Flide 将状态段分为两个层级。Gated DeltaNet 层按顺序处理这些层级,将第一层的最终状态保存为 checkpoint。这使得后续请求可以从 checkpoint 恢复,对所有问题仅计算新 token 和一小段未缓存尾部一次,从而最大化计算效率。
实验
在基于 RACE、QuALITY、MultiRC 和 Decision Index 构建的工作负载上,实验在 NVIDIA H200 硬件上将 Flide 与 vLLM、SGLang、多项评分及专用决策模型基线进行比较,测量延迟、吞吐量、答案保真度、准确性和稳定性。结果表明,即使对于单问题状态,Flide 也更快,并且在许多问题共享一个状态时获得显著收益,包括全 attention 模型,同时保持准确性并最接近 float32 参考答案。消融实验将这些收益归因于 state forks、CUDA graphs、flat graphs 和 selective readout;进一步分析确认了在专用决策模型上的优势,避免了基于分隔符共享造成的保真度损失,并随每个状态的问题数和状态长度增长而高效扩展。
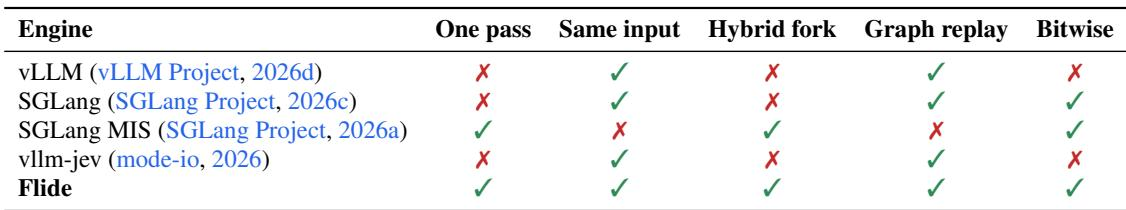
现有决策服务引擎被迫在单 pass 执行、同输入语义、混合分叉、graph replay 和位级可复现性之间做出权衡。Flide 是唯一已有记录同时满足全部五个属性的引擎,而 SGLang MIS 支持单 pass 混合分叉,但丢失同输入语义和 graph replay。其他引擎保留同输入语义和 graph replay,但无法分叉混合状态或在单 pass 中完成决策服务。Flide 是表中唯一具备全部五种能力的引擎:单 pass、同输入、混合分叉、graph replay 和位级输出。SGLang MIS 实现了单 pass 混合分叉和位级输出,但缺少同输入语义和 graph replay。vLLM、SGLang 和 vllm-jev 保留同输入语义和 graph replay,但不支持单 pass 或混合分叉。
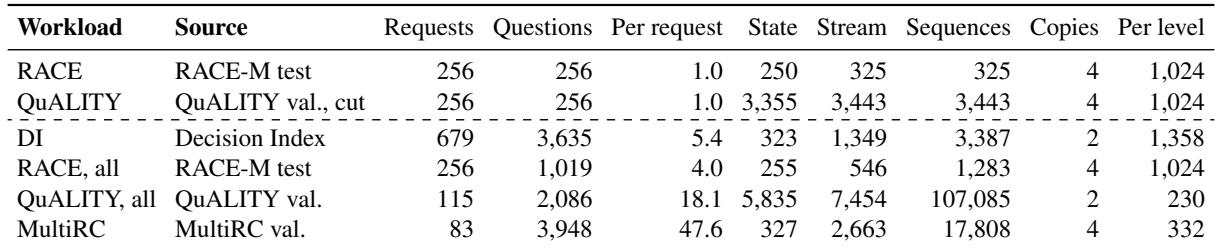
工作负载范围从短段落上的单问题请求到长文档上的多问题请求,其中某些设置每个状态包含数十个问题。在 stream prompt 中,状态包含一次,每个问题追加一次;而 one-sequence-per-question prompt 会为每个问题重复状态。因此,stream token 数量相对于 sequence token 数量保持较小,并且随着每个请求的问题数增加,差距扩大。每个请求的问题数从单个到数十个不等,其中 MultiRC 是问题密度最高的工作负载。在单问题工作负载中,stream 与 one-sequence-per-question 的 prompt 长度相同;但在多问题工作负载中,sequence prompt 长度会比 stream prompt 长度大数倍。
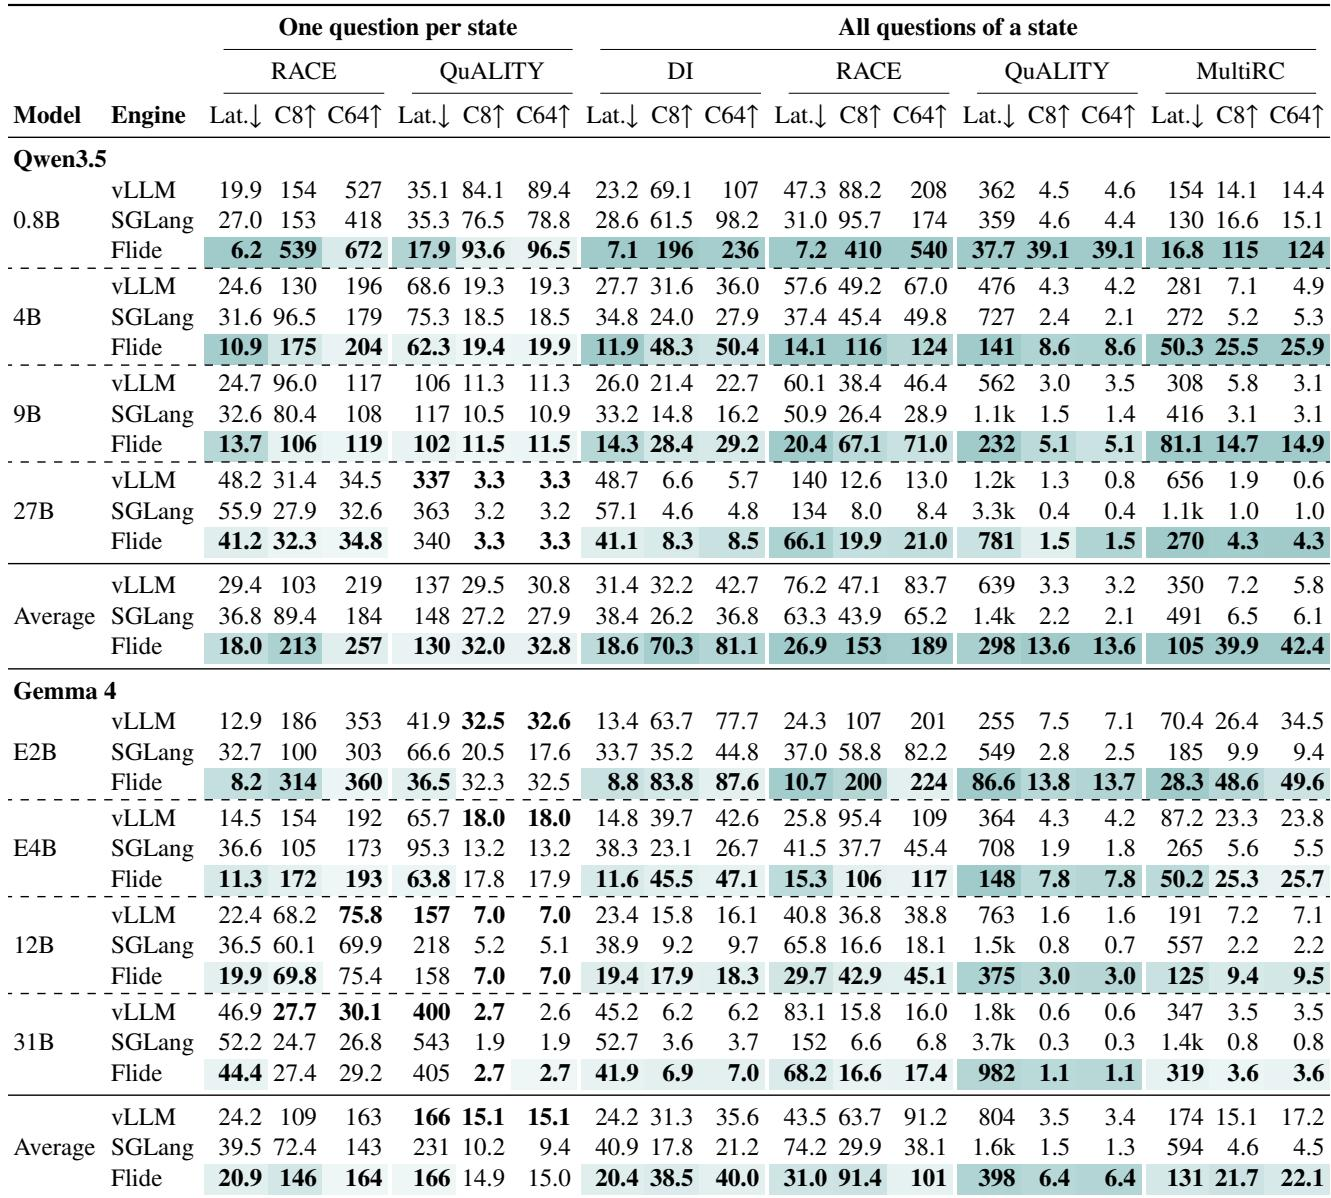
在评估的延迟和吞吐量设置下,Flide 优于 vLLM 和 SGLang,包括单问题状态和全 attention 模型。当许多问题共享一个状态时,其优势最大,尤其是在 QuALITY 和 MultiRC 等问题密集工作负载上,避免了重复计算或恢复共享上下文。即使状态只有一个问题,Flide 也能降低延迟,其中在最小的 Qwen3.5 模型上单个请求加速最大。对于每个状态多个问题,Flide 在所有评估模型规模和并发级别下均实现比最佳基线更低的延迟和更高的吞吐量,在 QuALITY 和 MultiRC 上收益最大。在全 attention Gemma 4 上,Flide 仍比 vLLM 的 prefix cache 更快,表明其优势不仅来自缓存,还来自在单个 forward pass 中处理整个请求。
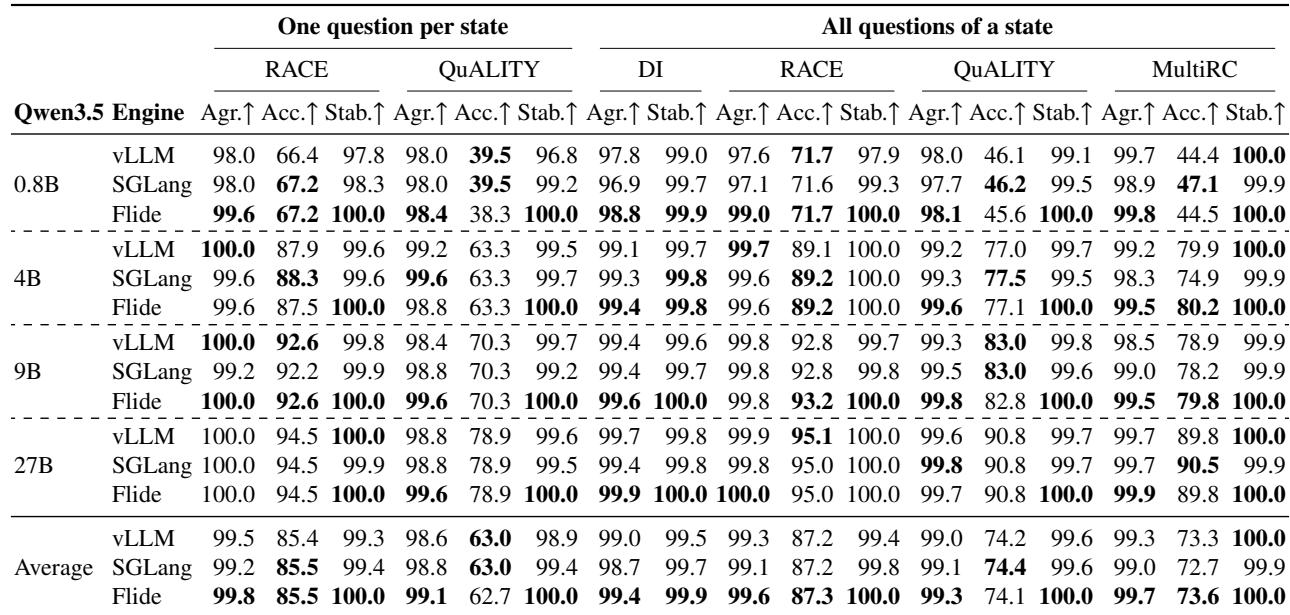
在各类 Qwen3.5 模型规模和工作负载上,Flide 的首选答案与 float32 参考一致的频率高于 vLLM 或 SGLang,并且其准确度在每个单元格中与 vLLM 的差距保持在 1.2 个百分点以内。Batching 会改变所有引擎的答案稳定性,但 Flide 变化最小,并且在其固定计算模式下在任何负载下都返回相同位。Flide 在所有评估工作负载上与 float32 参考的首选答案一致率最高。Flide 在保持速度优势的同时,其准确度在每个单元格中与 vLLM 的差距不超过 1.2 个百分点。Flide 的答案稳定性在 1 个和 64 个客户端之间变化至多 0.2 个百分点,而 SGLang 和 vLLM 的变化更大。
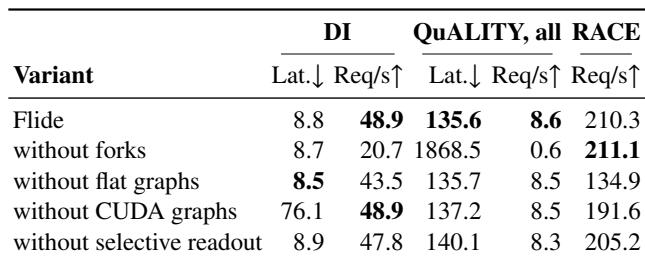
在 Qwen3.5-4B 上的消融实验分离了每个 Flide 组件的性能贡献。在多问题 QuALITY 工作负载上,移除 state forks 会导致最大延迟惩罚;移除 CUDA graphs 则会严重损害短输入延迟。禁用 flat graphs 使短 RACE 吞吐量降低三分之一以上,而 selective readout 在各工作负载上进一步增加吞吐量。没有 state forks 时,多问题 QuALITY 延迟增加超过一个数量级。没有 CUDA graphs 时,单个请求会启动数千个顺序 kernel,并导致严重的短输入延迟惩罚。没有 flat graphs 时,短 RACE 吞吐量下降超过三分之一,因为每个请求都需要一次不同的 replay。Selective readout 通过在所有工作负载上避免冗余 token 投影,带来额外的吞吐量提升。
评测首先确认 Flide 独有地结合了单 pass 执行、同输入语义、混合分叉、graph replay 和位级可复现性,而 SGLang MIS 和其他引擎各自缺少某些能力。在从单问题短段落到多问题长文档的工作负载中,stream prompt 的 token 数量远低于重复状态的 sequence prompt。Flide 在延迟和吞吐量上优于 vLLM 和 SGLang,尤其是在问题密集的多问题工作负载上,并且与 float32 参考的首选答案一致率更高,在 batching 下答案更稳定。在 Qwen3.5-4B 上的消融实验将最大的多问题收益归因于 state forks,将短输入延迟收益归因于 CUDA graphs,将吞吐量收益归因于 flat graphs,并将进一步吞吐量收益归因于 selective readout。