Command Palette
Search for a command to run...
L3G-WORLD:基于潜在 3D 高斯记忆的实时无限世界生成
L3G-WORLD:基于潜在 3D 高斯记忆的实时无限世界生成
Jinhyeok Choi JoungBin Lee Jongmin Lee Minkyeong Jeon Jiyoung Kim Kaeun Han Yoonjin Yoon Seungryong Kim
摘要
交互式世界模型根据用户动作生成视觉内容,但在实时条件下保持长时程探索的空间一致性仍然具有挑战性。现有方法依赖时间上下文或显式 3D 记忆,由于记忆随生成流的长度增长,二者的扩展性都较差。此外,显式 3D 记忆需要重新编码 RGB 渲染来为潜在视频生成器提供条件信号,这阻碍了实时生成。本文提出潜在 3D 高斯记忆(L3G),它将前馈重建的高效性与紧凑、可快速渲染的场景表示相结合。基于该记忆,我们提出 L3G-World,其中记忆更新器与视频扩散 Transformer(DiT)以自回归方式交替运行,生成空间一致的世界。记忆更新器在新观察到的区域生成高斯,并优化已有高斯,因此记忆随场景范围而非流长度增长。每个高斯还存储 VAE 潜在特征,使记忆能够直接渲染到 DiT 的潜在空间中,无需 VAE 重新编码。实验表明,L3G-World 在生成质量和长时程自洽性上达到当前最优结果;与各指标上最高效的先前 3D 记忆基线相比,其 3D 基元数量最多减少 38.6 倍,记忆重建速度提升 3.2 倍,VAE 特征渲染速度提升 359 倍,从而能够在 9 FPS 下实现实时世界生成。
一句话总结
KAIST AI、梨花女子大学和 KAIST Urban AI Institute 的研究人员提出 L3G-World,一种基于潜在 3D 高斯记忆(L3G)的实时无限世界生成器,其中记忆更新器和视频扩散 Transformer 以自回归方式交替运行,无需重新编码即可直接渲染 VAE 潜变量特征,实现领先的生成质量、长时程自一致性以及 9 FPS 生成速度。
核心贡献
- 论文提出一种潜在 3D 高斯记忆(L3G),将前馈重建与紧凑场景表示相结合,其中每个高斯存储一个 VAE 潜变量特征,因此记忆可以直接渲染到视频扩散 Transformer 的潜变量空间中,无需 VAE 重新编码。
- 在该记忆之上,L3G-World 以自回归方式交替运行记忆更新器和视频扩散 Transformer,更新器在新观测区域生成高斯并细化已有高斯,使记忆随场景范围扩展而增长,而非随流长度增长。
- 实验表明,L3G-World 实现领先的生成质量和长时程自一致性,与最高效的先前 3D 记忆基线相比,3D 基元最多减少 38.6 倍,记忆重建快 3.2 倍,VAE 特征渲染快 359 倍,从而实现 9 FPS 的实时世界生成。
引言
交互式视频世界模型根据用户动作生成视觉内容,在真实世界模拟、交互式游戏生成和具身模拟方面具有前景。核心挑战是在长时程探索和闭环过程中保持空间一致性,同时维持实时性能。先前的时序上下文方法让新帧关注更早的历史,但其记忆和注意力成本随流长度和分辨率增长;而显式 3D 记忆方法要么累积密集的逐像素基元,这些基元会变得冗余且渲染缓慢,要么依赖基于优化的重建,速度太慢,无法实时使用。作者提出 L3G-World,使用紧凑的潜在 3D 高斯记忆,只在未覆盖区域持续更新,并在已探索区域进行细化。该记忆存储 VAE 潜变量特征,并直接渲染到视频扩散 Transformer 的潜变量空间中,无需 VAE 重新编码即可高效条件化,支持实时、长时程世界生成。
方法
作者提出 L3G-World,一个用于实时交互式世界生成的框架,可在长时程内保持几何一致性。为了平衡存储先前生成内容与保持记忆紧凑以便快速读写之间的需求,系统采用 3D 高斯作为记忆表示。整体架构通过两个以自回归方式交替运行的模块实现:记忆更新器 L3G-Mem 读取并更新每个生成块对应的潜在 3D 高斯记忆;视频生成器 L3G-Gen 在记忆渲染到其潜变量空间中的条件下生成下一块。
如下图所示:
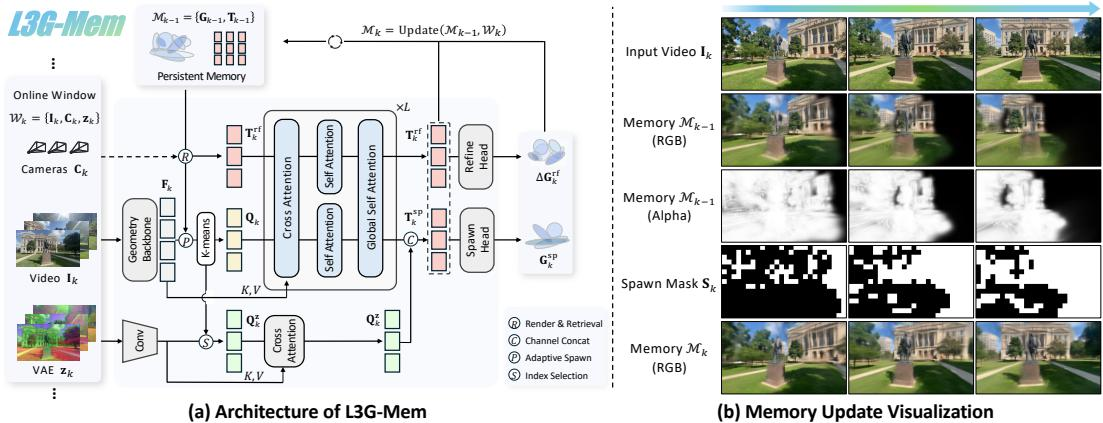
L3G-Mem 模块以大小 V 的窗口处理图像流及其对应的相机参数。在每个自回归步骤 k,模型使用当前输入窗口 Wk 更新潜在 3D 高斯记忆 Mk−1。更新过程表示为:
Mk=Update(Mk−1,Wk)为了保持记忆紧凑,作者设计了自适应高斯生成机制。通过从当前相机视角渲染现有记忆,系统识别低不透明度或高 RGB 误差的区域。这些表示不足的区域形成生成掩码。随后,模型使用几何基础模型对输入图像进行编码以获得几何特征,并对生成掩码内的特征应用 K 均值聚类,初始化一组紧凑的生成查询 token。这确保生成预算只分配给记忆中缺失的内容。
同时,高斯细化流更新当前窗口中可见的现有高斯。与可见高斯关联的记忆 token 被检索为细化 token。生成 token 和细化 token 被拼接在一起,并由 Transformer 联合处理。在每个块中,两条流与几何特征进行交叉注意力,随后进行流内自注意力和全局自注意力层,使新观测到的场景内容与先前重建的场景内容之间进行信息交换。此外,专门的潜变量提升分支从 VAE 特征初始化潜变量查询并与其进行交叉注意力,产生与查询 token 空间对齐的 VAE 潜变量 token。处理后的 token 随后被解码为新的高斯基元和针对被检索高斯的残差更新。记忆通过追加新生成的高斯并对被检索的高斯应用预测残差来更新。作者在连续窗口上自回归训练 L3G-Mem,使用 RGB、LPIPS、深度、VAE 潜变量 MSE 和可见性损失的组合监督渲染结果。
L3G-Gen 模块是一个以记忆为条件的自回归视频扩散模型,专为长时程世界生成设计。每一步,存储在记忆中的 VAE 潜变量在目标相机下渲染,以获得空间对齐的 VAE 潜变量和 alpha 掩码。它们与目标视频潜变量沿通道维度拼接,以提供几何条件。先前生成的参考潜变量也与零填充通道拼接,以匹配维度。输入序列由逐 token 拼接形成,并在每个 DiT 层的自注意力中加入相机射线旋转位置嵌入的残差。为处理时序一致性,参考潜变量被赋予一个位于当前生成块之前的时序偏移旋转位置嵌入。
以记忆为条件的教师模型使用整流流进行训练。损失仅应用于目标视频潜变量,条件是渲染的记忆潜变量、不透明度图、检索到的参考潜变量、目标相机和文本提示。为降低实时交互的采样成本,作者将教师模型蒸馏为几步自回归学生模型。学生模型以源噪声水平和目标噪声水平为条件,学习去噪轨迹上任意点之间的流映射转移。通过联合优化流映射目标和在线策略分布匹配,学生模型通过自身的自回归展开生成样本,这些样本被重新加噪并与冻结的教师模型比较,有效减少几步自回归生成中的训练-测试不匹配。
最后,L3G-World 框架将这两个模块结合在一个自回归循环中。给定输入图像,L3G-Mem 初始化持久的高斯记忆。在每个生成步骤,存储在记忆中的 VAE 特征从目标相机渲染,为 L3G-Gen 提供空间对齐的潜变量条件。生成的潜变量直接传递到 L3G-Mem 以进行 VAE 特征提升,同时对应 RGB 帧通过 VAE 解码器获得。通过反复从同一持久 3D 记忆读取并写回,系统不断扩展并修正生成的世界,同时避免两个模块之间的冗余潜变量编码。
实验
实验在 DL3DV 和 RealEstate10K 上使用长闭环轨迹评估 L3G-World,在自一致性、生成质量、相机控制、几何一致性和记忆效率方面与显式和隐式记忆基线进行比较。结果表明,采用选择性生成和细化的紧凑高斯记忆使用更少的记忆并加速渲染,同时实现强长时程自一致性和生成质量。定性比较表明,持久的、空间锚定的记忆避免了时序上下文和其他 3D 方法中出现的漂移、模糊和伪影;消融实验证实了自适应生成、残差细化、全局自注意力、RGB 监督和直接 VAE 潜变量渲染的重要性。
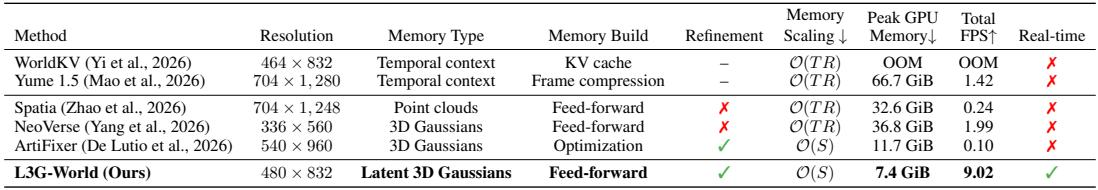
时序上下文和密集前馈场景表示随生成帧数和分辨率扩展,导致高记忆使用或内存不足故障。基于优化的细化随空间覆盖范围扩展,但大幅降低吞吐量。所提出的方法将前馈构建与细化结合,随空间覆盖范围扩展,同时获得最低 GPU 记忆占用和显著更高的吞吐量。时序上下文和密集逐像素 3D 方法显示出记忆随帧数和分辨率扩展,其中一种方法出现内存不足错误。具有空间扩展但没有前馈构建的场景表示仍远未达到实时吞吐量。所提出方法在所有比较方法中实现最低峰值 GPU 记忆和最高总 FPS,使实时生成成为可能。
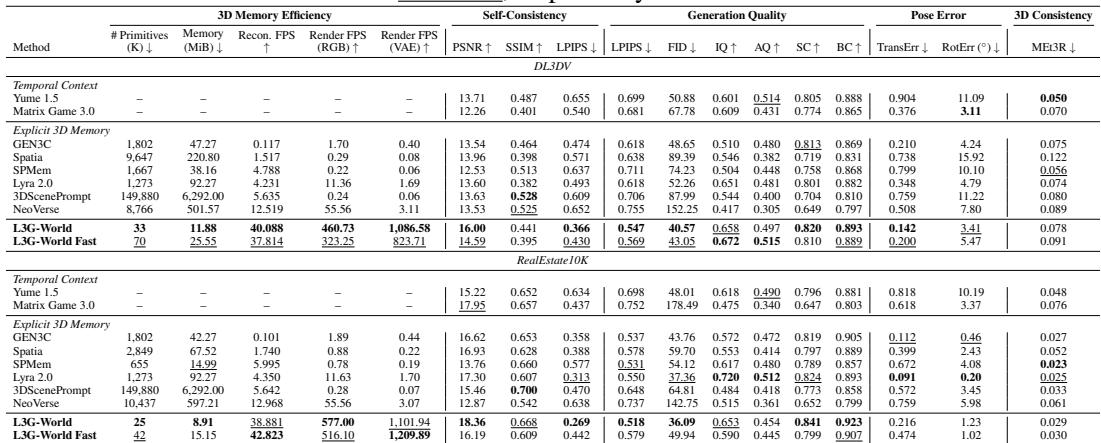
L3G-World 和 L3G-World Fast 将强生成质量和长时程自一致性与远低于显式 3D 基线的记忆和基元数量相结合。在 DL3DV 和 RealEstate10K 上,L3G-World 变体在感知和自一致性指标上位居前列,同时实现更快的记忆重建以及 RGB 或 VAE 渲染。这些效率优势不以生成质量为代价,因为 L3G-World 在两个数据集上的多项生成指标和 3D 一致性指标处于领先地位。与基于高斯和点云的记忆基线相比,L3G-World 使用少得多的基元和更少的记忆,同时显著加快 RGB 和 VAE 特征的渲染。L3G-World 变体在两个数据集上实现最佳或第二佳的自一致性和感知质量,并且 L3G-World 在多项生成指标和 3D 一致性指标上领先。
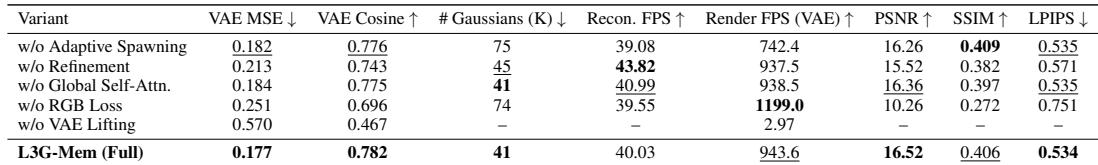
消融实验在 DL3DV 新视角合成上评估 L3G-Mem 组件。完整模型在保持高斯数量和重建吞吐量具有竞争力的同时,实现最佳 VAE MSE、VAE 余弦相似度和 RGB PSNR。移除自适应生成、细化、全局自注意力、RGB 监督或 VAE 提升会降低质量或效率,其中 VAE 提升和 RGB 监督导致尤其大的下降。完整模型用紧凑高斯记忆和相当的重建吞吐量在大多数 RGB 和 VAE 指标上获得最强重建质量。没有自适应生成时,模型使用约 1.8 倍的高斯,却仍降低 RGB 和 VAE 新视角合成质量,表明选择性生成减少了冗余基元。移除细化流会降低重建质量,进一步移除生成流与细化流之间的全局自注意力会降低性能。用 VAE 编码 RGB 渲染而不是提升 VAE 特征,会显著减慢 VAE 渲染并降低渲染潜变量质量。移除 RGB 监督会降低 PSNR 和 SSIM、增加 LPIPS,并恶化 VAE 潜变量指标。
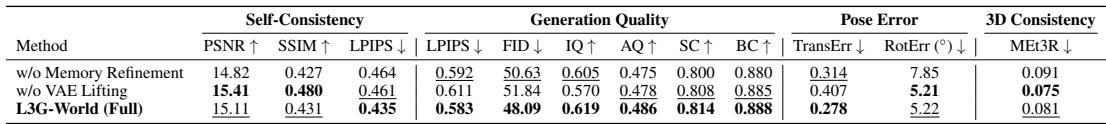
消融实验将完整 L3G-World 与不带记忆细化以及不带直接 VAE 潜变量提升的变体进行比较。禁用记忆细化会一致降低自一致性、生成质量、姿态准确性和 3D 一致性,表明对持久场景记忆的渐进修正是重要的。用 RGB 到 VAE 编码替代直接潜变量渲染改善了一些保真度和 3D 一致性指标,但降低生成质量和平移准确性,因此完整模型提供了良好的平衡。移除记忆细化会降低所有报告的指标,在自一致性、姿态准确性和 3D 一致性上出现明显损失。用 RGB 渲染后进行 VAE 编码替代直接 VAE 潜变量渲染,改善 PSNR、SSIM 和 3D 一致性,但降低生成质量和平移准确性。直接 VAE 潜变量渲染移除编码开销,提高生成质量分数,同时保持低平移误差。
实验在 DL3DV 和 RealEstate10K 上评估一种混合前馈和细化的场景表示,并将其与时序上下文、密集逐像素 3D、高斯和点云基线进行比较。效率研究表明,该方法随空间覆盖范围而非帧数或分辨率扩展,实现最低峰值 GPU 记忆和最高吞吐量,同时保持实时生成;基准结果表明,该方法在感知质量和自一致性方面位居前列,且使用的基元少得多。消融实验验证了自适应生成、细化、全局自注意力、RGB 监督和直接 VAE 潜变量提升改善重建质量或效率,而记忆细化和直接潜变量渲染对自一致性、姿态准确性和生成质量很重要。