Command Palette
Search for a command to run...
从结构化教材扩展数学证明监督
从结构化教材扩展数学证明监督
Youqing Fang Zhouqi Hua Yinhao Tang Yuzhe Gu Lingkai Kong Bin Liu Weiming Zhang Kai Chen Yanan Sun Wenwei Zhang
摘要
语言模型的数学监督通常被扁平化为孤立的“问题–解答”对,丢弃了原始来源的课程组织与证据结构。我们提出了 TOME-Math(面向教材的数学证据),一个大规模语料库,将涵盖大学数学核心领域的 2,118 本教材转换为约 380K 条结构化证明监督记录,同时保留章节顺序、命题–证明链接、依赖引用和来源出处。利用这些结构信号,我们探索了跨多个数学学科的课程学习,并刻画了监督数据量和来源广度方面的扩展规律。在完整规模下,在 TOME-Math 上进行微调,使我们在留出评估和既有公开基准上的未加权平均分比基础模型提高了 16.7 个百分点,同时在总体上超过了全部三个公开指令数据基线。我们的发现表明,结构化教材既是可扩展的数学监督来源,也是研究数据组织对数学推理影响的经验框架。我们将发布该语料库,以促进对结构化数学监督的进一步研究。
一句话总结
来自中国科学技术大学、复旦大学、上海人工智能实验室和上海交通大学的研究人员提出了 TOME-Math(Textbook-Oriented Mathematical Evidence,面向教材的数学证据),一个约 38 万条结构化证明监督记录的数据集,来源于 2,118 本大学数学教材,保留了章节顺序、命题-证明关联、依赖引用和来源出处;在 TOME-Math 上进行课程学习微调后,留出测试与公开基准得分比基础模型提高了 16.7 个百分点,并超过了三个公开指令数据基线。
核心贡献
- TOME-Math 被提出为一个大规模证明监督语料库,由 2,118 本大学数学教材构建,生成了 380,292 条 Concept 与 Gap QA 记录,同时保留章节推进、命题-证明关联、依赖引用和来源出处。
- 在教材留出习题和现有公开基准上,使用 TOME-Math 进行全语料微调将六个基准的未加权平均分从基础模型的 29.17% 提高到 45.83%,在六项评估中的五项上取得最佳,并在总体上超过三个公开指令数据基线。
- 受控实验显示,教材结构能够改善数学推理:在匹配的上下文预算下,结构引导的检索将证明生成 pass@1 从 13.25% 提高到 17.38%;在六个学科和三种数据规模上,正向教材课程优于打乱和逆序安排;在固定训练 token 预算下,更广泛的来源覆盖带来进一步收益。
引言
大语言模型中的数学推理通过更大规模的监督问答数据和额外的推理时计算取得了进展,但先前工作表明,数据组织、题目多样性、解答格式和教师模型质量比单纯的样本数量更重要。然而,主流范式仍将数学监督视为孤立的题目-解答对,尽管教材已经包含定义、定理、证明、习题、章节顺序和依赖关系等结构化知识。仅把教材当作内容来源,其原生结构未被充分利用。作者提出了 TOME-Math,一个由 2,118 本数学教材构建的证明监督语料库,在 29 个学科的 380,292 个证明导向问答对中保留了层级结构、依赖结构和课程结构。使用 TOME-Math 进行监督微调后,一个 30B 模型在六个基准上的平均分从 29.17% 提高到 45.83%;受控实验进一步表明,结构引导检索、与教材一致的课程安排以及更广泛的来源覆盖都能带来一致的收益。
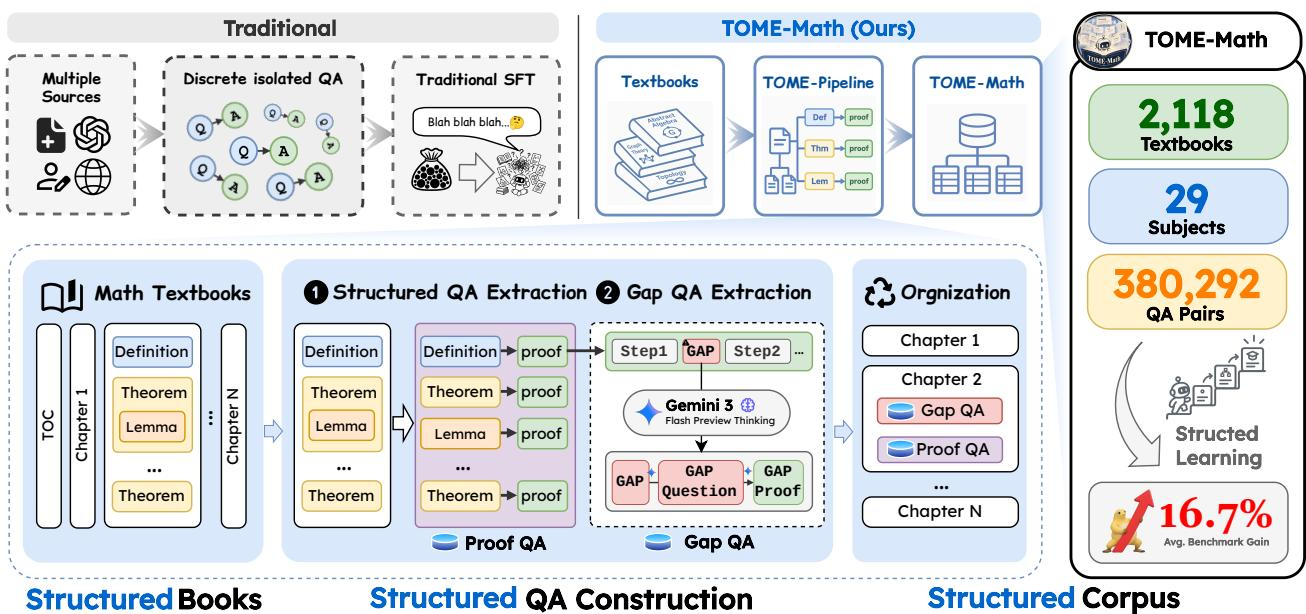
数据集

数据集概览
- TOME-Math 包含 380,292 个问答对,由 2,118 本经规范化教材构建,覆盖 29 个学科类别。
- 语料库包含两个流:205,861 个 Proof QA 对和 174,431 个 Gap QA 对。
来源
- 原始教材 PDF 依据大学课程大纲进行筛选,并由领域专家审阅。
- 经过规范化和去重后,来源集合包含 2,118 本教材。
- 学科与语言覆盖、任务构成、结构复杂度、质量和来源详情见附录 B。
处理流程
- OCR 与结构提取: DeepSeek-OCR 将每个 PDF 转换为带页面图像的多模态 Markdown。逐页 gpt-oss-120b 处理将目录和正文与封面、前言及其他前置内容分离,然后重建层级目录。
- 章节切分: 状态机按顺序读取正文,并将页面分配到当前章节、下一章节或内部边界;对不确定的分配会重试。由此生成有序的章节级文档,同时保留教材层级。
- 核心概念与习题分离: 第二次逐页处理将说明性核心概念与教材习题分离。习题作为独立储备保留,但不用于 Proof QA 生成。
- Proof QA 提取: 对每个核心概念章节,gemini-3.1-flash-lite-preview 提取定理-证明、引理-证明和定义-证明单元,并检索解释每个证明所需的先前命题。这些基于来源的单元构成 Proof QA 流。
- Gap QA 构建: 启用思考的 gemini-3-flash-preview 检查证明中的隐含或缺失推理步骤。当检测到实质缺口时,gemini-3.1-flashlite-preview 将缺失义务改写为自包含命题并完成其证明,生成 Gap QA 流。
过滤与质量控制
- 结构检查验证目录层级、不确定页面边界、跨页题目连续性、题目与答案对齐以及独立完整性。
- 受来源约束的 gpt-oss-120b 判定器对命题候选从五个维度进行审核:完整性、准确性、LaTeX 格式、自包含性和原子性。
- 准确性被视为关键。虚构的证明步骤、被修改的数学关系或其他无来源支持的内容均属于失败情况,而非风格缺陷。
- Gap QA 流从 918,235 个生成候选中保留了 174,431 个,保留率为 19.00%。
模式与来源
- 每条记录包含教材、章节和来源位置元数据。
- Proof QA 记录还包括命题标识符和已解析引用。
- 评估单元在教材层面定义。
- 留出习题用于题目级泛化评估,留出教材用于来源级泛化评估。
- 重复组通过全局内容哈希识别,并在评估划分中予以遵守。
论文中的使用
- 数据集提供两种互补的证明监督形式:显式命题-证明对,以及针对来源中未显式表述的中间推理的定向缺口填补监督。
- 所提供摘录定义了评估范围,但未指定明确的训练混合比例。
方法
作者通过一条保持结构的处理流程构建 TOME-Math,将原始教材 PDF 转换为两种互补的证明监督流:源自显式命题-证明单元的 Proof QA 对,以及源自有缺失或隐含证明义务的 Gap QA 对。来源收集以大学课程大纲为依据,并由领域专家审阅,得到 2,118 本经规范化和去重的输入 PDF。完整流程共生成 380,292 个问答对,包括 205,861 个 Proof QA 对和 174,431 个 Gap QA 对。
在文档解析中,DeepSeek-OCR 将每个 PDF 转换为带页面图像的多模态 Markdown。逐页 gpt-oss-120b 处理分离前置内容、目录和正文,然后重建层级目录。在该层级条件下,状态机按顺序读取正文,并判断每一页属于当前章节、下一章节还是内部边界。在更新章节状态之前,对不确定分配会进行重试。由此生成有序的章节级文档,同时保留教材层级。第二次逐页处理将说明性核心概念与习题分离。习题作为独立储备保留,但不进入 Proof QA 生成路径。
对于每个核心概念章节,作者使用 gemini-3.1-flash-lite-preview 提取定理-证明、引理-证明和定义-证明单元,并检索解释每个证明所需的先前命题。这些基于来源的单元构成 Proof QA 流。随后,启用思考的 gemini-3-flash-preview 检查每个证明中的缺口,即隐含或缺失的推理步骤。当检测到实质缺口时,gemini-3.1-flash-lite-preview 将缺失义务改写为自包含命题并完成其证明,生成 Gap QA 流。这一设计既保留了教材中的显式证明,又为来源未明确表述的中间推理提供了定向监督。
质量控制同时在结构和语义两个层面进行。结构检查验证目录层级、不确定页面边界、跨页题目连续性、题目与答案对齐以及独立完整性。对于命题提取,受来源约束的 gpt-oss-120b 判定器从五个维度审核候选:完整性、准确性、LaTeX 格式、自包含性和原子性。准确性被视为关键,因此虚构的证明步骤、被修改的数学关系或其他无来源支持的内容均被视为失败情况。
除数据集构建外,保留的教材结构还提供显式信号,如章节推进、命题依赖和来源出处。这些信号支持无需训练的、结构引导的检索,而无需更新模型参数。在该设置中,结构化策略利用章节位置和恢复的依赖关系检索命题-证明记录,增强策略还包含 Gap QA。所有添加上下文的条件共享相同的上下文 token 预算、骨干模型、提示、解码配置和参考引导验证器。目标习题及所有与其参考答案重叠的材料都会从每个检索池中移除,从而隔离证据选择的影响,而不是额外测试时 token 的影响。
实验
所有实验均使用 Qwen3-30B-A3B-Base,并在来自留出教材的证明密集型问题以及客观和公开数学基准上进行评估。全语料比较显示,TOME-Math 比更大的公开 SFT 语料库表现更好,这表明监督来源与结构比单纯样本数量更重要。受控研究发现,带有命题和 Gap QA 上下文的结构引导检索能够改善证明求解,而正向章节顺序加 Gap 优先调度在不同学科和数据规模上是最强课程安排。在固定 token 预算下更广泛的来源覆盖以及较强的跨学科迁移进一步支持结构化监督,完整配方的消融实验确认 Gap QA 和顺序是互补的贡献因素,尤其对证明基准而言。
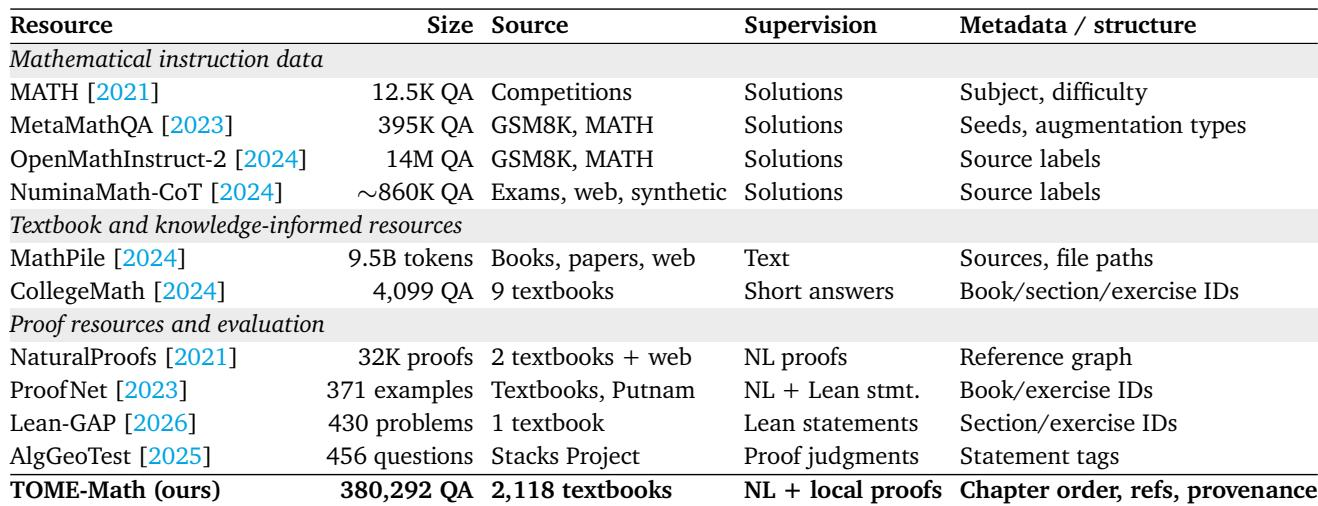
数学指令资源以问题-解答监督为中心,规模从小型人工编写集合到大型合成语料库不等;教材导向资源则提供来自教材、论文和网络的文本。TOME-Math 与这些资源不同,它保留教材层级和命题引用,将文本转化为结构化证明监督。更广泛的来源覆盖和显式的局部证明义务与更强的证明泛化相关,而这种泛化超出规模本身。现有数学指令数据集以解答作为共同的监督单元,通过合成扩充将人工编写的种子扩展到数百万个问答对。诸如 MathPile 等教材衍生资源提供来自教材、论文和网络的大规模文本监督,而 TOME-Math 进一步增加了层级和命题级结构。将相同监督预算分配到更多教材可提高平均性能,尤其在拓扑学和微分几何中;显式证明义务带来最大的证明基准收益。
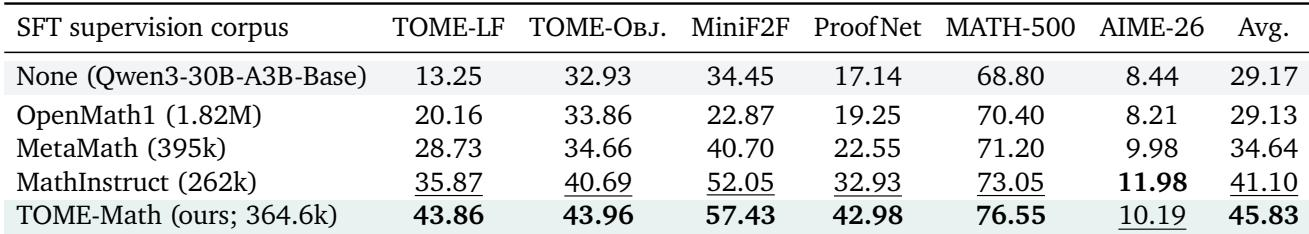
在 TOME-Math 上微调的模型在六项评估中取得最高的未加权平均分,并在六个基准中的五个上取得最佳成绩,在 AIME 2026 上排名第二。相比最强公开基线的提升具有广泛性,最大差距出现在面向证明的长文本和证明网络评估上。TOME-Math 在每个基准上也优于规模大得多的 OpenMath1 语料库,表明监督来源和形式比单纯样本数量更重要。TOME-Math 在六个基准中的五个上排名第一,在 AIME 2026 上排名第二。尽管 OpenMath1 的样本数量约为其 4.8 倍,TOME-Math 在所有六个基准上都优于 OpenMath1。
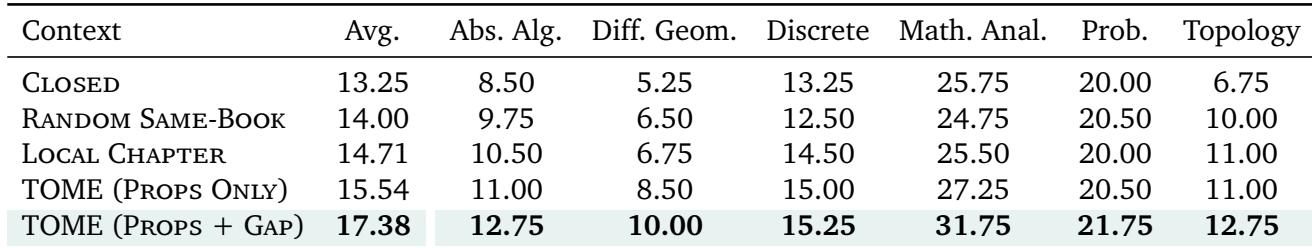
结构引导的 TOME 检索相较封闭检索、随机同书检索和局部章节检索基线提高了平均 pass@1。最佳设置组合了命题和缺口信号,取得最高总体平均分,并在多个学科中取得最强结果。收益因领域而异,拓扑学、微分几何和数学分析中的提升较大,概率论和离散数学中的变化较小。使用命题和缺口信息的 TOME 检索在比较的检索上下文中取得最高平均 pass@1。仅含命题的 TOME 平均已超过非 TOME 基线,加入缺口信息后性能进一步提升。学科层面的收益不均匀,拓扑学和微分几何的提升尤其大,而概率论仅有适度改善。
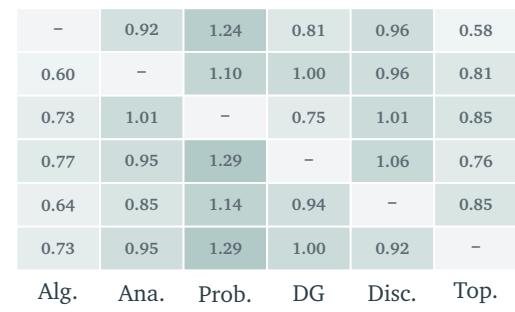
跨学科迁移矩阵显示,特定学科的检查点在数学各领域之间具有泛化能力,平均目标归一化系数为 0.92。拓扑学和微分几何是最强的来源,在若干情况下达到或超过领域内目标性能,尤其迁移到概率论时表现突出。匹配预算的广度结果进一步表明,将相同监督预算分配到更多教材可提高性能。特定学科检查点跨领域迁移的平均归一化得分为 0.92。拓扑学和微分几何具有最强的来源侧迁移均值,若干搭配超过了目标专业模型的性能。将相同监督预算分配到更多教材带来收益,尤其在拓扑学、微分几何和离散数学中。
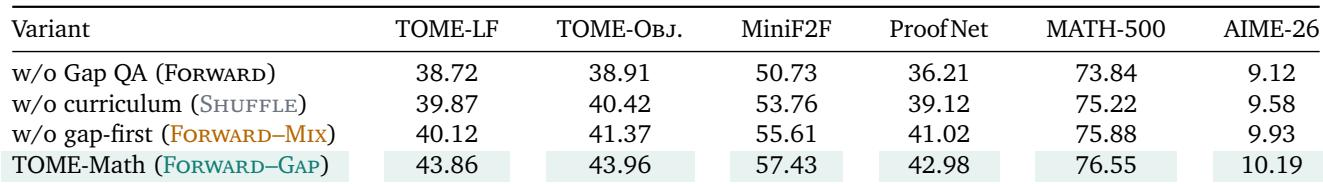
完整的 TOME-Math 配方在全部六个基准上取得最高 pass@1,而每项消融都会全面降低性能。Gap 优先调度是 TOME 基准上的主要顺序信号,而移除 Gap QA 会导致证明基准上的最大下降。完整配方在 MATH-500 和 AIME-26 上也处于领先,表明这些结构化组件带来的收益超出了以证明为重点的评估。完整配方在所有报告的基准上都优于每项消融。移除 Gap QA 在证明基准上产生最大下降,对 MATH-500 和 AIME-26 的影响较小。在 TOME 基准上,Gap 优先调度比正向章节推进贡献更大;全局打乱只带来少量额外损失。
实验将 TOME-Math 与标准数学指令语料库和教材语料库进行对比,并对检索、训练广度和顺序信号进行了消融。在 TOME-Math 上微调的模型在证明导向和通用数学基准上取得广泛收益,优于规模大得多的 OpenMath1 语料库,表明结构化证明监督比单纯样本数量更重要。使用命题和缺口信息的结构引导检索提高了 pass@1,在拓扑学和微分几何中收益尤其大,同时特定学科检查点能够跨领域良好迁移。消融实验确认,Gap 优先调度和缺口问答监督是配方的核心,因为移除它们会导致最大的性能下降。