Command Palette
Search for a command to run...
HiFOR:面向视觉-语言-动作模型的分层前瞻与动作引导世界对齐
HiFOR:面向视觉-语言-动作模型的分层前瞻与动作引导世界对齐
Rongxing Ding Hongyu Qu Kehong Wu Xudong Wang Fan Zhang Xinguang Xiang Xiangbo Shu
摘要
视觉-语言-动作(VLA)模型通过整合视觉感知、语言理解与动作生成,在机器人操作中展现出良好的能力。近期进展进一步引入未来预测,以增强对环境动态和任务进展的理解。然而,现有方法通常将短期动态与长期任务目标分别建模,并且在未充分考虑所预测未来与当前动作需求相关性的情况下,直接将其纳入动作策略。为解决上述局限,我们提出了 HiFOR,一个具有动作引导世界检索的分层前瞻框架。具体而言,分层前瞻预测(Hierarchical Foresight Prediction)通过分层依赖掩码(Hierarchical Dependency Mask,HDM)联合预测短期状态演化、语义里程碑和最终目标状态,建立跨时间尺度的依赖关系。在这些预测的基础上,结构感知潜在世界建模(Structure-Aware Latent World Modeling)沿时间范围、视角和空间维度组织未来潜在表示,以促进细粒度检索。此外,动作引导因子化世界检索(Action-Guided Factorized World Retrieval)在去噪过程中根据不断演化的动作表示,从结构化潜在世界中自适应地检索相关未来信息,为动作生成提供针对性指导。在两个仿真基准和六项真实世界机器人操作任务上的大量实验证明了所提方法的有效性。
一句话总结
来自南京理工大学、新加坡国立大学、中国科学院沈阳自动化研究所以及香港中文大学的研究人员提出了 HiFOR,一种分层前瞻框架,通过分层依赖掩码联合预测短期状态演化、语义里程碑和最终目标状态,并将结构感知的潜在世界建模与动作引导的因子化世界检索相结合,为动作生成提供有针对性的指导,并在两个仿真基准和六个真实世界机器人操作任务上得到验证。
核心贡献
- 本文介绍了 HiFOR,一种分层前瞻框架,通过分层依赖掩码联合预测短期状态演化、语义里程碑和最终目标状态,将局部世界动态与长期任务目标联系起来。
- 本文提出了结构感知的潜在世界建模机制和动作引导的因子化世界检索机制,前者沿时间范围、视角和空间维度组织预测的未来,后者在去噪过程中基于不断演化的动作表示检索与动作相关的未来信息。
- 在 LIBERO、RoboTwin 2.0 以及六个真实世界机器人操作任务上的实验证明了 HiFOR 的有效性,消融研究验证了其关键组件的贡献。
引言
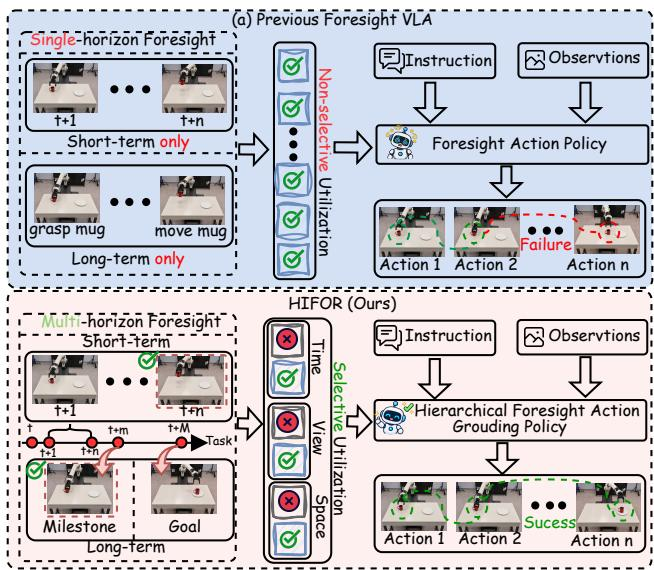
视觉-语言-动作(VLA)模型通过统一视觉感知、语言理解和动作生成,已成为机器人操作的核心,但复杂任务越来越需要能够预测未来环境变化和任务进展的策略。先前基于前瞻的方法通常孤立地建模短期动态或长期目标,并且通常将预测的未来状态、潜在表示、图像或视频注入动作策略,而没有有选择地加权它们与当前动作的相关性。这限制了连贯的时间推理,也未能考虑未来信息的重要性如何随预测时间范围、相机视角和空间区域而变化。作者提出了 HiFOR,一种分层前瞻框架,联合预测短期状态演化、语义里程碑和最终目标,将这些预测组织为结构化潜在世界,并在动作去噪过程中应用动作引导的因子化检索,以自适应地选择与决策最相关的未来信息。
数据集
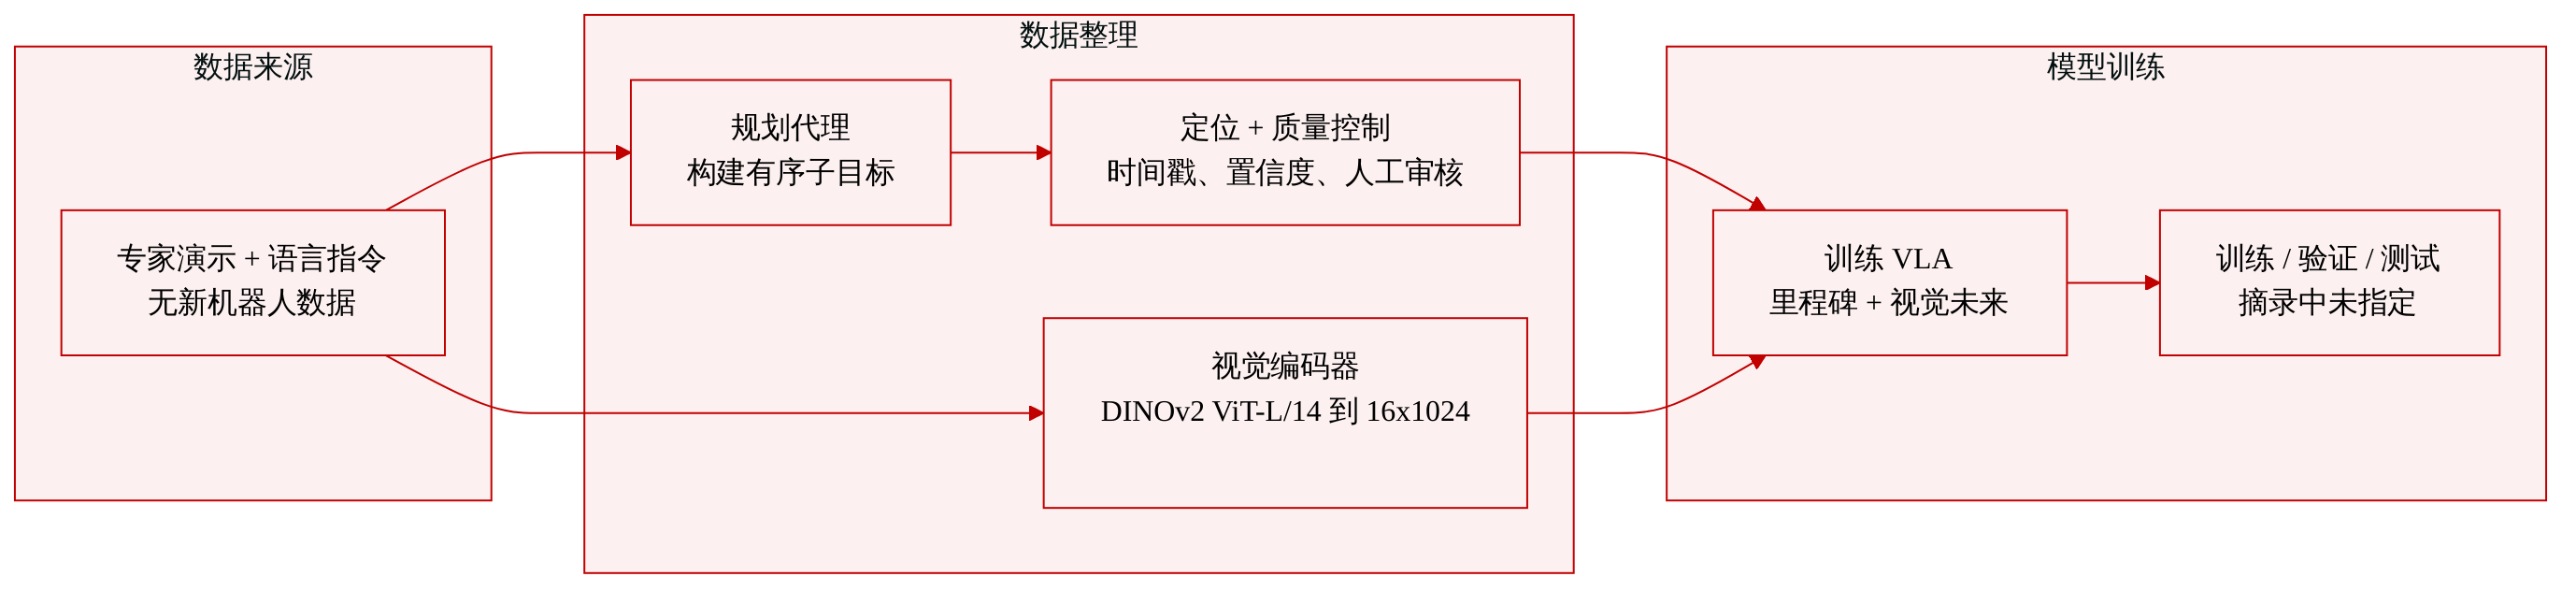
作者从已有的成功专家演示中构建分层规划数据集,而不收集额外的机器人轨迹。其目标是用具有语义意义的里程碑监督取代均匀的未来帧采样,用于视觉-语言-动作训练。
- 来源与组成:已有的成功专家演示轨迹;不进行新的机器人数据收集。
- 标注模式:对于每条语言指令,Planning Agent 生成有序的子目标序列 G1,G2,...,GK。每个子目标指定语义阶段、事件类型和完成验证标准。
- 时间戳定位:该方法在专家演示中自动找到每个子目标的完成时间戳。候选事件边界根据夹爪状态转换、机器人运动阶段和状态信息识别。
- 事件处理:稳定状态事件(例如抓取和放置)使用目标条件持续满足的最早帧。动态事件利用运动或状态转换边界进行定位。
- 质量控制:强制执行时间一致性 t1<t2<...<tK。为里程碑分配置信度分数,模糊或低置信度的情况被标记为需要人工审核。标注存储为 M={(Gk,tk)}k=1K。
- 视觉监督:多视角帧通过冻结的 DINOv2 ViT-L/14 模型编码。移除前缀 tokens,将 patch 特征自适应池化为 4x4 空间网格,得到 Ftv=ϕDINO(Itv)∈R16×1024。
- 在模型中的使用:里程碑标注和 DINOv2 视觉特征在 VLA 训练期间为分层前瞻预测提供结构化未来监督。
- 报告的规模与划分:所提供的节选未说明数据集大小、训练划分比例或混合权重。
方法
作者将基于视觉-语言-动作(VLA)模型的机器人操作形式化为语言条件下的序贯决策问题。在每个时间步 t,策略接收多视角视觉观测 Ot={Itv}v=1V、语言指令 L 和机器人状态 st,并预测未来动作块:
At={at+h}h=0H−1=πθ(Ot,L,st)其中每个动作由相对末端执行器平移、旋转和夹爪控制组成。
所提方法 HiFOR 的整体框架如下图所示。
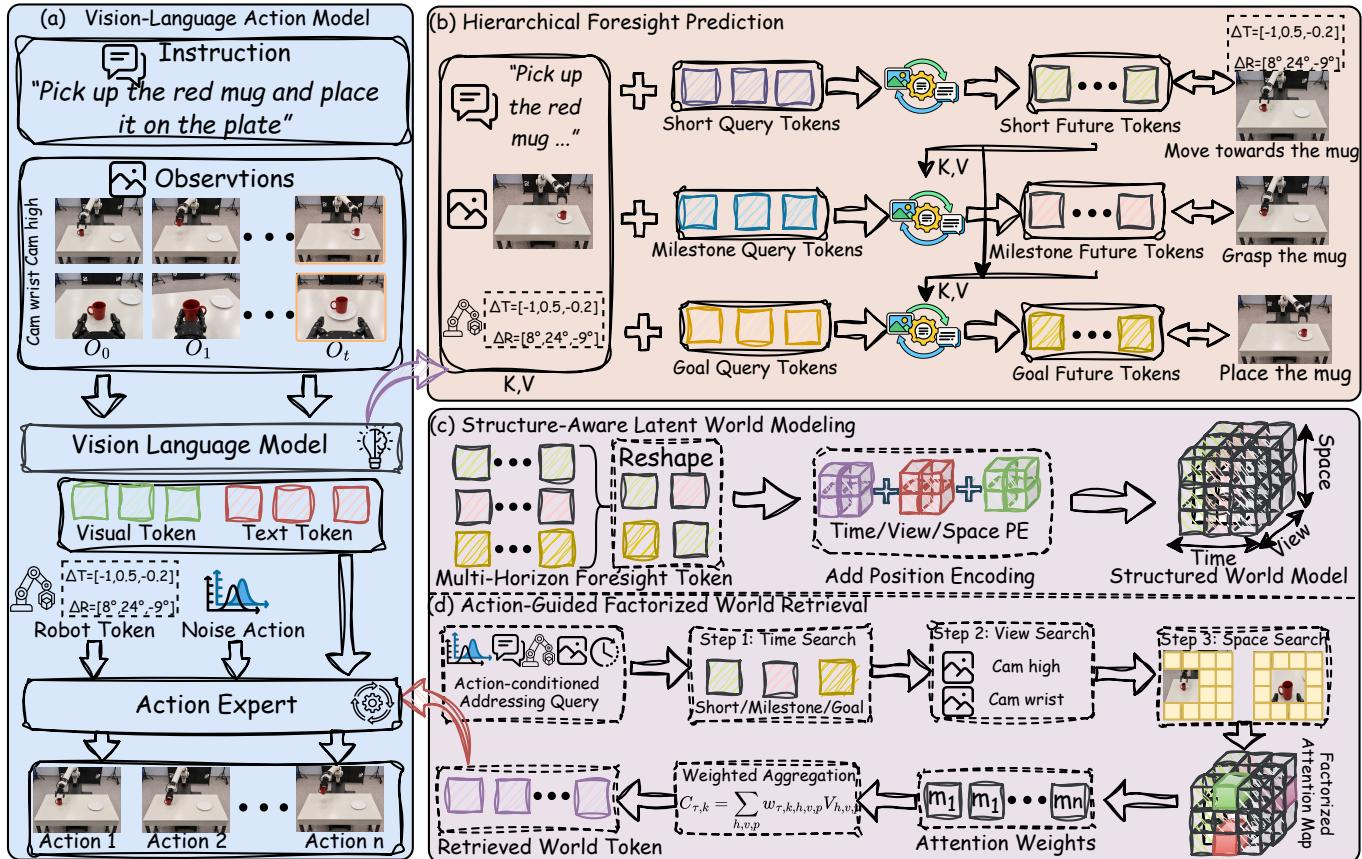
给定多模态输入,VLA 骨干网络对当前上下文进行编码以生成动作表示。然后作者引入了分层前瞻预测,联合预测短期状态演化、中间语义里程碑和最终目标状态。在这些预测的基础上,结构感知的潜在世界建模沿时间范围、视角和空间维度组织未来潜在表示。最后,动作引导的因子化世界检索有选择地检索与动作相关的未来信息,以指导动作专家。
为了在不收集额外轨迹的情况下为 VLA 训练提供结构化未来监督,作者从已有的专家演示中构建分层规划数据集。
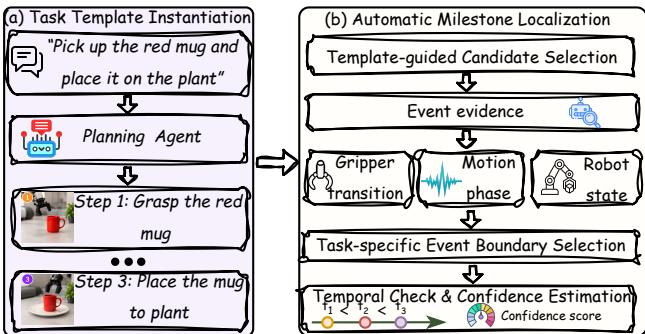
如上图所示,Planning Agent 首先从语言指令 L 生成任务特定的语义模板,将其分解为有序子目标序列 G={G1,G2,…,GK}。每个子目标指定语义阶段、事件类型和完成标准。给定该模板,系统通过使用夹爪状态转换、机器人运动阶段和状态信息识别候选事件边界,在专家演示中自动定位每个子目标的完成时间戳。强制执行时间一致性,并分配置信度分数。对于未来视觉监督,使用冻结的 DINOv2 ViT-L/14 编码器从所有轨迹帧中提取多视角语义特征。移除前缀 tokens 后,patch 特征被自适应池化为 4×4 空间网格:
Ftv=ϕDINO(Itv)∈R16×1024分层前瞻预测模块为每个时间步 t<tK 定义三个互补的预测时间范围:短期目标 tts=min(t+Δ,tK)、里程碑目标 ttm=mink:tk>ttk 和最终目标预测时间 ttg=tK。为每个时间范围 h∈{s,m,g} 构建相应的视觉监督 Zth∈RV×S×D。短期预测还包含未来机器人状态序列 Sts=(st+1,st+2,…,stts),以约束细粒度运动动态。
为了预测这些目标,当前观测和指令被编码为视觉 tokens Vt 和语言 tokens EL。引入三组可学习的未来查询 Qs、Qm 和 Qg。分层依赖掩码(HDM)逐步将注意力可见范围从短期查询扩展到目标查询,建立跨时间范围依赖:
Uth=Hθ(Qh;[Vt;EL;Q≤h]),h∈{s,m,g}其中 Q≤h 表示直到时间范围 h 的查询组的拼接。预测特征通过视觉预测头 Z^th=Pvish(Uth) 投影到 DINOv2 特征空间,额外的状态预测头估计 S^ts=Pstate(Uts)。前瞻预测损失定义为:
LHFP=λmDv(Z^th,Zth)+λnDs(S^ts,Sts)为了有效利用这些多时间范围预测,作者提出了结构感知的潜在世界建模。预测的未来特征通过特征投影和结构化位置嵌入被组织为结构化世界 tokens:
wth,v,p=Pw(Z^th[v,p,:])+ehhor+evview+epspa这些 tokens 形成统一的结构化潜在世界表示 Wt∈R3×V×S×dw,显式保留时间范围、视角和空间维度。时间范围级和视角级特征进一步通过空间聚合得到,以支持不同粒度。
最后,引入动作引导的因子化世界检索(AWR)以有选择地检索未来信息。由于未来信息的相关性随去噪步骤变化,因此在每个去噪步骤 τ 从动作专家的隐藏表示构造动态检索查询 qt,τa=Q(Ht,τa)。独立的线性投影生成用于时间范围、相机视角和空间位置的查询。然后在这些维度上建立统一的因子化注意力操作:
at,τℓ(i∣c)=Softmaxi(d(qt,τℓ)⊤ktℓ(i∣c)),ℓ∈{H,V,S}得到的注意力权重被组合以聚合潜在世界值,生成与动作相关的未来表示 ft,τ。随着以动作为条件的查询不断演化,模型动态调整其在预测时间范围、相机视角和空间区域上的注意力。检索到的特征与动作表示融合,并通过残差连接注入动作专家。
整体训练目标通过流匹配损失 LACT 和前瞻预测损失 LHFP 联合优化动作生成和分层前瞻预测:
L=LACT+LHFP实验
评估涵盖 LIBERO 和 RoboTwin 2.0 上的仿真基准、使用单臂机器人进行的真实世界操作任务、消融研究以及定性注意力可视化。在这些设置中,HiFOR 持续优于基线,尤其在长时间范围任务和复杂操作任务上提升显著。消融研究表明,分层前瞻预测和动作引导检索提供互补收益,而注意力分析表明模型会根据任务阶段自适应地在时间范围和相机视角之间转移关注点。
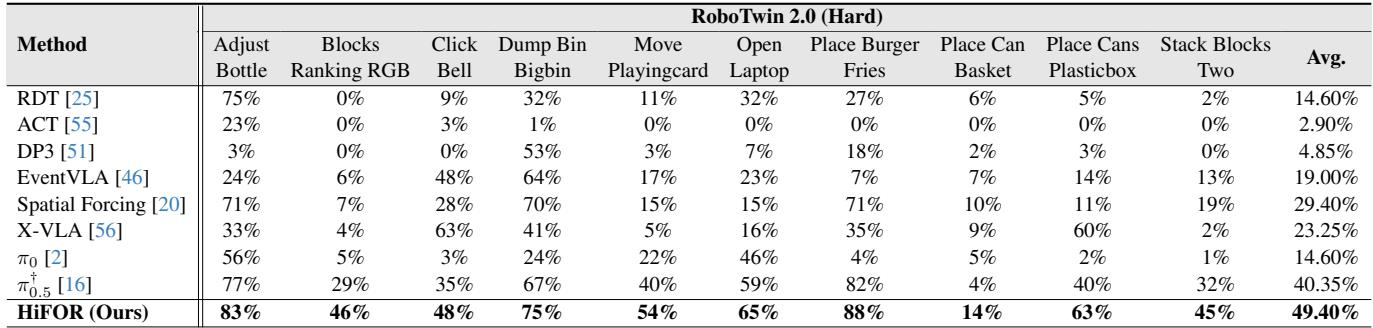
在 RoboTwin 2.0 Hard 基准上,HiFOR 在 20 个任务中取得最高平均成功率 49.40%,比 pi0.5 基线高出 9.05 个百分点。其他报告的方法明显较低,Spatial Forcing 平均为 29.40%,X-VLA 为 23.25%,EventVLA 为 19.00%。任务级提升在 Blocks Ranking RGB、Place Cans Plasticbox、Move Playingcard 和 Stack Blocks Two 上尤其明显。HiFOR 在 20 个 RoboTwin 2.0 Hard 任务上取得最佳整体平均成功率 49.40%,比 pi0.5 基线高出 9.05 个百分点。任务级改进包括 Blocks Ranking RGB 从 29% 提升到 46%,Place Cans Plasticbox 从 40% 提升到 63%。HiFOR 在 Move Playingcard 和 Stack Blocks Two 上分别超过基线 14% 和 13%。
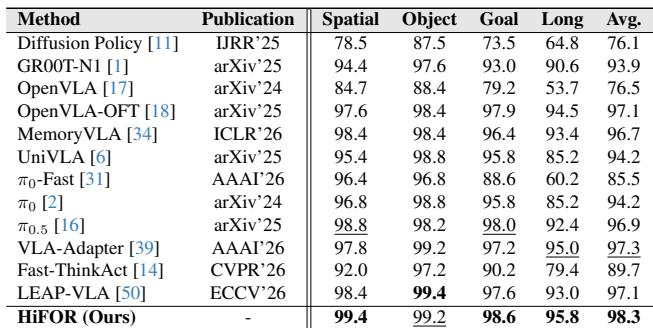
在 LIBERO 上,HiFOR 取得最高整体平均成功率 98.3%,并在 Spatial、Goal 和 Long 任务套件上取得领先结果。长时间范围任务表现出最大的相对收益,比所引用的基线提高 3.4 个百分点。先前视觉-语言-动作方法(如 OpenVLA-OFT 和 MemoryVLA)具有竞争力,但 HiFOR 在整体和长时间范围操作上仍然更强。HiFOR 取得 LIBERO 最佳整体平均成功率,并在 Spatial、Goal 和 Long 套件上领先,同时在 Object 任务上保持竞争力。长时间范围性能使 HiFOR 脱颖而出,在 Long 套件上达到 95.8%,而 OpenVLA 和 Diffusion Policy 等早期方法的分数明显更低。与所引用的基线相比,最大的改进出现在长时间范围任务上,提升为 3.4 个百分点。OpenVLA-OFT 和 MemoryVLA 属于较强的先前方法,但其整体平均成功率落后于 HiFOR。
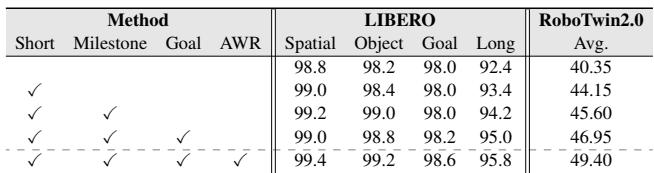
消融研究表明,每个核心组件都在操作成功率上带来递进收益,其中长时间范围 LIBERO 和 RoboTwin 2.0 上的改进最大。短期前瞻提供初始提升,里程碑和目标预测进一步提高准确性,动作引导的世界检索带来额外收益。基于语义特征的未来预测也优于直接 RGB 像素预测,尤其在长时间范围任务上。加入短期前瞻使 RoboTwin 2.0 成功率相比基线显著提高,随后加入的里程碑、目标和检索组件各自进一步带来收益。在 LIBERO-Long 上,完整模型相比基线将成功率提高若干个百分点,基于语义特征的预测超过基于 RGB 的预测。
HiFOR 在 RoboTwin 2.0 Hard 和 LIBERO 基准上进行了评估,分别取得 49.40% 和 98.3% 的最高平均成功率。它在 RoboTwin 上比 pi0.5 基线高出 9.05 个百分点,在 Blocks Ranking RGB 和 Place Cans Plasticbox 等任务上收益显著,并在 LIBERO 长时间范围任务上表现出最大的相对改进。消融研究确认,短期前瞻、里程碑和目标预测以及动作引导检索各自带来递进收益,而基于语义特征的未来预测优于直接 RGB 像素预测,尤其对于长时间范围操作。