Command Palette
Search for a command to run...
Wizard:一种智能体化游戏世界模型
Wizard:一种智能体化游戏世界模型
Yuzhe Wu Zijun Lin Yeying Jin
摘要
近年来,视频世界模型的进展使得生成日益逼真且可交互的虚拟环境成为可能,为玩家可自定义的游戏玩法开辟了新的可能性。智能体化框架通过将显式游戏逻辑和可控世界表示与视觉生成解耦,进一步推动了这一方向。然而,现有方法仅支持简单的游戏设定和预定义的运动模式,对未见环境和角色的泛化能力较差,且实时交互性有限。本文提出了 Wizard,一种智能体化游戏世界模型,该模型能够对角色运动进行实时、精确控制,同时在新场景、角色和动作上实现零样本泛化。为此,我们构建了一个涵盖 750 个场景和 178 个角色的多样化数据集,并将骨骼和几何信息作为结构化表示。我们将这些表示作为中间代理来条件化视频生成模型,并结合自适应掩码机制,以改善条件信号与生成视频片段之间的一致性。此外,我们引入了一个智能体化框架,该框架显式地维护和更新游戏状态,使玩家能够自由配置其虚拟世界,并对角色运动进行细粒度控制,同时保持视觉质量和游戏玩法一致性。通过将智能体化控制与基于结构化代理的生成相结合,我们的框架为玩家驱动的游戏创作开启了新的可能性,实现实时、可泛化且机制一致的世界模拟。
一句话总结
来自腾讯、新加坡国立大学和南洋理工大学的研究人员介绍了 Wizard,一个 agentic 游戏世界模型,通过以来自包含 750 个场景和 178 个角色的数据集的骨架与几何代理为条件进行视频生成,并使用自适应掩码和显式游戏状态更新,实现跨新场景、新角色和新动作的实时、精确、零样本角色运动控制,从而保持视觉质量和游戏玩法一致性,支持玩家驱动的世界创建。
核心贡献
- 本文介绍了 Wizard,一个 agentic 游戏世界模型,它以关节骨架和几何图作为生成条件,维护显式游戏状态,并支持玩家对角色运动和场景操作的细粒度控制,同时保持游戏玩法一致性。
- 本文构建了一个覆盖 750 个场景和 178 个角色的多源多样化数据集,并对齐了角色骨架与场景几何,为角色和场景生成提供结构化视觉代理。
- 该方法在训练和推理过程中使用基于这些代理中角色位置的自适应注意力掩码机制,以改善身份保持和视频-参考对齐,支持对未见过场景、角色和运动的零样本泛化,并通过因果适配和少步蒸馏实现实时生成。
引言
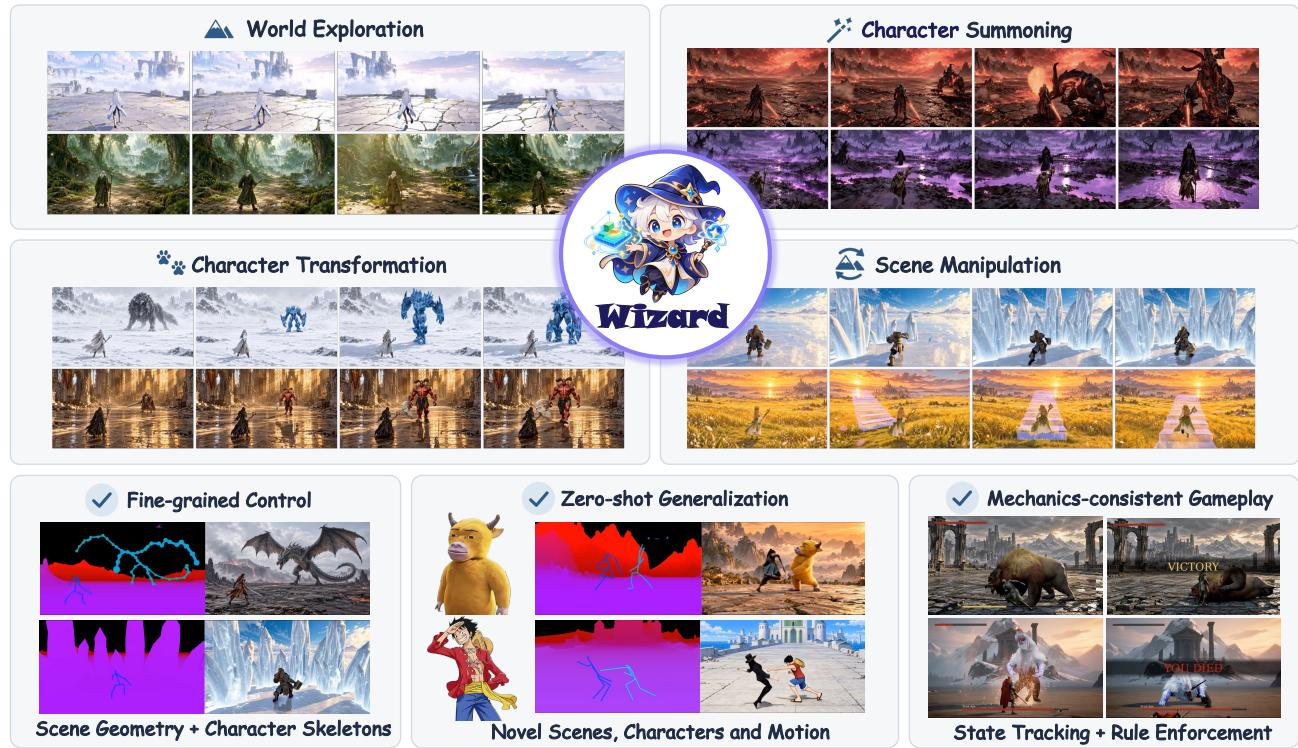
世界模型从视觉历史和当前动作预测未来观测,在游戏中,它们提供了一条基于玩家输入实现交互式、个性化游戏玩法的路径。现有方法在控制灵活性、泛化能力和实时交互方面仍受限制:动作条件模型受限于预定义动作集,提示条件模型难以处理未见过的指令,而 agentic 或基于引擎的方法通常侧重基础载具或运动控制,或施加场景和延迟约束。作者提出 Wizard,一个 agentic 游戏世界模型,通过结构化空间条件将场景构建、角色动画和游戏玩法逻辑与视觉生成解耦。Wizard 使用深度和高度几何表示场景,并使用关节骨架表示角色,从而支持对未见过场景、角色和运动的零样本泛化,同时支持实时、机制一致的游戏玩法。
数据集
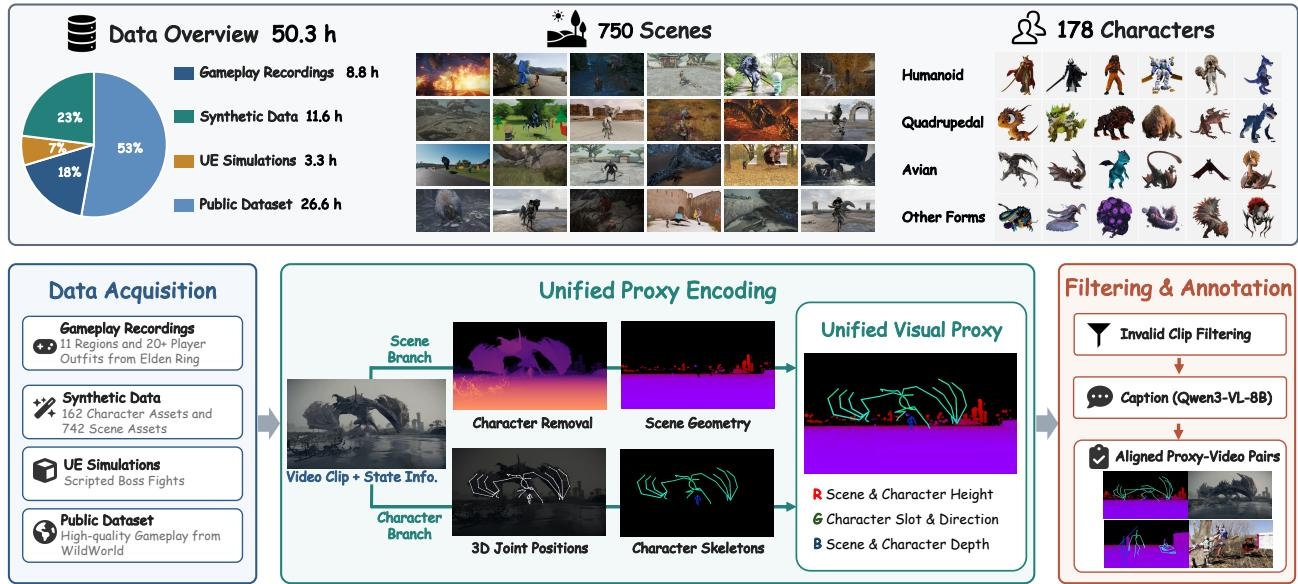
数据集概览
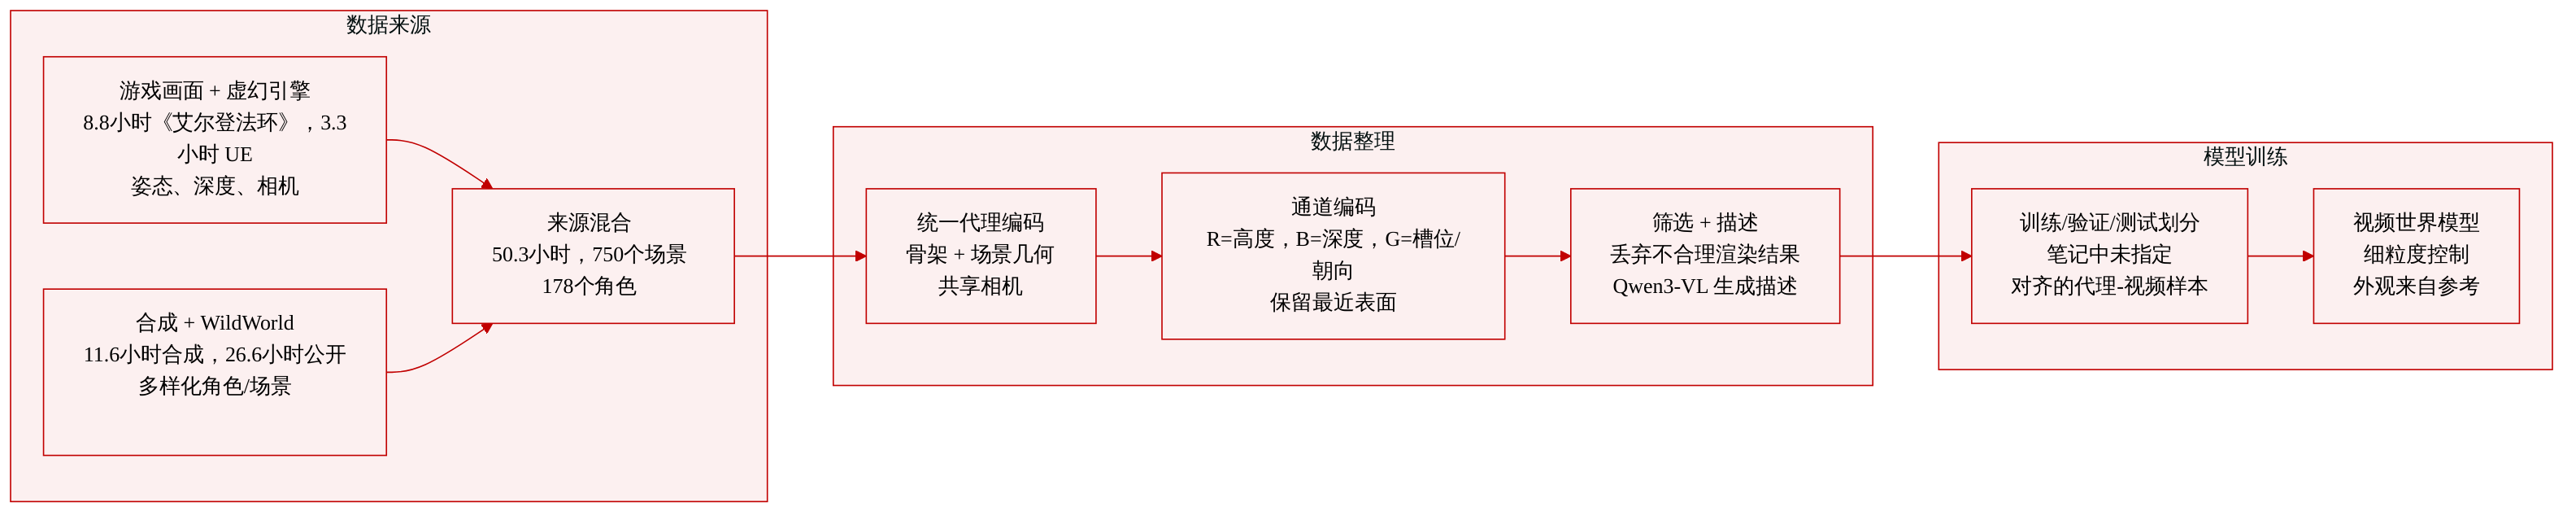
- 作者构建了 50.3 小时的对齐代理-视频对,覆盖 750 个场景和 178 个角色。
- 该数据集结合了真实游戏录制、合成数据、Unreal Engine 模拟以及公开数据集。
- 目标是将 RGB 视频与互补控制信号配对:用于角色运动的关节骨架和用于场景结构的几何图。
来源构成
- 游戏录制: 来自《艾尔登法环》的 8.8 小时,覆盖第三人称战斗与探索。战斗数据包含六个身体结构多样的 Boss,探索数据覆盖 11 个地区和 20 多种玩家外观。RGB 帧、相机参数、场景深度和角色骨架直接从游戏中捕获。
- 合成数据: 通过程序化渲染管线生成的 11.6 小时。它使用来自 Sketchfab、Quaternius 和 KayKit 的 133 个 Boss 和 29 个玩家资产,以及 842 个 Poly Haven 环境资产。每个场景包含 15 到 30 个随机放置的道具和随机化的角色颜色。四种场景针对鲁棒性:新角色进入、多角色共存、相机导致的消失/重现,以及跟随相机下的快速转身。95% 的样本应用了相机运动,并由视觉语言模型过滤掉无效渲染和物理上不合理的放置。
- Unreal Engine 模拟: 3.3 小时游戏画面,包含重建的角色与武器、脚本化对手和机器人控制的玩家。RGB 帧和几何代理从同一模拟状态渲染,用于对齐监督。
- 公开数据集: 来自 WildWorld 的 26.6 小时,选取了多样的生物形态和运动模式。其同步的相机、骨架和深度标注被转换为统一的代理表示。
处理管线
- 数据采集: 收集相机位姿、内参、骨架和场景深度。对于真实游戏,从游戏进程提取相机数据和骨架状态。场景深度以每秒一帧捕获,并用于重建场景几何,再按每帧渲染深度图。合成数据和 Unreal Engine 数据直接来自资产和模拟状态。公开数据集标注被复用。
- 统一代理编码: 在每一帧,角色骨架和场景几何在共享相机下联合渲染,以保持空间关系和遮挡。
- 场景分支:从深度图中移除角色和天空,将时序观测融合到 3D 场景几何中,并在每帧相机位姿下重新渲染几何。
- 角色分支:将 3D 关节投影到相机视图中,渲染为带关节标记的圆润骨骼段,其粗细根据角色尺度和相机距离调整。
- 通道编码: RGB 通道编码几何属性而非外观颜色。
- R 编码高度,角色值映射到 [0, 0.2],场景值映射到 [0.5, 1]。
- B 编码相机前向深度,越亮表示表面越近。
- 在每个像素处,渲染器保留最靠近相机的表面。
- G 联合编码角色槽位和朝向,场景几何使用 G = 0。同一帧内角色的所有部分共享相同槽位值,并且槽位与参考图像关联。
- 过滤与标注: 过滤掉具有不合理配置(如悬浮玩家或渲染失败)的合成样本。Qwen3-VL-8B 从第一帧和角色参考生成结构化字幕,描述条件信号、玩家、Boss 和背景。
训练样本格式
每个训练样本包含:
- 一个对齐的代理视频。
- 一个 RGB 片段。
- 角色参考图像。
- 一段文本描述。
模型中的使用
- 统一的代理-视频对用于训练视频世界模型,以实现细粒度控制和零样本泛化。
- 槽位和参考设置旨在使生成器从参考图像恢复角色外观,而不是依赖固定的视觉外观或屏幕位置。
- 提供的章节未指定显式的训练/验证划分、确切的来源混合比例或裁剪策略。所述处理聚焦于构建统一的几何条件信号和对齐的视频-代理训练样本。
方法
作者提出 Wizard,一个将用于显式世界状态控制的 agentic 框架与视频生成器相结合的系统,该生成器通过结构化视觉代理渲染不断演变的状态。在每次游戏会话之前,初始化阶段重建场景和角色,装配角色骨架,并通过运动检索和重定向构建特定于目标的运动集。初始化后,该框架通过根据玩家输入和 Boss 决策更新角色运动、场景几何和战斗状态来支持实时游戏,而视频生成器渲染相应的视觉观测。
如下图所示:
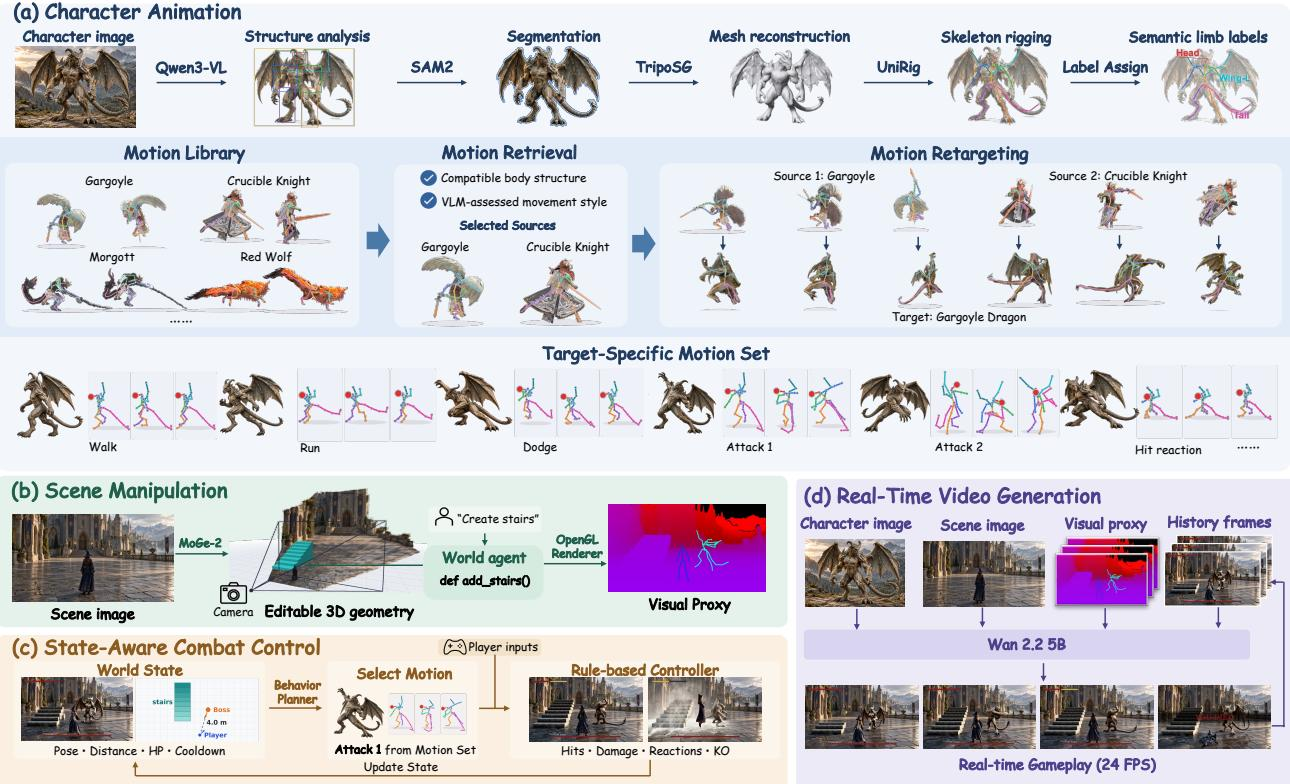
该 agentic 框架处理角色动画、场景操作和状态感知战斗控制。对于角色动画,Qwen3-VL 从角色图像推断身体结构,SAM2 对其进行分割,TripoSG 重建网格。UniRig 和中轴拟合程序生成带语义标签的骨架。动作从库中根据兼容的身体结构和视觉语言模型评估的运动风格进行检索,然后使用逆向运动学重定向。对于场景操作,MoGe-2 恢复 3D 点图和相机参数,以构建可编辑背景网格。一个 world agent 将自然语言指令转换为几何算子来修改场景几何,并使用 OpenGL 重新渲染为视觉代理。对于状态感知战斗控制,共享世界状态跟踪位置、姿态、生命值和冷却时间。行为规划器选择移动和攻击,而基于规则的控制器执行游戏玩法约束,通过扫掠碰撞盒检测命中,并更新战斗结果。
为了对视频生成器进行条件化,系统构建统一的几何条件视频。场景几何和角色骨架被联合渲染,以保持空间关系和相互遮挡。RGB 通道编码几何属性而非外观颜色:R 编码高度,B 编码相机前向深度,G 联合编码角色的槽位和朝向。
参见框架图:
视频生成器基于 Wan2.2-TI2V-5B 构建,将不断演变的视觉代理渲染为视频,其条件包括初始场景图像和角色参考:
X^t:t+L−1=Gθ(Pt:t+L−1,I0,{Rk}k=1K;H<t)其中 Pt:t+L−1、I0 和 Rk 分别表示视觉代理序列、初始场景图像以及角色 k 的参考图像。H<t 表示来自先前生成帧的保留上下文。
如下图所示:
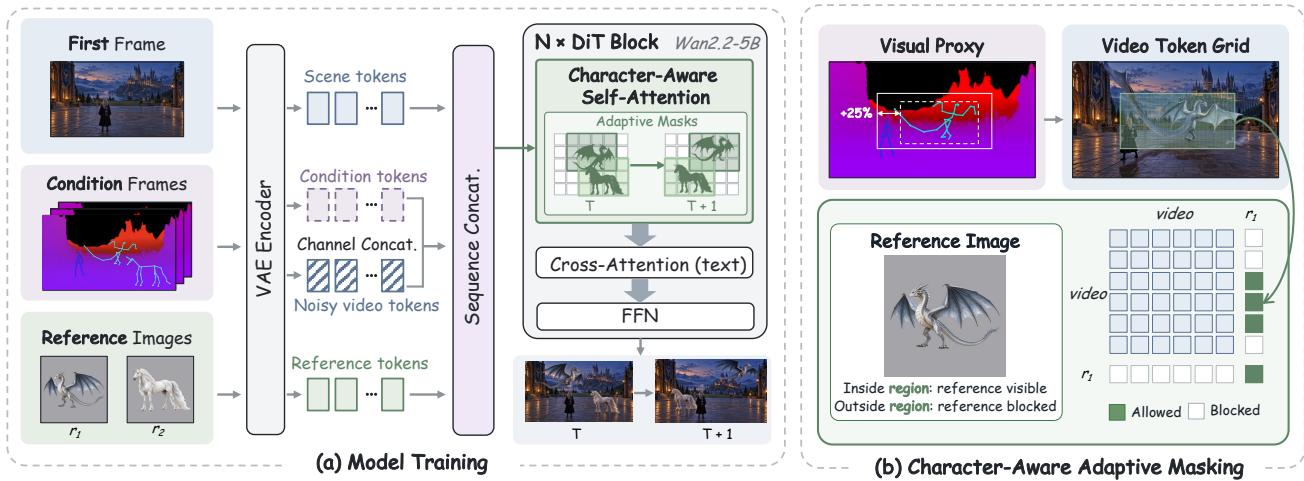
第一帧被编码为干净的隐变量前缀,以建立场景外观。代理帧由同一 VAE 编码,并沿通道与带噪视频隐变量拼接,使用零初始化条件嵌入。角色参考作为额外的 tokens 追加,以指定外观。
为了将参考图像绑定到目标角色,作者通过 Character-Aware Adaptive Masking 利用显式骨架结构。边界区域由骨架推导并扩展 25%。在每个 DiT 自注意力层中,从视频 token i 到参考 token j 的注意力通过一个加性掩码进行门控:
Aij=Softmaxj(dqi⊤kj+Mij),Mij={0,−∞,ui∈Ωk(j),τ(i),otherwise,其中 k(j) 标识与参考 token j 关联的角色,ui 和 τ(i) 表示视频 token i 的空间位置和帧索引,Ωk,τ 是角色 k 在帧 τ 处的扩展区域。这种空间掩码减少了跨角色外观泄漏,并支持灵活的角色召唤、移除、变换和多角色游戏玩法。
对于实时自回归生成,作者采用三阶段训练管线。首先,通过教师强制使双向模型适配自回归生成。其次,一致性蒸馏使用引导式因果教师和指数移动平均目标,以 20 个隐帧的滑动窗口训练学生模型,并将第一帧作为持久注意力锚点。第三,在学生对自身自回归展开结果上应用分布匹配蒸馏,使用冻结的双向模型作为目标评分网络,并使用学习到的 critic 估计学生评分。视觉代理条件和角色门控的参考注意力在所有阶段保持有效,使模型能够仅用 2 个去噪步骤以 24 FPS 生成实时展开结果。
实验
实验使用训练期间未见过的用户提供参考来评估 Wizard,并由 agent 控制的视觉代理驱动实时游戏生成。零样本泛化测试表明,该模型能够处理新场景、角色和运动,同时保持视觉一致性并执行基于生命值的战斗结算等游戏规则。开放式创造性游戏测试进一步展示了交互式角色变换和场景操作,包括在单一场景中组合这两种变化。总体而言,该框架支持用户灵活驱动的角色和环境控制,而无需额外微调。