Command Palette
Search for a command to run...
视频生成遇见智能体运行框架(Agent Harness):智能体化视频生成、智能体化世界建模与递归自我改进
视频生成遇见智能体运行框架(Agent Harness):智能体化视频生成、智能体化世界建模与递归自我改进
摘要
视频生成正从端到端合成走向智能体化生成,其中规划、工具使用和反馈能够生成具有更强可控性的连贯多镜头视频。与此同时,视频世界模型提供以动作条件化的观测和未来预测,并可作为智能体的交互式环境。我们通过智能体运行框架(agent harness)研究这一交汇点:该框架是可执行运行时,用于构建智能体的上下文、暴露工具、维护状态、路由反馈,并对视频生成器等模型施加预算约束。本报告围绕三个方向展开。第一,我们研究智能体化视频生成,其中运行框架协调剧本与镜头规划、素材管理、镜头制作和剪辑,并讨论此类系统的评估必须区分哪些内容。第二,我们考察智能体化世界建模,其中运行框架在观测、控制、执行和状态之间起中介作用,包括如下设计:由游戏引擎或编码智能体编写的程序保持世界状态,而视频模型对其进行渲染;智能体与世界模型相互测试、相互改进。第三,我们考察视频模型开发中的递归自我改进(RSI):我们将对当前输出的修订,与对运行框架状态、生成器参数和评估器的更新,以及与对产生后续更新的程序的更改区分开来;并识别改进可能重新进入开发流程的通道。在这些方向中,我们分析了视频对智能体能力提出的要求,从视听感知、长时程规划和记忆,到通过代码和计算机使用进行交互、反馈引导控制、技能复用和多智能体组织。最后,我们总结开放挑战,包括自主视频制作、终身记忆、可编程混合控制、自主模型开发、来源追踪与成本核算,以及将视频质量和任务性能同模型与运行框架的持续改进联系起来的评估。
一句话总结
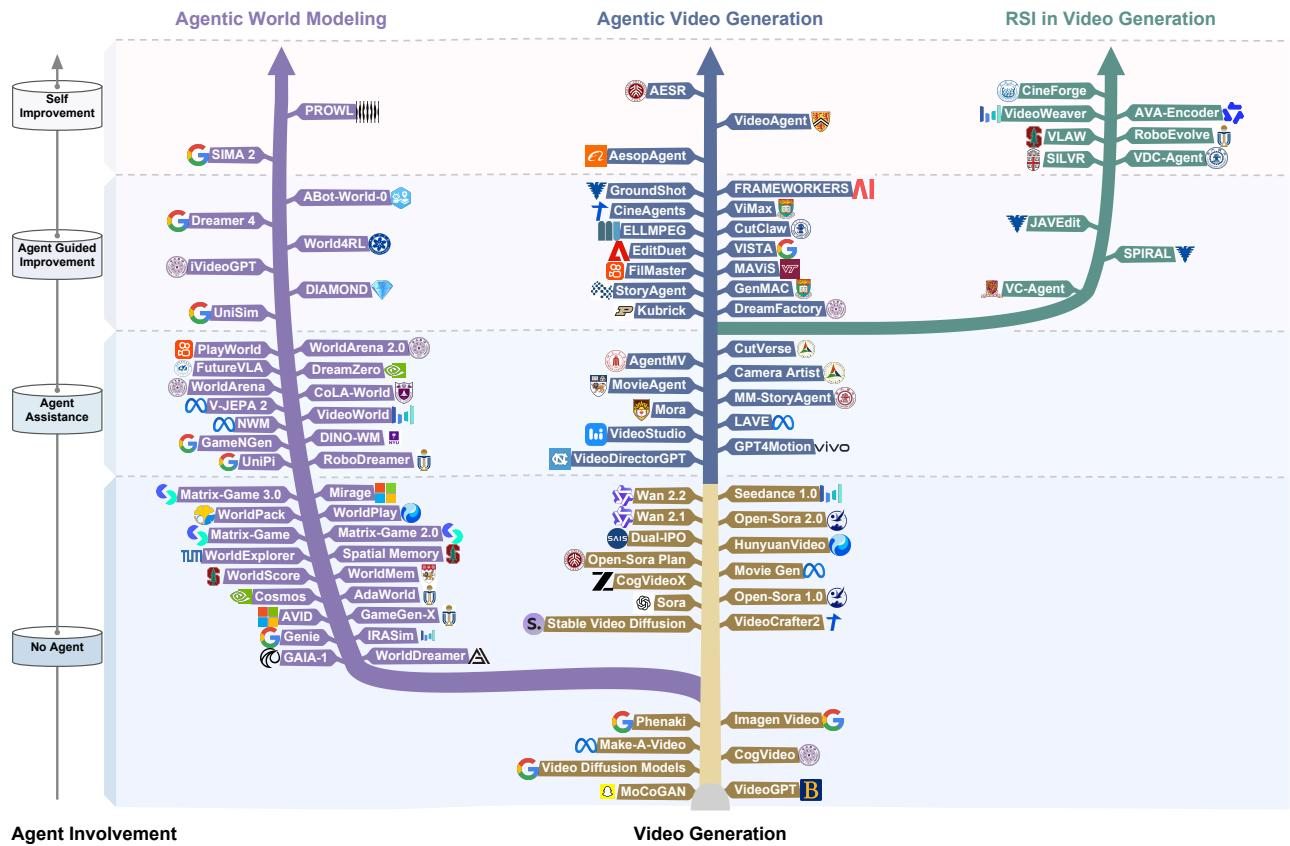
来自 Video Rebirth、新加坡国立大学、南洋理工大学等机构的研究人员将 agent harness 作为可执行运行时进行分析,该运行时在 agentic video generation、agentic world modeling 和 recursive self-improvement 中协调规划、工具、状态、反馈与预算,并指出自主视频生成和评估中的开放挑战。
核心贡献
- 引入了面向 agentic video generation 的 agent-harness 框架,涵盖脚本与镜头规划、资产管理、镜头制作和剪辑,并阐明必须分离哪些评估方面。
- 通过该 harness 检视 agentic world modeling,包括观察、控制、执行和状态如何被中介;混合设计,其中游戏引擎或由 coding agent 编写的程序持有世界状态,而视频模型负责渲染;以及 agent 与世界模型之间的相互测试和改进。
- 分析视频模型开发中的 recursive self-improvement,区分对当前输出的修订、对 harness 状态和生成器/评估器参数的更新,以及对产生后续更新程序的更改,并识别改进可以重新进入开发流程的通道。
引言
视频生成器现在能够生成越来越逼真、可控且时间连贯的片段,但仅靠生成器并不能组织完成视频任务所需的决策:创意简报必须转化为连贯镜头,参考内容必须跨场景保持,拍摄素材必须检查,剪辑必须保留正确工作,交互式视频必须从观察中继续。现有综述考察了相关部分,如时空一致性、后训练与对齐、评估、视觉 agent、世界模型和 agent harness,但并未将视频生成器周围的 harness 作为跨生成、交互和模型开发的分析单元。当前系统还倾向于自动化固定的数据收集和训练循环,而不是改进循环本身,并且尚无被调查系统会修订训练和验证生成器的程序。作者通过以 harness 为中心的框架来填补这一空白,该框架将 agentic video generation、视频世界模型交互以及朝向 recursive self-improvement 的发展联系起来,同时明确该路径的评估要求和开放问题。
数据集
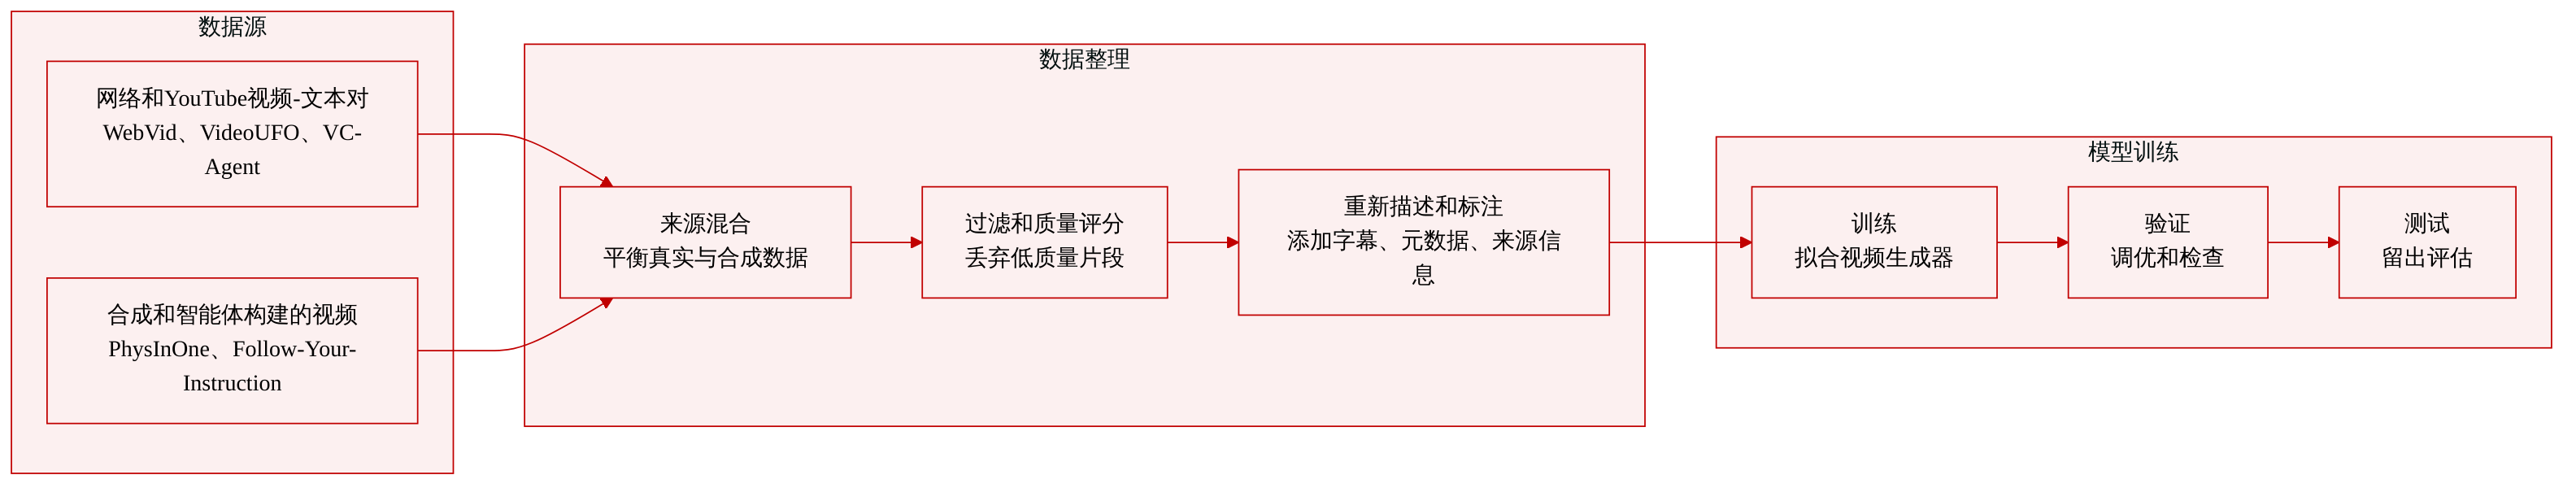
作者综述了视频生成训练数据的策展方式,而不是引入一个新的数据集。他们将相关领域组织为三个阶段:数据获取与检索、标注与合成,以及数据精炼。
来源与构成
- WebVid:数百万个网络视频-文本对,用作通用视频生成来源。
- HD-VG-130M:更大规模的高清视频集合,用于文本到视频生成。
- VideoUFO:根据从真实用户提示中提取的主题检索 YouTube 视频,提高对请求内容的覆盖。
- Phantom-Data:跨对训练数据,包含同一主体在不同视觉上下文中的参考图像,旨在减少 subject-to-video generation 中的复制粘贴伪影。
- VC-Agent:通过用户反馈过滤的视频检索数据,包括接受的样本和拒绝原因;所得数据用于微调 CogVideoX。
- Panda-70M:由多个跨模态教师生成候选字幕,并由训练好的视频-文本检索模型进行选择。
- ShareGPT4Video:通过比较连续关键帧生成的详细视频字幕,用于描述动作和相机运动变化。
- Vidu S2-Avatar:通过多个 agent 与单个事件对齐的时间顺序字幕。
- PhysInOne:覆盖多种物理现象的合成视频,用于提高物理合理性。
- Follow-Your-Instruction:由 MLLM agent 构建的合成视频数据,这些 agent 构建 3D 场景、跨视图验证布局,并规划时间演变。
- EdenLive:从 agent 构建的代理视频合成的训练对。
- OpenVid-1M:通过质量过滤和重新字幕改进的视频数据。
- Koala-36M:由结合多个质量指标的 Video Training Suitability Score 选出的视频。
- SolarWM:来自十个数据集的 143 万个片段,统一为包含观察、度量相机几何、字幕、质量元数据、选择决策和来源的记录。
- Ditto 和 JAVEdit:针对合成视频数据的 agent 驱动过滤、修正和流水线修复。
处理与元数据
- 主要处理步骤包括过滤、重新字幕、质量评分、标注和合成生成。
- SolarWM 将源处理与混合构建分离,因此可以通过更改过滤标准或采样权重来定义新的训练混合,而无需重新处理源。
- 文本没有指定统一的裁剪策略;重点在于字幕质量、过滤、元数据统一和来源追踪。
数据如何使用
- 策展数据支持视频生成模型的训练和微调。
- VC-Agent 数据用于微调 CogVideoX。
- PhysInOne、Follow-Your-Instruction 和 EdenLive 被用作合成监督来源,用于提高物理合理性或微调视频模型。
- 论文指出,来源以及合成数据与真实数据的混合对递归训练很重要,因为重复重用生成样本可能降低覆盖范围、质量或多样性。
方法
作者提出了一个针对 agentic video generation 和 world modeling 的统一框架,核心在于区分 agent 的决策过程与 harness 的执行运行时。agent 被定义为以目标为条件的决策过程,其中控制器策略 πϕ 从观察中选择动作。harness H 作为可执行运行时,负责构建控制器上下文、暴露工具接口、调度操作、维护状态 st 并执行约束。在每个决策周期中,控制器提出动作,harness 管理执行,工具产生后果,反馈被路由回来以更新状态。
在 agentic video generation 的语境中,该框架将创意简报转化为经过剪辑的视听作品。
参考框架图:
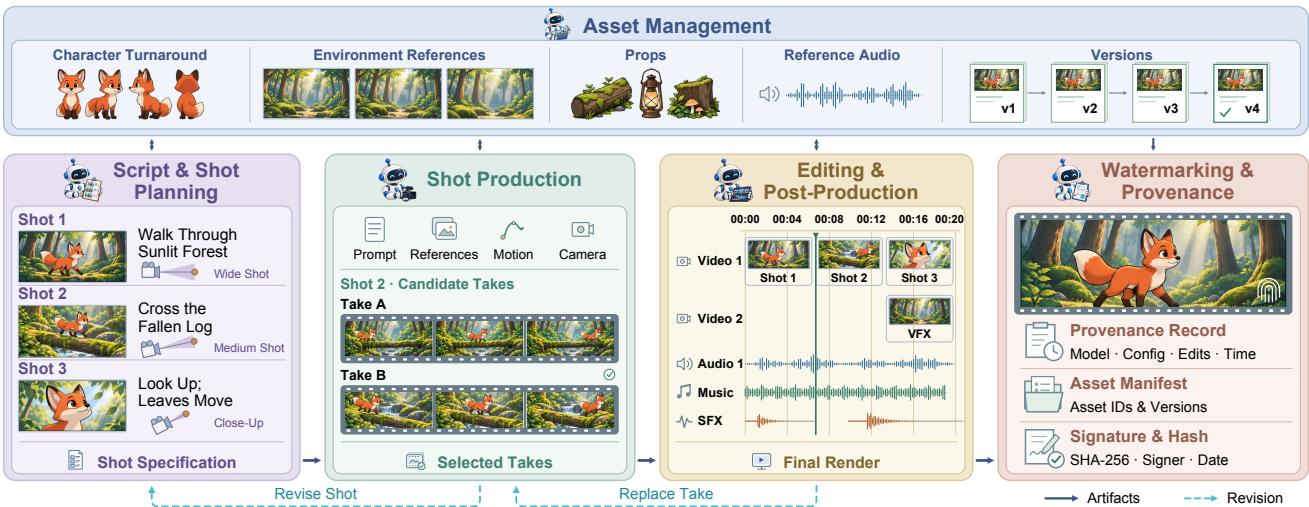
该工作流分为脚本与镜头规划、资产管理、镜头制作和剪辑。脚本定义叙事要求,可复用资产指导候选镜次生成。agent harness 连接这些活动,维护项目状态以协调跨阶段更改。决策会在不同工件之间传播;例如,修改角色参考会导致多个镜头需要修订,harness 管理这些依赖关系以确保一致性。
该框架扩展到 agentic world modeling,其中视频生成模型作为持续交互的预测核心。
如下图所示:
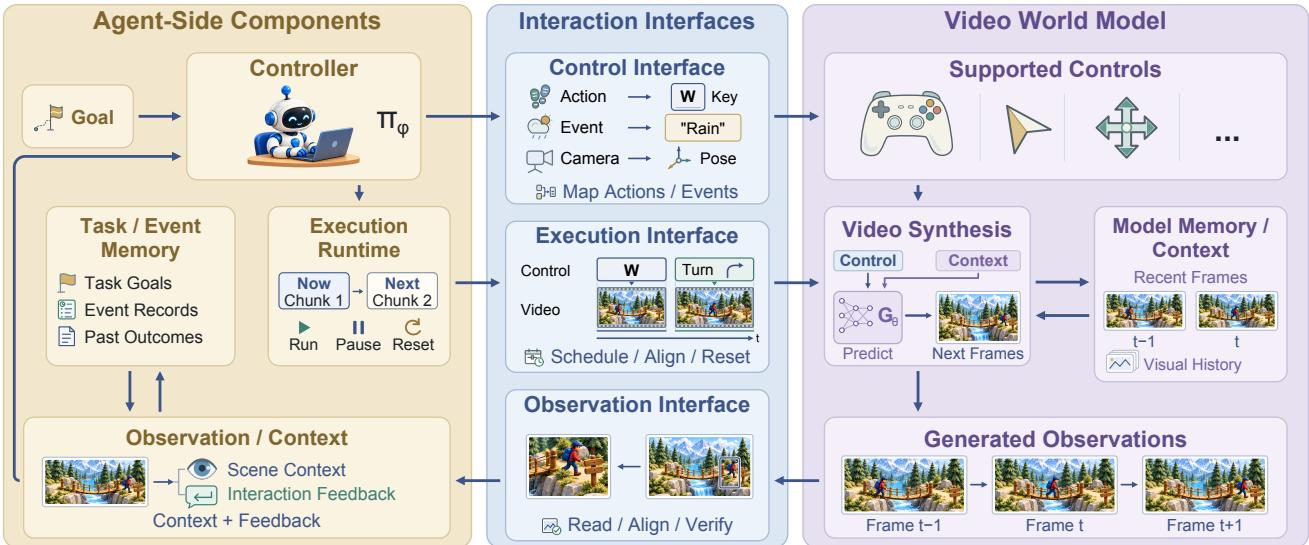
在此设置中,一次性条件生成演变为持续控制。harness 观察环境、决定动作、转换控制信号并纳入返回的反馈。视频世界模型在动作和时间上下文的条件下预测后续视觉观察,使 agent 能够持续观察、行动和修订计划。
另一种 world modeling 方法涉及显式世界状态和生成式渲染,将动力学与生成器分离。
参考框架图:
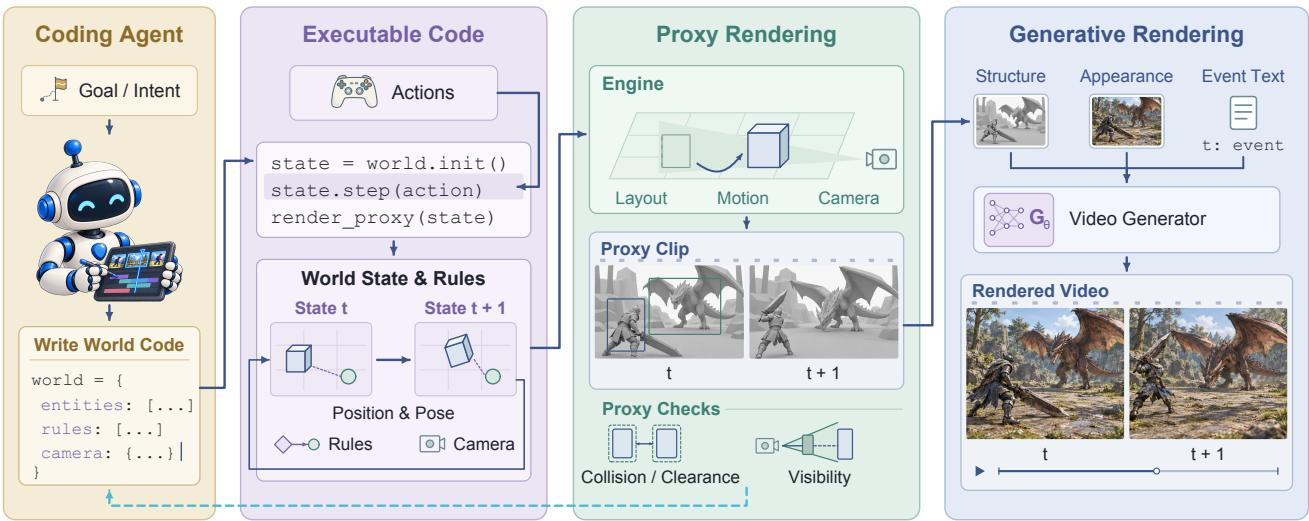
在这里,coding agent 编写一个世界程序,维护状态并应用交互规则。引擎将该状态转换为代理帧,视频生成器随后将其渲染为逼真图像。这种分工使 harness 能够直接从程序读取和编辑世界状态,而不是从帧中估计,从而精确控制几何和运动,同时将外观合成委托给神经模型。
为支持这些 agentic 系统,作者概述了基础模型改进的分类法。
如下图所示:
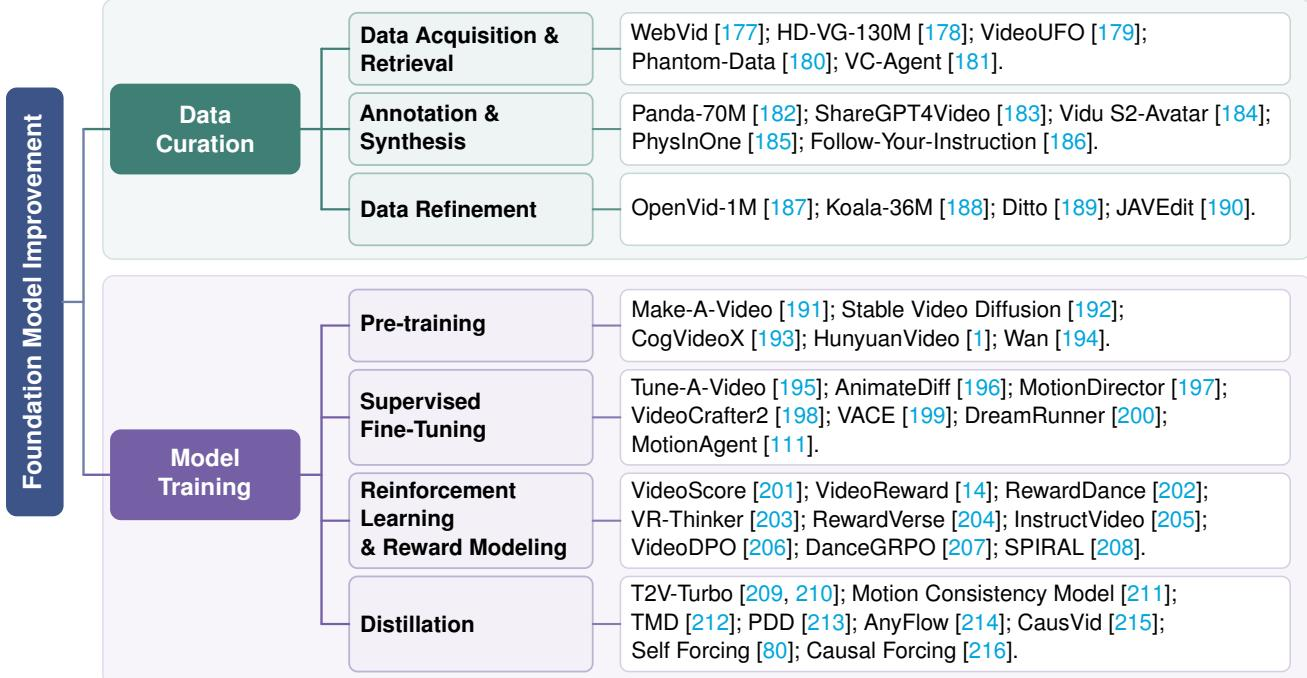
该过程涵盖数据策展,包括获取、标注和精炼,以及预训练、监督微调、带奖励建模的强化学习和蒸馏等模型训练策略。这些机制促进更强大的生成器和评估器的发展,反过来又为 agent harness 提供更好的监督和反馈。
整体 agent 设计将这些组件整合为一个连贯架构。
参考框架图:
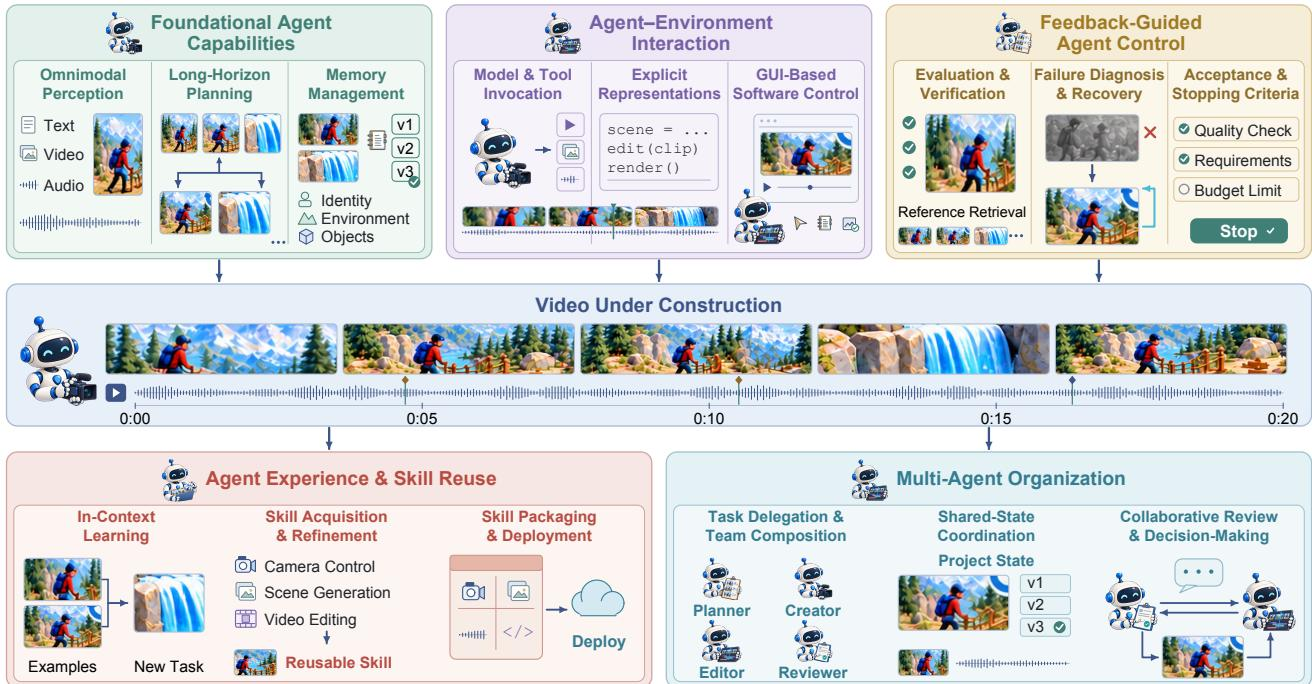
该设计涵盖全模态感知、记忆管理和长时程规划等基础能力。它通过模型调用、显式代码表示和 GUI 控制来定义 agent 与环境的交互。反馈引导的控制机制处理评估、故障诊断和接受标准。此外,该架构支持 agent 经验和技能重用,使系统能够通过上下文学习和可部署技能进行适应,并支持多 agent 组织以进行任务委派和协作审查。这些方面共同决定了视频 agent 如何通过连续的生成和修订决策来追求目标。
实验
这些章节描述 agentic world modeling 和视频生成中 recursive self-improvement 的评估框架。agentic world modeling 通过 agent 驱动的主动测试来评估长时程一致性、干预敏感性和约束一致性,同时将世界模型视为测试 agent 的环境,并要求分别衡量世界可靠性和 agent 能力。self-improvement 评估将视频输出评估(使用基准、模型评判、人类评估和 agentic 流水线)与 agent harness 评估(涵盖有效性、可诊断性、泛化性和持续适应)相结合。在这些设置中,工作强调将开发反馈与留出验证集分离、控制资源预算和基线,并通过针对性干预确认失败,而不是仅依赖视觉合理性。
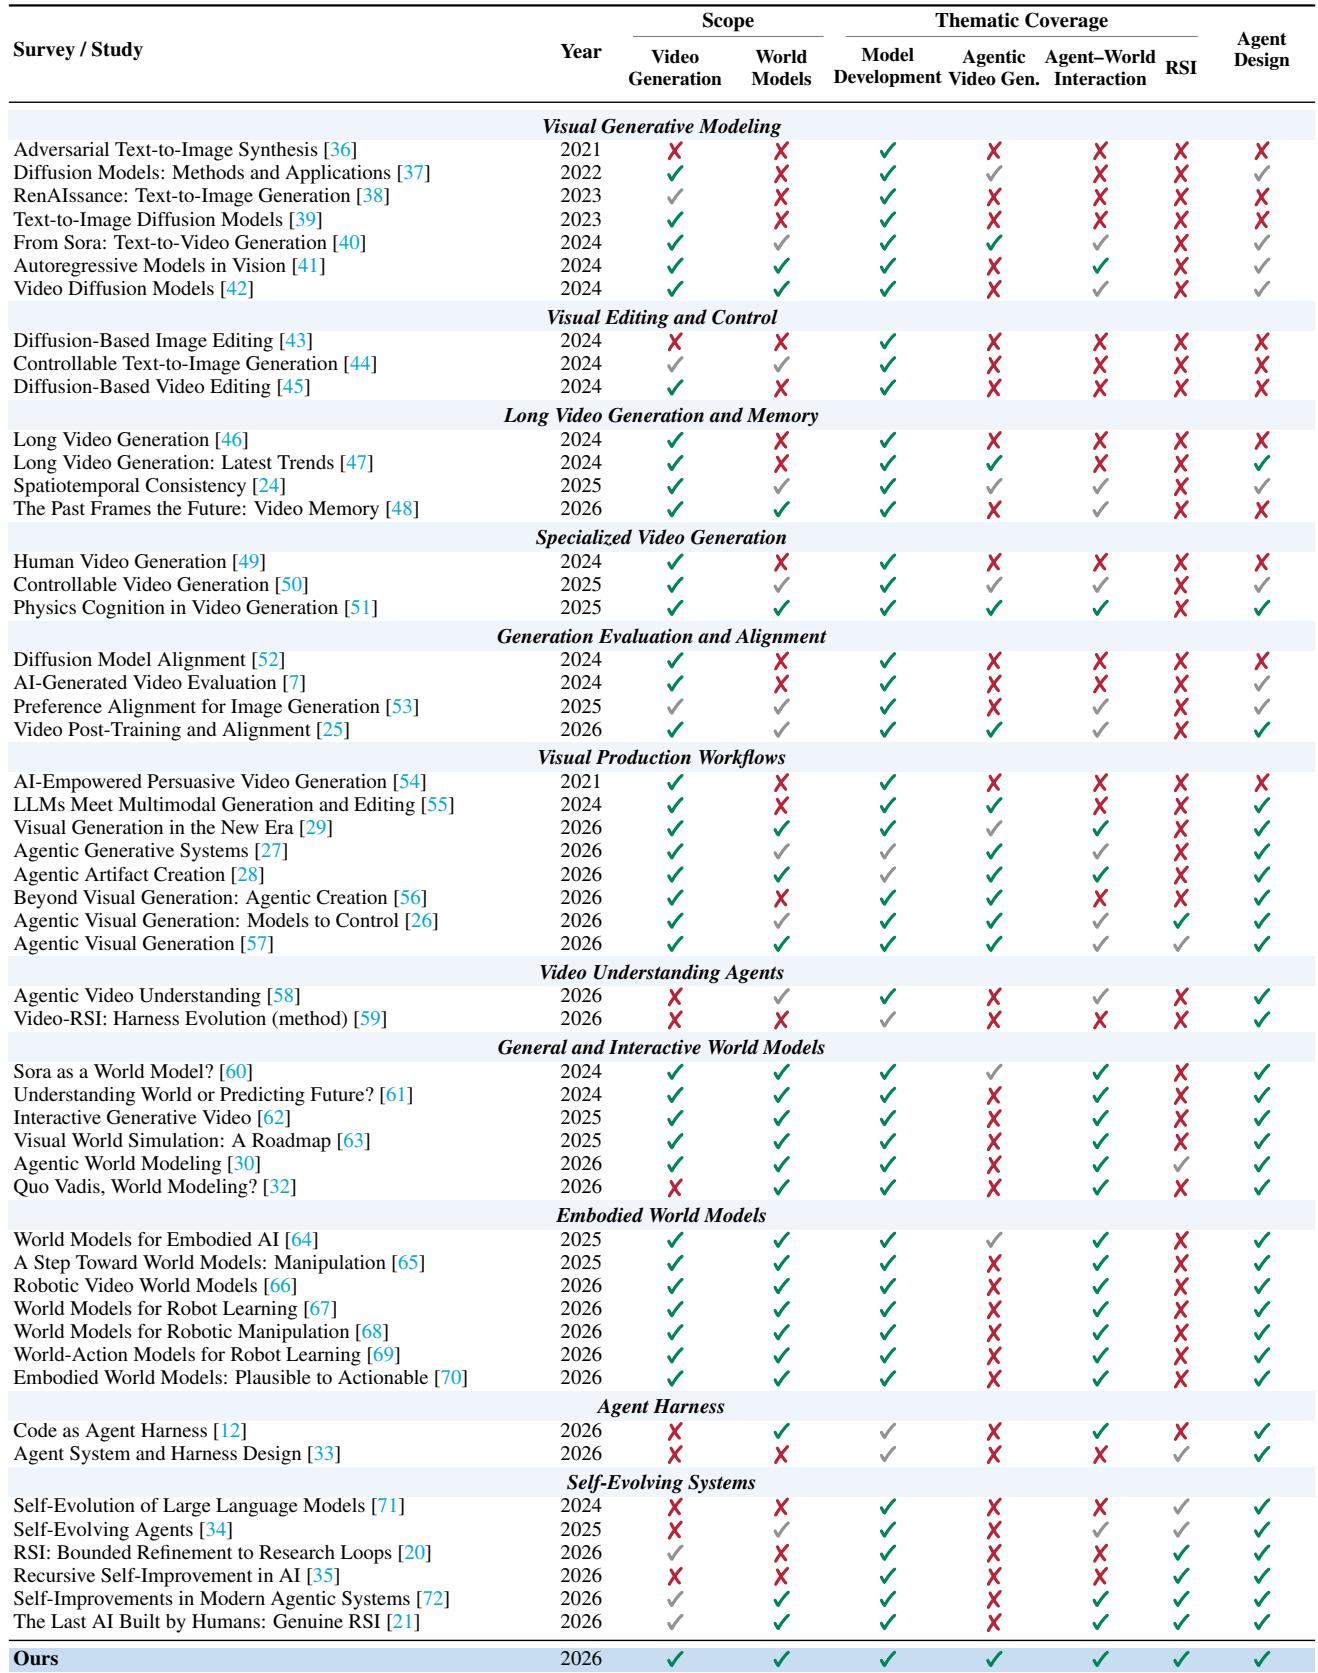
该比较从范围、主题覆盖和 agent 设计等方面考察相关综述和相邻研究。现有研究一致覆盖世界模型,但在视频生成、agentic generation 和 agent-world interaction 方面覆盖程度不一或缺失。所提出的综述通过统一的 agent-harness 框架将视频生成、世界模型、模型开发和 recursive self-improvement 结合起来,定位为互补性工作。在所比较的研究中,世界模型覆盖始终存在。agent-world interaction 未被任何比较研究覆盖,而它是所提出框架的核心。所提出框架将生成器周围的 agent harness 作为分析单元,将视频模型同时作为合成器、交互环境和面向 recursive self-improvement 的开发对象联系起来。
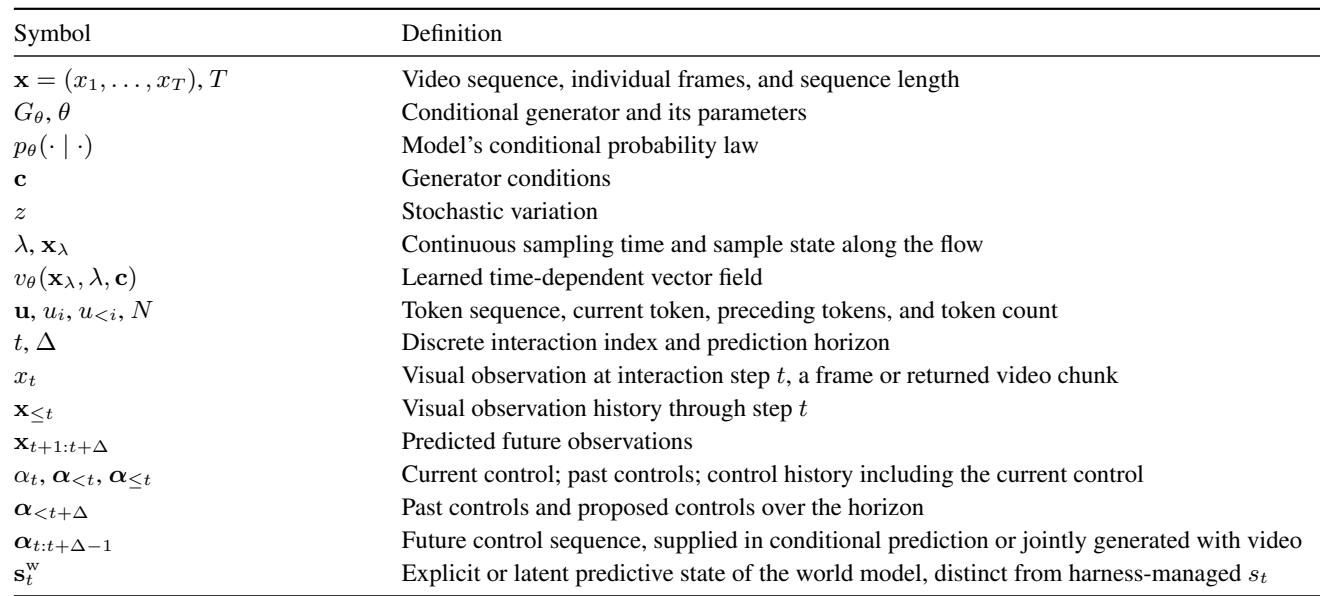
该符号定义了一个条件视频生成器,它根据条件和随机变化生成视频序列,条件涵盖文本、图像、关键帧、掩码、深度、姿态、轨迹、相机参数、音频或动作。它区分采样时间、token 位置和交互时间,并将世界模型视为功能性角色,而不是单独的采样器家族。条件不一定由用户固定,控制器在交互过程中可以构建、分解或修订条件。条件生成器将视频建模为给定条件和随机变化下序列的概率律。条件可以包含多种视觉、音频和控制信号,并且可以由控制器组合或修订。该符号区分采样时间、token 位置和交互时间,世界建模由其功能性角色定义。交互式世界模型通过接收观察和动作条件,并为后续步骤返回生成的观察来扩展视频延续。
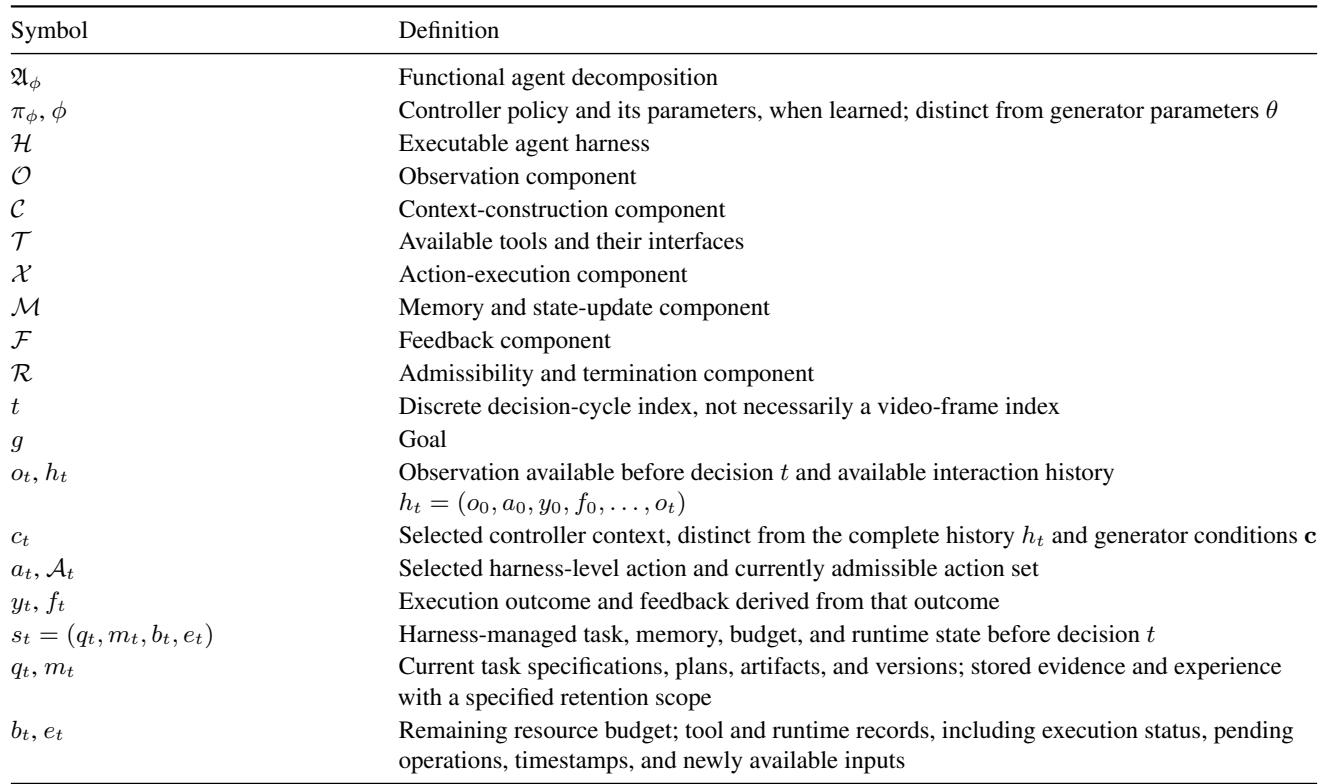
该表定义了 agent harness 的功能组件,包括观察、上下文构建、可用工具、动作执行和控制器策略。这些组件是概念性角色,不必是独立的网络或软件模块。随附讨论阐明,agency 来自执行过程,而使用 LLM 或 VLM 是实现选择,而不是 agency 的定义。agent harness 被分解为观察、上下文构建、工具和动作执行等功能角色,这些角色可以合并在单个模块中。控制器策略不同于生成器参数,将决策过程与底层模型分离。agency 被视为以目标为条件的执行过程,可以使用学习、编程或混合策略,并不要求依赖 LLM 或 VLM。
比较显示,大多数列出的视频世界模型在其运行时配置中没有外部 agent harness,只有 AdaWorld 和 Genie 3 列出了外部 harness 角色。控制接口从潜在动作或显式动作到包含相机姿态、文本提示的组合,并在更广泛讨论中包含语义或对象交互。随附文本将 harness 证据描述为薄弱,大多数机制仅在单个系统中得到演示,且很少有可归因于 harness 的单独量化收益。大多数列出的系统被标记为没有外部运行时 harness;AdaWorld 包含交互支持,Genie 3 包含交互和评估支持。控制接口从单一潜在控制或动作控制扩展到动作与相机姿态或动作与文本等组合,而讨论指出特定于 harness 的收益很少被单独分离。
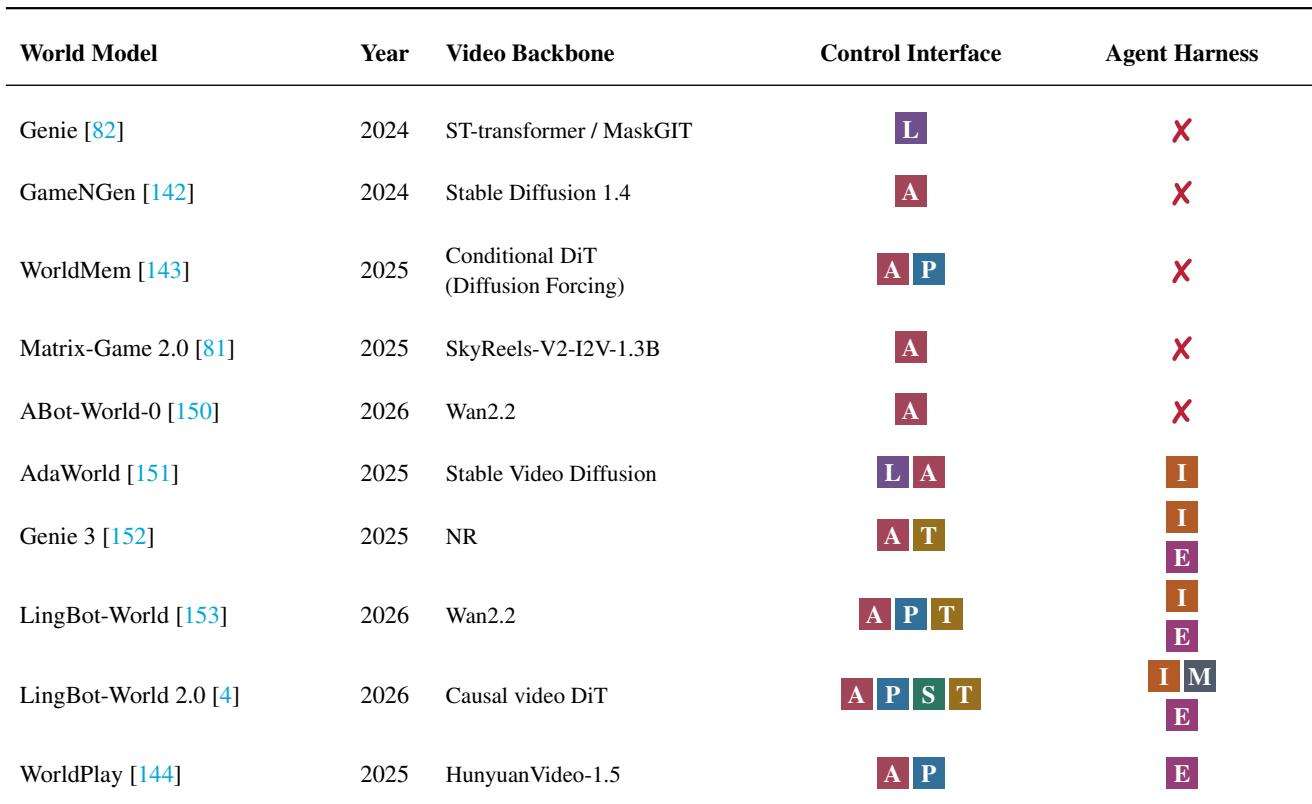
评估比较了相关综述,形式化了条件视频生成和世界模型符号,将 agent harness 分解为功能角色,并综述了现有视频世界模型中的运行时 harness 支持。先前综述一致覆盖世界模型,但大多忽略 agentic generation 和 agent-world interaction,因此所提出的统一 agent-harness 框架具有互补性。该符号阐明世界建模是功能性角色,条件可以由控制器构建或修订,交互式世界模型通过观察和动作扩展视频延续。系统综述发现,大多数列出的视频世界模型没有外部运行时 harness,只有 AdaWorld 和 Genie 3 列出 harness 角色,并且特定于 harness 的收益很少被单独分离。