Command Palette
Search for a command to run...
通过强化学习激励大语言模型的自学习能力
通过强化学习激励大语言模型的自学习能力
Lingkai Kong Yuzhe Gu Haiteng Zhao Zijian Wu Youqing Fang Zhouqi Hua Yanan Sun Kai Chen Wenwei Zhang
摘要
大语言模型(LLM)依靠参数化知识和检索增强生成(RAG)来解决知识密集型任务。然而,在陌生领域中进行问题求解,需要知识获取与推理紧密耦合,这超出了事实检索与聚合或仅从预先组装好的上下文中学习的范畴。我们研究自学习——即自主检索、研读并即时运用来自长篇参考资料的知识。为考察这一能力,我们构建了一个基于教材的数学问题求解任务。LLM 必须浏览教材内容,学习并应用相关原理,并在不提供参考解答的情况下为习题构造证明。我们引入 BookNavigator 接口来支持这一受人类启发的学习过程,并通过带有细粒度奖励的强化学习(RL)来激励自学习。实验表明,我们的方法在域内和域外教材及学科上均提升了性能,将 Intern-S2-Preview-35B 的整体证明准确率从 51.5% 提高到 79.5%,并优于经过 RL 训练的无教材基线和固定检索基线。这些收益还扩展到涉及不同任务类型的复杂长上下文基准上,在 BrowseComp-Plus 和 CL-bench 上分别比基础模型提高了 1.7 和 2.3 个百分点。综合来看,这些发现表明 RL 能够培养一种领域无关的自学习策略,凸显了从长篇语料中自学习在增强复杂长上下文任务上更广泛问题求解能力方面的潜力。
一句话总结
上海人工智能实验室及合作者提出 BookNavigator 接口,利用带细粒度奖励的强化学习来激励 LLM 进行自学习,使 Intern-S2-Preview-35B 能够在推理过程中即时学习长篇幅教材,将其证明准确率从 51.5% 提升到 79.5%,并在 BrowseComp-Plus 和 CL-bench 上取得性能提升。
核心贡献
- 本文定义了一种基于教材的数学问题求解任务,模型必须在没有参考解答的情况下浏览长篇幅教材内容,学习相关定义和定理,并为习题构造证明。
- 本文引入了 BookNavigator 接口和一种细粒度强化学习奖励方案,该方案对学习和导航动作予以奖励,鼓励在单个问题求解回合内自主获取并应用知识。
- 实验表明,该方法将 Intern-S2-Preview-35B 在域内和域外教材及学科上的整体证明准确率从 51.5% 提升到 79.5%,优于经过 RL 训练的无教材基线和固定检索基线,并迁移到长上下文基准,在 BrowseComp-Plus 上提升 1.7 分,在 CL-bench 上提升 2.3 分。
引言
大型语言模型在预训练期间获得广泛的参数化知识,检索增强生成或搜索工具在推理时扩展其获取外部信息的途径,但解决陌生问题还需要理解新原理并将其整合到正在形成的解答中。先前工作通过检索训练的 agent、上下文学习研究以及元 RL 或测试时适应等方式处理相关环节,但对长篇幅参考材料的持续自主学习仍然探索不足。作者形式化了一种基于教材的数学问题求解任务,模型必须在构造习题解答的同时学习定义、定理和证明。其主要贡献是使用 BookNavigator 接口和细粒度强化学习的训练框架,该框架带有退火探索奖励和轮次级工具信用,能够在未见教材、未见学科以及非数学复杂上下文任务上带来可迁移的自学习改进。
数据集
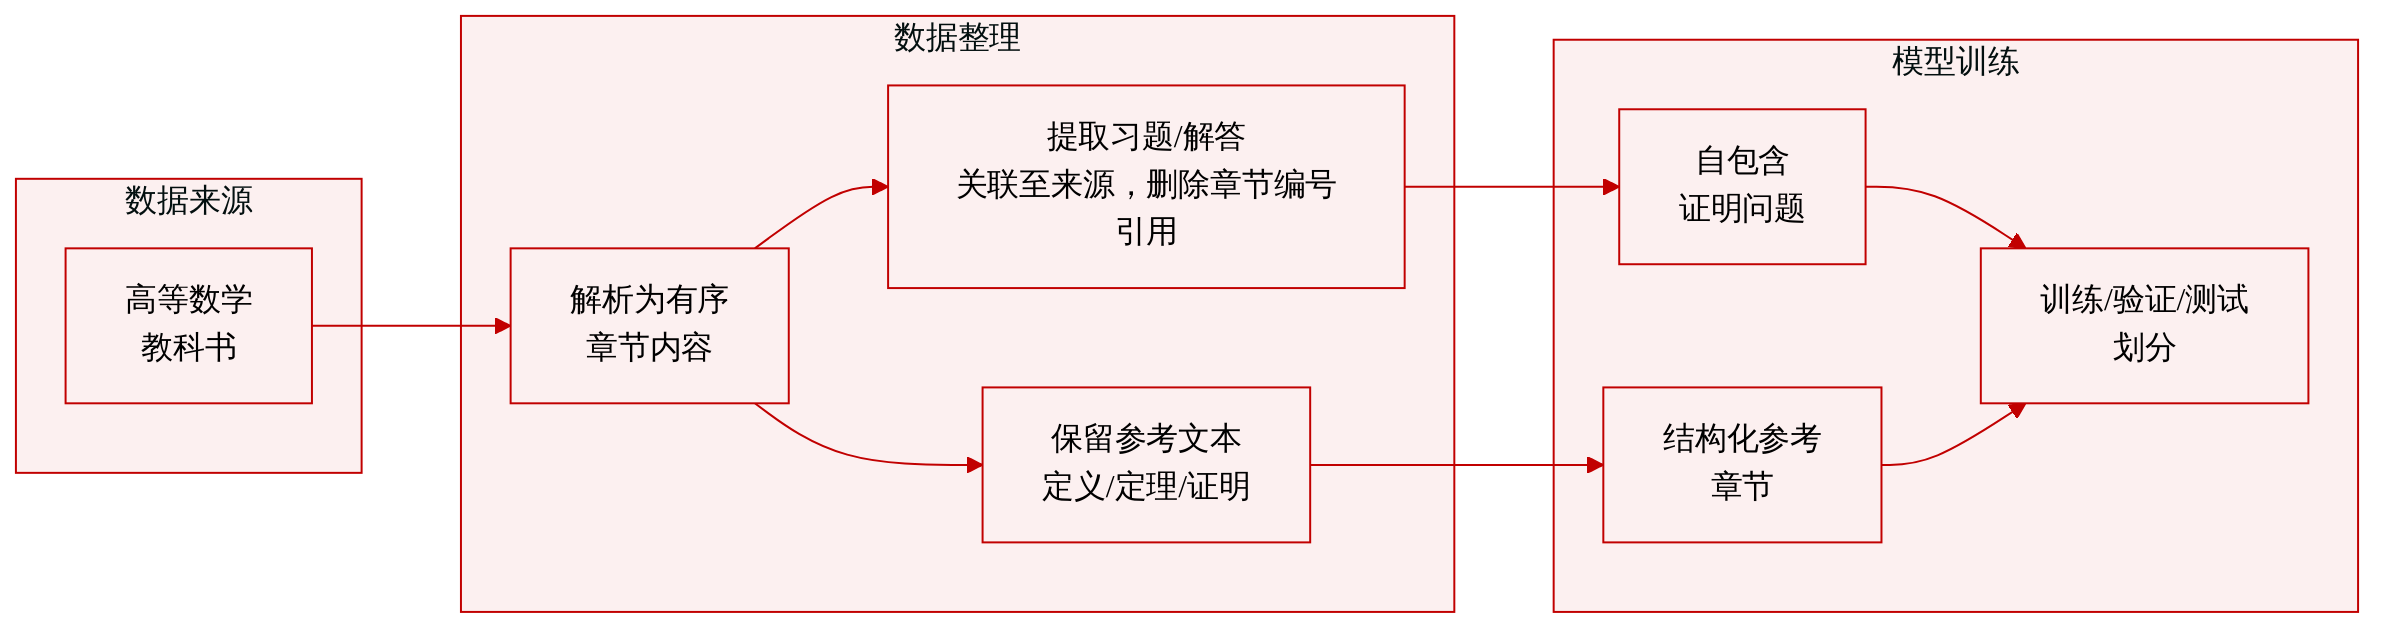
作者从高等数学教材构建证明问题数据集。
-
来源与构成
- 数据集由高等数学教材构建。
- 包含两个主要部分:
- 从习题中提取的证明问题,并与解答配对。
- 从教材说明性内容中保留的结构化参考资料,包括定义、定理、解释性段落和一般性结论的证明。
-
处理与过滤
- 每本教材被解析为按章节索引的文本序列。
- 层级组织得以保留,使各节可以按顺序导航和阅读。
- 习题和解答从说明性内容中单独提取,并链接到来源教材。
- 明确引用教材章节号的习题被排除。
- 该过滤旨在使问题表述自包含。
-
模式与结构
- 模型可见的教材表示为一个有序的节序列。
- 每个节存储为三元组:节标识符、标题和保留文本。
- 形式化地,教材写成一个有序的节列表,每个节包含标识符、标题和正文。
-
在模型中的使用
- 保留的教材节作为问题求解期间可用的结构化参考资料。
- 证明问题被设计为需要慎重的自主研究,而不是简单的答案检索。
- 论文在本节未给出明确的混合比例或划分规模。
方法
作者在基于教材的数学问题求解框架中形式化了自学习,模型通过多轮推理和结构化教材学习来构造自包含证明。整体流程和训练循环在框架图中展示。
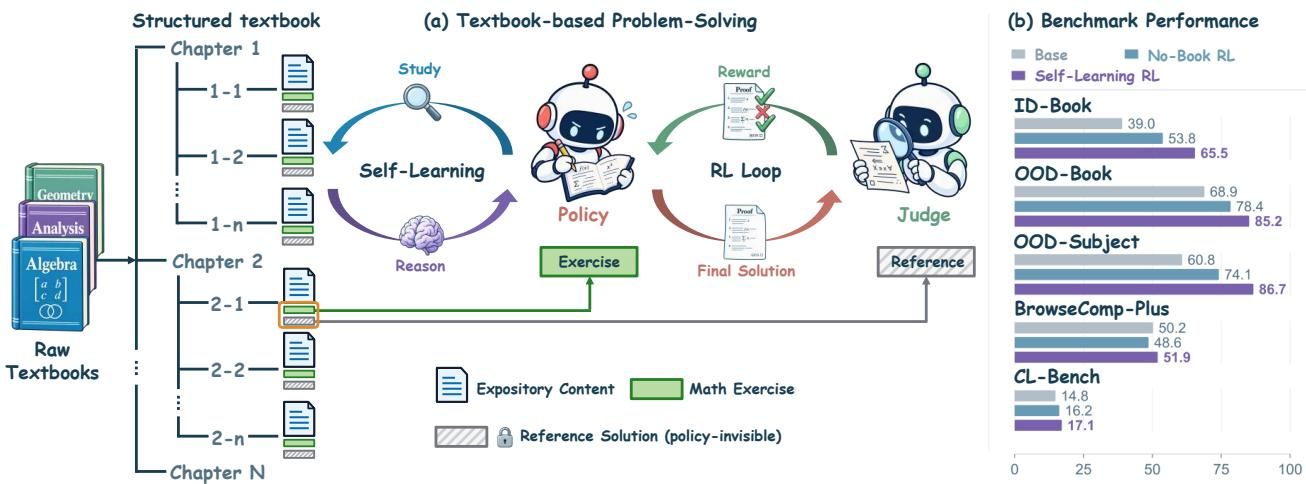
为建立学习环境,作者使用端到端流程从原始教材中整理问题-教材对。每本教材被解析为按层级排列的节序列,保留定义、定理和解释性段落,同时将习题及其解答分离。模型可见教材 B 表示为一个有序的节序列 sk=(ιk,ℓk,xk),其中 ιk、ℓk 和 xk 分别表示节标识符、标题和文本。这种结构化格式确保任务需要慎重的自主研究,而不是简单的答案检索。
给定问题 q 和结构化教材 B,策略 πθ 在多轮中与环境交互。在每个非终止轮 t,模型生成推理 zt 并从教材访问动作空间 A 中执行动作 at,获得观测 ot。交互轨迹在第 T 轮结束,并给出最终证明 y^。y^ 的正确性由 LLM-as-judge 对照保密的参考解答 y⋆ 进行评估,产生二元奖励 r(τ)∈{−1,1}。
为了便于有效的教材导航,作者设计了 BookNavigator,它作为策略与教材之间的唯一接口。它支持三种操作:通过 get_toc 获取目录以实现全局定位,通过 search_index 进行基于关键词的检索以定位相关节,通过 read_section 详细阅读特定节的完整文本。这样模型可以在数学推理与有针对性的信息检索之间无缝交替。
为了优化策略,作者改进了强化学习过程,使用细粒度奖励来鼓励有效探索并惩罚冗余访问。他们为正确解答的轨迹引入退火探索奖励 b(τ),将其加到轨迹级奖励 Rn(τ)=r(τ)+βnb(τ)I[r(τ)=1] 上,其中 βn 按余弦调度变化,以在整个训练过程中维持探索。此外,为了区分有用的教材学习和无效交互,工具评判器评估每一轮并赋予信用标签 ct∈{useful, neutral, harmful}。该轮级信用用于重新分配轨迹级优势 A,为每一轮计算细化优势 At=A+α∣A∣(ct−cˉ)。然后使用包含这些重新分配优势的 GRPO 目标优化策略,确保学习信号准确反映每个教材访问决策的质量。
实验
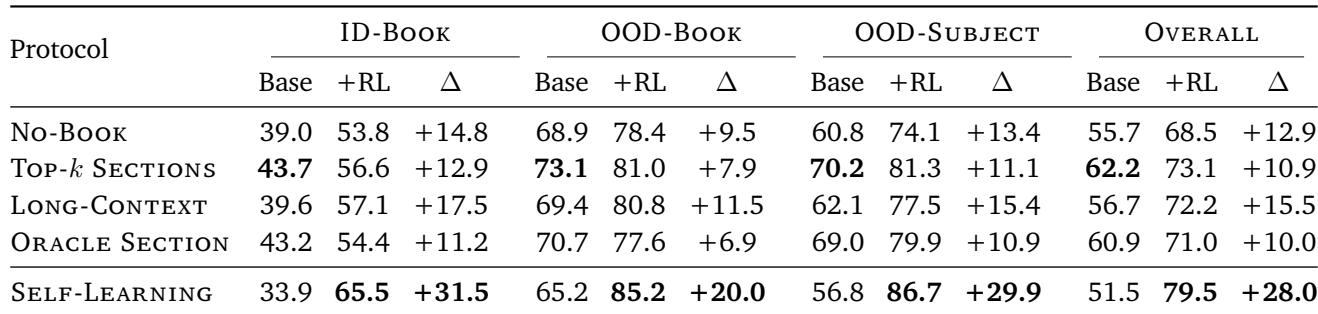
实验使用 GRPO 在来自 158 本数学教材的 5,183 个问题上训练和评估一个 35B 模型,比较交互式自学习协议与无教材和固定检索基线,在留出教材、学科和跨任务基准上进行评估。自学习协议交替进行推理和 BookNavigator 访问。主要结果表明,强化学习扭转了自学习最初的劣势,使其成为整体上及在域外教材和学科上最佳协议,而归因分析表明提升来自更强的无辅助推理和稳健的知识获取,而不是对特定来源节的记忆。跨任务评估发现可迁移到 BrowseComp-Plus 和 CL-bench,但提升具有选择性;RL 消融显示,轮级工具信用改善域内学习,而退火探索奖励保持工具使用并改善跨域迁移。
在 RL 之前,自学习在所有被评估协议中的整体证明准确率最低。RL 之后,它取得了最高整体准确率和最大绝对提升,超过固定检索基线和无教材检索。在分布外教材和学科上,自学习仍然是最准确的协议,表现出超越训练特定教材和学科的迁移。自学习从 RL 前最弱的整体协议转变为 RL 后最强的协议,提升幅度在所有协议中最大。在分布外教材和学科划分上,经过 RL 训练的自学习明显优于最佳固定检索基线。
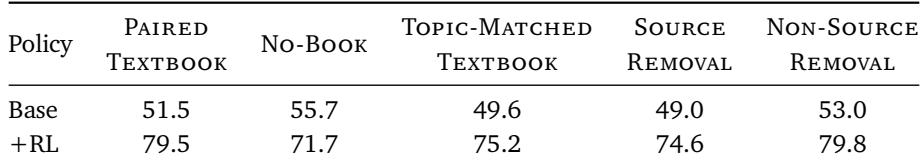
自学习 RL 在所有测试的参考条件下都提高了证明准确率,包括在无教材可用时也有显著提升,表明无辅助推理能力更强。训练后的策略在有教材访问时仍优于无教材时,并且在教材被替换或来源节被删除时仍保持高于无教材的准确率。删除来源节比删除相当的非来源节降低更多准确率,表明性能取决于可用内容,而不仅仅取决于内容是否缺失。RL 在包括无教材设置在内的每种参考条件下都提高了准确率。训练后的策略在有配对教材时优于无教材时,因此参考访问在无辅助推理之外继续带来帮助。在主题匹配教材或来源删除后,准确率仍高于无教材水平,表明知识获取具有灵活性。来源删除导致的下降大于删除非来源节,表明被删除材料的位置很重要。
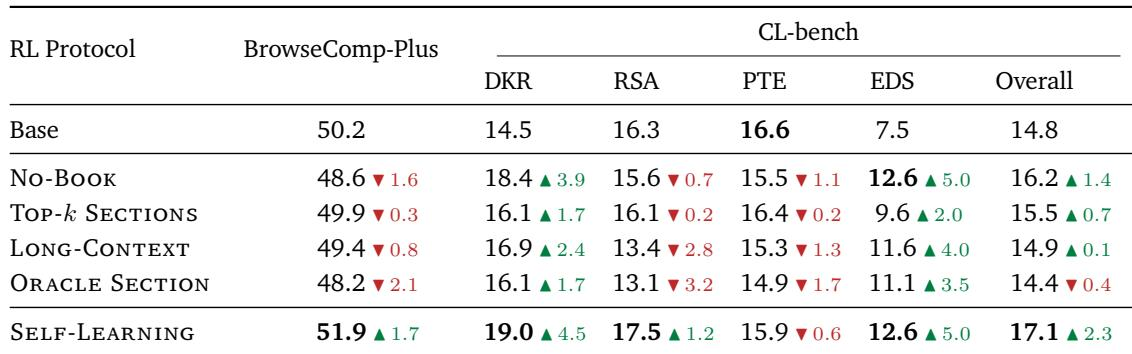
自学习是唯一在 BrowseComp-Plus 和整体 CL-bench 上均优于 Base 的被评估协议,并且获得最大的整体 CL-bench 提升。其优势具有选择性,集中在领域知识推理和规则系统应用上,并在经验发现和模拟上与 No-Book 持平。然而,所有经 RL 训练的策略在程序性任务执行上都低于 Base,固定检索协议在 BrowseComp-Plus 上往往低于 Base,在整体 CL-bench 上低于 No-Book。自学习在被评估策略中取得最高的 BrowseComp-Plus 和整体 CL-bench 分数,在这两个基准上均优于 Base。固定检索协议在 BrowseComp-Plus 上仍低于 Base,在整体 CL-bench 上低于 No-Book,表明跨任务泛化有限。在 CL-bench 内部,自学习在领域知识推理和规则系统应用上领先,并在经验发现和模拟上与 No-Book 持平。所有经 RL 训练的策略在程序性任务执行上低于 Base,表明迁移收益具有选择性。
仅使用正确性奖励的强化学习提高了证明准确率,但显著减少了工具使用,仅添加工具信用无法扭转这一下降。添加退火探索奖励大幅增加使用工具的轨迹比例并改善域外准确率,而将工具信用与探索奖励结合可在每个划分上获得最强准确率。结果表明,过程级信用和探索激励在改善泛化方面发挥互补作用。仅使用正确性奖励的强化学习提高了整体证明准确率,但大幅降低了使用工具的轨迹比例和平均工具调用次数。添加工具信用无需更强的工具评判器即可改善域内教材准确率,但域外准确率几乎不变。探索奖励显著增加使用工具的轨迹并改善域外准确率,与工具信用结合后在所有划分上取得最佳性能。
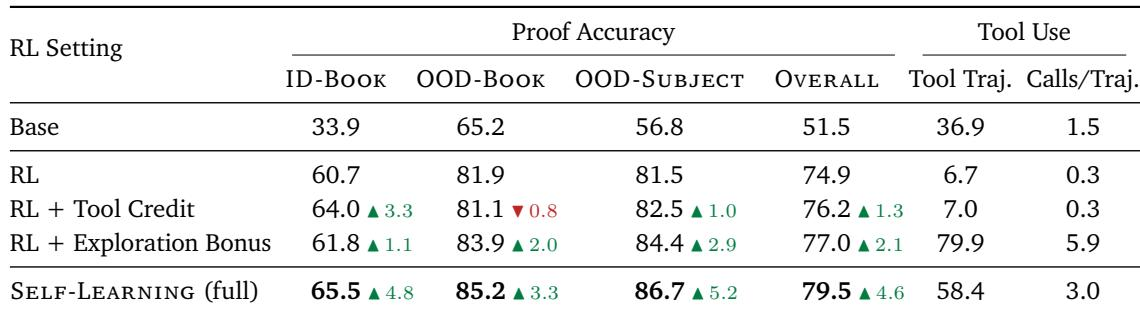
实验评估了自学习 RL 协议与固定检索和无教材基线,在证明准确率、参考条件扰动、跨任务基准和奖励设计消融方面进行比较。自学习从 RL 前最弱的协议转变为 RL 后最强的协议,在包括无教材和来源删除设置在内的每种参考条件下都提高了准确率,并最好地迁移到分布外教材和学科。在更广泛的基准上,它取得了最高的 BrowseComp-Plus 和整体 CL-bench 分数,并具有选择性收益,但程序性任务执行仍然是一个弱点。仅使用正确性奖励的 RL 提高了准确率但抑制了工具使用,而将工具信用与退火探索奖励结合可恢复工具使用行为并产生最强的泛化。