Command Palette
Search for a command to run...
迈向 AGI 的规模扩展是否取决于 System-1 允许 System-2 执行的内容?
迈向 AGI 的规模扩展是否取决于 System-1 允许 System-2 执行的内容?
摘要
通往通用人工智能(AGI)的进展在很大程度上依赖于对资源密集型执行系统 System-2 进行扩展,包括使用更大的模型、更多的数据与算力、更长的推理过程以及更多的智能体。我们探讨下一阶段是否可能转而来自将其与 System-1 协同设计;System-1 是一种轻量级、具有语义感知能力的预测器,在执行前评估候选交互,从而使 System-2 仅执行那些值得付出相应代价的交互。我们的回答是有保留的肯定。我们研究了条件交互,即一个“预测—门控—执行—更新”循环:System-1 估计每个候选交互的效用,System-2 执行由自适应阈值接纳的那些交互,执行结果再更新 System-1。该循环覆盖训练、测试时推理、自适应决策和智能体工具使用,其中效用与成本由具体应用定义。在理想筛选和执行成本相等的条件下,执行计算量按接近 1/ρu 的因子下降(即降至原来的约 ρu 倍),其中 ρu 是与效用相关的交互密度(当成本不同时按成本加权);预测误差、探索和分布偏移会降低这一节省。我们用预测器误差和效用裕度给出了选择遗憾的上界。这些结果支撑了我们的核心假设:ρu 是扩展效率的一个可度量坐标,并使得信息性计算比总计算更能刻画扩展。
一句话总结
来自清华大学和 THU-IDM 的研究者提出了 conditional interaction,一种 predict-gate-execute-update 循环;在该循环中,轻量级 System-1 预测器在训练、推理、决策和 agentic 工具使用过程中对 System-2 的执行进行门控。在理想筛选条件下,执行计算量趋近于 1/ρu,,从而使 ρu 成为可测量的扩展效率坐标,并使 informative compute 成为比总计算量更好的度量指标。
核心贡献
- 论文提出了一个 conditional interaction 框架:轻量级 System-1 预测器估计候选交互的效用,自适应门控只放行与效用相关的交互,高成本 System-2 执行被准入的动作;这一 predict-gate-execute-update 循环被应用于训练、测试时推理、决策和 agentic 工具使用中。
- 在给定假设下,论文提供了理论支持,包括筛选与 memory 结果、regret 界、测试时与 agentic 成本界以及协同扩展结果;此外还给出了应用层面的证据,表明预测式 prompt 与任务采样可以降低执行计算量,理想筛选节省量接近 1/ρ_u 的因子。
- 论文将 ρ_u,即效用相关交互的密度,确定为可测量的扩展效率坐标,并提出 informative compute 是比总计算量更好的扩展描述量;ρ_u 的衰减曲线以及计算最优的 System-1/System-2 划分被列为具体的后续工作。
引言
近期通向通用人工智能的进展主要集中在扩展模型容量、数据、计算量以及资源密集型 System-2 推理上;但随着前沿模型和多 agent 系统不断增长,每次交互的成本正成为限制因素。作者认为,简单增加交互次数是低效的,因为边际收益递减、高质量数据有限,而且许多交互,例如具有均匀奖励的 RLVR rollout 或对已掌握任务进行模拟 rollout,会消耗资源却几乎不产生学习信号。此前的工作往往在执行后再过滤,或在任务空间中随机采样,从而为无信息交互承担全部成本。作者引入 conditional interaction 作为一种协同设计原则:轻量级 System-1 在执行前预测候选交互的效用,高成本 System-2 只运行那些高于资源感知阈值的交互,而 System-2 的结果会改进 System-1。作者提出,效用相关交互密度 rho_u 是将计算和数据转化为数字训练、物理适应和测试时推理能力的核心效率指标。
方法
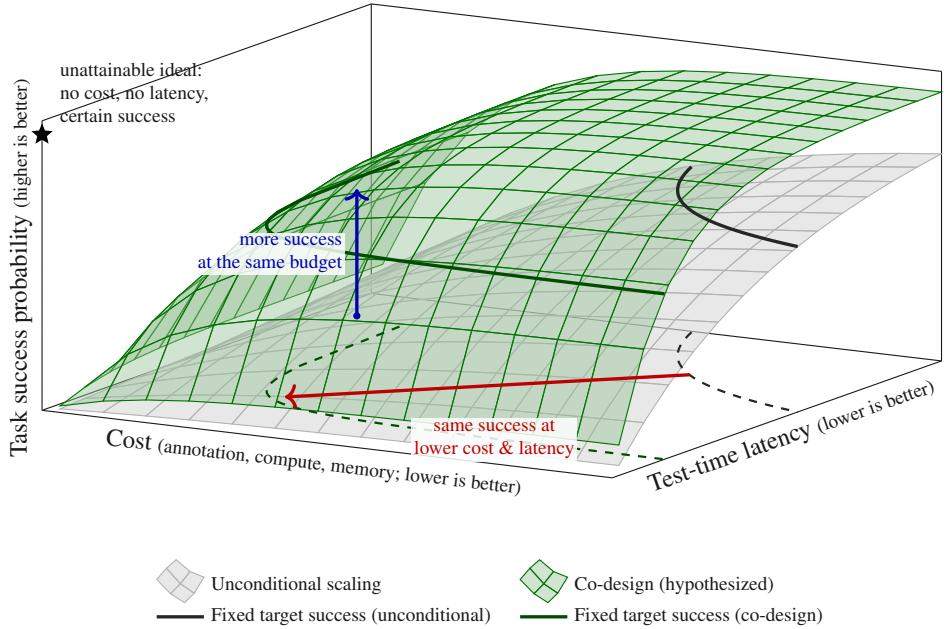
作者提出将 conditional interaction 作为一种协同设计策略:一个轻量级、具有语义感知能力的模块(System-1)预测候选交互的效用,而资源密集型模型或 agent(System-2)只执行超过阈值的交互。这对协同设计系统的目标是在成本、延迟和任务成功率上主导帕累托前沿,在相同预算下实现更高的成功率,或在相同成功率下实现更低的成本和延迟。
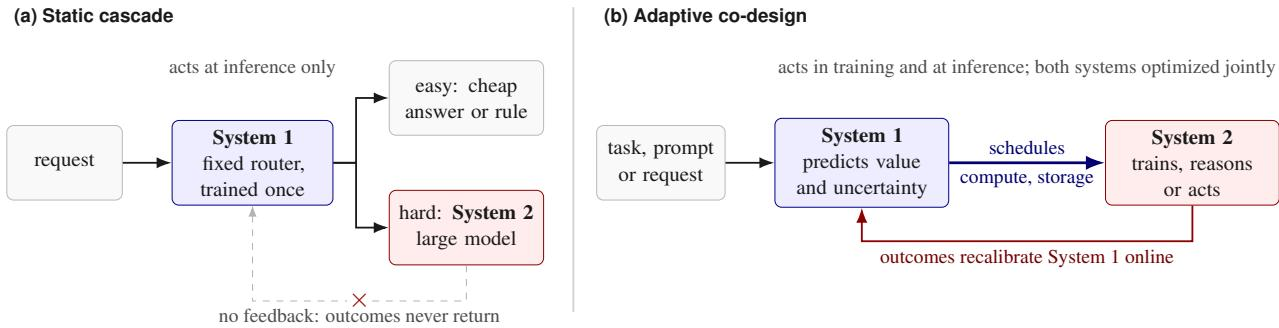
这些系统的配对可以构建为静态级联,也可以通过自适应协同设计实现。在静态级联中,快速模型仅在推理时路由一次请求,而不接收大模型结果的反馈。相比之下,自适应协同设计允许 System-1 在训练和推理期间调度 System-2 的计算与存储。System-2 的结果会在线持续重新校准 System-1,从而确保预测器跟踪不断演化的执行系统。
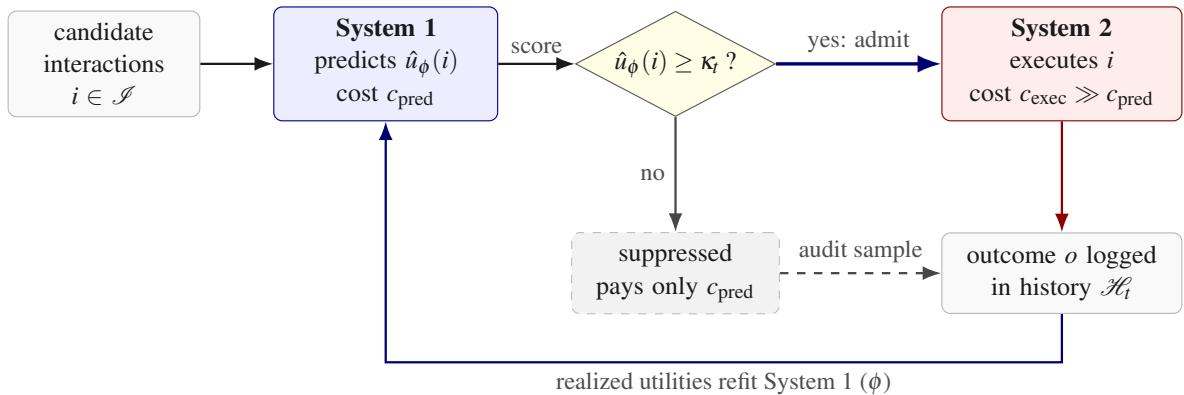
核心接口是 predict-then-gate 架构。System-1 以较低成本 cpred 为每个候选交互打分。阈值 κt 只允许那些被预测为对 System-2 有信息量的候选进入,由 System-2 以远高于 cpred 的成本 cexec≫cpred 执行这些候选。被抑制的候选只产生预测成本,同时会执行被抑制候选中的少量审计样本,以检测预测器的遗漏。已执行结果中获得的实际效用会被记录,并用于重新拟合 System-1。
该分解通过四个领域无关的组件实现。首先,候选对象,如 prompt、任务、查询和工具调用,被嵌入潜在空间。其次,System-1 以低成本预测每个候选的价值和不确定性。第三,选择策略对候选进行门控,只准入得分超过阈值 κt 的候选;该阈值由控制器调整,以维持目标准入率。第四,已执行的交互会被验证、记录并用于重新拟合 System-1,而 System-2 从相同结果中学习。该架构由三个接口支持:用于将 System-2 的解决方案蒸馏到 System-1 的知识接口、用于共享特征的表示接口,以及用于监督信号的反馈接口。
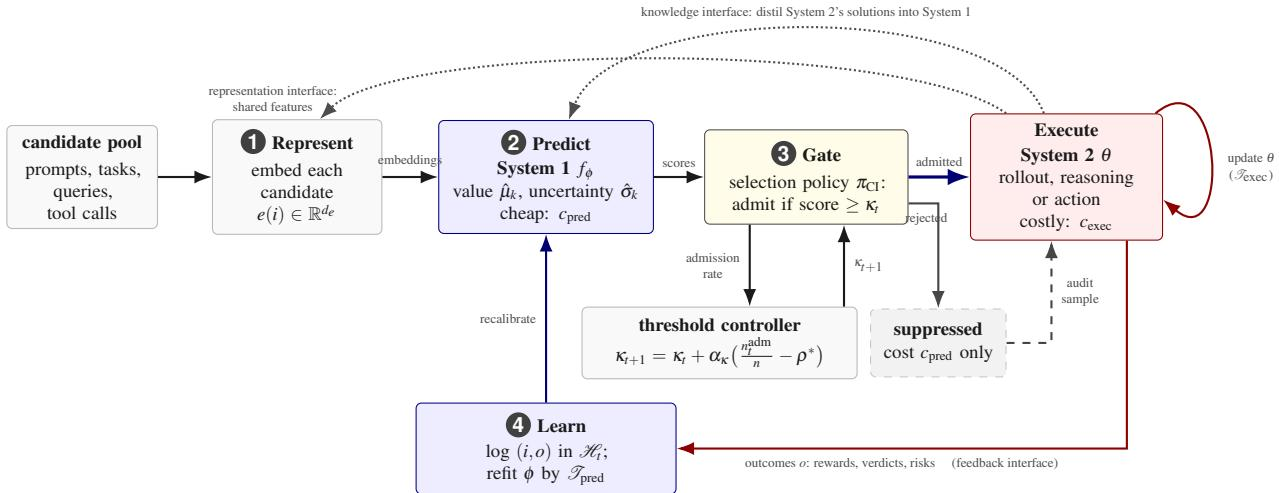
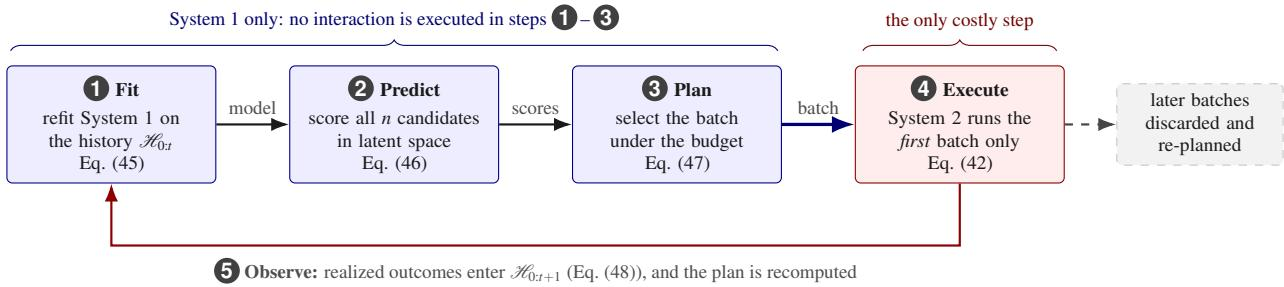
作者将这一闭环框架描述为对学习被控对象进行滚动时域控制。过程开始时,先基于过去交互历史重新拟合 System-1。随后 System-1 在潜在空间中为所有候选打分。接着,求解一个带预算的选择计划,以选择最优批次。只有第一批会由 System-2 执行,因为这是唯一高成本步骤。最后,实际结果进入历史,计划被重新计算。前三个步骤不在环境中执行任何动作,但需要计算;只有当这些预测步骤足够便宜时,循环成本才由执行主导。
实验
本节比较预测式采样与反应式 execute-then-filter 评估。结果表明,当有用候选稀疏且筛选成本低时,对低成本 embedding 进行预测式筛选可以大幅降低执行成本,而实际收益受筛选误差限制。结果还表明,预测式打分消除了 rollout 内存对候选池大小的限制,从而可以在固定内存下使用更大的候选池。Regret 分析证实,当预测误差小于效用差距时,选择是无损的;一旦误差超过该差距,regret 会随着预测误差和盲点候选而增大。
单一 conditional interaction 模式在数字训练、物理训练、测试时推理和 agentic 使用中反复出现:每次交互都包含执行,门控会准入那些预测价值超过特定场景阈值的动作。选择逻辑是共享的,但效用、学习动态和所节约的资源因场景而异,从训练期间的梯度和驱动,到测试时的推理计算量,再到综合 agentic 成本。在所有四种场景中,执行都是每次交互的一部分,而不是一个独立阶段。门控阈值因场景而异,但在各列中具有类似含义:从信息样本率和风险阈值,到停止阈值和调用/提交阈值。所节约的资源从训练计算量或物理保真度与驱动,转变为推理计算量,再进一步转变为 agentic 使用中由延迟、花费、tokens 和风险组成的综合资源。
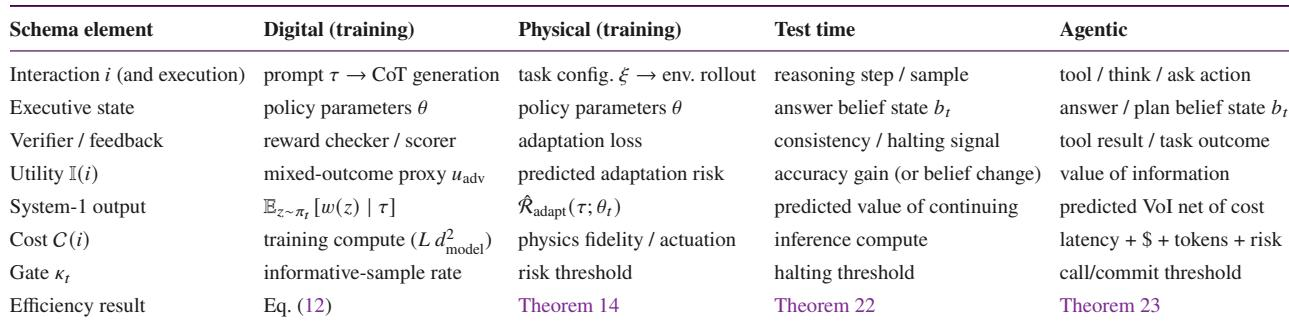
实验比较了数字训练、物理训练、测试时推理和 agentic 使用,表明四者共享同一个 conditional interaction 模式:执行是每次交互的一部分,基于价值的门控会准入高于特定场景阈值的动作。各场景中的门控阈值具有类似含义,从信息样本和风险阈值到停止阈值和调用/提交阈值。所节约的资源也因场景而异:从训练期间的梯度和物理驱动,到测试时的推理计算量,再到 agentic 使用中由延迟、花费、tokens 和风险组成的综合资源。