Command Palette
Search for a command to run...
用 JEPAs 证明并改进柏拉图表示假说
用 JEPAs 证明并改进柏拉图表示假说
Randall Balestriero Yann LeCun
摘要
不同模态上训练的模型是否会收敛到相同的世界表示,是人工智能的核心问题。柏拉图表示假说(PRH)推测,随着模型规模扩大,它们会收敛到相同表示;但缺少证明使其既无法提供保证,也无法提供方法。我们将该假说转化为定理。首先,我们证明了一个柏拉图表示定理:在任意数量模态上分别训练的联合嵌入预测架构(JEPAs),当其正样本对是同一场景的两个观测——即好视图——且在其他情况下失配程度有界时,所学的表示相同,至多相差一个旋转。其次,我们证明下一 token 预测是一种具有坏视图的 JEPA,其视图是单个文档的片段,这解释了为什么语言模型只能通过规模与视觉对齐。第三,我们验证了该理论,实验覆盖从 145k 条图像描述到 9.4 亿张网络图像的文本,并发现一条对齐缩放定律,能够在种子噪声范围内预测未见过的训练运行。在相同语料库上,好视图达到相同对齐程度所需的训练样本比下一 token 预测少 42 倍;一个 109M 参数的文本 JEPA 与 DINOv2 和 CLIP 的图像编码器对齐效果优于我们评估的所有语言模型(参数量高达 72B),也优于 CLIP 的文本编码器:下一 token 预测是通向柏拉图表示的一条效率极低的路径。作为示例,一个旋转即可将分别训练的编码器变为图像描述生成器(在 COCO 上 CIDEr 为 .838)。即便该旋转也不需要成对数据:在最新的无成对数据基准上,我们的文本 JEPA 超过了所有已报告的、使用高达 8B 参数语言模型得到的零样本准确率,例如在 ImageNet-100 上 top-5 准确率为 64%,而最高仅为 56%。因此,好视图——而非仅仅依赖规模——才是构建柏拉图表示的关键杠杆。
一句话总结
来自布朗大学、纽约大学和 AMI Labs 的研究者证明了一个柏拉图表示定理:在任意数量的模态上、使用良好视图分别训练的联合嵌入预测架构(JEPA)会学到只差一个旋转的相同表示;他们还证明,next-token 预测是一种具有坏视图的低效 JEPA,并且通过一个 109M 参数文本 JEPA 在对齐和零样本基准上优于最高 72B 参数的语言模型来展示这一点。
核心贡献
- 一个柏拉图表示定理证明:当正样本对是同一场景的两个观测,且其他情况下未对齐程度有界时,在任意数量模态上分别训练的联合嵌入预测架构(JEPA)会学到只差一个旋转的相同表示。
- next-token 预测被识别为一种具有坏视图的 JEPA,其中正样本是同一文档的部分内容;这解释了为什么语言模型只能通过规模来与视觉对齐,实验表明,在相同语料上,良好视图所需的训练样本比 next-token 预测少 42 倍。
- 经验验证覆盖从 145k 条图像描述到 9.4 亿张网页图像,并发现一个对齐的缩放定律,可以在种子噪声范围内预测未参与运行的实验。一个 109M 参数文本 JEPA 与 DINOv2 和 CLIP 图像编码器的对齐程度优于最高 72B 参数的语言模型以及 CLIP 的文本编码器,并且一个学习到的旋转将分别训练的编码器变成 COCO 上 CIDEr 为 .838 的图像描述器;在无配对基准上,该文本 JEPA 还超过了所有已报告的、参数最高 8B 的语言模型的零样本准确率,例如在 ImageNet-100 上 top-5 为 64%,而最高为 56%。
引言
深度网络重新提出一个老问题:同一世界的不同观察者是否会收敛到相同表示。经验上,词嵌入和视觉-语言模型表现出越来越强的跨模态对齐,Huh 等人将这一现象称为柏拉图表示假设,但对于联合嵌入预测架构(JEPA)这类实际自监督目标,这仍只是观察而缺乏证明。作者将这一观察转变为关于 JEPA 的定理。他们证明,当分别训练的 JEPA 使用关联相同世界状态的正样本对时,它们学到的表示只差一个旋转;而当正样本只是破坏单个观测时,编码器会将容量花费在模态特有的干扰因素上,这些干扰因素无法通过旋转对齐。这将该假设重新表述为关于正视图的命题,并给出训练原则;实验结果表明,良好视图 JEPA 比 next-token 预测对齐得更好,并且数据效率更高。
方法
作者通过单射渲染形式化由多个模态观测的世界。针对特定模态的联合嵌入预测架构(JEPA)在从分布中抽取的正样本对上训练。核心目标最小化预测项加上一个防坍缩项。作者证明了柏拉图表示定理,该定理表明,如果多个模态在世界状态上共享相同的正样本对分布,那么它们的编码器学到的世界嵌入只差一个旋转。这对具有二阶防坍缩的谱 JEPA 成立,它们学习由正样本对定义的图的前几个特征向量。
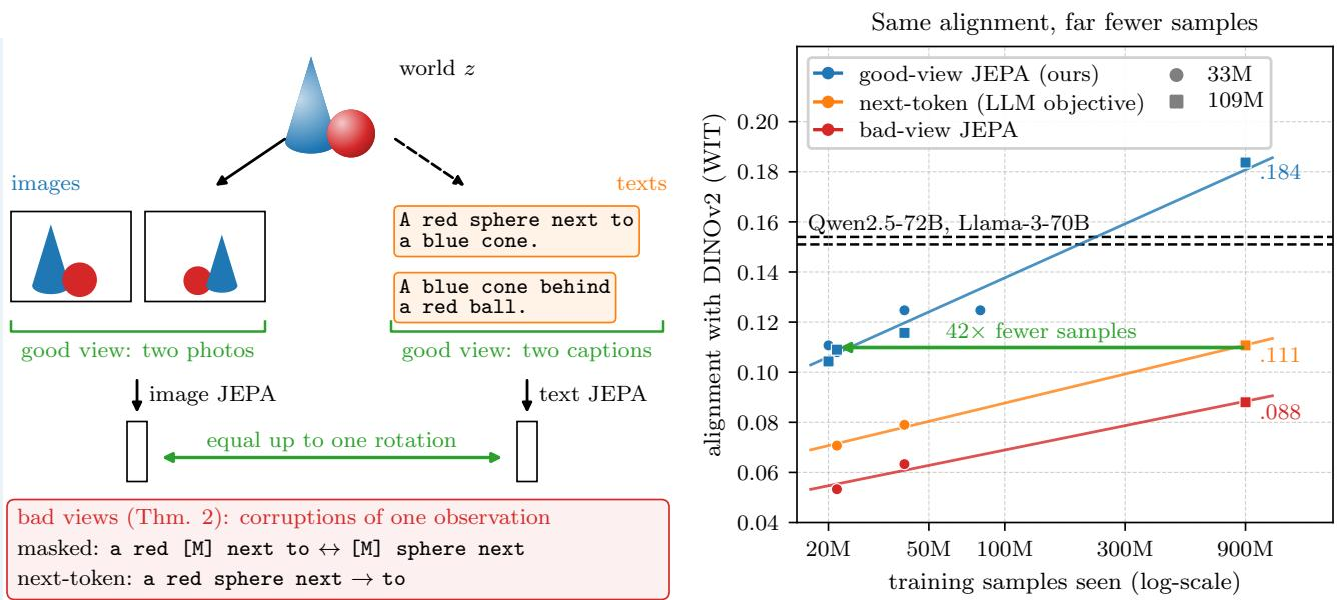
对齐质量关键取决于正样本对的性质。作者区分了良好视图和坏视图 JEPA。良好视图 JEPA 使用由同一世界状态的两个独立观测组成的正样本对,例如同一场景的两张照片或描述该场景的两个图像描述。这些 JEPA 忽略模态特有的干扰因素,仅学习世界状态的函数。坏视图 JEPA 使用由单个观测的破坏构成的正样本对,例如一张图像的两个裁剪或一个句子的两个掩码。这些 JEPA 往往把嵌入维度花费在破坏之间共享的干扰因素上,而这些干扰因素无法通过旋转跨模态对齐。
如下图所示,良好视图通过设计诱导世界自身的核,从而在只差一个旋转的情况下实现完美对齐,而坏视图和 next-token 预测依赖数据密度来连接状态,并且常混入干扰因素。右侧面板表明,一个良好视图 JEPA 与 DINOv2 实现的对齐程度与 next-token 预测相同,但所需样本少 42 倍。
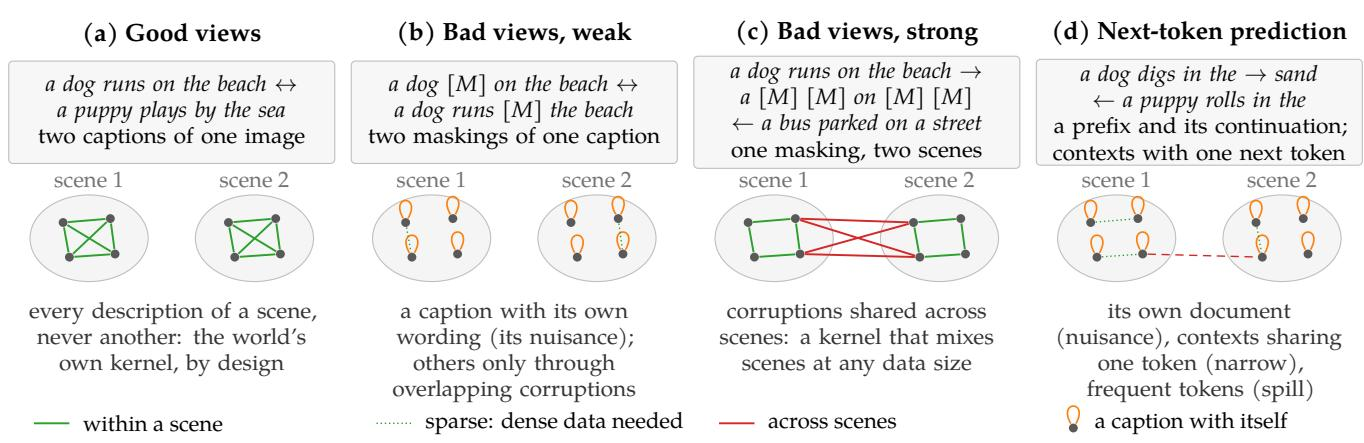
此外,作者说明了不同的正样本对定义如何连接观测。良好视图连接同一场景的所有描述,而不会串到其他场景。坏视图和 next-token 预测则在场景内部建立稀疏连接,或因共享干扰因素而溢出到不同场景之间。
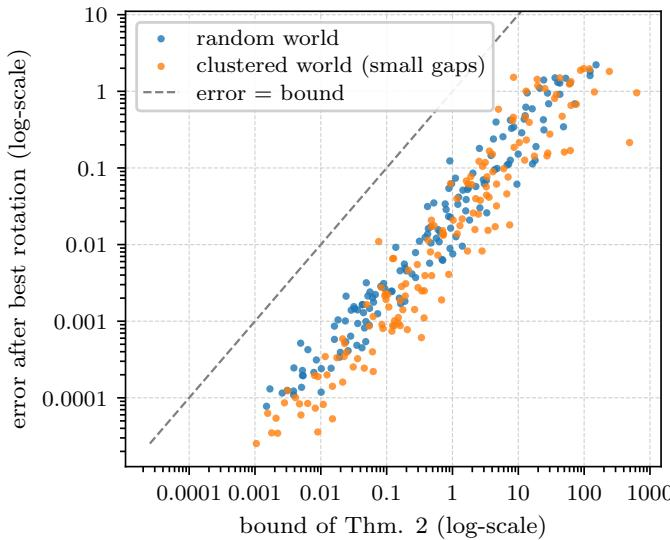
在实际中,不同模态很少共享完全相同的正样本对。作者基于不同模态正样本对所诱导核之间的不匹配,给出了未对齐程度的一个上界。最佳旋转后嵌入之间的均方根距离受核之间的差异和谱间隙约束。
如下图所示,这个上界在随机生成的有限世界上得到了经验验证,误差始终低于理论界限。
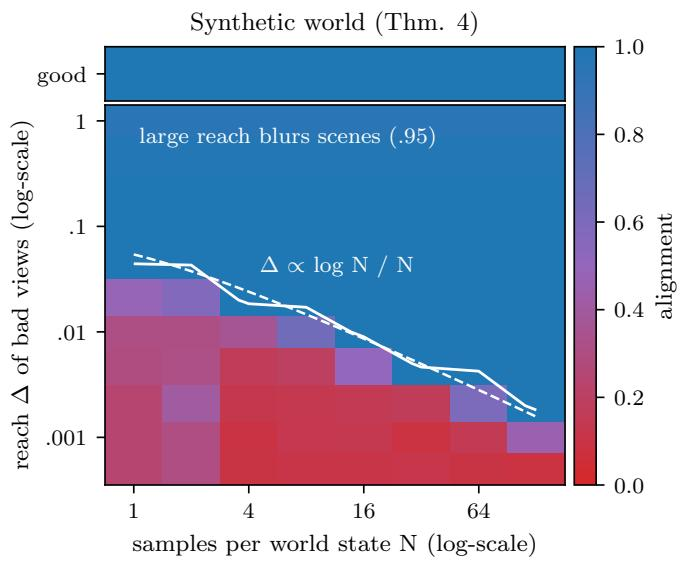
作者还分析了坏视图的覆盖范围与所需数据量之间的权衡。更弱的正样本需要每个世界状态显著更多的样本才能实现对齐,如下图所示。
作者将 next-token 预测形式化为一种 JEPA。其正样本是单个文档中的前缀及其后续内容。由于前缀和后续内容共享该文档特有的干扰因素,next-token 预测表现为一种坏视图 JEPA。它把嵌入方向花费在这种干扰因素上,这解释了为什么与良好视图 JEPA 相比,语言模型需要极大规模才能与视觉模型对齐。
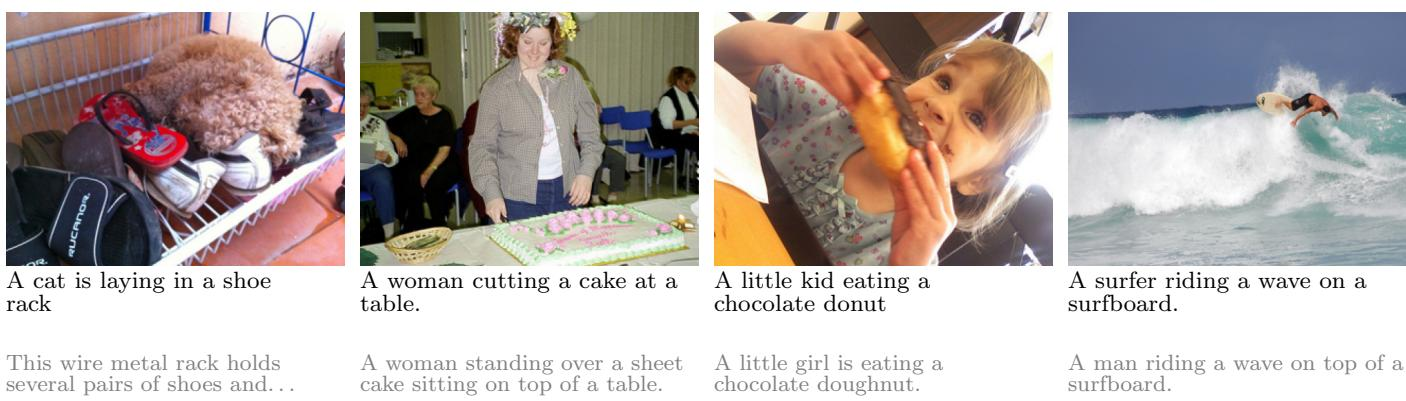
利用表示只差一个旋转这一定理,作者设计了一个无需在图像-描述配对数据上训练网络的图像描述系统。文本 JEPA 和因果 Transformer 解码器仅在文本上训练。图像使用冻结的视觉编码器。通过在一小组图像-描述配对数据上拟合单个旋转矩阵,将冻结的图像嵌入与文本嵌入空间对齐。要为图像生成描述,先将其嵌入,再旋转,然后解码。嵌入中加入高斯噪声以容忍残余对齐误差。
下图展示了该系统在 COCO 测试图像上生成的描述。系统使用仅通过一个旋转连接的冻结编码器,却能准确描述场景、物体和动作。
实验
这些实验评估使用 JEPA 目标分别训练的图像和文本编码器,通过检索、互最近邻和基于旋转的映射,在 Flickr30k、MSR-VTT、COCO 以及大型网页文本语料上测量跨模态对齐。它们验证:从同一世界状态的不同观测中抽取并经过修剪的良好视图,在相同数据上始终比坏视图或 next-token 预测对齐得更好,其中修剪是主要因素,并且两种模态都受益。结果进一步表明,良好视图 JEPA 在样本效率上远超 next-token 预测,优于大得多的语言模型,接近使用成对数据训练的编码器,并且能够在很少甚至没有成对图像-描述监督的情况下实现图像描述和对齐。
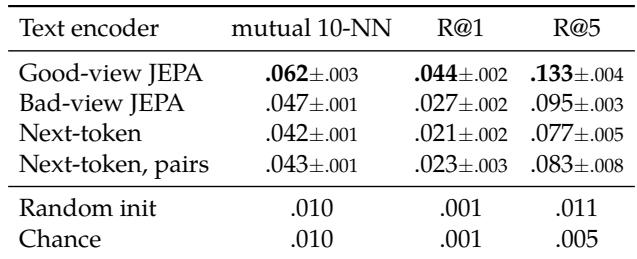
与使用坏视图 JEPA 或 next-token 预测训练的编码器相比,使用良好视图 JEPA 训练的文本编码器在 Flickr 测试对上与图像 JEPA 的对齐更强。这一优势出现在互最近邻重叠和基于旋转拟合的检索指标上。将 next-token 预测用于同一图像的两个图像描述对进行训练,仅略微改善对齐,说明增益来自 JEPA 目标。图像描述视图在 mutual 10-NN、R@1 和 R@5 上优于掩码片段和 next-token 预测,差距大于种子波动。将 next-token 预测用于同一图像的两个图像描述对进行训练,相比标准 next-token 预测几乎没有提升,因此对齐优势来自 JEPA 目标。
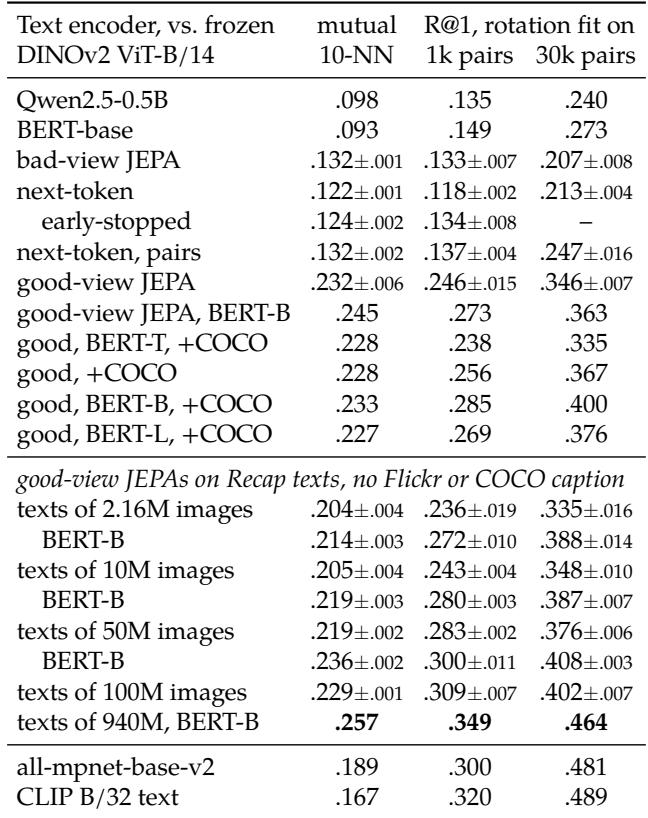
当与冻结的 DINOv2 ViT-B/14 配对时,良好视图 JEPA 文本编码器在所列模型中表现出最强的对齐,检索得分约为坏视图 JEPA 和 next-token 基线的两倍。它在相同指标上也超过了预训练的 Qwen2.5-0.5B 和 BERT-base 文本编码器。在 30k Flickr 训练和验证对上拟合旋转后,检索进一步提升,良好视图 JEPA 仍然是作者模型中最好的。良好视图 JEPA 在所有列出的文本编码器中取得了最高的 mutual 10-NN 和 R@1,在 1k 对上的 R@1 约为坏视图 JEPA 和 next-token 模型的两倍。良好视图 JEPA 对冻结 DINOv2 的检索得分也超过了预训练 Qwen2.5-0.5B 和 BERT-base,并且当旋转在 30k 对上拟合时,其优势进一步扩大。
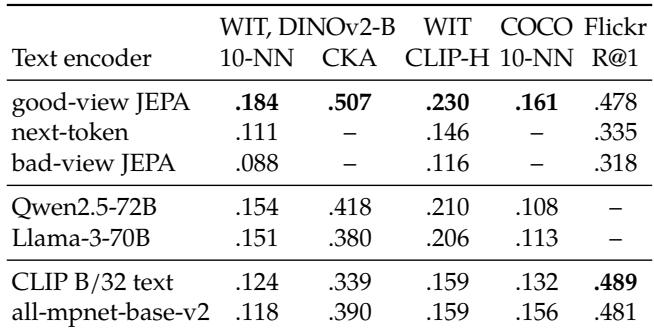
一个在 9 亿条图像衍生文本样本上训练的 109M 参数良好视图 JEPA,与 DINOv2 和 CLIP 视觉编码器的对齐强于最高 72B 参数的语言模型。这一优势出现在 mutual 10-NN、线性 CKA 和 COCO 检索上,而在相同文本上训练的 next-token 预测和坏视图 JEPA 则远远落后。驱动对齐提升的似乎是良好视图目标,而不只是文本数据本身。良好视图 JEPA 在与 DINOv2 ViT-B 和 CLIP ViT-H/14 的 mutual 10-NN 一致性上超过了所有列出的最高 72B 参数语言模型。在相同文本上的 next-token 预测和坏视图 JEPA 远远落后,进一步说明视图设计的作用。
一个 109M 良好视图 JEPA 在无需成对示例的情况下对齐视觉和文本,优于先前的无配对方法,在比较中取得最低的 FOSCTTM 和最高的零样本分类准确率。在相同条件下,它与重跑的 Qwen3-8B 持平或更优,而在相同文本上的 next-token 预测在 FOSCTTM 上接近随机,零样本准确率则差得多。这表明驱动基于几何的对齐的是良好视图 JEPA 表示,而不是 next-token 文本训练。109M 良好视图 JEPA 超过了此前报告的所有无配对对齐零样本准确率,并在这些数据上追平了先前最佳的 FOSCTTM。它在 FOSCTTM 和 CIFAR-10 上与重跑的 Qwen3-8B 持平,在 CIFAR-100 和 ImageNet-100 上以明显优势超过它。坏视图 JEPA 的对齐也远好于 next-token 预测,而在相同文本上的 next-token 预测在 FOSCTTM 和 CIFAR-10 上失败。一个更小的 33M 良好视图 JEPA 仍然超过了先前最佳的无配对零样本准确率。
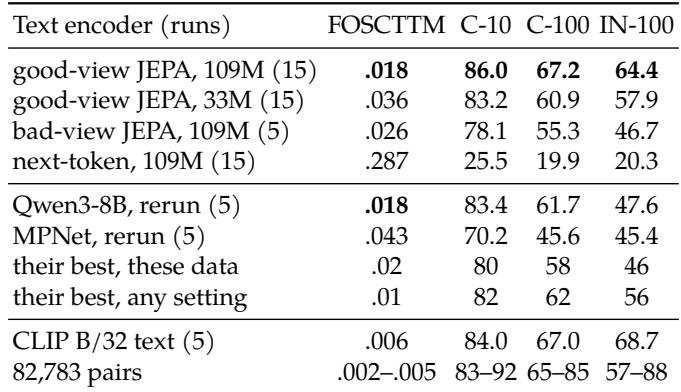
在 Flickr 检索、冻结 DINOv2 对齐、缩放比较和无配对视觉-文本对齐中,作者比较了良好视图 JEPA 文本编码器、坏视图 JEPA、next-token 预测、预训练语言模型和先前的无配对方法。良好视图 JEPA 目标始终带来更强的跨模态对齐和检索,通常超过大得多的语言模型和先前的无配对结果,而 next-token 和坏视图基线仍然较弱。这些收益来自 JEPA 视图设计,而不是文本数据或成对图像描述。