Command Palette
Search for a command to run...
A-RSI:面向零数据多模态自我改进的自适应任务刷新
A-RSI:面向零数据多模态自我改进的自适应任务刷新
摘要
递归式自我改进不仅要求模型获取有用的训练经验,还要求模型判断当前经验何时已不再有用。现有方法通常关注接下来生成何种经验,而对何时引入新经验关注较少。许多方法还通过自一致性或多数投票来构造训练目标,使监督信号依赖于模型自身不确定的预测。我们分别处理这两个问题:训练动态决定何时获取新经验,而新任务的答案保持可独立验证。A-RSI 监控训练日志中的奖励变化与准确率,在任务池学习信号减弱时对其进行刷新,且不参考验证集或测试集分数。一个由模型编写的程序构成的静态库生成多模态问题并推导其参考答案;我们规定了任务生成契约,自动验证奖励与刷新规则的选定性质,并单独审计生成的答案。训练循环不使用外部训练样本或人工编写的答案标签。在主要的 11 个基准套件上,A-RSI 利用 800 个新任务将平均性能从 57.77 提升至 61.05。
一句话总结
香港中文大学的研究人员提出 A-RSI,一种用于零数据多模态自我改进的自适应任务刷新方法,该方法通过监控训练日志中的奖励变化和准确率,在学习信号下降时刷新任务池,使用模型编写的程序生成可独立验证的多模态任务,并借助 800 个新任务将十一项基准的平均分从 57.77 提升至 61.05。
核心贡献
- A-RSI 监控训练日志中的奖励变化和准确率,在学习信号下降时刷新任务池,而无需参考验证集或测试集分数。
- 任务从静态的模型编写程序库中生成,并带有程序计算的参考答案,因此答案正确性不依赖于模型投票;任务生成契约、奖励与刷新属性以及生成的答案均经过验证或审计,且不使用外部训练样本或人工编写的答案标签。
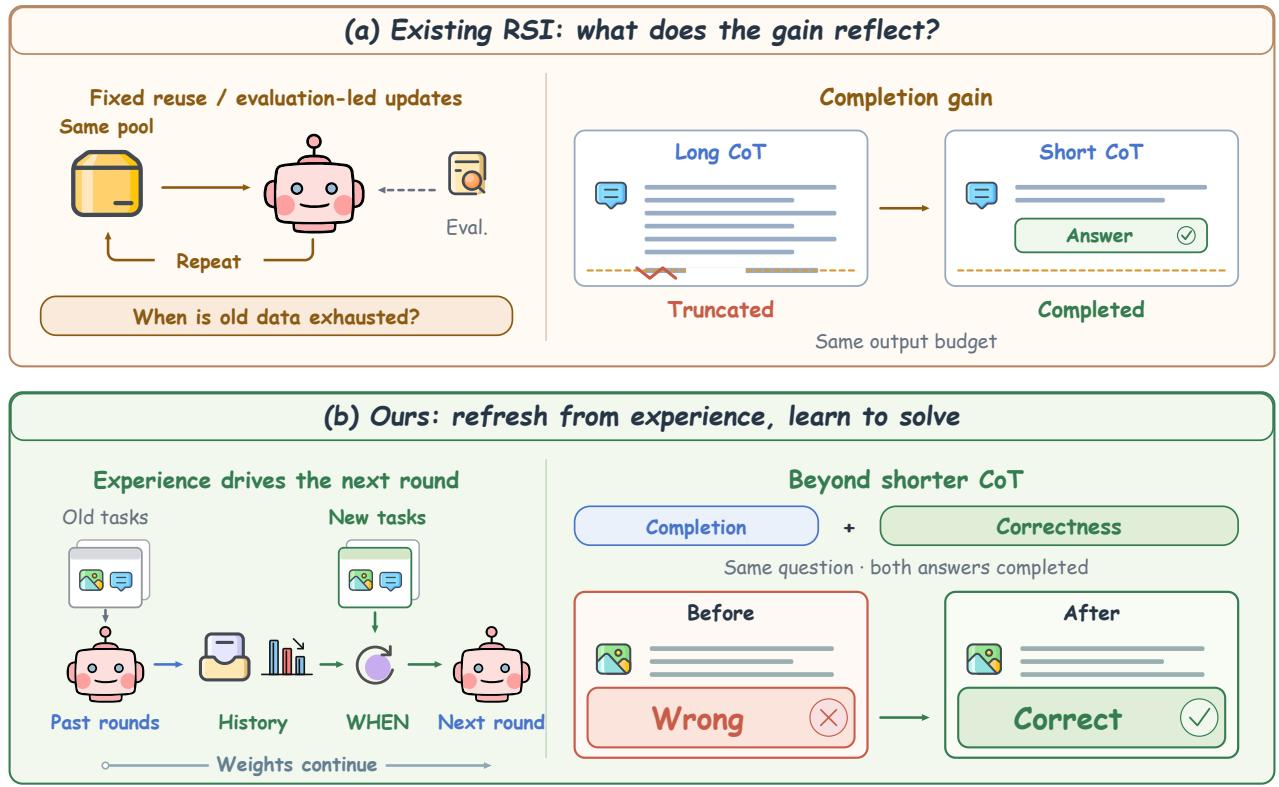
- 在十一项基准套件上,A-RSI 借助 800 个新任务将 Macro11 平均分从 57.77 提升至 61.05;匹配比较显示,基于难度、基于控制器和基于 rollout 的选择器并未优于随机替换,长度预算审计表明部分紧预算增益反映的是模型学会完成输出。
引言
递归自我改进系统既需要有用的经验,也需要一种识别这些经验何时不再有帮助的方法。近期工作强调了下一步生成什么,例如更困难的任务或接近模型能力边界的任务,但往往忽略了另一个独立决策:何时替换当前训练池。保留过时的池会浪费更新,而刷新过于频繁又会不必要地消耗新任务。通过多数投票等方法生成的自生成目标也可能把模型错误转化为训练标签。作者通过引入 A-RSI 来解决这一问题,该方法利用训练日志信号(例如具有组内奖励变化的提示数量下降)来决定何时提取新任务。新任务来自带有独立计算答案的模型编写程序,从而将刷新决策与答案正确性分离,并避免依赖验证集或测试集分数。
数据集

数据集构建与来源
- 作者从几何、图表、表格和计数领域的种子任务类型中构建了一个程序化任务库 T。
- 基础模型生成可复用的问题结构和参数化程序。每个模板指定了可接受的参数、目标量、采样过程、图像绘制、问题构成和答案计算。
- 在生成过程中,模板 τ 和潜在参数 z 产生图像、问题和参考答案:
- 学习器仅接收 (I,q)。参考答案 a 用于评分。
数据集构成与规模
- 生成器组覆盖几何、图表、表格和计数。
- 经审计的已消耗替换池从五个受支持的生成器组中各无放回地抽取 200 个任务,总计 1,000 个经审计任务。这五个组涵盖几何、图表、表格和计数。
- 每个生成器的具体分配和储备池大小在附录 Q.2 中报告。
- 初始替换池来自早期的几何和图表批次,并经过模型辅助的问题重写和检查。
- 在一个比较中,活跃池在替换期间从 500 个任务变为 400 个任务。
处理与过滤
- 候选任务只有在通过生成器特定构建检查 Vτ、新鲜度检查 F、污染筛查 C,且不在诊断保留集 H 中时,才会被纳入合格集合 C:
- 生成器特定检查测试采样配置、答案计算、渲染约束和歧义约束。
- 新鲜度和污染筛查会拒绝被标记的候选任务。
- 保留的诊断项目不参与训练。
- 保留的记录将每个图像、问题和答案与生成器标识和种子关联,以便重建。
- 图像哈希被记录并检查。
- 经审计的图像文件必须能够解码、满足最小尺寸检查且非空白。
- 生成契约要求一个共享的底层配置:
- 独立求解器对所有 1,000 个采样参考答案一致。训练金标准/解值与选定的源记录一致,图像文件哈希与所有 1,000 个经审计任务上的记录哈希一致。
- 重放冻结生成器可逐字节复现 800 个完整图像。对于其余 200 个图表任务,绘图像素和类别/数值轴标签一致,但由于字体差异,完整图像复现仍未解决。
数据使用方式
- 合格集合 C 为继续训练提供替换池。
- 训练使用生成的图像-问题对 (I,q) 作为输入,回答根据程序计算的参考答案 a 进行评分。
- 程序计算的监督仍取决于模板及其答案执行器的正确性。
- 作者比较了新鲜池训练与原始池继续训练。在匹配进度下,新鲜池训练在 Macro11 格式校正基准上得分为 60.40,而原始池继续训练为 58.35,同时活跃池从 500 个任务变为 400 个任务。
- 数据集构建和有效性检查侧重于可验证的数据属性,但论文指出这些检查并不认证生成任务的每一个视觉或语言属性。
方法
作者提出 A-RSI,一个通过程序化任务管道和训练日志控制器支持持续多模态强化学习的框架。整体工作流分为三个相互关联的阶段:预训练准备、主动训练和动态池管理。
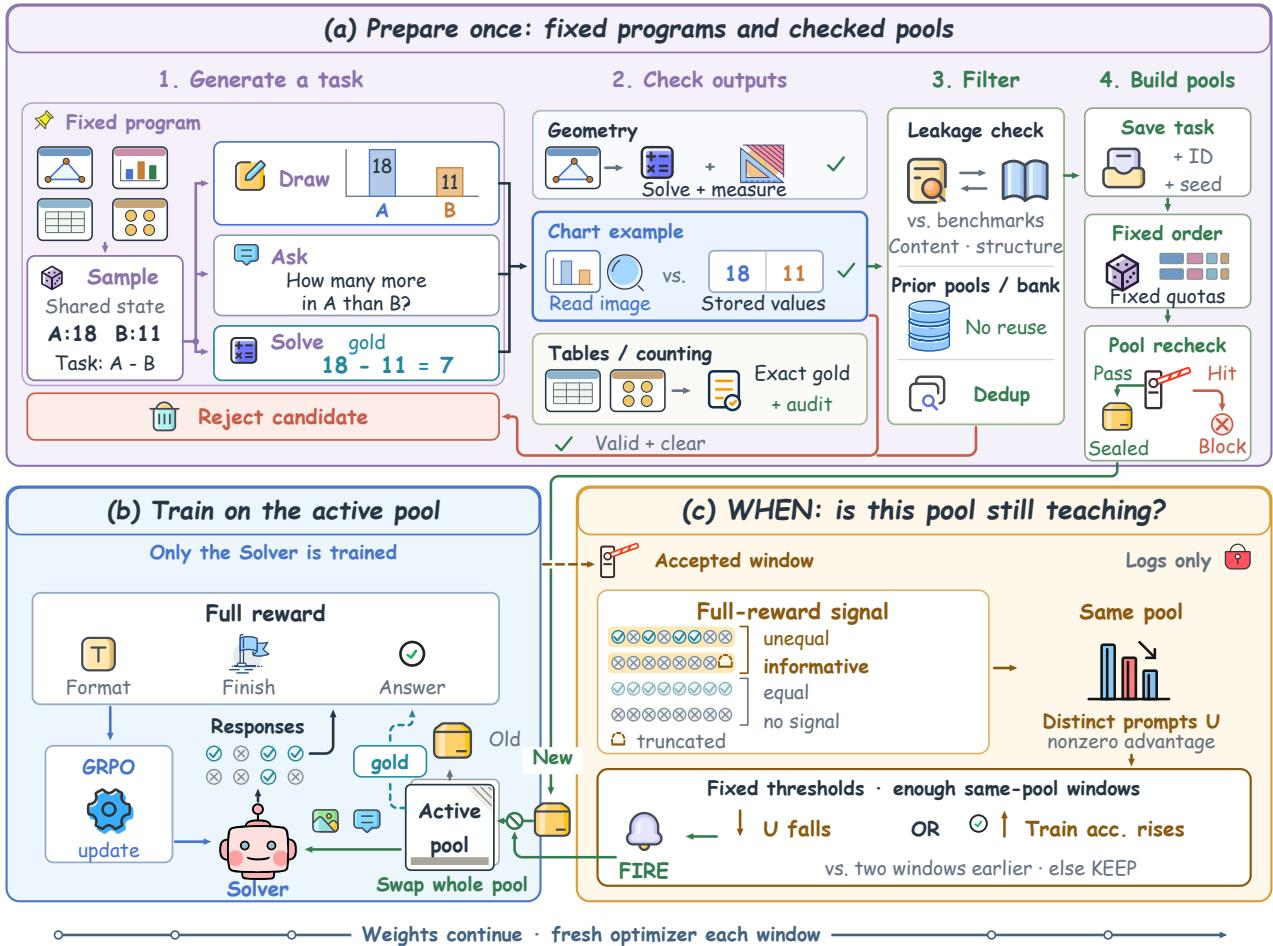
在训练开始之前,系统构建一个固定的可执行任务模板库。对于每个模板,模型指定可接受的参数、条件以及采样值、绘制图像、构成问题和计算答案的过程。然后,管道执行这些冻结模板以生成候选实例。每个候选实例都经过严格的准入检查,包括生成器特定验证、新鲜度筛查和污染检查,以确保数据质量。保留的记录在固定的系列配额下被组织成互不相交的替换池,形成一个合格任务储备库,该储备库在整个训练过程中保持不变。
在训练阶段,仅优化 Solver 策略。对于从活跃池中采样的每个任务,模型生成多个回答。作者采用组相对策略优化(GRPO)基于复合奖励函数更新策略:
r(y,a)=rans(y,a)+λfmtrfmt(y)+λstoprstop(y)其中 rans 评估提取出的答案相对于程序计算参考的正确性,rfmt 强制要求使用规定的方框答案格式,rstop 惩罚异常解码终止。系数 λfmt 和 λstop 在整个训练过程中保持固定。
为了防止模型过拟合静态数据集,框架引入了训练日志控制器来监控池饱和情况。控制器跟踪产生非零相对优势的不同提示数量,记为 Uw,以及回答准确率 aw。总奖励相同的回答组不提供任何策略梯度信号,表明模型已经耗尽当前提示的学习潜力。在每个被接受的训练窗口结束时,控制器将这些信号与 ℓ 个窗口之前的值进行比较。刷新池的决策 δw 在满足最短观察期且非零优势数量降至保留阈值以下或准确率足够提高时触发:
δw={1,0,nw≥nmin and (Uw≤ρUw−ℓ or aw−aw−ℓ≥η),otherwise.当 δw=1 时,系统用从预构建储备库中无放回抽取的 B 个未使用任务替换整个活跃池,并遵守固定的系列配额。关键是,这一替换不会重置模型参数;Solver 从最新被接受的权重继续训练,确保学习经验在窗口之间累积,同时数据分布保持新鲜和具有挑战性。
实验
实验通过在 Qwen 和 MiMo 上跨十一项基准比较刷新策略,评估了多模态模型的零数据 RL 训练循环。实验验证了当饱和检测器触发时刷新训练池并随机采样未使用任务,能够用比固定周期刷新或持续刷新更少的新任务维持学习,而保留旧池最终会停滞。消融实验显示替换选择改进并未优于随机采样,奖励检查发现辅助奖励无法逆转正确性排名,尽管存在解析器漏洞。定性案例研究进一步证实,较晚的检查点能够完成先前被截断的回答并纠正先前错误的答案。
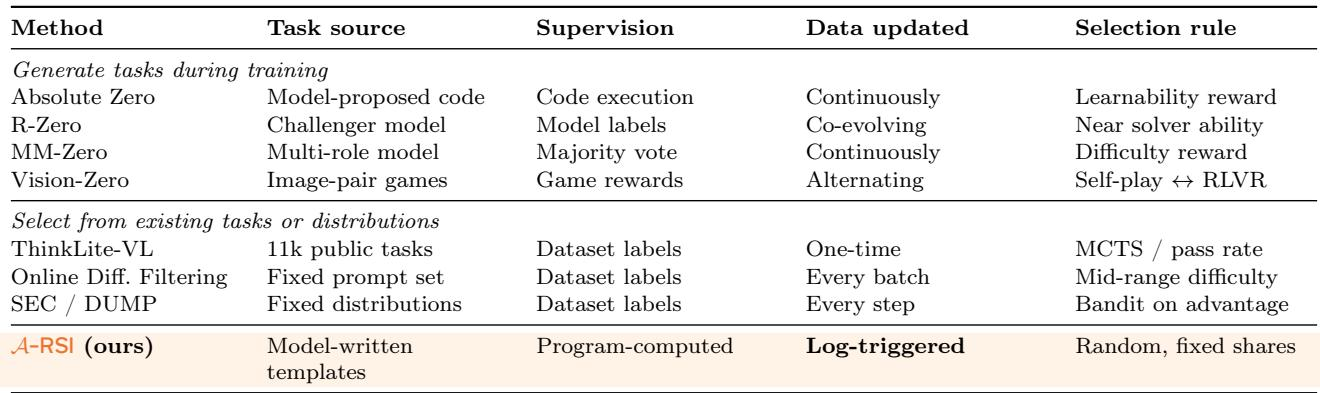
相关的自我改进系统在任务来源、训练监督和数据更新方式上有所不同。大多数被比较的方法持续或与模型能力同步地改变训练数据,而 A-RSI 保留固定的任务生成程序库,仅在自身训练日志表明饱和时才替换整个池。A-RSI 也不同于固定数据选择方法,它用随机程序化任务补充池,而不是从静态集合中选择。大多数被比较的方法持续更新训练数据或使其与模型共同进化,而 A-RSI 使用来自训练日志的饱和信号来触发完整池刷新。各系统的任务监督差异很大,包括代码执行、模型标签、多数投票、游戏奖励和数据集标签。ThinkLite-VL 一次性从固定任务集合中选择具有挑战性的子集,而 A-RSI 在饱和后抽取随机程序化任务,并且在训练期间不调整其任务生成规则。A-RSI 的训练增益对翻倍生成预算的敏感性低于 MM-Zero v5 的增益,表明该改进并非主要源于在评估限制内完成输出。
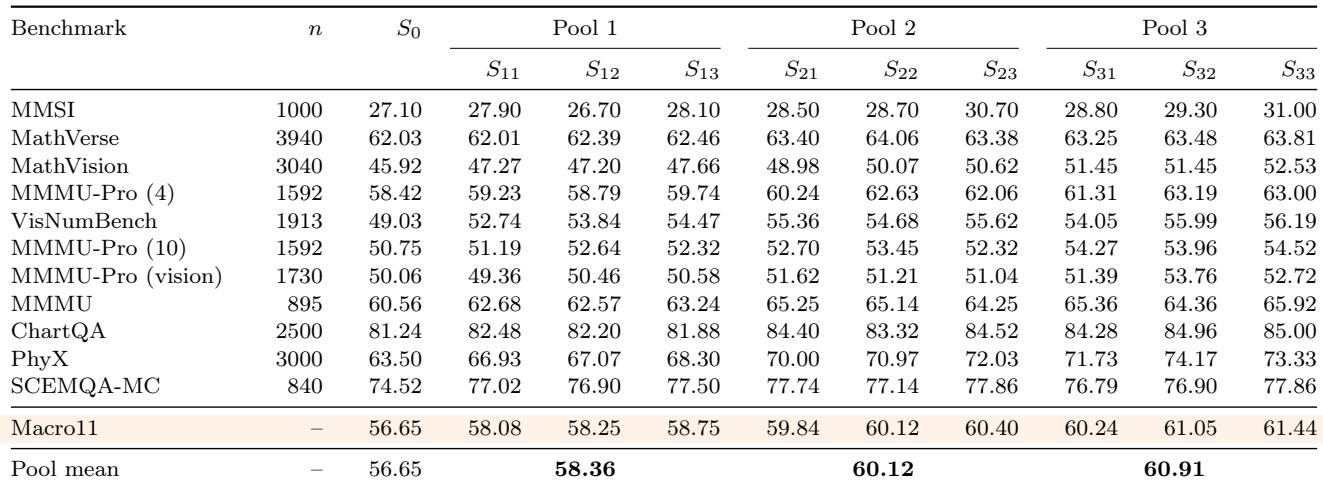
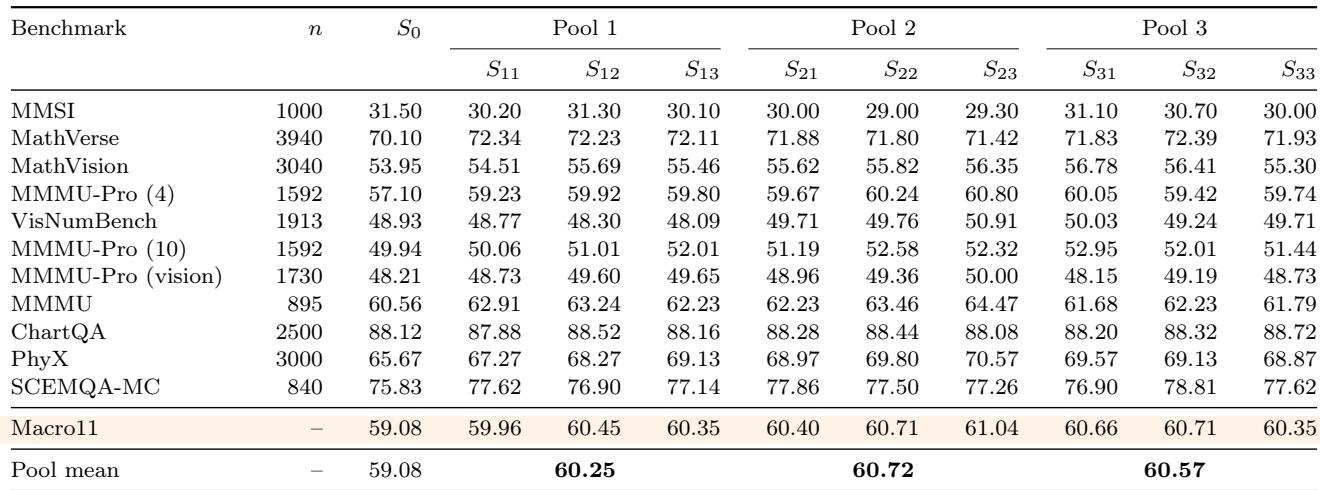
对于所列的 Qwen3-VL-8B-Instruct 基准,后续训练池总体上优于起始模型,其中 VisNumBench 和 MathVision 的增益最大。改进在任务间不均衡且并非严格单调,多个基准在相邻窗口间下降或在最后记录的窗口之前达到峰值,而 MathVerse 仅略有变化。VisNumBench 和 MathVision 显示从起始模型到后续记录窗口的整体改进最大。MathVerse 相对平稳,MMSI 仅显示适度的净变化。进展在某些地方是非单调的,VisNumBench 和 MMMU-Pro(10)等基准出现暂时下降。所有列出的最终分数都超过起始模型,但 MathVerse 和 MMMU-Pro(4)达到峰值更早。
对于在 8192 tokens 下评估的 MiMo-VL-7B-SFT 模型,大多数基准通过训练较起始检查点有所改进,其中 MathVerse 和 MMMU-Pro 的增益最明显。MMSI 是例外,在所有显示的窗口中仍低于其初始分数。轨迹并非单调,后续检查点有时相对于同一池中的早期检查点出现退化。MathVerse、MathVision 和两个 MMMU-Pro 变体在每个显示的训练窗口中都优于起始模型。MMSI 是唯一在所有显示的检查点中保持低于起始分数的基准。在最后显示的池中,第一个检查点在大多数基准上表现最好,而添加的继续训练通常出现退化。
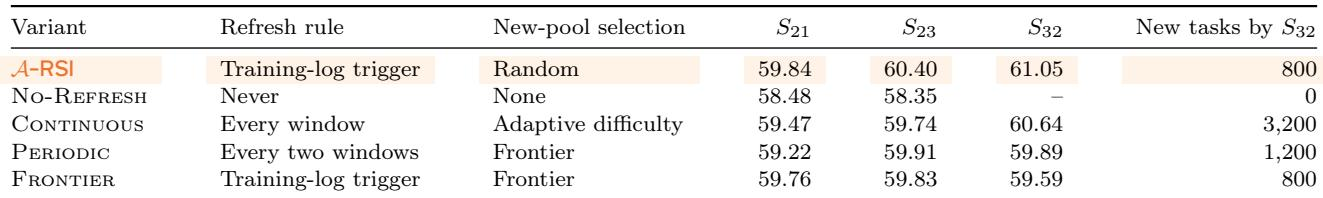
A-RSI 将训练日志触发的刷新与随机新任务选择相结合,在十一项基准上达到最高最终分数,同时与 frontier 刷新一起使用最少的新任务预算。无刷新继续训练出现平台期并提前停止,替代刷新策略要么使用更多新任务,要么得分更低。该比较支持本次运行中实施的新鲜池策略,但并未分离触发时机是否优于固定时间表。A-RSI 达到最高最终分数,并与 frontier 刷新一起使用最少的新任务数量,但得分远高于该 frontier 变体。无刷新继续训练出现平台期且未能生成最终检查点,而所有刷新组均继续改进。持续刷新缩小了差距,但需要 3,200 个新任务,是 A-RSI 预算的四倍,且在最终检查点仍落后。在固定 frontier 选择的情况下,检测器触发的刷新略逊于周期刷新,因此 A-RSI 的优势并未被证明仅来源于更好的时机。
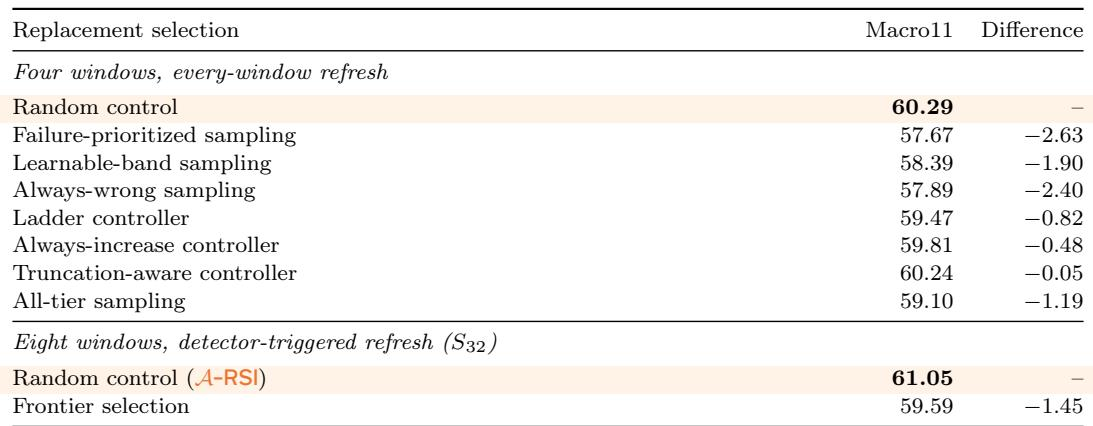
在 8192 tokens 下,每窗口随机刷新对照在替换选择变体中达到最高的 Macro11 分数。失败优先、可学习带宽和总是错误采样均低于该对照,其中失败优先和总是错误的差距最大。阶梯和总是增加控制器也低于对照,但差距较小;这些变体共享对照运行和训练历史,因此比较并非独立重复。所有列出的替换选择变体均低于每窗口随机刷新对照。失败优先和总是错误采样比阶梯和总是增加控制器显示出更大的下降。
实验在 Qwen3-VL-8B-Instruct 和 MiMo-VL-7B-SFT 基准上比较了 A-RSI 与在任务来源、监督和刷新策略上有所不同的自我改进基线。后续训练池总体上优于起始检查点,但增益不均衡且非单调,一些基准在最终窗口之前达到峰值或出现退化。A-RSI 在使用最少新任务预算的同时达到最高最终总分,而无刷新继续训练出现平台期,替代刷新策略需要更多任务或得分更低。替换选择消融显示,简单的随机刷新优于失败优先、可学习带宽和基于控制器的采样变体。