Command Palette
Search for a command to run...
PDRVLA:一种具有物理动力学表示的视觉–语言–动作模型
PDRVLA:一种具有物理动力学表示的视觉–语言–动作模型
摘要
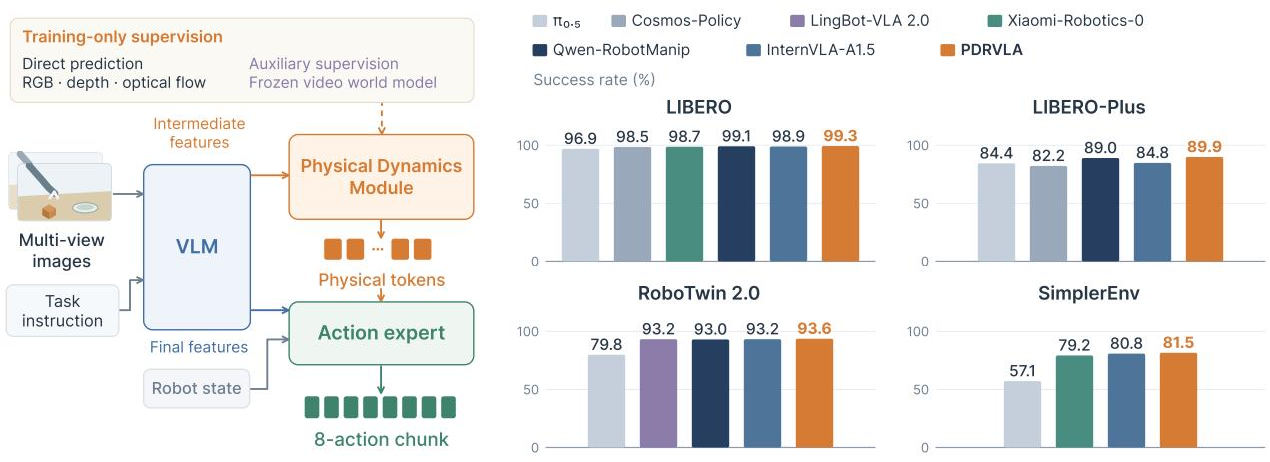
视觉–语言–动作(VLA)模型根据视觉观测和语言指令生成机器人动作,但这类模型对物理动力学的理解仍然有限。视频世界模型能够捕捉场景动力学,然而生成未来视频会在控制回路中引入较高延迟。我们提出 PDRVLA,其轻量级物理动力学模块从视觉–语言特征中提取物理 token,并在无需在线视频生成的情况下对动作生成进行条件化。该模块通过直接预测未来 RGB、深度和光流特征进行学习,并通过一个冻结的预训练视频世界模型提供辅助监督。训练完全依赖公开可用数据,并通过人类到机器人合成、子任务标注和具身思维链(ECoT)标注进行扩充。在四个仿真基准上,PDRVLA 在 LIBERO 上成功率达到 99.3%,在 LIBERO-Plus 上达到 89.9%,在 RoboTwin 2.0 上达到 93.6%,在 SimplerEnv 上达到 81.5%。消融实验表明,世界模型监督改善了未来预测,并评估了子任务条件化、未来物体位姿监督和 ECoT 训练对动作成功的影响。
一句话总结
北京大学和京东的研究人员提出 PDRVLA,一种视觉-语言-动作模型,其轻量级物理动力学模块(Physical Dynamics Module)从视觉-语言特征中提取 physical tokens,以在不进行在线视频生成的情况下条件化动作生成;该模型通过直接预测未来 RGB、深度和光流特征进行训练,并使用冻结的预训练视频世界模型提供辅助监督,在 LIBERO 上取得 99.3% 成功率,在 LIBERO-Plus 上取得 89.9%,在 RoboTwin 2.0 上取得 93.6%,在 SimplerEnv 上取得 81.5%。
核心贡献
- PDRVLA 引入了一个轻量级物理动力学模块(Physical Dynamics Module),从中间视觉-语言特征中提取紧凑的 physical tokens,以在不进行在线视频生成的情况下条件化动作生成。这些表示通过直接预测未来 RGB、深度和光流特征进行训练,并使用冻结的预训练视频世界模型提供辅助监督;部署时使用学习到的 physical tokens,而无需运行视频生成器。
- 训练语料完全由公开数据集构建,将真实机器人、手持 UMI 和仿真演示与通用及面向机器人操作的视觉-语言数据相结合。通过以自我为中心的人到机器人合成进行扩展,并增加子任务和具身思维链(embodied chain-of-thought)标注,以支持联合动作和语言学习。
- 在 LIBERO、LIBERO-Plus、RoboTwin 2.0 和 SimplerEnv 上的评估成功率分别为 99.3%、89.9%、93.6% 和 81.5%。消融实验表明,在世界模型监督下未来预测有所改善,分析揭示了子任务条件化、未来物体姿态监督和具身思维链标注对动作成功率的影响。
引言
视觉-语言-动作(VLA)模型将视觉观察和语言指令映射为机器人动作,通常依赖预训练的视觉-语言模型和异构机器人演示,但它们对物理场景属性的理解仍然有限,包括对物体质量的编码较弱以及运动适应不可靠。操作还需要预测抓取、移动和放置物体如何改变空间配置,而不仅仅是识别当前场景。预训练的视频世界模型可以通过预测未来场景来学习物理动力学,但在控制回路中生成视频会增加延迟,因此最近的工作仅在训练期间使用未来预测来构建紧凑的表示。作者提出了 PDRVLA,一种带有轻量级物理动力学模块的 VLA 模型,该模块从中间 VLM 特征中提取 physical tokens,并将其与最后一层特征一起用于动作生成。这些 tokens 通过直接未来 RGB、深度和光流预测以及来自冻结视频世界模型的辅助监督进行训练,使策略能够在部署时受益于物理预判,而无需运行视频生成器。
数据集
语料概览
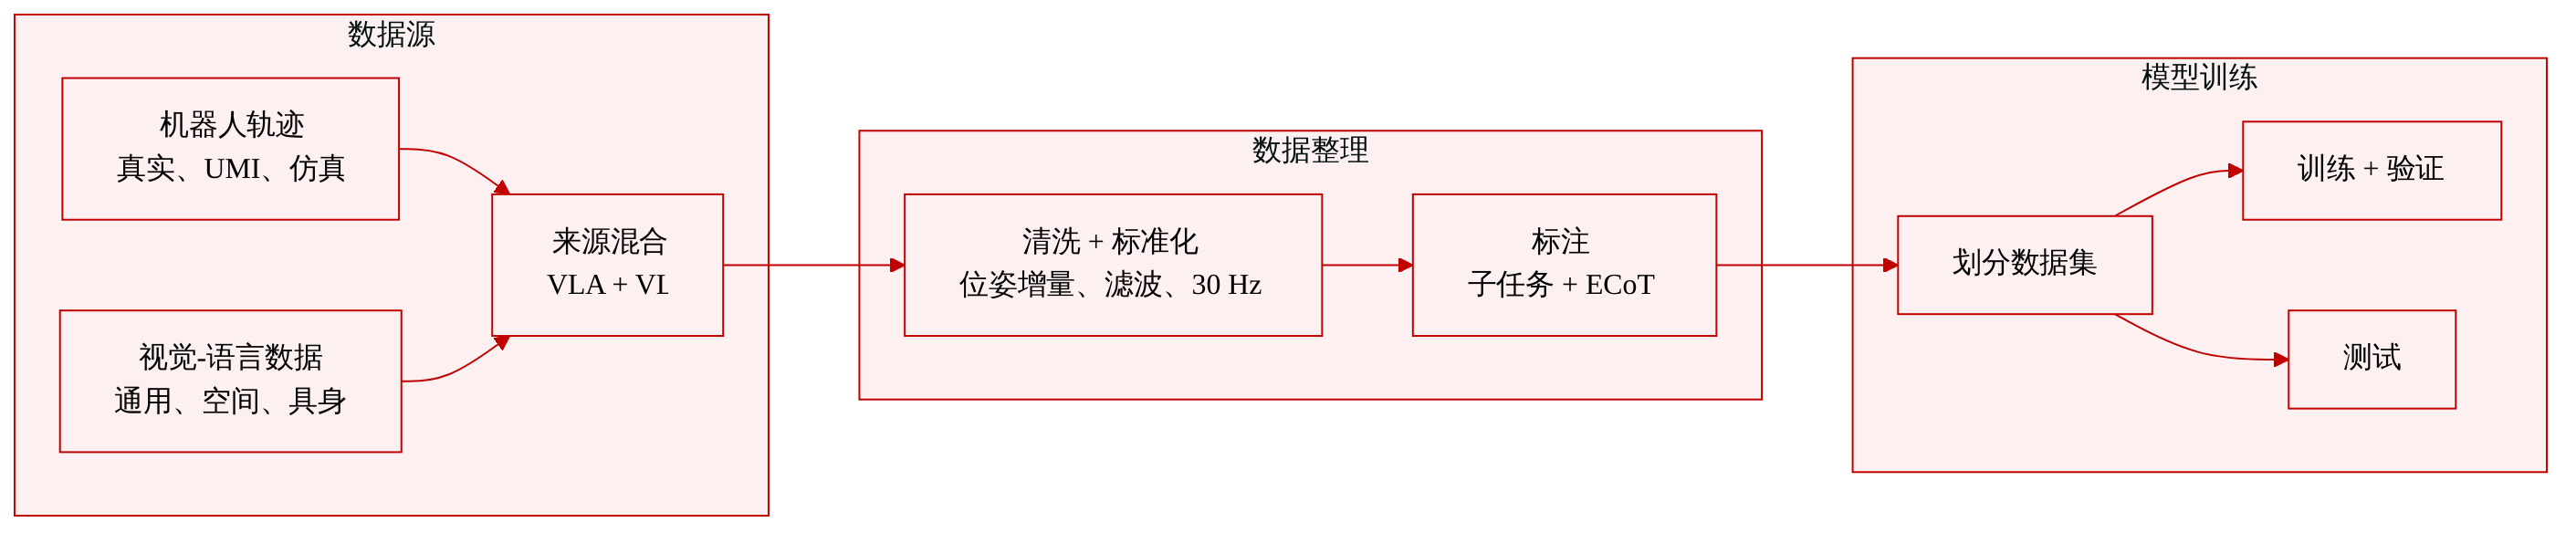
- 作者构建了一个训练语料,结合 VLA 数据和 VL 数据。
- VLA 部分将观察和任务指令与控制目标配对,使模型以机器人行为为基础。
- VL 部分增加了超出动作轨迹覆盖范围的感知、空间和任务级推理。
- 语料分为五类:真实机器人轨迹、UMI 演示、仿真交互、通用图像/视频-语言数据,以及空间/具身 VL 数据。
- 本部分未说明确切的混合比例和训练划分细节。
VLA 子集
-
真实机器人数据
- 来源包括 RoboSet、DROID、BridgeData V2、BC-Z 和 RH20T,用于单臂桌面和野外操作。
- 双臂和多平台覆盖来自 RoboMIND V1/V2、RoboCOIN 和 ABC-130K。
- 人形机器人、臂和灵巧手数据来自 Humanoid Everyday 和 Unitree UniFoLM 发布。
- 多机器人数据包括 AgiBot World Colosseo。
- 额外操作轨迹来自 REASSEMBLE、FuSe、MolmoAct 和选定的 LeRobot 社区子集。
- 这些来源涵盖抓取放置、关节物体交互、工具使用、接触密集装配和其他技能,且跨不同机器人和环境。
-
UMI 数据
- 来源包括 UMI、FastUMI、FastUMI-100K、Hy-Embodied-0.5-VLA-Data、HiFi-UMI-2K 和 RealOmni-Open Data。
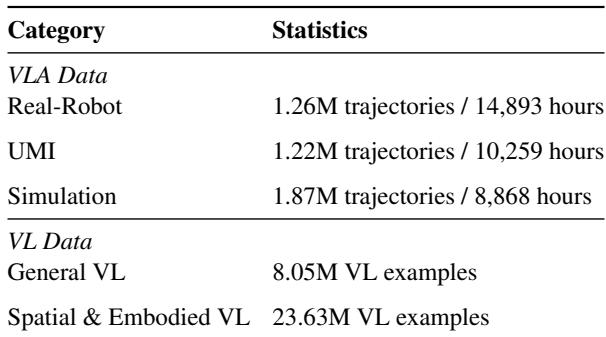
- 经来源特定过滤后,它们贡献约 122 万条轨迹片段和 10,259 小时。
- 由于 UMI 数据不提供机器人关节空间指令,作者直接使用时间对齐的末端执行器姿态,并采用统一的笛卡尔动作表示。
-
仿真数据
- 标准化技能和长时程任务来自 ManiSkill2、Meta-World 和 RoboCasa。
- 大规模跨形态轨迹来自 InternData-A1、GR00T-X-Embodiment-Sim 和 InternVLA-M1。
- 双臂或灵巧操作数据来自 RoboTwin 2.0 和 DexMimicGen。
VL 子集
-
通用 VL 数据
- 来源包括 Cambrian-1、COCO-Caption、VQAv2 和 OneThinker。
- 这些提供以视觉为中心的指令数据、图像描述、开放式视觉问答,以及图像/视频推理示例。
-
空间与具身 VL 数据
- 空间推理来源包括 SpaceThinker、OpenSpaces、SpaceOm、RefSpatial、来自“Scaling Spatial Intelligence with Multimodal Foundation Models”的数据,以及跨视角对应示例。
- 具身和程序性来源包括 RoboPoint、Robo2VLM、RoboVQA、EO-1、Cosmos-Reason1 和 ProcCorpus-60M。
- 这些涵盖物体和可供性定位、操作视频问答、交错感知与推理、物理常识以及程序性监督。
数据处理与模式
-
动作表示
- 位置被转换为米,姿态方向被转换为旋转矩阵。
- 坐标轴采用右手约定,+x 向前,+y 向左,+z 向上。
- 姿态保持相对于臂基座或世界坐标系,具体由每个来源数据集指定。
- 参考坐标系记录在元数据中。
- 末端执行器动作表示为从当前姿态到目标姿态的增量。
- 目标为数据集提供的绝对目标(如果可用),否则为重采样后的下一个观测姿态。
- 夹爪开度归一化为:完全闭合为 0,完全张开为 1。夹爪动作是归一化后的绝对目标开度。
-
轨迹过滤
- 如果整条轨迹片段过短、缺少可用的动作目标或状态序列、包含无法恢复单位的值、无法对齐图像和状态流,或任务描述与来源元数据冲突,则整条轨迹片段会被剔除。
- 过滤阈值按数据集或子集设置。
- 具有非有限值、异常重复观测、突然尖峰或超出范围值的帧会被排除在监督之外,但保留在其原始时间位置上。
- 如果损坏无法隔离到单个帧,则整条轨迹片段会被剔除。
-
形态元数据标准化
- 机器人、臂和末端执行器类型分别记录为 robot_type、arm_type 和 hand_type。
- panda 和 franka_panda 等别名会被标准化,同时保留所附带末端执行器的身份。
- 缺失或不一致的元数据会根据来源文档和录制视频进行核对。
-
视觉处理
- 相机观测和机器人状态以各流中最低频率对齐,上限为 30 Hz。
- 每条轨迹片段最多保留四个相机视角,优先保留腕部和第三人称视角。
- 视频最长边调整为 640 像素,并以最大 GOP 大小为 2 帧进行编码,以便更快随机访问。
- 未描述单独的裁剪策略。
衍生数据与标注
-
以自我为中心的人到机器人合成
- 作者将 Qwen-RobotManip 中的人到机器人流程应用于 EgoDex 演示。
- 为 12 种机器人臂模型生成数据,包括 Panda、UR5e、UR10e、FR3、Kinova Gen3、IIWA、ARX-L5、xArm7、ViperX、WidowX、Piper 和 YAM。
- 手部关键点映射为末端执行器姿态轨迹和夹爪指令,逆运动学生成臂关节轨迹。
- 视觉适配使用 SAM3 进行分割,ProPainter 用于背景重建,机器人渲染,以及 DA3 深度处理遮挡。
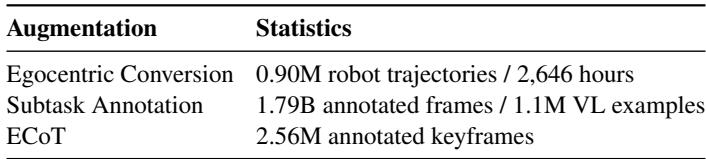
- 过滤后,合成语料包含 896,832 条双臂机器人轨迹和约 2,646 小时的数据,来自 74,813 条 EgoDex 演示。
-
子任务标注
- 如果有来源提供的子任务标签,则复用这些标签;否则由 Qwen3.8-27B 对稀疏采样的观察进行标注。
- 片段边界合并为轨迹级别的分割,并传播到每一帧。
- 标注覆盖约 188 万条轨迹片段、17.9 亿帧和 20,101 小时。
- 约 7800 万个采样帧被自动标注,占总帧数的 4.4%。
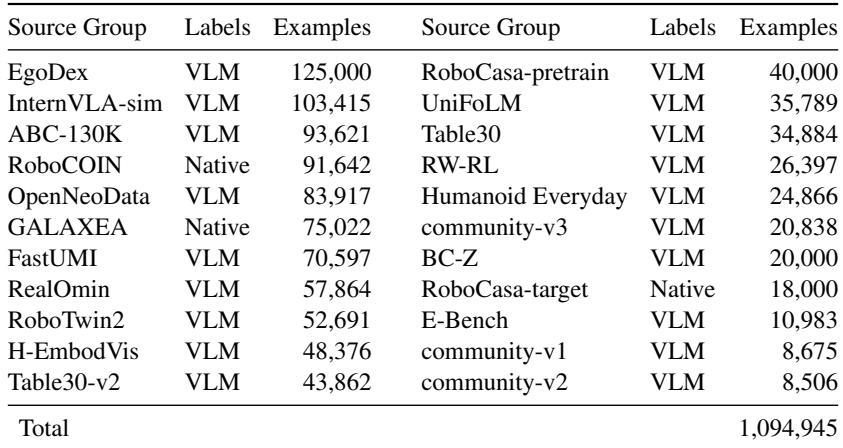
- 作者从约 294,000 条已标注轨迹片段中构造了 110 万个单轮 VL 示例。
-
ECoT 标注
- 关键帧选取为每个子任务中的第一个和最后一个有效帧,外加视觉相似度低于阈值的额外帧。
- Qwen3.8-27B 根据记录的姿态生成场景描述、进度评估和下一步运动描述。
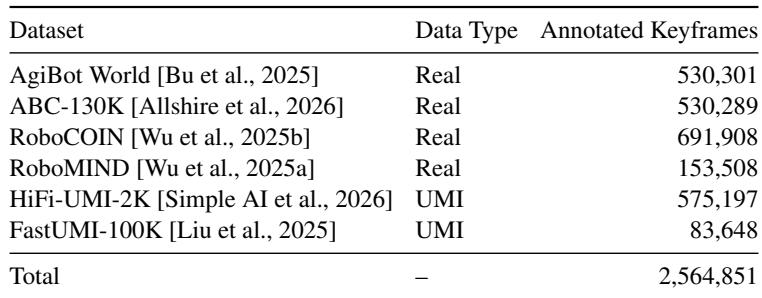
- 该流程从选定的真实机器人和 UMI 数据集中生成 2,564,851 个已标注关键帧。
- 也使用了已发布的 ProcCorpus-60M 标注。
数据使用方式
- 该语料被用作 VLA 和 VL 的联合训练混合数据。
- VLA 示例通过观察、任务指令和控制目标提供监督。
- VL 示例提供更广泛的感知、空间、具身和程序性推理监督。
- 衍生的子任务和 ECoT 标注在现有轨迹之上添加了结构化语言目标。
- 合成的 EgoDex 数据增加了多形态的 VLA 示例,并带有机器人兼容的观察和动作。
- 摘录中未提供确切的训练划分或混合比例。
方法
作者利用 Qwen3.5-4B VLM 骨干网络、物理动力学模块(Physical Dynamics Module)和动作专家来构建 PDRVLA 框架。
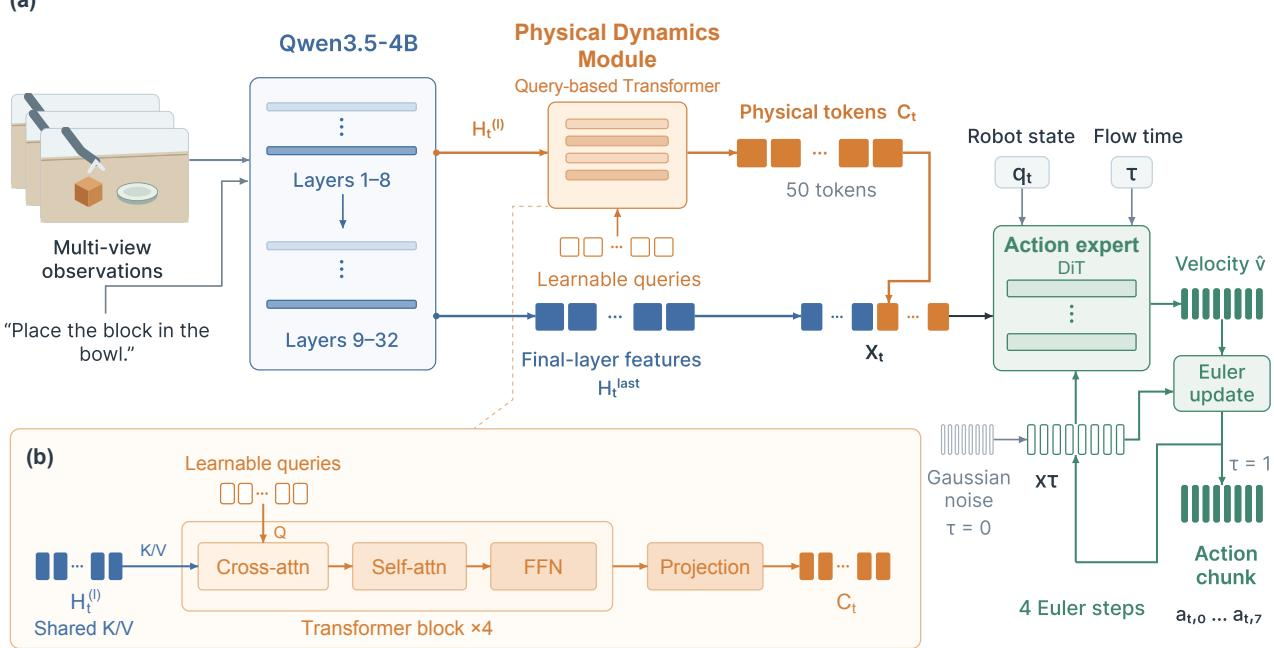
给定多视角观察和任务指令,VLM 骨干网络处理输入。物理动力学模块从中间 VLM 特征中提取 physical tokens,而动作专家利用最后一层特征以及 physical tokens 和本体感受状态来生成机器人指令。
为了捕捉有助于预测物理变化的视觉信息,物理动力学模块使用 50 个可学习查询,从中间 VLM 特征 Ht(l) 中提取一组固定的 physical tokens Ct。在 4 个 Transformer 块中,这些查询通过交叉注意力检索信息,通过自注意力交换信息,并通过前馈层。最终投影将输出映射到 VLM 隐藏宽度,生成 50 个 physical tokens。
动作策略预测一个包含 K=8 条机器人指令的 chunk。为处理异构机器人,使用固定维度 58 维动作向量,为左右操作臂提供独立槽位。动作专家是使用条件流匹配训练的 Diffusion Transformer。它接收带噪声的动作 chunk,将其映射为 tokens,并在自注意力和对条件序列 Xt=[Htlast;Ct] 的交叉注意力之间交替。本体感受状态被编码为前缀 token。在推理时,chunk 由高斯噪声初始化,并使用四步 Euler 积分。
训练流程包括物理模块预训练和联合策略训练。
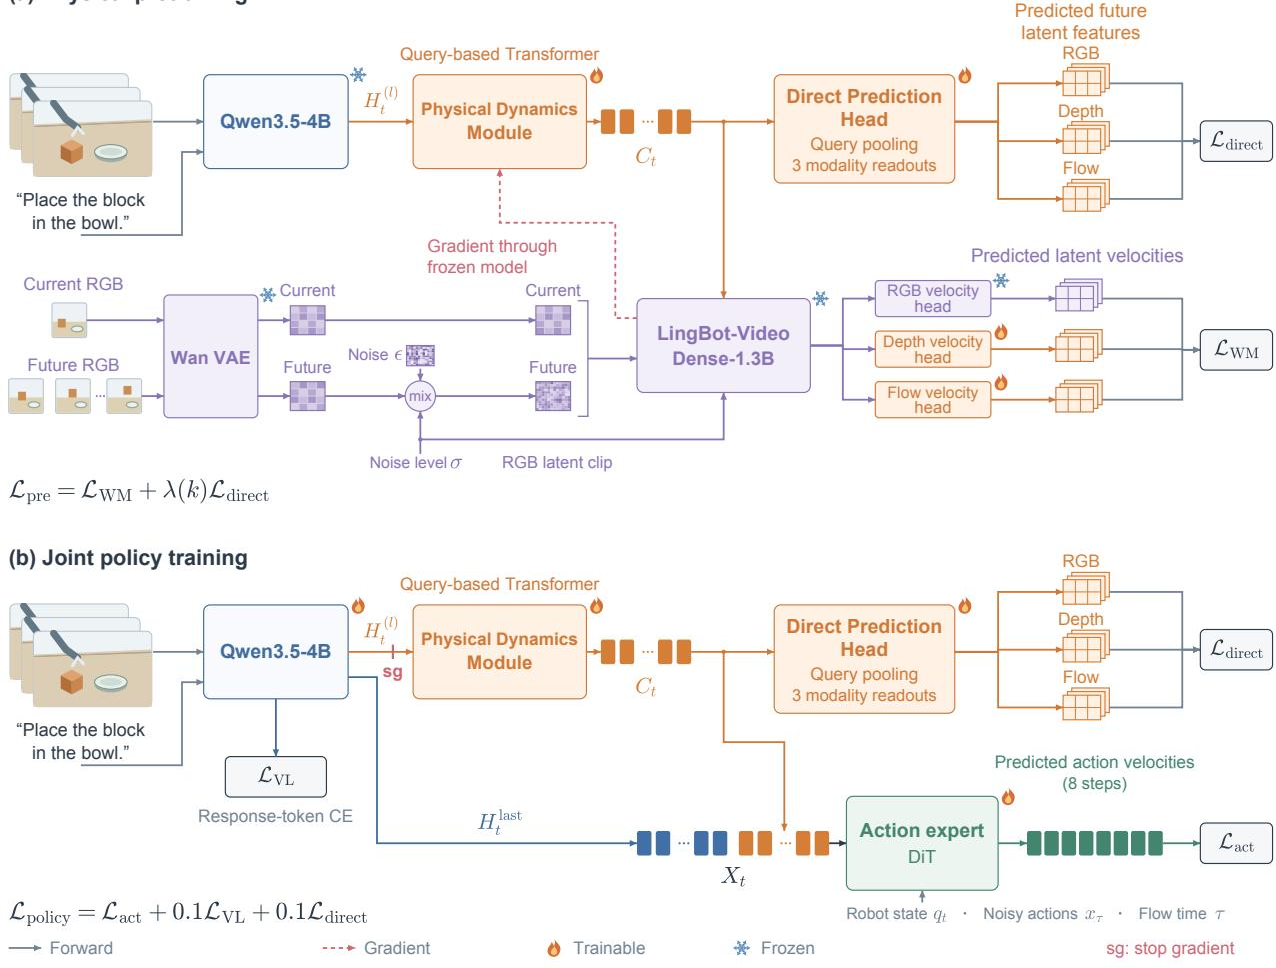
在物理预训练期间,该模块被训练为编码未来的外观、几何和运动。这结合了直接预测未来 RGB、深度和光流潜在特征,以及来自冻结预训练视频模型的辅助监督。直接预测损失使用带空间查询的轻量级头,而世界模型辅助损失通过预测潜在速度来指导表示学习。
在联合策略训练阶段,视频世界模型被移除。VLM、物理动力学模块、动作专家和直接预测头在 VLA 和 VL 数据上联合训练。进入物理模块的中间 VLM 特征被 detach(停止梯度),以防止动作损失沿此路径反向传播到 VLM。总损失结合了掩码速度匹配动作损失、VL 交叉熵损失和直接预测损失。
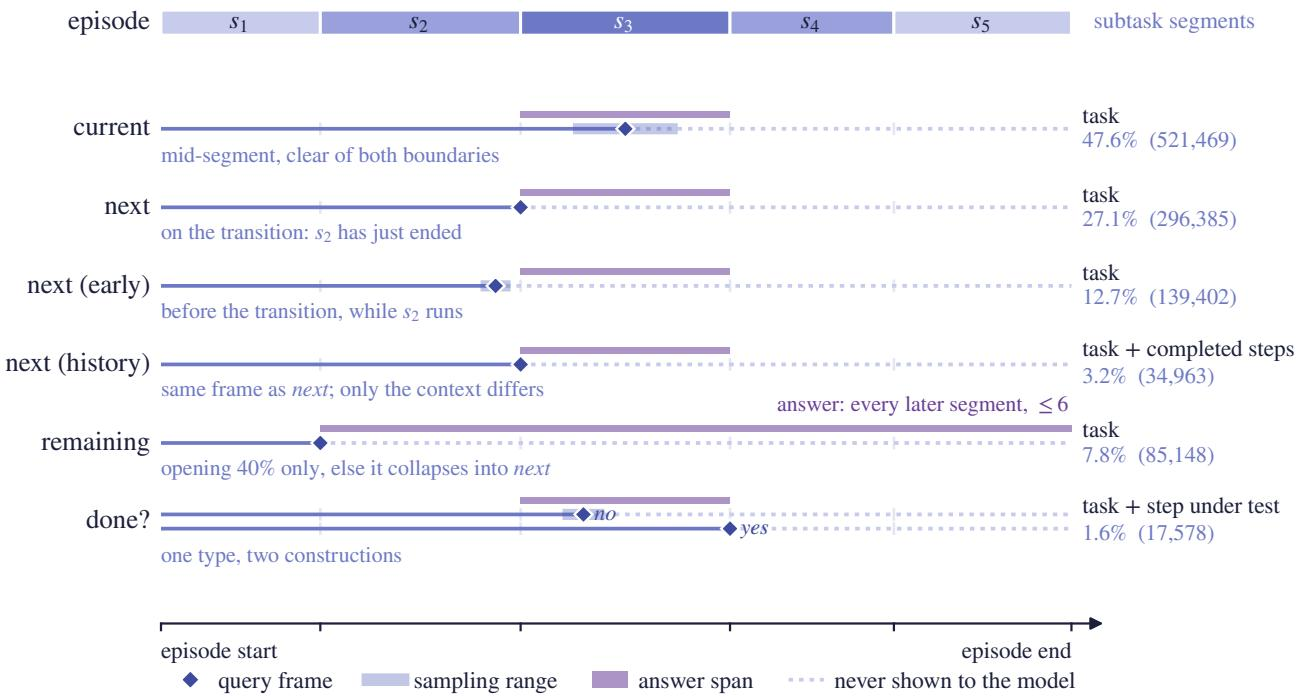
为丰富训练语料,作者采用人到机器人合成和语言标注。子任务标注使用大语言模型对稀疏采样的观察进行标注,将轨迹分割为有序子任务。这些标注被转换为 VL 示例,用于询问模型当前、下一个或剩余子任务。
此外,ECoT 标注利用根据记录姿态生成的场景描述、进度评估和下一步运动描述来增强关键帧,为动作专家提供详细上下文。
实验
PDRVLA 在四个仿真基准上进行了评估,涵盖单臂 LIBERO 和 LIBERO-Plus 扰动任务、双臂 RoboTwin 2.0,以及 WidowX SimplerEnv 操作任务,同时包含针对预训练和策略监督的组件研究。在这些基准上,PDRVLA 取得了最高的综合成功率和较强的鲁棒性,但在某些扰动类别和单项任务上其他方法更优。组件分析表明,世界模型辅助预训练能改善未来 RGB 和深度预测;子任务条件化在周期性刷新下带来适度提升;ECoT 训练能提升动作成功率,且推理时无需生成 ECoT;辅助物体姿态监督仅带来边际收益。
核心训练语料将来自真实机器人轨迹、UMI 演示和仿真交互的 VLA 数据与 VL 数据相结合。在 VLA 各类别中,仿真贡献了最多的轨迹,但记录的小时数最少,而真实机器人数据贡献了最多的小时数。VL 部分以空间和具身示例为主,其数量约为通用 VL 示例的三倍。仿真在 VLA 类别中提供了最大的轨迹数量,但小时数最少。真实机器人数据在 VLA 类别中提供了最高的小时数,尽管轨迹数量少于仿真。空间和具身 VL 示例的数量约为通用 VL 示例的三倍。
合成和标注的训练数据增加了三个大规模组成部分:以自我为中心的转换贡献了近百万条机器人轨迹,跨越数千小时;子任务标注贡献了超过十亿帧标注和超过一百万个 VL 示例;ECoT 标注增加了数百万个已标注关键帧。这些新增内容以行为适配轨迹以及视觉接地的子任务和解释式监督扩展了语料。以自我为中心的转换产生了约百万条机器人轨迹和数千小时的自适应演示数据。子任务标注是最大的帧级贡献,超过十亿帧标注被提炼为超过一百万个 VL 示例。ECoT 标注增加了数百万个关键帧级标注,用于场景、任务进度和运动描述。
子任务 VL 示例主要来自 VLM 生成的标签,而非来源提供的原生标注。在列出的组中,EgoDex、InternVLA-sim 和 ABC-130K 贡献了最大的 VLM 标注份额,而 RoboCOIN 和 GALAXEA 是仅有的原生标签来源,合计贡献约五分之一的示例。许多来源组贡献的示例远少于领先组,表明数据集组成存在长尾分布。VLM 标注示例占所列子任务 VL 数据的大部分;原生标签仅出现在 RoboCOIN 和 GALAXEA 中。EgoDex 在所有来源组中贡献最大,随后是 VLM 标注组中的 InternVLA-sim 和 ABC-130K。RoboCOIN 是最大的原生标签来源,并跻身总体贡献前列,而 GALAXEA 也贡献了相当数量的原生标签份额。较小的来源组长尾贡献的示例明显少于领先组。
ECoT 标注流程在六个机器人数据集上产生了约 256 万个已标注关键帧。真实机器人数据集提供了其中大部分关键帧,而 UMI 数据集贡献了较小但相当可观的份额。不同数据集的已标注关键帧数量差异很大,从约 84,000 到近 692,000。真实机器人数据占已标注关键帧的大多数,RoboCOIN 贡献了单个数据集中的最大总量。在 UMI 数据集中,HiFi-UMI-2K 包含的已标注关键帧远多于 FastUMI-100K,后者总体贡献最小。AgiBot World 和 ABC-130K 贡献的已标注关键帧总数几乎相等,各约 530,000。
在四个仿真基准上,PDRVLA 在所比较方法中取得了最高的综合成功率,尤其是在 LIBERO 和 LIBERO-Plus 上表现突出。各基线的表现因基准而异,大多数报告基线集中在较高的 LIBERO 成功率和较低的 SimplerEnv 成功率。在 LIBERO-Plus 上,PDRVLA 总体领先,但并未在每个扰动类别中都占优,因为 Qwen-RobotManip 在机器人初始状态、传感器噪声和物体布局变化下表现更好。PDRVLA 在 LIBERO、LIBERO-Plus 和 SimplerEnv 上报告了最佳综合结果,并在 LIBERO-Plus 七个扰动类别中的四个类别领先。Qwen-RobotManip 在 LIBERO-Plus 的机器人初始状态、传感器噪声和物体布局扰动上优于 PDRVLA,而机器人初始状态是 PDRVLA 最困难的类别。在基线中,LingBot-VLA 2.0 报告了最强的 RoboTwin 2.0 结果,π0 报告了最低的 SimplerEnv 结果。在 SimplerEnv 上,PDRVLA 最大领先出现在 Eggplant to Basket 任务,但在 Carrot to Plate 任务上落后于 InternVLA-A1.5。
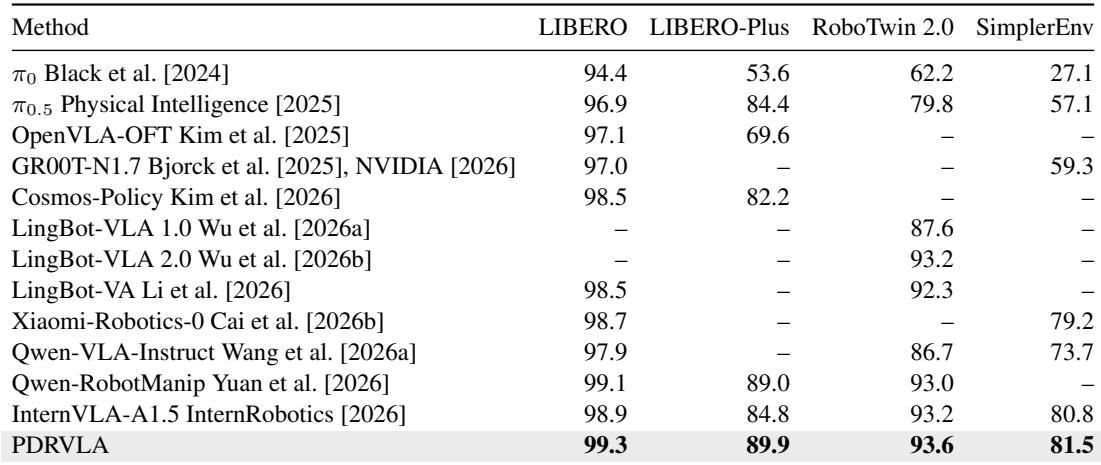
实验首先分析了训练语料及其合成监督,然后在四个仿真基准上评估 PDRVLA。语料在轨迹数量上以仿真数据为主,在小时数上以真实机器人数据为主,空间和具身 VL 示例多于通用 VL 数据;新增的以自我为中心、子任务和解释式标注显著扩展了行为适配和视觉接地的监督。子任务 VL 标签大多由 VLM 生成,并集中在少数来源中,呈长尾分布,而真实机器人数据集贡献了最多的已标注关键帧。在机器人操作基准上,PDRVLA 在 LIBERO、LIBERO-Plus 和 SimplerEnv 上取得了最高综合成功率,尽管 Qwen-RobotManip 在 LIBERO-Plus 的若干扰动类别上优于它。