Command Palette
Search for a command to run...
EmbeddingGemma 2:统一且高效的多模态表示
EmbeddingGemma 2:统一且高效的多模态表示
摘要
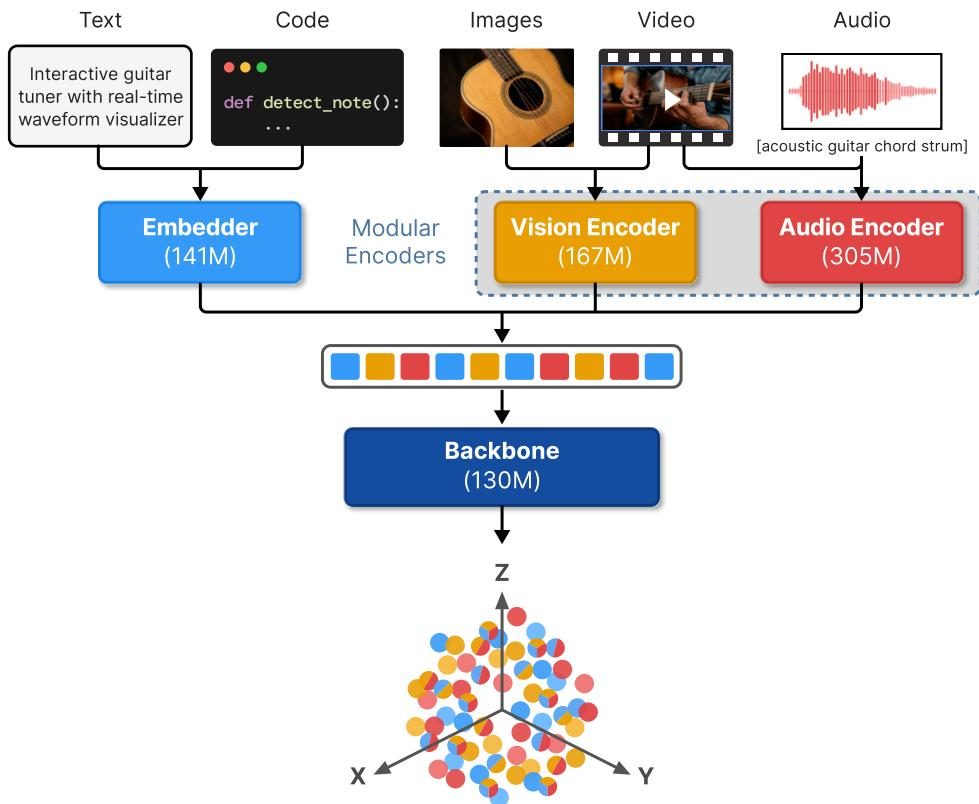
我们提出 EmbeddingGemma 2,这是一种开放的多模态嵌入模型,能够在统一空间中原生表示文本、图像、音频、视频及其组合。我们的方法引入了简化逐层嵌入、以及具有模态与目标递进的多阶段课程学习等改进,从而确保在单模态、跨模态和混合模态评测中均具备强劲性能。值得注意的是,在涵盖所有模态的综合嵌入基准测试中,EmbeddingGemma 2 建立了新的帕累托前沿,超越了专用模型以及规模大两倍至十二倍的模型。此外,我们的设计为资源受限环境提供了灵活性,支持模态编码器选择性加载、可调视觉 token 预算、可截断嵌入维度和量化权重。我们提供了针对关键决策的消融分析,并发布 EmbeddingGemma 2 以促进后续研究。
一句话总结
Google 的 EmbeddingGemma 团队提出 EmbeddingGemma 2,一款开放的多模态嵌入模型。它通过简化的逐层嵌入,以及让模态和目标逐步递进的多阶段课程,将文本、图像、音频、视频和混合模态表示统一到同一空间。该模型在覆盖所有模态的综合嵌入基准上建立了新的帕累托前沿,表现优于专家模型以及规模达到其 2 到 12 倍的模型,并通过按需加载指定模态编码器、可调整的视觉 token 预算、可截断的嵌入维度和量化权重实现灵活部署。
核心贡献
- EmbeddingGemma 2 是一款开放的多模态嵌入模型,通过简化的逐层嵌入以及让模态和目标逐步递进的多阶段课程,将文本、图像、音频、视频和混合模态输入映射到统一空间。
- 沿单一微调轨迹合并检查点,并在合并后增加独立的量化感知训练 tail-patch 阶段,在保留微调质量的同时生成接近半精度性能的 int4 Q4_0 和 Q4_C 检查点,在 MTEB(English, v2) 等评估中表现良好。
- 文本、视觉和音频基准上的实验显示,EmbeddingGemma 2 相比专家模型以及规模达到其 2 到 12 倍的模型建立了新的帕累托前沿,同时按需加载指定模态编码器、可调整的视觉 token 预算、可截断的嵌入维度和量化权重支持资源受限环境下的部署,包括在 Google Pixel 11 Pro 上实现仅文本场景 191 MB 的峰值端侧内存占用。
引言
嵌入模型是现代检索、语义相似度、聚类以及检索增强生成技术的核心,因为它们将数据映射为固定长度向量,使语义相近的条目彼此靠近。在仅文本场景中,这一范式已经非常成熟,但处理图像、视频和音频通常需要额外工具,例如自动语音识别或图像字幕生成,这会增加成本,并可能遗漏细粒度视觉细节以及非语言和环境声音。
此前的多模态嵌入模型要么专注于视觉与文本对齐,而不原生处理混合模态交互,要么改造多模态大型语言模型,这类模型通常较大、较慢,且不适合对延迟敏感、高吞吐量或端侧应用。作者通过 EmbeddingGemma 2 解决这一缺口,这是一个 744M 参数的通用多模态嵌入模型,能够将文本、图像、视频、音频以及任意交错组合映射到单一嵌入空间。其模块化设计、高效架构、多阶段训练和量化支持使高质量多模态嵌入即使在资源受限场景下也具备实用性。
数据集
-
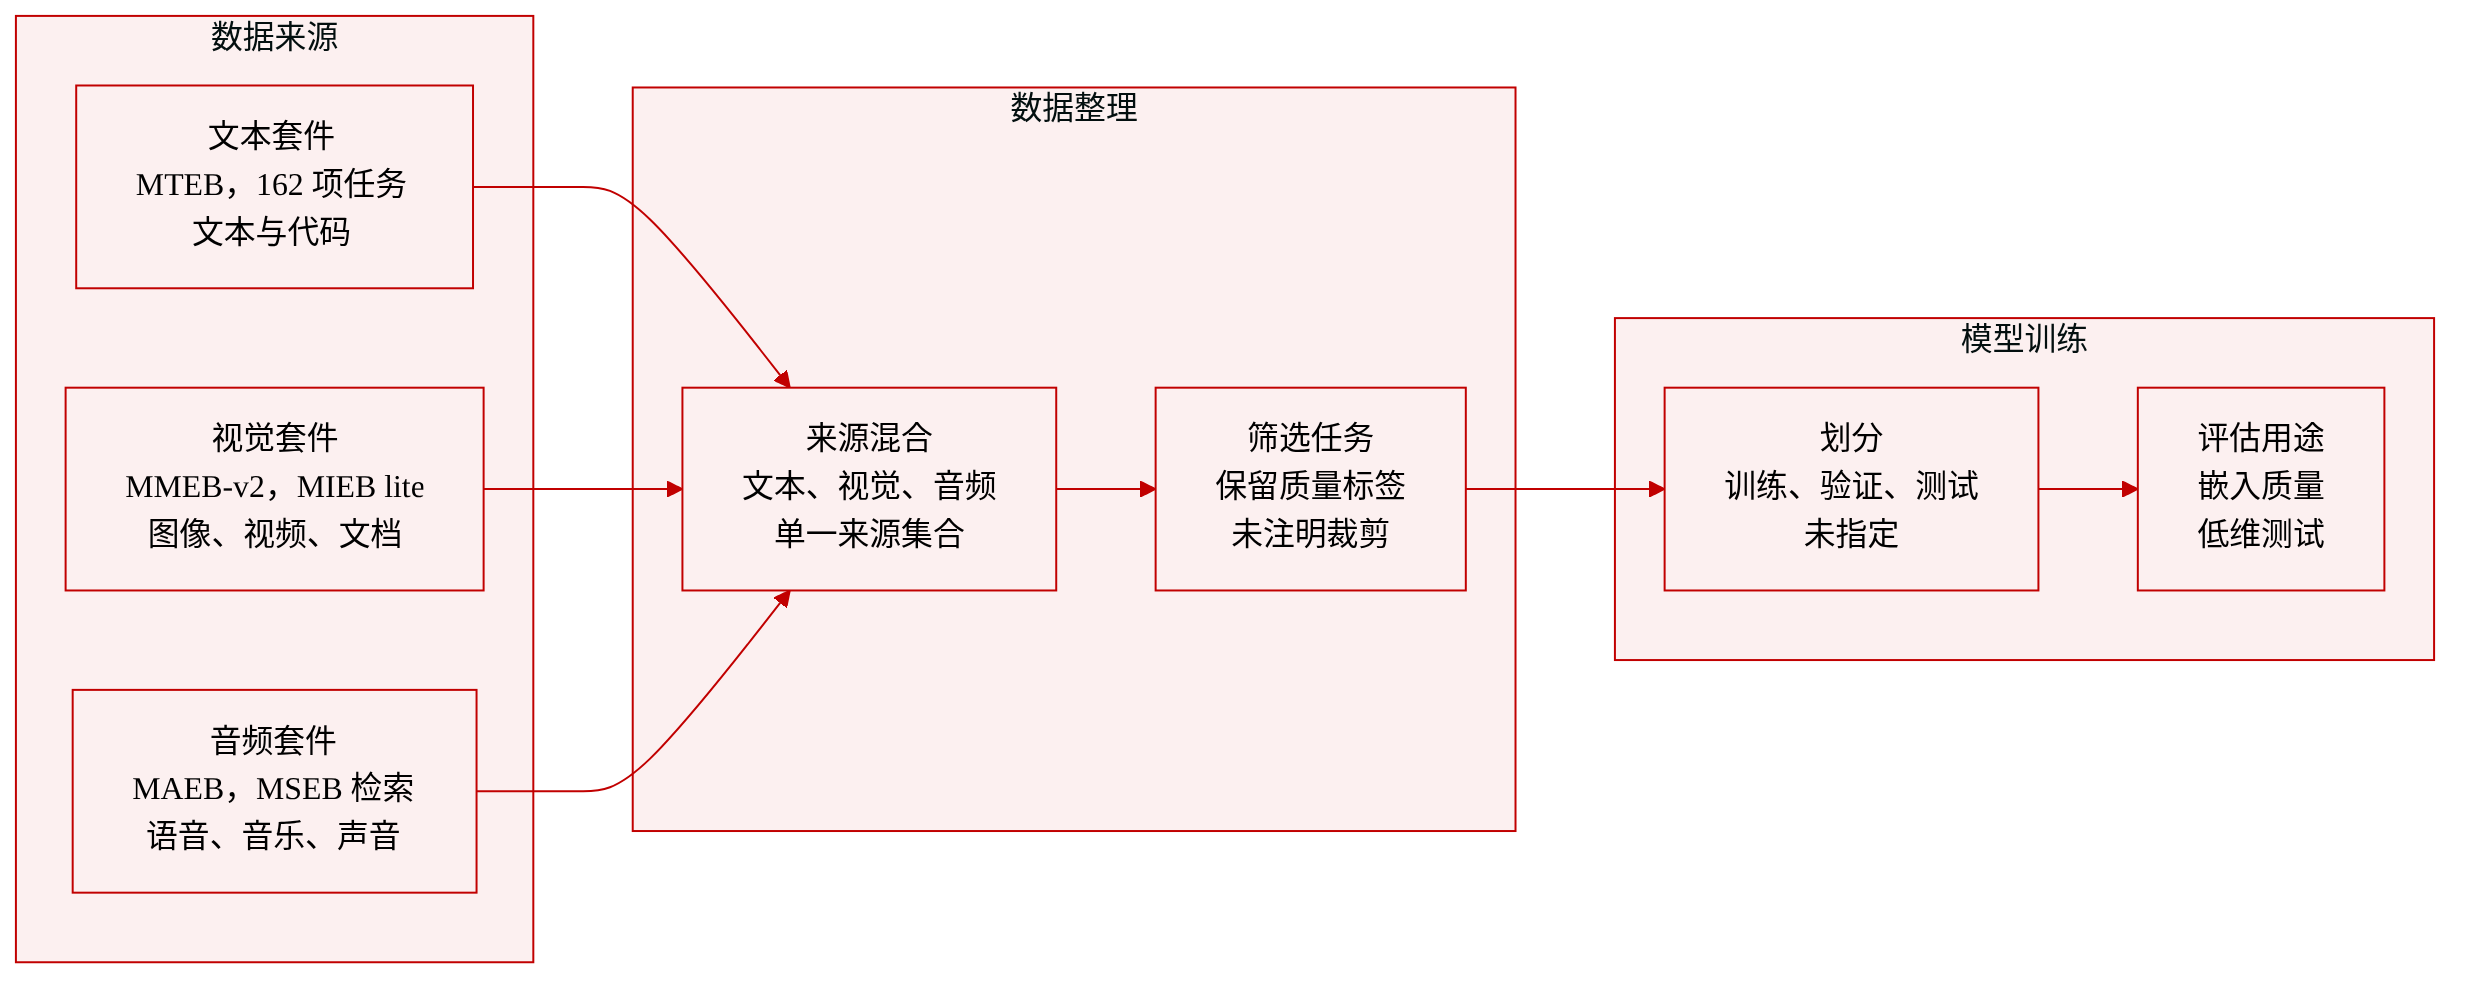
文本数据。 作者使用 MTEB 评估套件,其中包含 162 个经过质量控制的任务。这些任务覆盖 250+ 种自然语言和 14+ 种编程语言,涵盖法律、医疗、新闻、编程和 Web 等 20 个领域,并包括 10 种任务类型:平行文本挖掘、分类、聚类、指令检索、多标签分类、成对分类、重排序、检索、语义文本相似度和摘要。论文使用这些数据评估多语言和英语设置下的文本与代码嵌入。该节选未描述该基准的训练划分、混合比例、过滤流程、裁剪策略或元数据模式。
-
视觉数据。 作者使用 MMEB-v2 和 MIEB(lite)。MMEB-v2 包含覆盖图像、视频和视觉文档模态的 78 个任务,包括 PDF、幻灯片和图表,任务类型包括检索、分类、问答、视觉定位和时刻检索。MIEB(lite) 补充了线性探针分类、聚类、多选题、组合性和视觉语义文本相似度。这些数据集用于评估跨模态和混合模态视觉嵌入,包括零样本行为和线性探针测量。该节选未指定各子集的过滤规则、裁剪策略、元数据构建方式或训练划分与混合比例。
-
音频数据。 作者使用 MAEB 和 MSEB(Retrieval)。MAEB 包含五个声学域中的 30 个任务:语音、音乐、环境声、生物声学以及情感。它覆盖单模态和跨模态检索、重排序、聚类和分类。MSEB(Retrieval) 聚焦多语言语音理解,并在 26 种语言和区域设置下评估同语言和跨语言场景中从语音查询检索文本段落。论文使用这些数据集比较原生音频嵌入与基于 ASR 的文本嵌入,并评估较低维度下的截断嵌入,包括讨论中的 256 维和 128 维设置。该节选未提供训练划分、混合比例、过滤规则、裁剪策略或元数据模式。
-
总体使用。 所描述的数据集是评估基准套件,而不是新构建的训练语料库。作者使用它们评估模态特定和跨模态嵌入质量、任务类型性能、语言覆盖范围以及低维嵌入的影响。
实验
实验在覆盖文本、代码、图像、视频、视觉文档和音频的广泛嵌入基准上评估 EmbeddingGemma 2,并通过消融实验隔离关键设计选择的影响。结果显示,共享的逐层输入、对比微调阶段以及可训练的视觉编码器能够提升多模态表示质量,而视觉 token 预算则在效率与特定模态准确性之间进行权衡。在主要评估套件中,相对于更大或专家基线,该模型提供了较强的通用嵌入,尤其在多语言文本、代码、视觉和原生音频方面表现突出,但在某些零样本副语言音频任务中仍存在弱点。
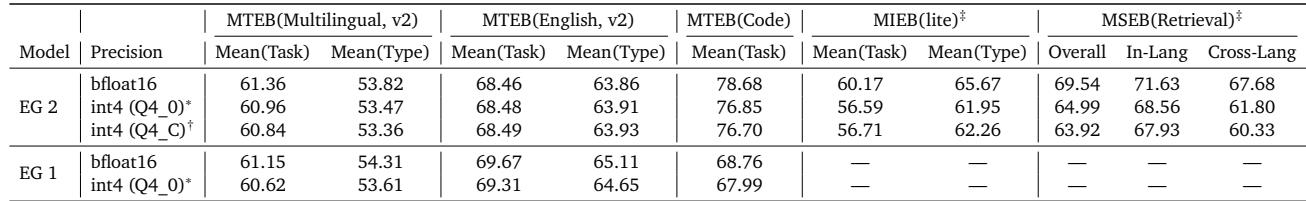
量化后的 int4 EmbeddingGemma 2 检查点在多语言、英语和代码文本基准上仍接近 bfloat16 基线,按块量化和按通道量化表现相似。最明显的退化出现在音频检索中,其分数下降比文本任务更明显,尤其是在跨语言检索中。EmbeddingGemma 1 在其报告的文本基准指标上也呈现类似的量化趋势。文本和代码嵌入对 int4 量化较为稳健。音频检索比文本检索对量化更敏感,其中跨语言性能出现更明显的下降。
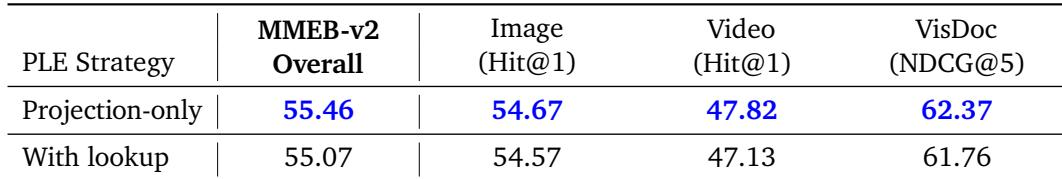
将专用的逐层嵌入查找表替换为仅投影的逐层输入可提升整体性能,并有助于 Image、Video 和 VisDoc 任务。该设计还降低了参数开销,同时从共享嵌入空间中导出逐层信号。收益在 Video 和 VisDoc 上尤为明显,其中仅投影变体的分数高于查找表变体。仅投影方案的整体性能高于使用专用 PLE 查找表。仅投影方案在 Image、Video 和 VisDoc 指标上优于查找表变体。移除查找表会降低参数开销,同时提升表示质量。
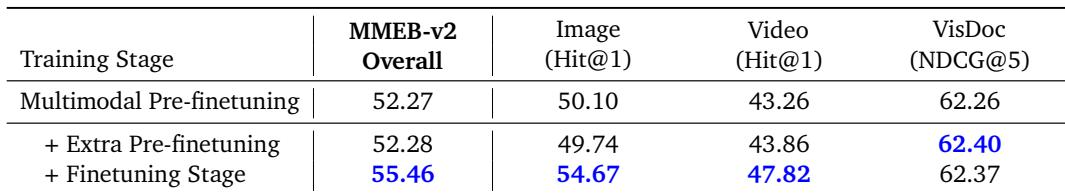
将预微调阶段延长相似的训练时长,相对于初始多模态检查点并未提升性能。进入具有对比目标和 spread-out 目标的微调阶段后,整体、图像和视频性能提升,而视觉文档分数几乎不变。这表明是训练配方变化,而非仅额外训练,使表示学习更好。额外蒸馏从预微调检查点仅带来很少收益。微调阶段在图像和视频任务上带来最明显的改进。在所测试的阶段中,视觉文档性能总体保持稳定。
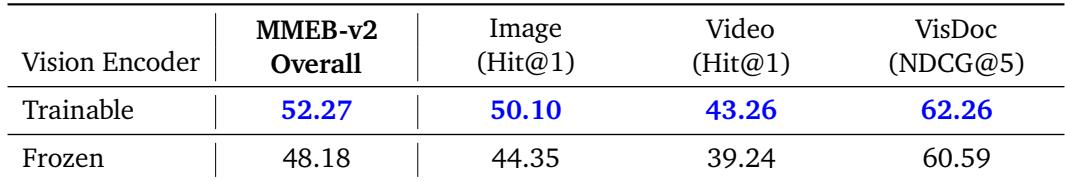
训练视觉编码器而不是将其冻结,可提升图像、视频和文档任务上的多模态嵌入性能。改进在图像和视频任务上最明显,而在 VisDoc 上的增益较小。可训练视觉编码器设置在整体多模态性能上优于冻结视觉编码器设置。图像和视频任务在训练期间更新视觉编码器时获益最大。冻结视觉编码器在 VisDoc 上仍然相对较强,但可训练调整仍提供优势。比较从相同的文本预微调检查点开始,这表明视觉编码器训练是关键差异。
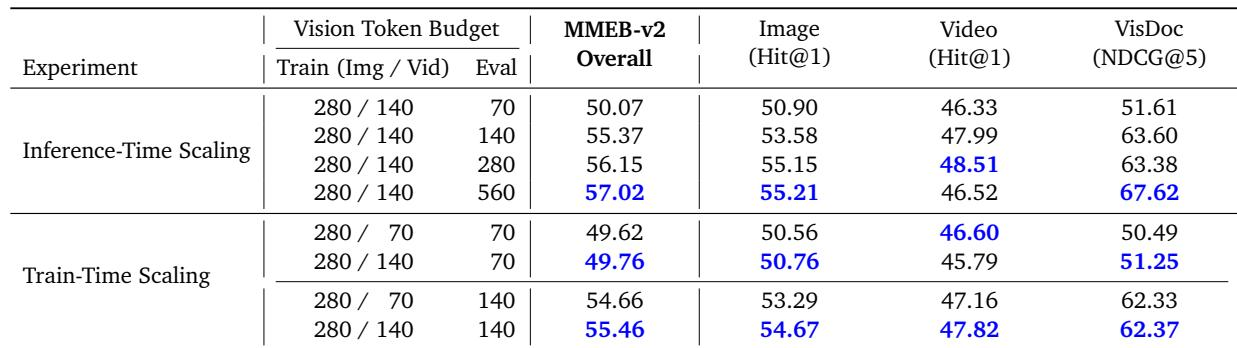
在推理阶段增加视觉 token 预算通常可提升整体视觉嵌入性能,但效果因模态而异。视觉文档任务从大于训练预算的预算中获益明显,而图像质量往往趋于饱和,视频性能在非常大预算下可能下降。使用较小的逐帧视频预算训练会在匹配的小预算评估下改善视频任务,但会削弱图像和视觉文档性能。较大的推理视觉 token 预算会提升整体性能,尤其是视觉文档任务。小预算视频训练有助于在小推理预算下的视频检索,但会降低图像和视觉文档质量。
实验评估了 int4 量化、逐层输入设计、训练阶段变化、视觉编码器调优以及推理视觉 token 预算在文本、代码、音频、图像、视频和视觉文档任务上的表现。结果表明,int4 量化能较好地保留文本和代码嵌入,但会削弱音频检索,尤其是跨语言检索,而仅投影的逐层输入能提升整体性能并降低参数开销,对视频和视觉文档尤其有清晰收益。仅延长预微调带来的收益很小,但进入对比微调并训练视觉编码器会提升表示质量,尤其对图像和视频任务。较大的推理视觉 token 预算有助于整体视觉嵌入和视觉文档,但非常大的预算可能饱和或损害视频性能。