Command Palette
Search for a command to run...
CodeCap-Bench:代码能否作为良好的视频描述?
CodeCap-Bench:代码能否作为良好的视频描述?
摘要
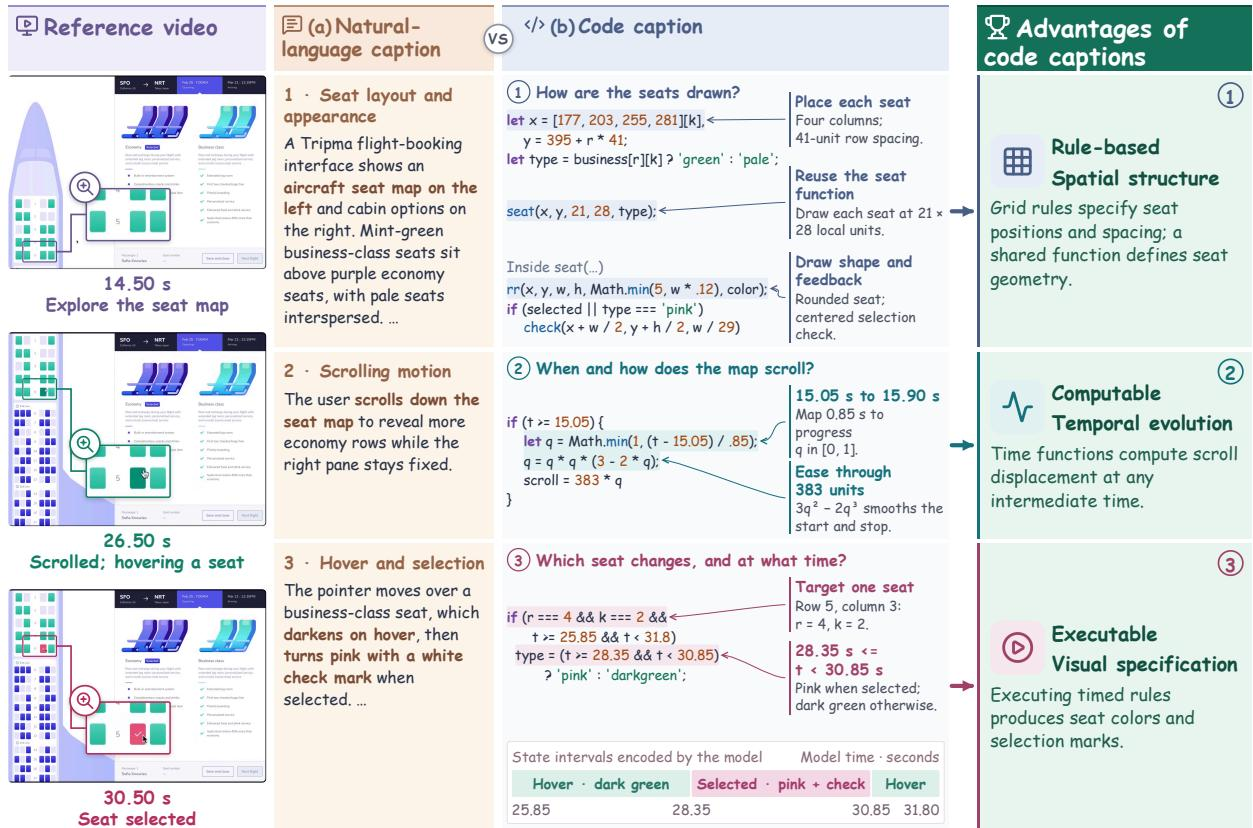
视频描述生成旨在通过紧凑的描述来保留视觉信息,且主要采用自然语言。然而,用自然语言精确表达细粒度的空间结构和时间动态往往会使描述冗长且可能产生歧义。在本文中,我们探索了代码作为视频描述(Code as Video Caption)这一范式,其中可执行程序通过图形基元、布局规则和时间函数充当视觉内容的互补表示。为了检验代码描述能否有效保留视频信息,我们在下游问答和视频重建任务上将它们与自然语言描述进行了比较。结果表明,代码描述实现了更高的推理准确率和重建保真度。尽管有这些优势,代码描述生成潜力的实现仍取决于当前多模态大语言模型(MLLM)能否生成忠实的代码描述。为系统评估这一能力,我们提出了 CodeCap-Bench,它包含 323 个视频,涵盖五类结构化 2D 内容,并配有细粒度标注和多层次评估框架。大量实验表明,尽管领先的闭源 MLLM 展现出有前景的代码描述生成能力,但它们仍难以忠实捕捉复杂的时间动态,开源模型则明显落后。
一句话总结
NJU、Kling AI、TJU 等提出了 CodeCap-Bench,这是一个包含 323 个视频的基准,覆盖五类结构化 2D 内容,并提供细粒度标注和多层次评估框架;结果表明,可执行代码描述在推理准确性和重建保真度上优于自然语言描述,但专有多模态大语言模型仍然难以捕捉复杂时间动态,开源模型则明显落后。
核心贡献
- 本文提出将可执行代码作为一种互补的视频描述表示,代码程序指定图形基元、布局规则和时间函数;结果表明,代码描述在推理准确性和重建保真度上优于自然语言描述。
- 本文提出了 CodeCap-Bench,这是一个包含 323 个视频的基准,覆盖五类结构化 2D 内容,提供细粒度焦点标注和对象级时空标注,并包含多层次评估框架,覆盖全局视觉相似性、对象级时空对齐和细粒度视觉信息保留。
- 在 CodeCap-Bench 上对多模态大语言模型进行系统评估表明,领先的专有模型表现出有前景的代码描述能力,但仍然难以忠实捕捉复杂时间动态,而开源模型明显落后;agentic 工作流提高了渲染成功率,但并未一致提升描述保真度。
引言
作者探索将可执行代码作为结构化 2D 视频的互补视频描述格式,此类视频包括界面录制、2D 游戏、可视化和动态图形等。代码描述可以指定图形基元、布局规则和时间逻辑,使空间结构、运动轨迹和状态变化比自然语言描述更加明确。先前的自然语言描述方法通常需要冗长的位置、时间和关系约束,并且此前没有专门基准用于评估多模态大语言模型生成代码描述的忠实程度。为此,作者提出了 CodeCap-Bench,这是一个包含 323 个视频的基准,具有细粒度焦点标注和时空标注,并通过将生成的代码渲染为视频来评估视觉相似性、对象级时空 IoU 和细粒度视觉信息保留。
数据集
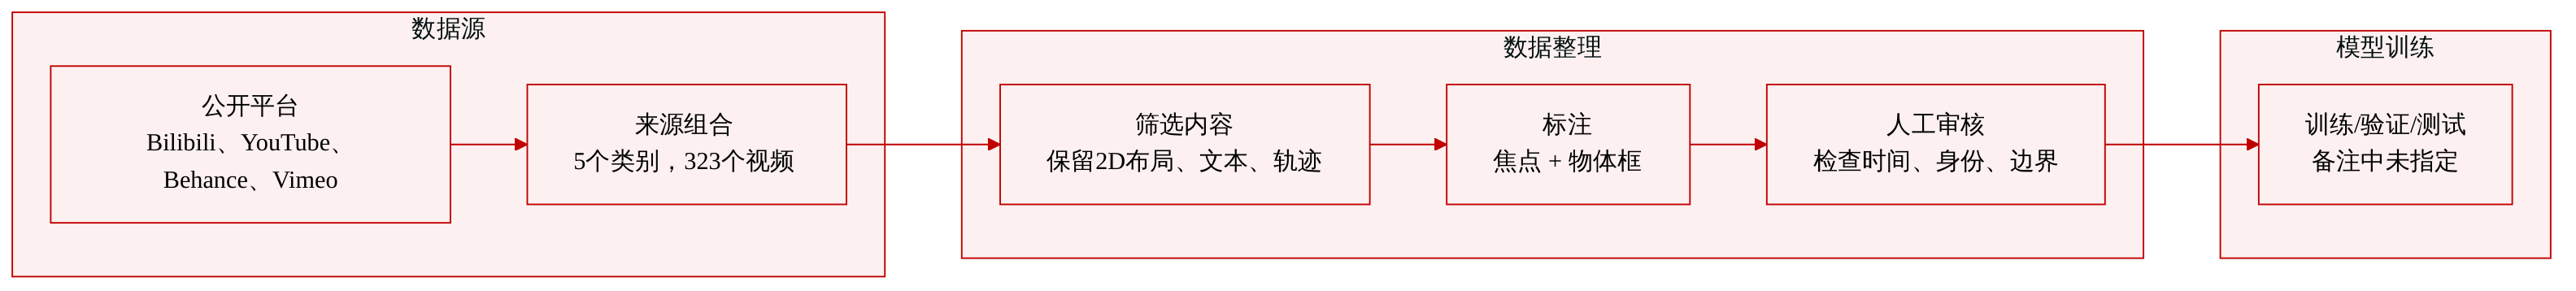
- 作者通过三阶段流程构建 CodeCap-Bench:多源视频收集、内容过滤以及带人工审核的细粒度标注。
- 数据集聚焦于结构化 2D 视频,其中细粒度视觉细节、空间布局和时间动态是核心。
- 候选视频来自 Bilibili、YouTube、Behance 和 Vimeo 等公共平台。
- 基准覆盖五个类别:
- 桌面和应用程序界面
- 2D 游戏
- 视觉设计和媒体动画
- 数据和科学可视化
- 图标和抽象动态图形
- 内容过滤保留以 2D 布局、形状、文本和明确对象轨迹为主的视频,排除以复杂 3D 视角、细节纹理或密集像素级动态为主的视频。
- CodeCap-Bench 在五个类别中共包含 323 个视频。
- 视频时长平均为 19.0 秒,中位数为 17.0 秒。
- 每个视频平均包含 16.8 个标注对象和 8.6 个静态与动态焦点。
- 标注焦点区间的平均时长为 3.3 秒,中位数为 1.8 秒。
- 提供两种标注类型:
- 焦点标注通过描述和时间戳识别关键静态特征或动态过程。静态焦点捕获外观、构图、空间关系和文本呈现。动态焦点捕获状态变化、运动过程、节奏和时间协调。
- 对象级时空标注记录关键对象的可见区间和逐帧边界框。
- 对象级空间标注通过视频分割模型获得,该模型由边界框提示以及代表性帧上的正/负点提示引导。
- 所有标注均经过人工审核和修正。审核人员检查焦点代表性、描述准确性、时间定位、对象身份一致性、可见区间和空间边界。
- 所提供的章节将 CodeCap-Bench 描述为用于评估模型通过可执行代码表达视觉信息和时空关系的忠实程度的基准,并未指定训练划分或混合比例。
方法
作者将基于代码的视频描述定义为通过可执行程序表达视觉内容及其时间演化的任务。给定时长为 T 的参考视频 V,目标是生成代码描述 C,以捕获其视觉元素、空间布局和时间动态。与自然语言描述不同,代码描述使用图形基元、布局规则和时间逻辑,明确指定视觉元素如何随时间构建、排列和更新。通过渲染引擎 R 执行代码会生成视频 V^=R(C),其视觉状态在视觉外观、空间结构和时间动态方面与参考视频 V 进行评估。
为支持该任务,作者通过结构化三阶段流程构建了 CodeCap-Bench 数据集,包括多源视频收集、内容过滤以及带人工审核的细粒度标注。
如下图所示:
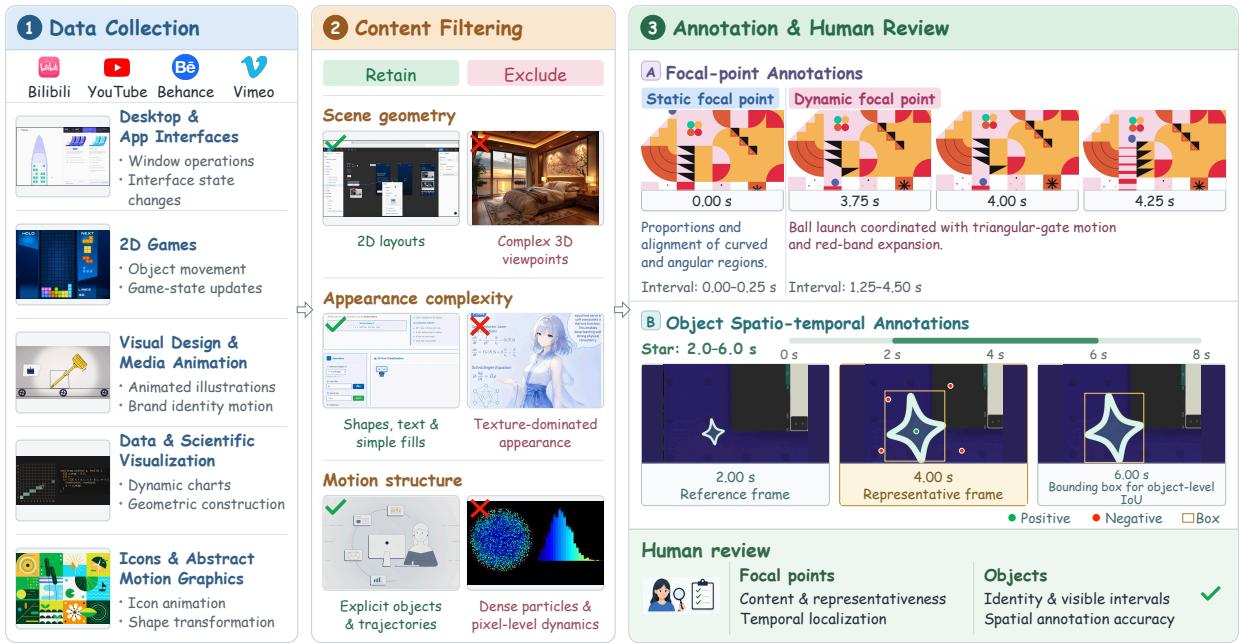
在数据收集阶段,候选视频来自 Bilibili、YouTube、Behance 和 Vimeo 等公共平台。收集范围涵盖五个类别:桌面和应用程序界面、2D 游戏、视觉设计和媒体动画、数据和科学可视化以及图标和抽象动态图形。这些类别包含多样的视觉内容和动态模式,包括窗口操作、页面滚动、对象运动、动态图表、几何构造和形状变换。
内容过滤阶段根据场景几何、外观复杂度和运动结构细化候选池。作者保留以 2D 布局、形状、文本和明确对象轨迹为主的视频,排除以复杂 3D 视角、细节纹理或密集像素级动态为主的视频。该选择确保基准始终聚焦于适合程序化表示的视觉内容。
最后,标注与人工审核阶段提供两种标注:焦点标注和对象级时空标注。焦点标注通过描述和相应时间戳识别关键静态特征或动态过程。静态焦点捕获外观、构图、空间关系和文本呈现,动态焦点捕获状态变化、运动过程、节奏和时间协调。对象级时空标注记录关键对象的可见区间和逐帧边界框。作者使用视频分割模型获得空间标注,该模型由边界框提示以及代表性帧上的正/负点提示引导。所有标注均经过严格的人工审核和修正,以确保焦点具有代表性且定位准确,并确保对象级标注保持身份一致、可见区间正确和空间边界准确。
实验
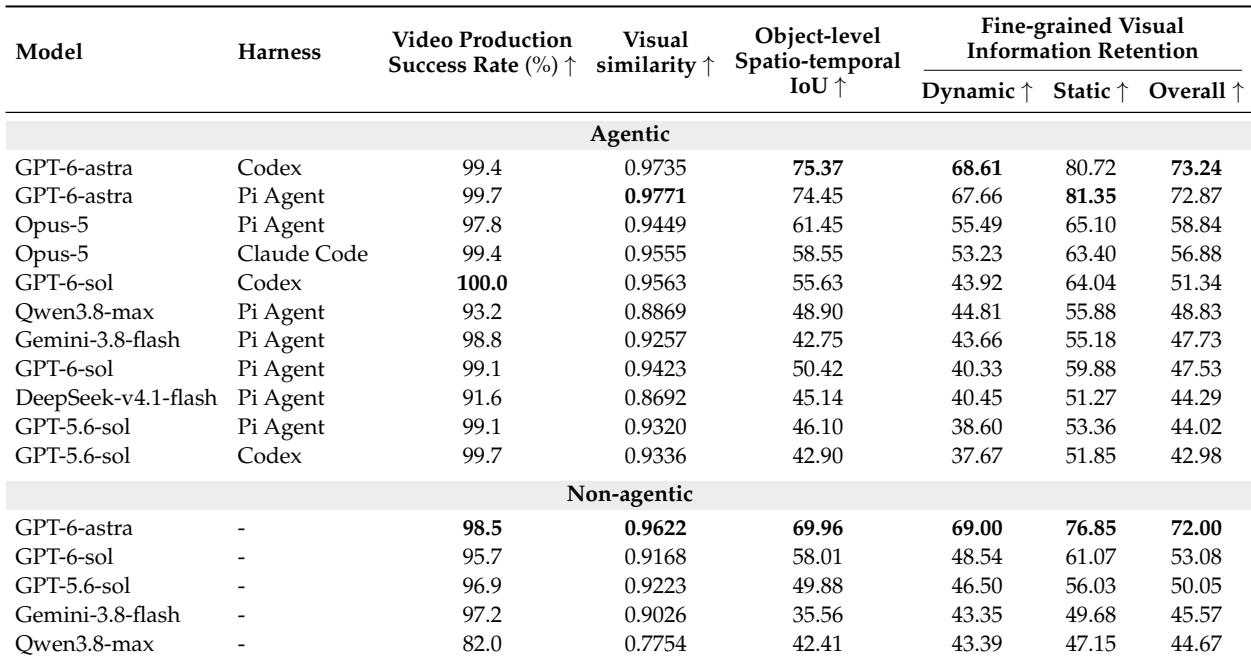
实验在 agentic 和非 agentic 设置下,对七个多模态模型评估代码描述保真度,使用视觉相似性、对象级时空对齐和细粒度视觉信息保留。结果表明,视频生成成功并不保证忠实保留信息,动态信息始终比静态信息更难保留,agentic 工作流、思考强度和工具使用带来的收益因模型而异。评估指标与人类判断高度一致,代码描述在重建和问答中保留了比自然语言描述更多有用的视觉和时空信息,工具辅助反馈有助于纠正时间错误。
在中等思考强度下,GPT-6-astra 在 agentic 和非 agentic 设置中均表现出最强的细粒度视觉信息保留,其 Codex 配置在 agentic 运行中的整体保留率和对象级时空 IoU 方面领先。高视频生成成功率并不保证视觉保真度,因为某些接近完美生成成功的模型保留的视觉信息少得多。动态视觉内容始终不如静态内容被忠实保留,agentic 生成提高了生成成功率,但并不总能提高保留率。GPT-6-astra 获得了最高的整体细粒度视觉信息保留率,其 Codex 配置在 agentic 设置中的对象级时空 IoU 方面领先。完美的视频生成成功率并不能确保忠实的视觉保留;带 Codex 的 GPT-6-sol 达到完全生成成功,但整体保留率远低于 GPT-6-astra。跨模型和生成配置,动态视觉信息的保留均不如静态信息忠实。agentic 生成持续提高视频生成成功率,但其对视觉保真度的影响因模型而异,并且可能降低某些模型的整体保留率。
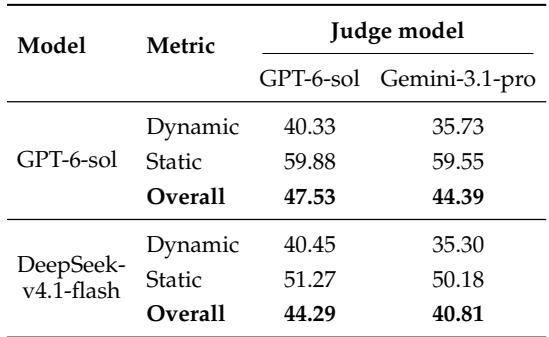
报告的质量分数显示,在两个评判模型下,两个被评估模型的静态指标始终高于动态指标和整体指标。由 GPT-6-sol 评判时,整体分数高于由 Gemini-3.1-pro 评判时的整体分数;GPT-6-sol 模型在静态分数和整体分数上领先,而动态分数保持接近。在两个评判模型下,两个被评估模型的静态分数均高于动态分数和整体分数。两个评判模型在静态分数上高度一致,但在动态分数和整体分数上存在分歧,Gemini-3.1-pro 给出的值更低。GPT-6-sol 比 DeepSeek-v4.1-flash 获得更高的静态分数和整体分数,而动态分数几乎持平。
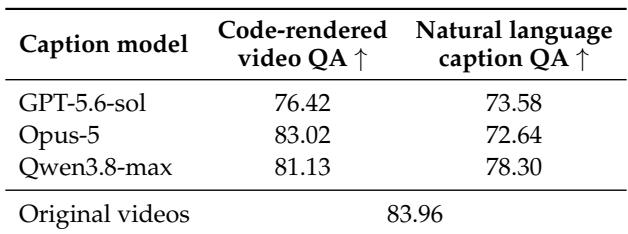
代码渲染视频在问答准确率上高于自然语言描述,且对所有三个描述模型均成立。提升幅度约为 2.8 到 10.4 个百分点,最佳代码渲染结果接近原始视频基线。在所有描述模型中,代码渲染视频准确率始终高于自然语言描述准确率。Opus-5 的提升最大,准确率最接近原始视频。整体提升幅度约为 2.8 到 10.4 个百分点。
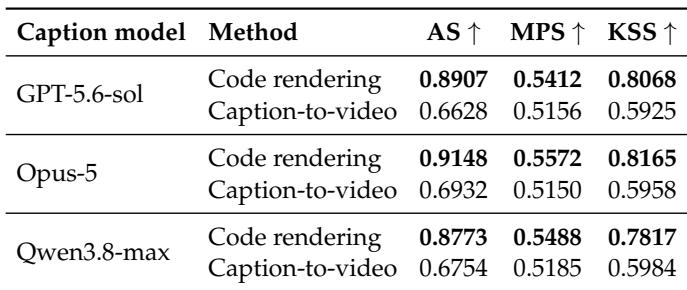
在所有三个描述模型和所有报告指标上,代码渲染的重建保真度始终高于描述到视频生成。外观和关键帧结构相似性的优势最大,而运动模式相似性的提升幅度较小。这些结果表明,可执行代码描述比自然语言描述保留了更精细的视觉和时空结构。在每个描述模型中,代码渲染在外观相似性、运动模式相似性和关键帧结构相似性方面均优于描述到视频生成。外观和结构相似性的提升最为显著,运动模式相似性也有较小但一致的提升。在使用代码渲染的设置中,Opus-5 获得了最高的外观和结构相似性分数。
实验比较了不同视频生成配置下的细粒度视觉保留、评判模型评分质量、问答准确率和重建保真度。agentic 生成提高了生成成功率,但并不总能提高视觉保留率;GPT-6-astra 保留了最佳视觉信息;跨模型而言,动态内容的保留不如静态内容忠实。静态质量分数高于动态分数和整体分数,评判模型在静态指标上更一致,在动态分数和整体分数上存在分歧。代码渲染描述在问答准确率和重建保真度上始终优于自然语言描述到视频基线,且在外观和关键帧结构方面提升最大。