Command Palette
Search for a command to run...
GameVerse:面向长时程交互式世界建模的分钟级游戏视频数据集
GameVerse:面向长时程交互式世界建模的分钟级游戏视频数据集
Kang He Wenshuo Peng Chuanhao Li Zihui Gao Xiaojie Xu Zhengyuan Lin Yuzhe Ding Donghong Ji Kaipeng Zhang Yongtao Ge
摘要
交互式世界模型的最新进展已使根据动作输入生成可控、动态的环境成为可能。然而,当前模型难以在约一分钟以上的推演(rollout)中保持连贯性——这一局限并非源于模型容量,而在于长时程训练数据的匮乏。现有游戏视频数据集通常由不足十秒的片段组成,其文本描述粗略且不加区分地概述整个片段,这不足以支持可控的长时程生成。我们通过 GameVerse 解决这一问题,这是一个专为长时程交互式世界建模构建的分钟级游戏视频数据集。GameVerse 包含 69.7K 个片段,共计 1,655 小时、349.6M 帧,涵盖多种第一人称和第三人称游戏玩法,其中包括 1,358 小时的连续两分钟序列——比以往数据集长出一个数量级。所有片段均经过统一流程处理,包括场景一致性分割、质量过滤、相机位姿估计和基于事件的描述标注。每个片段配有在数分钟尺度上保持连贯且时间上稳定的相机轨迹,以及将静态场景上下文与动态前景事件区分开、并与事件边界而非固定时间窗口对齐的文本描述。全面分析表明,GameVerse 在规模、多样性和标注质量上均优于现有公开数据集。实验进一步证明,在 GameVerse 上训练可显著扩展交互式世界模型的时间视野。
一句话总结
来自 Alaya Lab、上海创新研究院、武汉大学和清华大学的研究人员提出了 GameVerse,一个分钟级游戏玩法视频数据集,包含 69.7K 个片段、1,655 小时和 3.496 亿帧,其中包括 1,358 小时连续两分钟序列,具有时间稳定的相机轨迹和事件对齐的描述,将静态场景上下文与动态前景事件分离,在规模、多样性和标注质量上超过现有公开数据集,并大幅扩展交互式世界模型的时间视野。
核心贡献
- GameVerse 是一个分钟级游戏玩法视频数据集,包含 69.7K 个片段、1,655 小时和 3.496 亿帧,其中包括 1,358 小时连续两分钟游戏玩法序列。
- 该数据集通过统一处理和标注流程构建,产生经过质量过滤的帧级相机轨迹和四级层次化描述;轨迹经过针对跳变、抖动和漂移的过滤,而描述将静态场景上下文、动态事件和 agent 动作对齐到事件边界。
- 在 GameVerse 上训练大幅扩展交互式世界模型的时间视野,并改善 60 秒生成中的时间连贯性、几何一致性和视觉质量;相同主干网络上的对比验证了 GameVerse 微调的收益。
引言
交互式世界模型旨在学习能够根据动作和相机输入展开的动态环境,这对具身决策、模拟和游戏风格内容生成很重要。近期 GameGen-X 和 Matrix-Game 等游戏系统显示出较强的短时程控制能力,但推演大约一分钟后就会退化,因为它们的训练数据大多由不足十秒的片段组成,整段描述混合了静态场景上下文和动态事件。现有数据集也割裂了所需监督信息,将分钟级视频、经过验证的相机轨迹、密集交互覆盖和事件对齐的语义标注分开。作者用 GameVerse 解决这一缺口,这是一个分钟级游戏数据集,提供 69.7K 个片段和 1,655 小时视频,包括 1,358 小时连续两分钟序列,以及经过验证的帧级相机轨迹和四级事件对齐描述,将场景上下文与 agent 行为分离。
数据集
数据集:GameVerse
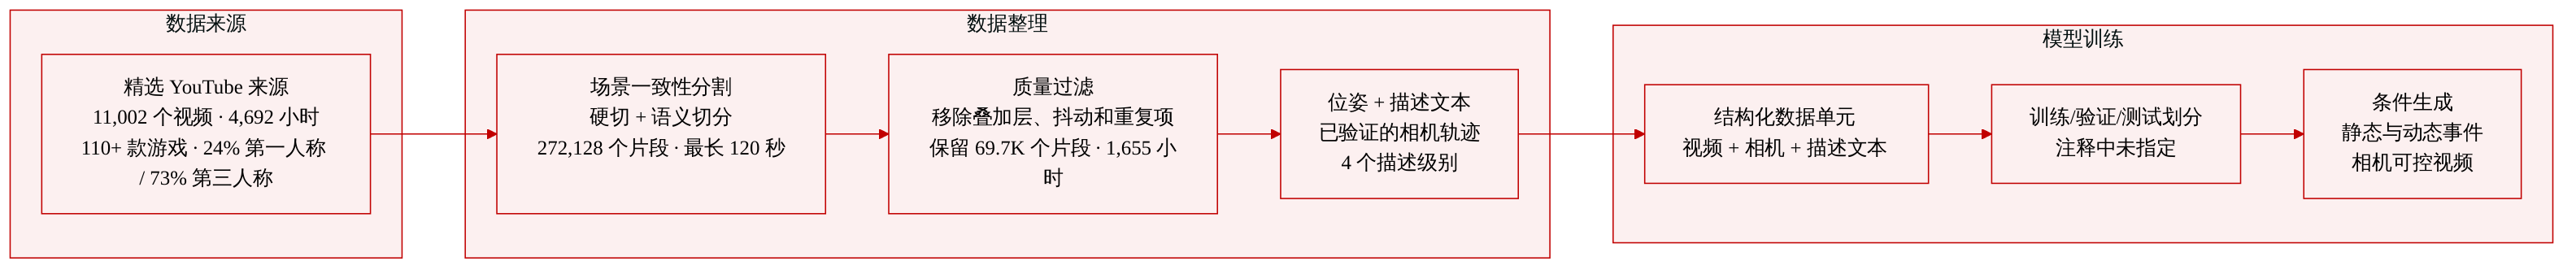
作者从长时 YouTube 游戏玩法视频构建 GameVerse,并将其转换为分钟级数据单元。每个单元包含对齐的视频片段、经过验证的相机轨迹和多粒度描述集。
来源与原始组成
- 来源:从开放世界 AAA 和独立游戏中按游戏标题精选 YouTube 游戏玩法视频,选择第一人称和第三人称视角以及多样的玩家行为。
- 原始规模:11,002 个源视频,总计 4,692 小时、195.5 天和约 986.6M 帧,保留最高 1080p、30 到 60 FPS。
- 游戏覆盖:至少 110 个不同游戏标题。分布呈长尾,头部游戏包括《战神》、《荒野大镖客2》、《对马岛之魂》、《艾尔登法环》和《巫师3》,每款贡献超过 1,800 个片段。
- 视角组合:24% 第一人称,73% 第三人称跟随相机,3% 特殊视角,如无人机、车载、云台跟随或固定视角。
- 行为覆盖:探索、战斗、行走、奔跑、驾驶、交互、攀爬和闲置。
- 环境覆盖:城市、乡村、森林、公路、神庙和工业环境,具有不同的建筑、天气、一天中的时间、季节和人群密度。
处理与过滤
- 时序分割:TransNetV2 检测硬切,而基于 CLIP 的余弦语义距离检测相机平移或 UI 变化等渐变转场。该流程提取最长 120 秒的场景一致片段,这些片段可拼接为更长序列。
- 分割输出:272,128 个片段,总计 4,661 小时,其中 120 秒片段贡献约 2,773 小时。
- 多阶段质量评估:过滤移除低分辨率或损坏视频;基于 OCR 的检测移除字幕、HUD 元素和叠加层;稳定性检查识别不稳定运动和时序伪影;去重和多样性选择降低冗余;COVER 和 VBench 等时序指标优化时序质量。
- 质量评分:每个片段获得各阶段得分的加权和,阶段特定约束可防止严重缺陷被其他维度的高分掩盖。
- 相机位姿处理:ViPE 估计逐帧的相机内参和外参。估计出的轨迹经过验证并针对突然跳变、高频抖动和长期漂移进行过滤。
- 描述生成:视觉语言模型 Kimi-K2.5 生成结构化描述,包含四个组成部分:全局静态、局部静态、动态事件和 agent 动作。
- 所描述的处理主要集中在时序分割和过滤;提供的章节未指定单独的空间裁剪策略。
最终数据集统计
- 最终高质量集合:69.7K 个游戏玩法片段,总计 1,655 小时,其中包括 1,358 小时两分钟连续视频。
- 长时程分布:超过 40.6K 个片段达到 120 秒上限。60 秒或更长的片段构成可观的分钟级部分。
- 相机运动分布:向前运动占 34.7%;复杂平移加旋转占 22.0%;还包含静止、横向、环绕、旋转、平移和混合运动。
- 描述统计:局部静态描述的中位长度为 895 个字符;动态事件描述的中位长度为 775 个字符。全局静态和 agent 动作描述较短,其中 agent 动作来自受限词汇表。
- 描述分离:四级描述使用大体不相交的词汇表,覆盖场景属性、空间布局、环境过渡和显式运动。
论文如何使用该数据
- 每个结构化数据单元组合了对齐视频、经过验证的相机轨迹和四级描述集。
- 多粒度描述提供分层语义监督,并将静态上下文与动态事件和 agent 动作分离,支持条件生成。
- 相机轨迹支持相机可控视频合成、几何感知生成以及视角变化下的交互式世界建模。
- 提供的章节未说明明确的训练、验证或测试集划分大小或混合比例。
方法
作者设计统一数据构建流程,将长时游戏玩法视频转换为结构化分钟级数据单元。每个单元包含对齐视频片段、经过验证的相机轨迹和多粒度描述集。如下图所示,该流程通过多个不同阶段处理原始视频池,以克服时序结构、相机位姿稳定性和语义标注方面的局限。
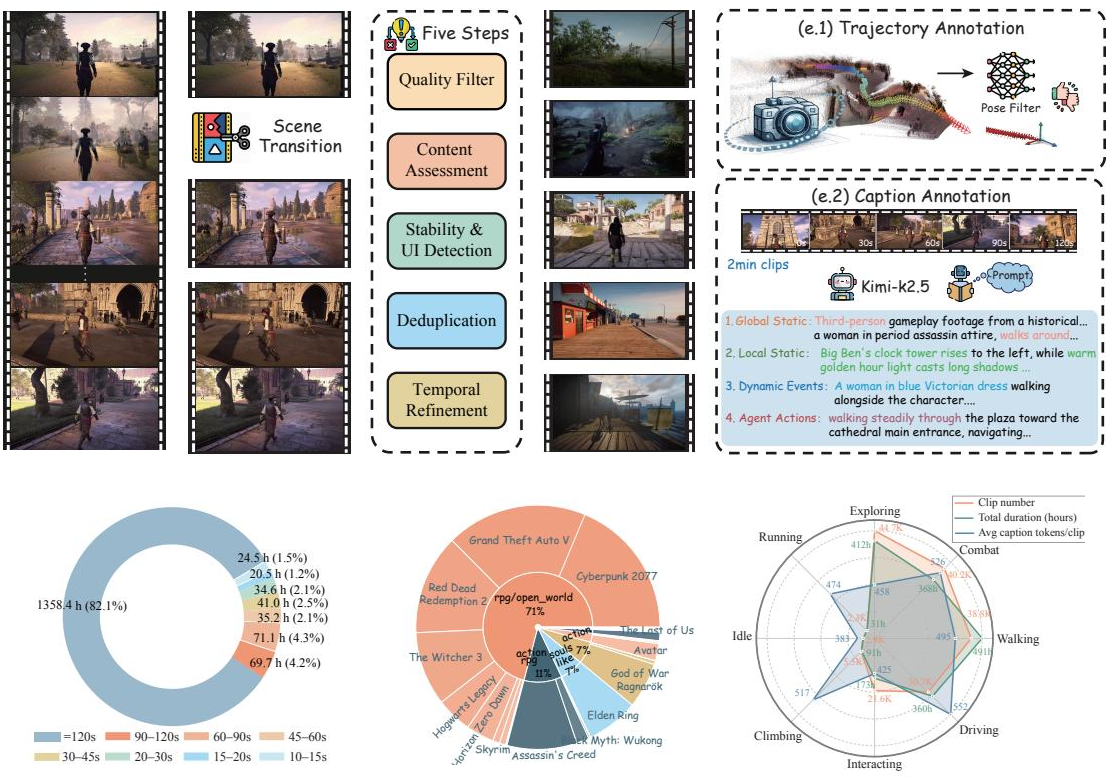
针对碎片化时序结构,作者通过移除场景转场构建连续片段。他们使用 TransNetV2 基于帧级转场概率检测突然硬切。为了捕捉相机平移或 UI 状态变化等渐变转场,他们计算采样帧之间基于 CLIP 的余弦语义距离,将大幅语义跳跃视为平滑转场边界。该组合方法提取最长 120 秒的场景一致片段。
分割后,原始视频仍可能包含干扰性视觉信号,例如字幕、水印、UI 叠加层和压缩伪影。为确保视觉保真度和时序连贯性,作者实现多阶段视频质量评估流程。有关该过滤工作流的详细分解,请参考框架图。
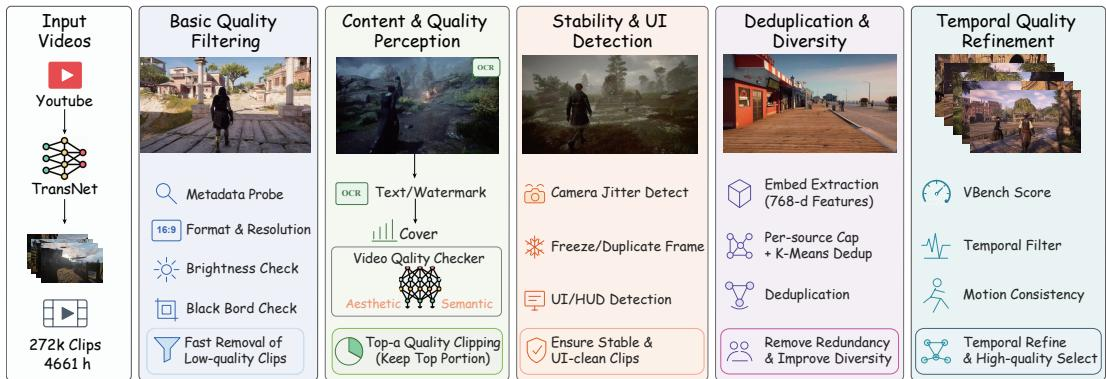
该流程逐步执行针对低分辨率或损坏视频的基础过滤,随后使用基于 OCR 的检测进行内容和质量评估,以移除字幕和 HUD 元素。后续阶段包括稳定性和 UI 检测,用于识别不稳定运动模式;去重和多样性选择,用于消除高度相似样本;以及利用 COVER 和 VBench 一致性得分等指标进行时序优化。片段整体质量计算为各阶段得分的加权和,阶段特定约束可防止严重缺陷被其他维度的高分掩盖。
在几何建模方面,作者应用 ViPE 估计逐帧相机位姿,获得内参和外参。由于动态场景中的位姿估计容易受到噪声和跟踪失败影响,他们针对三种常见错误模式验证每个估计位姿:突然跳变、高频抖动和长期漂移。统一轨迹质量函数结合局部相对位姿增量和全局轨迹平滑项,并采用基于阈值的过滤移除不可靠样本。
为了细粒度捕捉游戏玩法语义而不将静态上下文与动态事件混为一谈,作者引入利用视觉语言模型 Kimi-K2.5 的多粒度结构化描述生成框架。该框架将静态上下文与动态过程分离,并把每个片段的语义组织为四个互补组成部分。全局静态捕捉片段级环境和场景上下文,如地形、天气和光照。局部静态描述时序片段内相对稳定的场景配置,包括功能区域和地标。动态事件跟踪周围世界的变化,如人群移动和环境过渡。最后,agent 动作使用统一动作词汇表描述主体的行为,将动作语义与视角解耦,在多个粒度上提供显式语义监督。
实验
评估覆盖 60 秒图像到视频生成,使用 LingBot、HY-World 1.5、HY-World-FT 和 LTX-FT 在 103 个输入上进行,VBench 衡量视频质量,WorldScore 衡量可控性和世界生成质量。结果表明,在相同主干网络下,在 GameVerse 上微调一致改善时间连贯性、视觉质量、几何一致性和可控性,并能更长时间保持参考帧,在多样化游戏玩法活动中表现更好。额外验证确认多阶段过滤流程和结构化标注过程能产生稳定的相机轨迹和高质量描述,且幻觉和时序不匹配较低。
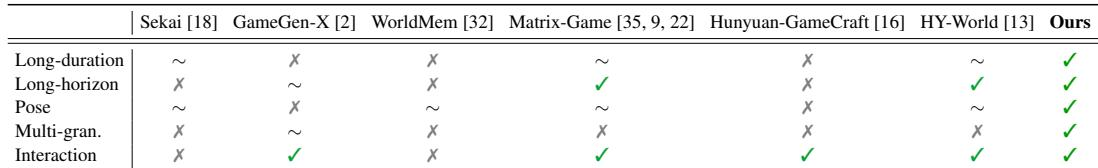
现有世界建模数据集各自覆盖理想监督要素组合中的一部分,但没有一个同时提供分钟级连续视频、长时程连贯性、已发布相机轨迹、多粒度语义和密集交互。所提出的数据集是唯一满足全部五项标准的数据集,而此前工作仍分散在单一轴上。这种分散有助于解释为什么基于单一来源训练的模型会继承特定盲区,例如短程推演或缺少位姿与语义监督。大多数数据集表现出单轴优化:Sekai 提供探索视频,但缺乏密集交互、经过验证的相机轨迹和结构化语义。Matrix-Game 和 HY-World 支持长时程和交互,但仅部分提供长时视频,并且不发布可靠相机位姿作为监督。只有所提出的数据集将长时视频、长时程、已发布位姿、多粒度标注和交互结合在一个集合中。
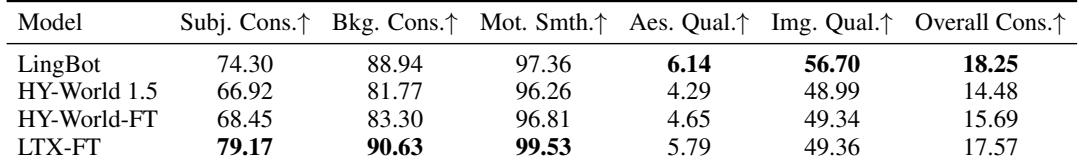
在完整 VBench 评估集上,LTX-FT 在时序一致性指标上领先,包括主体一致性、背景一致性和运动平滑度,而 LingBot 在感知质量和文本-视频对齐上领先。在相同 HY-World 1.5 主干网络上使用 GameVerse 微调改善了全部六项 VBench 指标,其中主体一致性和背景一致性的提升尤为明显。LTX-FT 实现最佳时序一致性,在主体一致性、背景一致性和运动平滑度上领先。GameVerse 微调在 HY-World 1.5 基线上一致改善全部六项 VBench 指标,尤其是主体一致性、背景一致性和整体一致性。
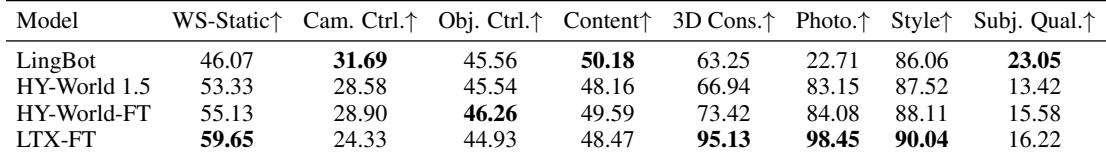
LTX-FT 实现最强的整体静态世界生成质量,在 3D 一致性、光度一致性和风格一致性上得分最高。LingBot 在相机控制、内容对齐和主观质量上领先,而 HY-World-FT 在对象控制上领先。在 HY-World 主干网络上利用 GameVerse 微调改善了每项 WorldScore 组件,最显著的是 3D 一致性。LTX-FT 记录最高静态世界得分,并在比较模型中具有最佳几何、光度和风格一致性。相同 HY-World 主干网络上的 GameVerse 微调改善所有 WorldScore 组件,其中 3D 一致性提升尤其大。
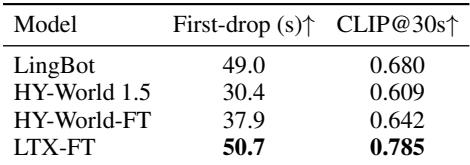
长时程一致性通过参考帧相似度随时间变化以及跨游戏玩法活动的主体一致性来衡量。LTX-FT 展示最强整体稳定性,具有最高后期相似度和最晚观察到的下降。GameVerse 微调也在时序稳定性和按活动划分的主体一致性上相对 HY-World 基础模型取得一致提升。LTX-FT 在 30 秒时达到最高参考帧相似度,并在首次下降前保持稳定性最久。在相同 HY-World 主干网络下,GameVerse 微调提高 30 秒相似度,并推迟首次低于 0.6 阈值的时间。在驾驶、骑行、奔跑和行走中,HY-World-FT 的主体一致性始终高于 HY-World 1.5,而 LTX-FT 在所有活动中领先。
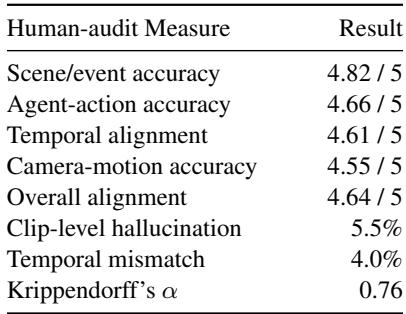
对 400 个片段的人工评估表明,结构化描述在场景/事件和 agent 动作内容上高度准确,时间对齐和相机运动准确性也获得积极评价。整体对齐较强,标注者一致性稳定。片段级幻觉和时序不匹配保持较低。场景/事件准确性和 agent 动作准确性是评分最高的维度,而相机运动准确性在描述质量得分中最低。只有少数片段显示幻觉或时序不匹配,整体标注者一致性稳定。
该工作评估了一个新数据集,该数据集独特地结合了长时视频、长时程连贯性、已发布相机轨迹、多粒度语义和密集交互。在 VBench 和 WorldScore 上,LTX-FT 实现最强时序和静态一致性,而 LingBot 在感知质量、相机控制和对齐上领先;在 HY-World 上使用 GameVerse 微调相对基线一致改善所有指标,尤其是主体一致性、背景一致性和 3D 一致性。长时程测试显示 LTX-FT 维持参考帧相似度最久,GameVerse 微调延缓稳定性下降。人工评估证实结构化描述在场景/事件和 agent 动作内容上高度准确,且幻觉和时序不匹配较低。