Command Palette
Search for a command to run...
TAO:面向基于 LLM 的智能体服务的工具感知联合调度
TAO:面向基于 LLM 的智能体服务的工具感知联合调度
Shuhuai Li Dongdong Ge Yinyu Ye Shengdong Ye Jianghao Lin
摘要
智能体服务在集群 GPU 上的模型推理与分布式 CPU 上的外部工具之间交替执行。在该场景中,现有系统(1)在服务评估中忽视工具返回就绪状态,浪费有限资源;(2)使用启发式策略决定 GPU 上的准入与放置,导致次优的调度决策。为弥补这一不足,我们提出 TAO,一个面向基于 LLM 的智能体服务的工具感知联合调度框架。其价值接口综合了近期工具就绪度、节点特定缓存信用及其时间感知衰减和 token 占用;一个动态规划在容量约束下联合选择并放置等待会话。在 12 个已报告的模型–工作负载–并发设置中,相较于每个指标上表现最佳的已评估最先进基线,TAO 将延迟最多降低 26.8%,将平均首 token 时间(TTFT)最多降低 36.3%,并将解码吞吐量最多提高 29.5%。
一句话总结
上海交通大学与斯坦福大学的研究者提出 TAO,一个面向基于 LLM 的 agentic 服务、具备工具感知的联合调度框架。该框架将近端工具就绪度、带时间衰减的节点级缓存信用以及 token 足迹结合到一个动态规划中,在容量约束下联合选择并放置等待会话。在 12 个已报告的模型-工作负载-并发设置中,相比每个指标上评估的最优最先进基线,TAO 最高降低 26.8% 延迟、最高降低 36.3% 平均首 token 时间、最高提升 29.5% 解码吞吐。
核心贡献
- TAO 是一个面向基于 LLM 的 agentic 服务、具备工具感知的联合调度框架,将近端工具就绪度、带时间衰减的节点级缓存信用以及 token 足迹统一到一个会话价值接口中。
- 动态规划在快照容量约束下联合选择并放置等待的 agent 会话,同时会话中断与异步重新验证将所得的准入与放置计划连接到实际执行。
- 在 12 个已报告的模型-工作负载-并发设置中,相比每个指标上评估的最优最先进基线,TAO 将延迟最多降低 26.8%,平均首 token 时间最多降低 36.3%,解码吞吐最多提升 29.5%。
引言
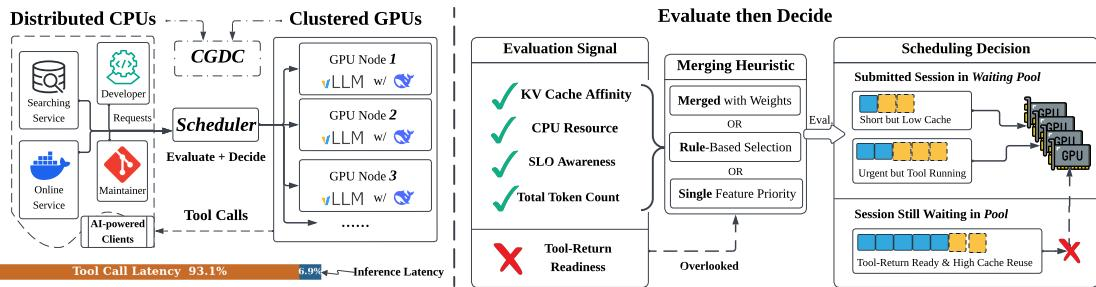
作者研究 CGDC 场景下基于 LLM 的 agent 服务,即集群 GPU 与分布式 CPU 结合的场景。在该场景中,外部工具调用会在推理请求之间产生可变间隔,并使 GPU 需求可被中断。这一点之所以重要,是因为工具执行现在贡献了可观的延迟,因此调度必须同时考虑推理容量以及会话何时会再次需要 GPU 资源。先前系统通常采用“先评估后决策”的启发式方法,单独评估每个会话,并把工具时序主要当作 KV-cache 复用或 token 数量的代理,导致会话在竞争共享容量时出现短视和次优的放置。作者提出 TAO,一个具备工具感知的联合调度框架,将会话评估中引入工具返回就绪度,并使用动态规划在等待池中联合优化准入与放置,从而在延迟、TTFT 和解码吞吐方面优于最先进基线。
方法
作者提出 TAO,该框架将会话评估与决策制定相结合,通过动态规划实现联合选择与放置。流水线将会话评估与决策制定分离,使评估接口可以演进,同时保留调度过程。如下图所示:
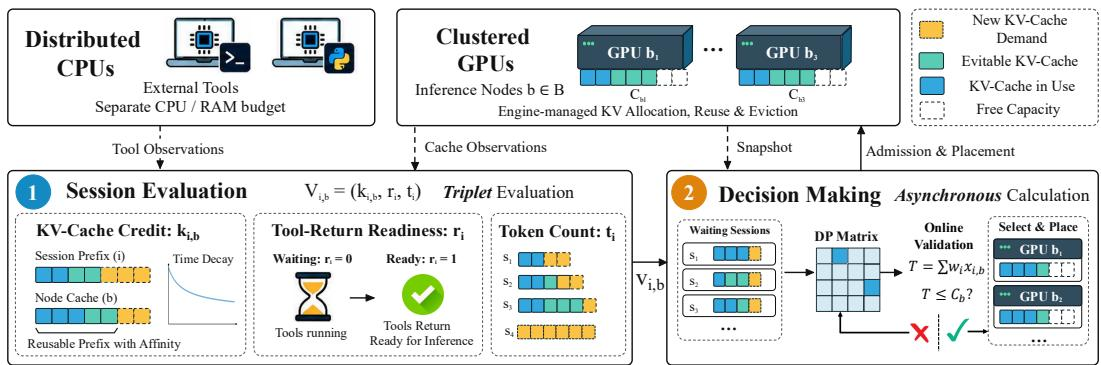
在每次重启调度决策时,等待池 P 包含等待推理准入的 agent 会话,包括被中断的会话和新到达的会话。设 B 为冻结快照中的节点。每个 agent 会话 i 具有准入成本 wi,每个节点 b 具有剩余容量 Cb。设 E⊆P×B 表示可用的分配,xi,b∈{0,1} 表示会话 i 是否被准入到节点 b。可行集定义为:
X={x:b∈B∑xi,b≤1,i∈P∑wixi,b≤Cb,xi,b=0 if (i,b)∈/E}.TAO 为每个 agent 会话-节点对赋予一个字典序价值三元组:
vi,b=(ki,b,ri,ti),其中 ki,b 是衰减后的缓存信用,ri 是二元就绪信号,ti 是 token 数量。系统联合选择并放置会话以最大化其总价值:
x⋆∈arglexmaxx∈Xi∈P∑b∈B∑xi,bvi,b.评估三元组的顺序保持固定,而其值随时间变化。KV-Cache 信用优先,因为前缀复用直接避免重复预填充。随着未刷新信用衰减,工具返回就绪度区分接近返回的 agent 会话与距离下一次模型轮次仍然较远的会话。最后,token 足迹在缓存信用与就绪度并列的计划中偏向更大的累积上下文。
为估计可复用的 KV 状态,TAO 使用观测到的已缓存 token 数量,或根据观测到的 token 量与缓存率进行估计。缓存 token 留存随时间的下降促使对较旧观测进行折减,如下图所示:
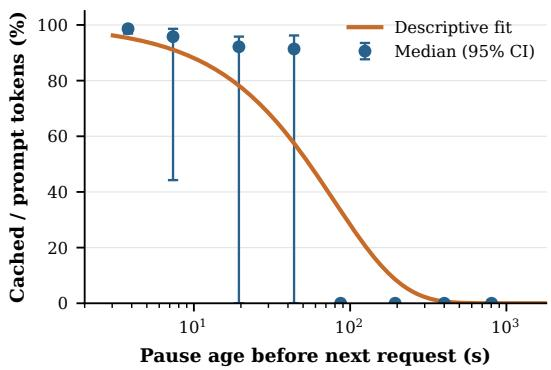
较旧观测根据时间感知衰减公式获得较少信用:
ki,b(t)=ki,b02−τi,b/h,τi,b=max(0,t−ti,bobs).此处 ki,b0 是观测到的缓存信用,h 是其衰减半衰期,设为 10 秒。这种折减使准入价值对观测年龄敏感。
对于工具返回就绪度,预测器结合来自解析后的 sleep 命令与历史工具时长的提示。对于已过去时间 ei(t) 的调用,历史估计 Df 给出:
di(t)=max{0,Df−ei(t)}.二元就绪度定义为:
ri(t)=⎩⎨⎧1,ai(t)bi(t),ai(t)gi(t)1[zi(t)≤t+H],oi(t)=1,oi(t)=0,zi(t)≤t,otherwise.此处 oi(t) 表示观测到的工具完成,ai(t) 表示已建立的工具执行候选,gi(t) 表示有效预测时间戳。zi(t) 是预测完成时间或暴露的返回期限,H 是设为 1 秒的视界。观测到的完成优先于预测检查。
优化器是一个针对多背包与广义分配结构的容量状态动态规划。设 Δ 为容量量子,wˉi=⌈wi/Δ⌉,Cˉb=⌊Cb/Δ⌋。对于候选 j,设 Dj(s) 为在前 j 个候选中、已用容量 s 下可达到的最优目标,并设 uj,b 嵌入将 j 分配到节点 b 的价值与计数:
Dj(s)=lexmax{Dj−1(s),b eligiblemaxlex[Dj−1(s−wˉjeb)+uj,b]}.仅允许 Cˉ 内的非负状态。跳过或分配每个候选穷尽可行选择,为冻结的离散化问题提供精确性。节点特定的缓存观测在预处理期间被衰减并合并到分配价值中,缓存等价节点可以分组为聚合容量维度。规划器在隔离的异步工作进程中运行,并在应用前进行重新验证。
实验
实验在 DeepSeek-V4 Flash、Qwen3-32B 和 GLM-4.7 上,将 TAO 与 vLLM 轮询调度器和缓存感知调度器、Dynamo 以及 ThunderAgent 进行对比,工作负载包括 SWE-bench Lite、SWE-verified 和 Terminal-Bench 2.0。在不同模型、并发级别与拓扑下,TAO 在任务延迟、首 token 时间与解码吞吐之间始终取得最强的整体权衡。组件分解显示,缓存感知评估、工具就绪信号与联合调度各自都能改善缓存复用、减少暂停等待并加速工具完成后的模型响应。消融实验进一步确认,移除任一组件都会降低吞吐、缓存命中率与响应性,验证了组合设计。
TAO 在测试的模型、并发级别与拓扑中是最强整体选择,同时具备持续较低的延迟与 TTFT,并伴随更高的解码吞吐。在 DeepSeek-V4 Flash 上,它在 SWE-Lite 上改善延迟、TTFT 与解码吞吐,并在 Terminal-Bench 上在延迟与 TTFT 方面领先。在 Qwen3-32B 上,它在更高工作进程数时领先 TTFT 与解码吞吐,并在大多数 SWE-verified 设置上降低延迟。相对于所示每个工作进程数下的最佳竞争方法,TAO 在 DeepSeek-V4 Flash SWE-Lite 上改善延迟、TTFT 与解码吞吐。在 Qwen3-32B SWE-verified 上,TAO 在不同工作进程数下具有最低 TTFT 与最高解码吞吐,并在大多数评估设置下降低延迟。
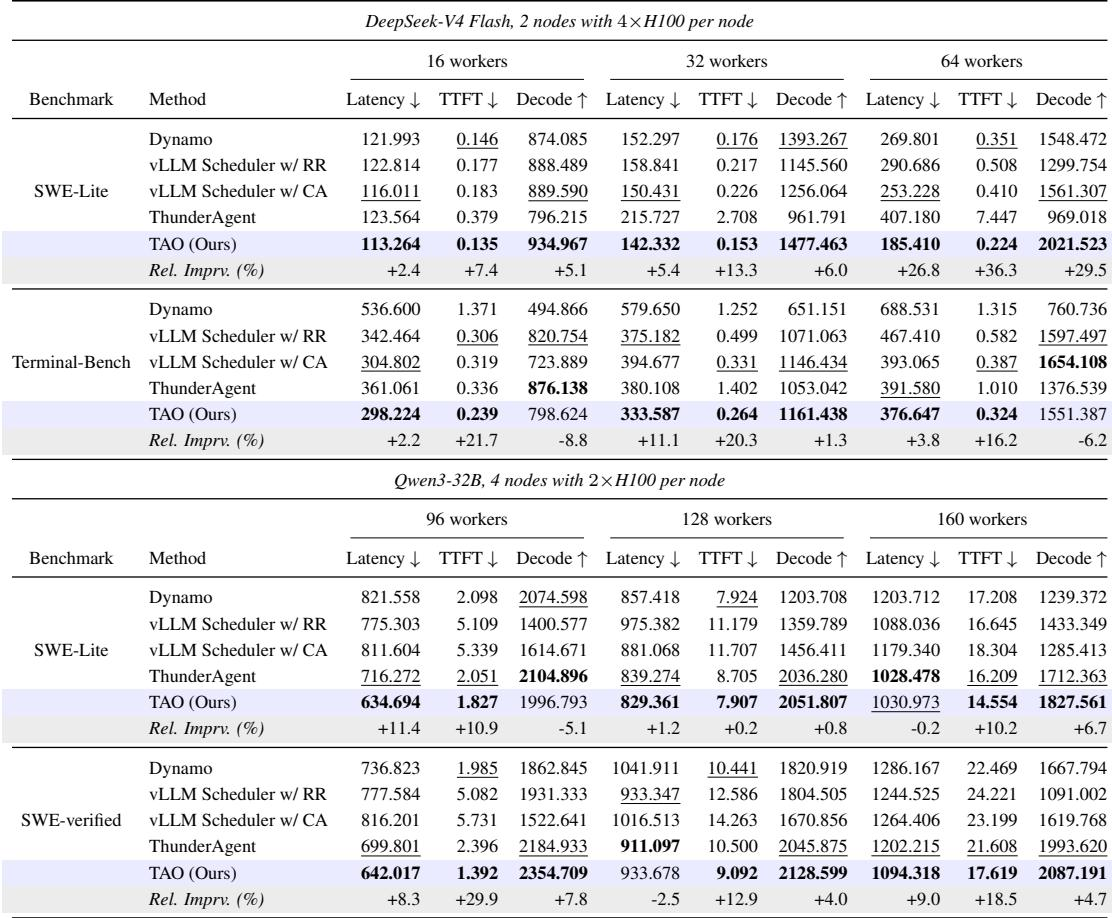
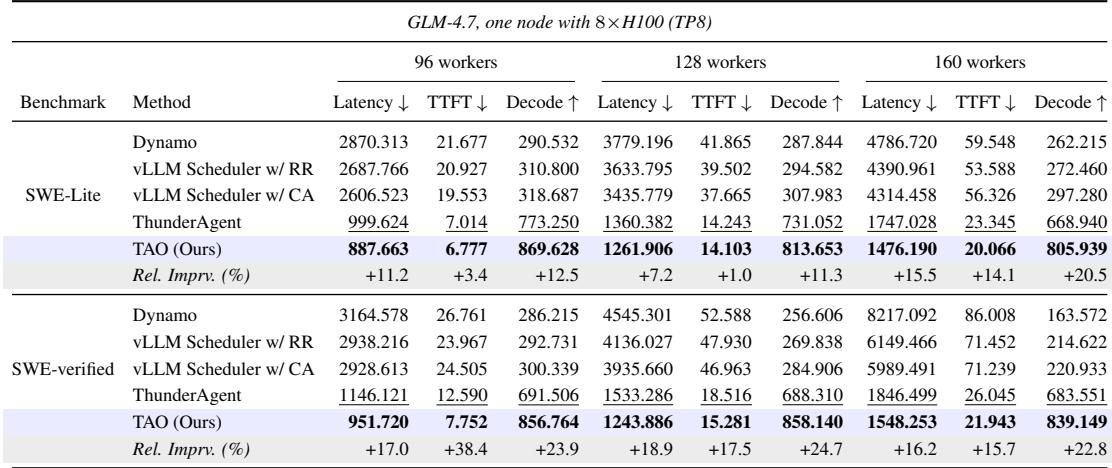
在单节点八块 H100 上的高并发 GLM-4.7 设置中,TAO 在 SWE-Lite 上优于 ThunderAgent 及其他基于 vLLM 的调度器,在 160 个工作进程时相对提升最大。该模式包括较低的平均延迟与客户端 TTFT,以及更高的解码吞吐。在完整 SWE-verified 集上,与 ThunderAgent 相比,TAO 同样降低延迟与 TTFT,同时提升解码吞吐。在所有报告的 SWE-Lite 工作进程数下,TAO 均实现比 ThunderAgent 更低的延迟、更低的 TTFT 与更高的解码吞吐,且在 160 个工作进程时改进最强。与 Dynamo 及 vLLM 调度器变体相比,TAO 在 GLM-4.7 SWE-Lite 运行中的每个并发级别都大幅降低延迟与 TTFT。在更大规模的 GLM-4.7 评估中,相对于 ThunderAgent,TAO 降低 SWE-verified 平均任务延迟与客户端 TTFT,同时提升解码吞吐。
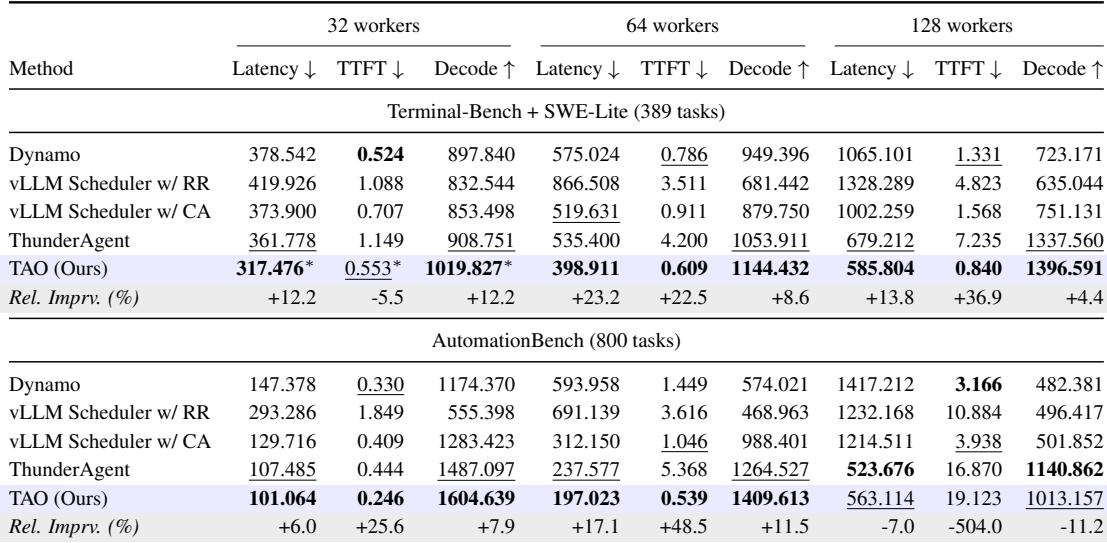
在 Terminal-Bench 与 SWE-Lite 混合工作负载上,相对于 Dynamo、vLLM 调度器变体及 ThunderAgent,TAO 在 32、64 与 128 个工作进程下实现最低延迟与最高解码吞吐。在 64 与 128 个工作进程时其 TTFT 最低,在 32 个工作进程时仅略低于最优结果。在每个评估的工作进程数下,TAO 均记录最低延迟。TAO 下的解码吞吐在每个评估的工作进程数下均高于所有列出的基线。在 64 与 128 个工作进程时,TAO 具有最低 TTFT,而在 32 个工作进程时接近观测到的最佳 TTFT。在 128 个工作进程时,TAO 相较于 ThunderAgent 表现出显著的延迟与 TTFT 优势,同时保持更高的解码吞吐。
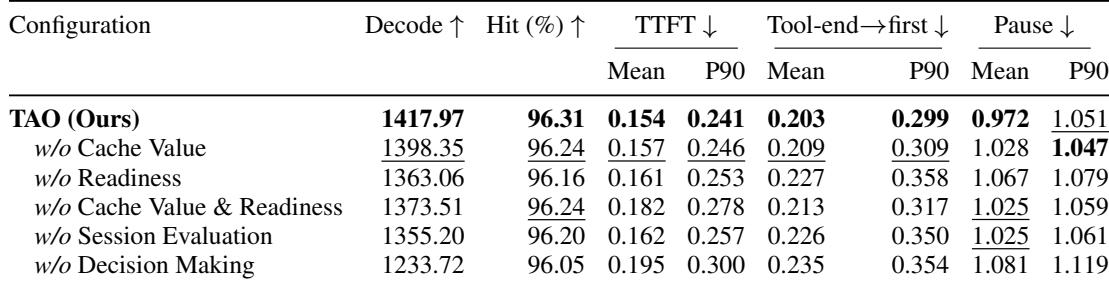
完整 TAO 配置在 SWE-Lite 上提供最强整体效率,其解码吞吐与缓存命中率最高,平均 TTFT、工具结束到首 token 延迟与暂停等待最低。移除缓存价值或就绪度会适度降低吞吐与响应性,其中就绪度损失比缓存价值损失影响更大。最大回退出现在决策制定被 best-fit-decreasing 替换时,它产生最低解码吞吐与最慢延迟指标。完整 TAO 配置在解码吞吐、缓存命中率、平均 TTFT、工具结束到首 token 延迟与平均暂停等待方面均优于所有变体。移除就绪度比移除缓存价值更明显地降低解码吞吐,而缓存命中率在不同变体间保持相对稳定。用 best-fit-decreasing 替换 DP 重调度导致最大性能下降,降低解码吞吐并产生最高的平均与 P90 延迟时间。
实验在多个模型配置、基准与并发级别上评估 TAO,包括 DeepSeek-V4 Flash、Qwen3-32B、GLM-4.7、SWE-Lite、SWE-verified、Terminal-Bench 以及混合工作负载,并与 ThunderAgent、Dynamo 及基于 vLLM 的调度器进行对比。TAO 始终实现更低延迟与首 token 时间,同时保持更高解码吞吐,最大提升出现在高并发 GLM-4.7 运行与混合工作负载中。消融研究确认完整 TAO 配置对效率与响应性很重要,其中移除就绪度或缓存价值会导致适度回退,而用 best-fit-decreasing 替换决策制定则产生最大下降。