Command Palette
Search for a command to run...
WorkFactory:将职业意图转化为可执行工作,用于可扩展智能体训练
WorkFactory:将职业意图转化为可执行工作,用于可扩展智能体训练
摘要
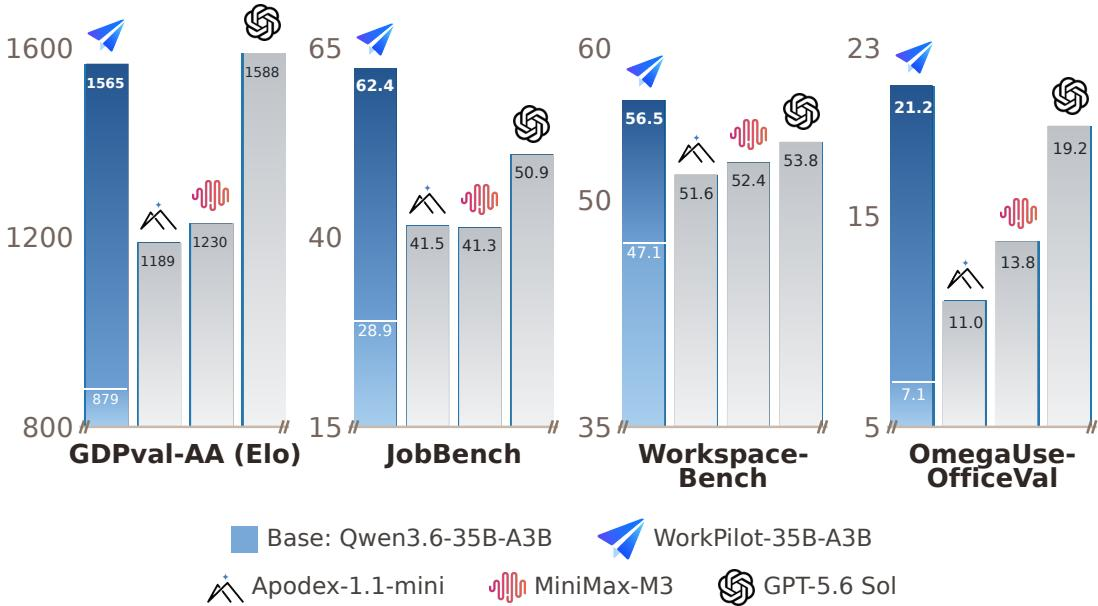
扩展工作智能体的监督训练需要多样化且能产生可靠专家演示的专业任务。然而,任务信息的缺失或不一致会阻碍教师执行,并削弱由此得到的监督信号。我们提出 WorkFactory,一个用于构建连贯且可执行专业任务的可扩展框架。该框架从职业意图出发,通过信息级规划构建信息支撑图来指导任务实例化,显式表示预期输出所需信息的依赖关系和位置。随后,探测执行识别支撑失败并在保持预期工作不变的前提下指导修复。我们构建了 112,686 个任务,涵盖 612 个职业,并利用收集到的教师轨迹在 4B、27B 和 35B-A3B 规模上微调 Qwen 模型,得到 WorkPilot 系列。三个模型在四个专业工作基准上均优于各自的基础模型,其中 WorkPilot-35B-A3B 在 GDPval-AA v2.1 上的 Elo 分数从 879 提升至 1565。扩展分析揭示了与模型相关的收益递减现象,执行长度先增加后减少。受控组件分析表明,规划与修复减少了经探测诊断出的任务环境缺陷,并提升了下游性能。数据和模型可在 https://github.com/IQuestLab/WorkFactory 获取。
一句话总结
IQuest Research、浙江大学及合作机构的研究人员提出 WorkFactory,一个可扩展框架,通过信息层规划、信息支撑图和探针执行修复,将职业意图转换为连贯且可执行的任务,并在 4B、27B 和 35B-A3B 规模上微调 Qwen 模型,形成 WorkPilot 系列,其中 WorkPilot-35B-A3B 在 GDPval-AA v2.1 上从 879 Elo 提升至 1565 Elo。
核心贡献
- WorkFactory 从预期输出反向构建信息支撑图,协调复用与合成材料之间的依赖关系和位置,从而构造连贯且可执行的专业任务,然后应用基于探针的执行与修复来保持任务可执行性。受控组件分析表明,规划与修复减少了探针诊断出的任务环境缺陷,并提升下游性能。
- 一项涵盖 612 个职业、112,686 个任务的规模研究考察了工作型 agent 的性能与执行行为,发现模型相关的边际收益递减、执行长度先增后减以及工具使用可靠性的变化。
- 由此得到的 WorkPilot 系列在 4B、27B 和 35B-A3B 规模上微调后,在四个专业工作基准上均优于其基座模型,其中 WorkPilot-35B-A3B 在 GDPval-AA v2.1 上从 879 Elo 提升至 1565 Elo,WorkPilot-27B 在 GDPval-AA 上达到前沿水平。任务数据和模型权重的子集已发布。
引言
将推理和行动交错执行的语言 agent 正越来越多地应用于专业数字工作,而在专家示范上进行监督微调是常见的后训练策略。扩展这一方法需要大量可执行任务,但先前的自动任务构建方法往往难以确保教师示范可靠展现预期的专业能力,因为支撑信息分布在多个工件中,并通过中间计算连接。作者提出 WorkFactory,一个从预期输出向后规划的框架,使用信息支撑图组织支撑信息应出现的位置,同时将推导结果留给求解器,然后在收集教师轨迹之前使用隔离探针和基于执行的修复来纠正环境缺陷。
数据集
数据集描述:WorkFactory
-
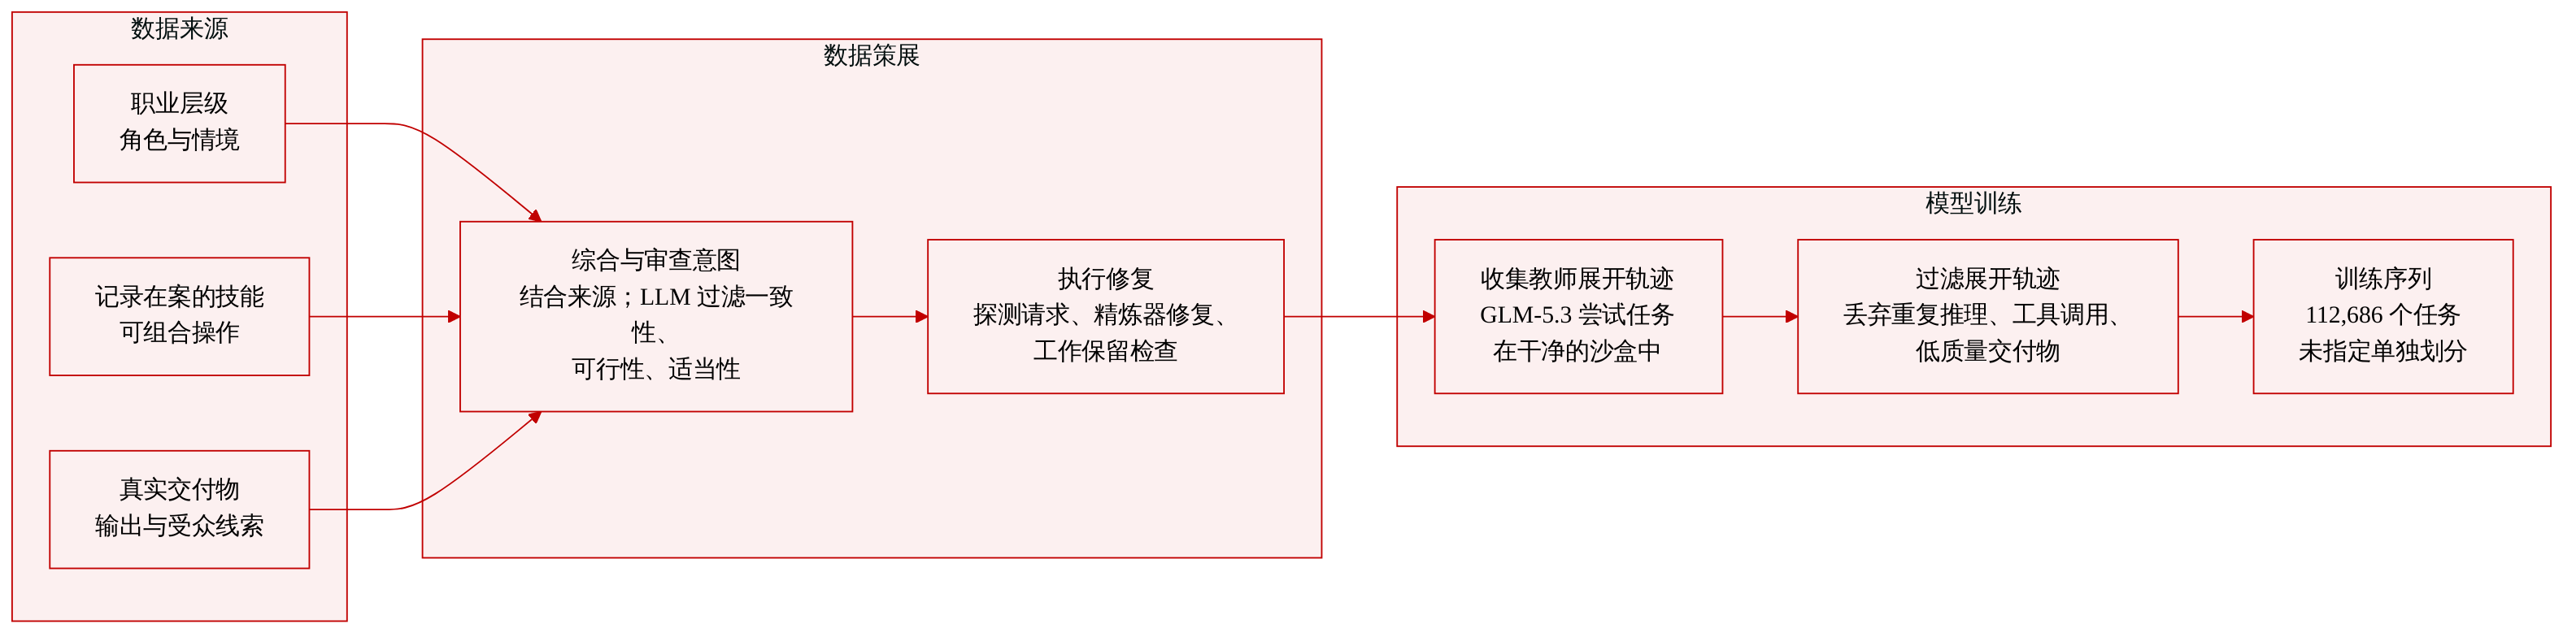
来源与意图组合 作者从三类专业来源构建 WorkFactory:职业层级、文档化技能和真实专业交付物。职业层级将工作锚定在角色和情境中。文档化技能识别可组合为工作流的操作。真实交付物提供关于预期输出和受众的线索。这些来源用于将职业扩展为角色、在一种操作为另一种操作提供输入时组合技能,以及通过指令回译从交付物推断目标。
-
意图过滤与任务池构建 来自三条路径的候选意图由 LLM 审查其内部一致性、可行性、专业适当性以及作为真实工作场景活动的合理性。被接受的意图构成共享意图库。环境构建后,基于执行的修复会诊断所实现的环境是否支持该任务。精修器可以在保持文件数量、类型和依赖结构不变的情况下修改请求和参考文件。修改必须通过构建检查以及 LLM 的工作保持性审查。通过修复的任务构成轨迹采集的候选池。
-
轨迹采集与训练数据 对于每个保留的任务,GLM-5.3 在与探针相同的信息访问边界内的干净沙箱中独立尝试该任务。产生的交互轨迹和交付物构成初始教师 rollout。作者保留通过轻量过滤器的 rollout,过滤项包括重复推理、重复工具调用,以及交付物缺失或实质性不足。对于初始 rollout 最长的 5% 任务,应用基于交付物成对比较的选择性拒绝采样。保留的 rollout 被转换为一个或多个训练序列,用于掩码自回归监督。
-
最终语料统计 最终训练语料包含 112,686 个任务,涵盖 612 个细粒度职业和 23 个主要职业组。教师轨迹使用 Stirrup 和 Claude Code harness 采集。语料通过请求重叠检查、对标记配对的审查以及文件哈希与评估任务进行比对筛查。检查未发现评估任务复用或与训练语料共享字节完全相同的文件。
-
使用详情 这些数据用于生成掩码自回归监督的训练序列。所提供的摘录未说明单独的训练划分、混合比例、裁剪策略或超出上述任务与环境结构的详细元数据模式。
方法
作者提出 WorkFactory,一个用于构建可执行专业任务以训练工作型 agent 的流程。流程始于多源专业意图合成,系统利用职业层级、文档化技能和真实专业交付物生成多样化的意图库。基于 LLM 的审查会评估候选意图的一致性、可行性和专业适当性,然后将其加入共享库。
对于每个意图,系统进入图引导的环境构建阶段。为确保每个请求输出都由求解器可见前提的完整链条支撑,同时把实际计算和判断留给求解器,作者引入信息支撑图 Ginfo=(Vinfo,Vcarrier,Einfo,Eloc)。其中 Vinfo 包含信息单元,Vcarrier 标识其载体,Einfo 表示信息单元之间的支撑关系,Eloc 将它们绑定到位置。规划器从预期输出反向工作,识别所需计算并追踪到必要信息,形成图的节点和边。位置绑定随后将这些信息分配到特定载体,例如用户请求或参考工件,确保内部构建要求对求解器隐藏。该图随后被转换为工件级构建计划,环境执行器按照该计划复用、改编或合成工件。
如下图所示:
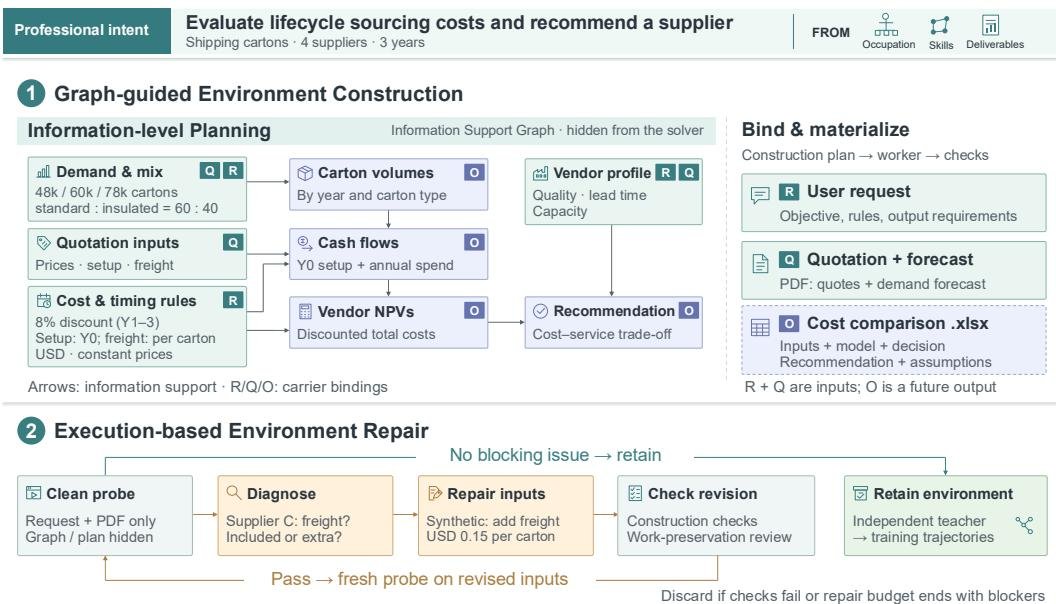
由于依赖关系在物化过程中可能丢失或发生矛盾,作者实现了基于执行的环境修复。探针求解器仅使用求解器可见的输入尝试任务。如果识别到阻碍性问题,精修器会修改请求和参考文件,以恢复必要支撑,而不会替求解器完成预期工作。每次修订都经过构建检查和工作保持性审查。该循环持续到没有阻碍问题或修复预算耗尽为止。
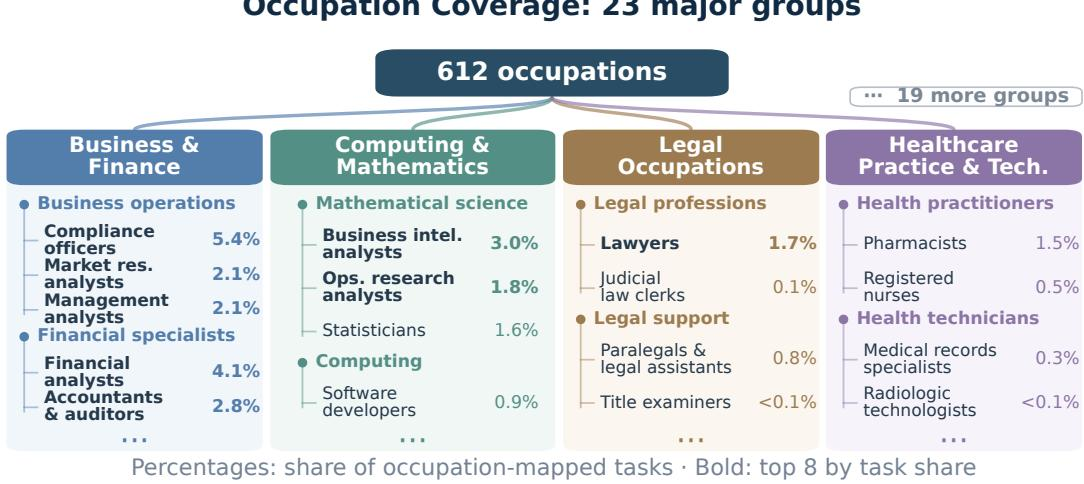
通过这一严格流程的任务构成轨迹采集的候选池。独立的教师模型在干净沙箱中尝试每个任务,生成交互轨迹和交付物。作者应用轻量过滤器以移除推理重复或交付物不足的 rollout。对于最长的 rollout,基于交付物成对比较应用选择性拒绝采样。所得训练语料涵盖 23 个主要职业组中的 612 个细粒度职业。
下图展示了这些职业在主要职业组中的分布,例如商业与金融、计算机与数学、法律职业以及医疗保健实践与技术。
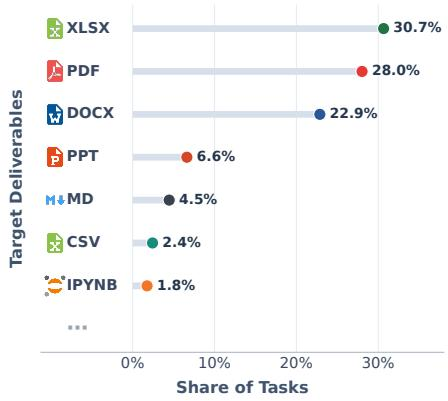
最后,训练语料中的目标交付物涵盖多种文件格式。下图详细展示了这些文件类型的分布,显示电子表格、文档和演示格式占主导。
实验
实验将在 WorkFactory 合成轨迹上微调的 WorkPilot 模型,与其匹配的基座模型以及前沿和开放权重基线,在 GDPval、JobBench、Workspace-Bench 和 OmegaUse-OfficeVal 等专业工作基准上进行比较。微调提升了所有测试模型规模的表现,最大模型接近前沿水平;规模分析显示模型相关的边际收益递减,且执行长度随准确率提升先增加后收缩。组件研究发现,信息层规划和基于执行的修复减少了任务缺陷并提升下游训练效用,而教师模型选择会影响收益,WorkPilot 模型保持在有利的成本性能前沿。
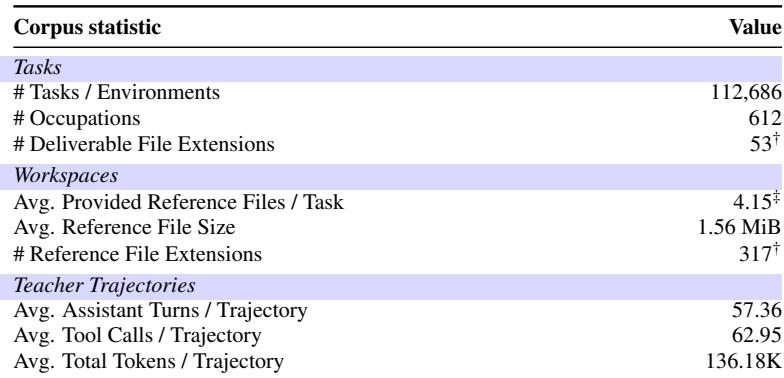
WorkFactory 训练语料包含超过十万个任务,涵盖数百个职业和数十种交付物文件类型。平均而言,它提供适度的工作空间上下文,每个任务约有四个参考文件,文件大小约 1.5 MiB,而有些任务依赖网络搜索而非提供的参考。语料覆盖广泛的职业和交付物多样性,包含数百个职业和数十种文件扩展名。大多数任务平均仅包含少量参考文件,有些任务没有参考,需要网络搜索获取必要信息。参考文件往往较小,平均每个文件约 1.5 MiB。
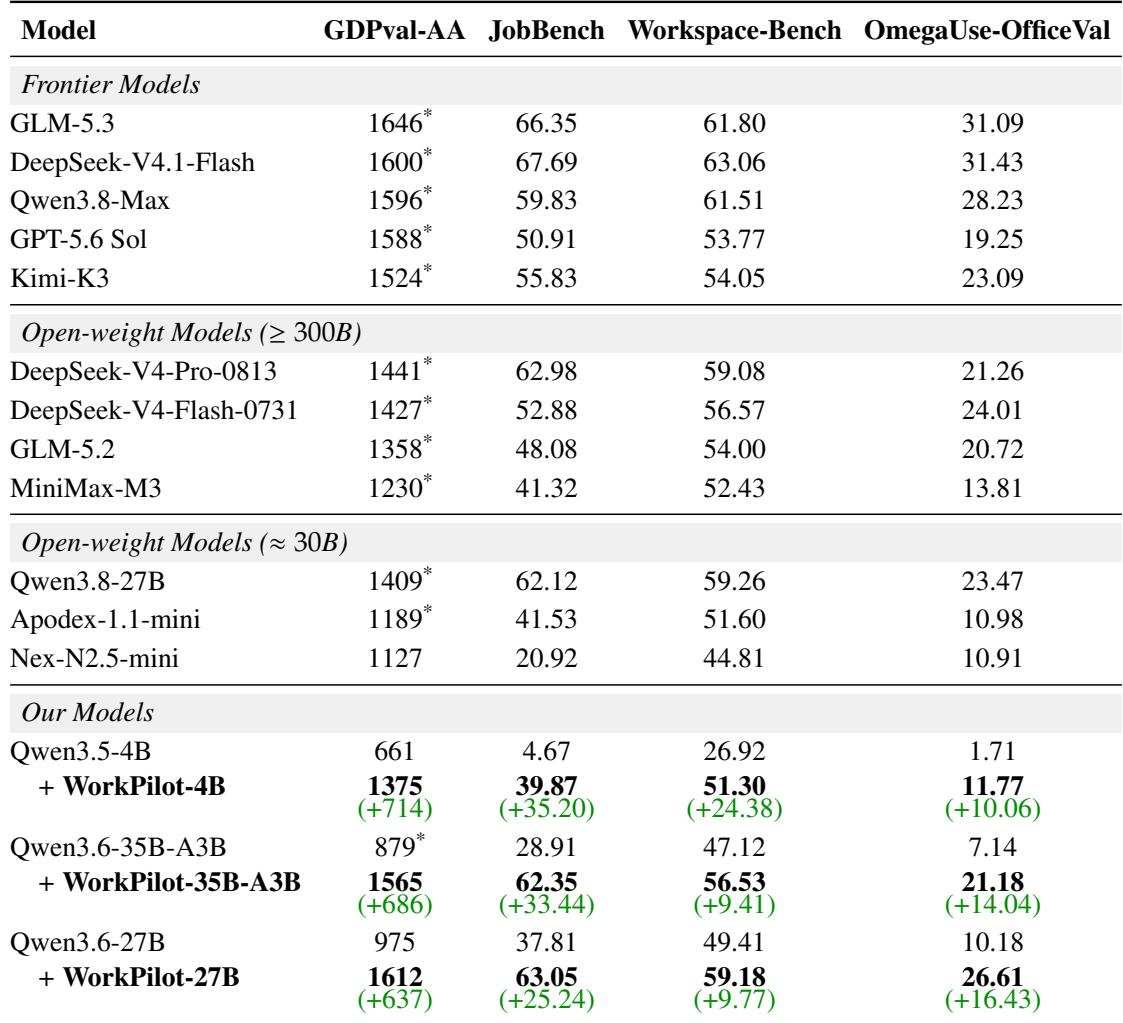
在 WorkFactory 语料上微调提升了所有测试基座模型规模在四个专业工作基准上的表现。所得 WorkPilot 模型达到接近前沿的性能,其中 27B 模型在 GDPval-AA 上介于 DeepSeek-V4.1-Flash 和 GLM-5.3 之间,4B 模型在两个基准上优于更小的基线。WorkPilot-35B-A3B 在 GDPval-AA、JobBench、Workspace-Bench 和 OmegaUse-OfficeVal 上均优于其基座模型。WorkPilot-27B 在 GDPval-AA 上超过 DeepSeek-V4.1-Flash,略低于 GLM-5.3;WorkPilot-4B 在 GDPval 和 OmegaUse-OfficeVal 上优于 Apodex-1.1-mini。
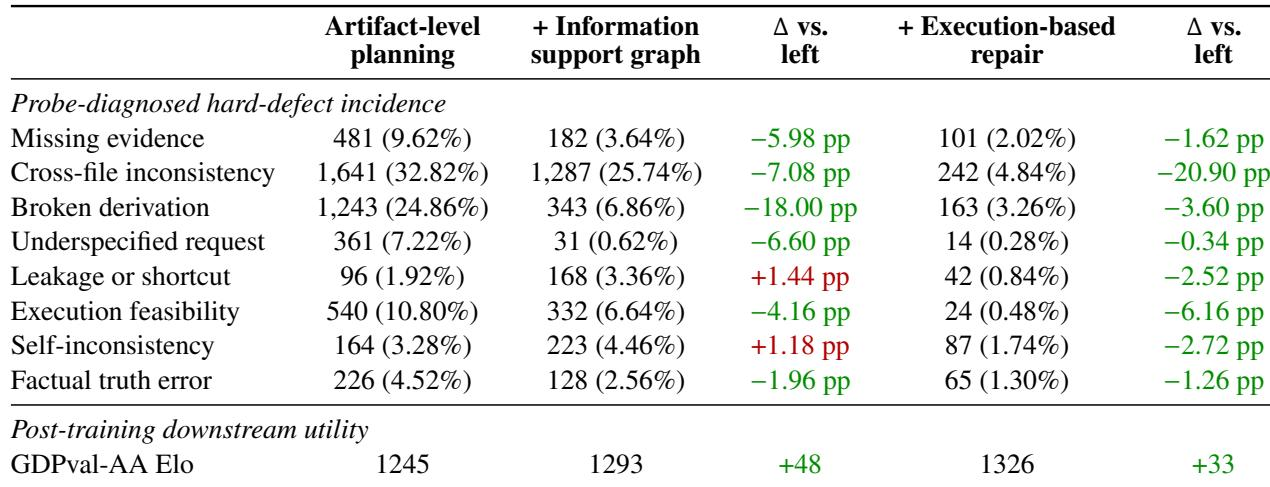
加入信息层规划减少了大多数类别中探针诊断出的硬缺陷,尤其是断裂推导和请求说明不足,尽管泄漏或捷径问题略有上升。随后的基于执行的修复减少了所有报告类别的缺陷,并带来最高的下游效用。任务质量的提升伴随着比直接工件级规划更高的 GDPval-AA Elo。信息层规划减少了大多数类别的硬缺陷发生率,断裂推导和请求说明不足的缺陷相对大幅下降。泄漏或捷径缺陷是例外,在从工件级规划转向信息层规划时略有增加。基于执行的修复进一步减少了每个报告类别的缺陷,并将下游 GDPval-AA Elo 提升到仅使用信息层规划之上。
WorkFactory 语料覆盖广泛的职业和交付物多样性,并提供适度的工作空间上下文,通常依赖较小的参考文件或网络搜索。在该语料上微调提升了所有测试基座模型规模,所得 WorkPilot 模型在专业工作基准上接近前沿水平。信息层规划减少了大多数硬缺陷,尤其是断裂推导和请求说明不足,尽管泄漏或捷径问题略有增加。基于执行的修复进一步减少了所有类别的缺陷,并带来最高的下游效用。