Command Palette
Search for a command to run...
Hy-Nomas:迈向自由形式交互式世界生成
Hy-Nomas:迈向自由形式交互式世界生成
摘要
交互式世界生成需要模型在保留相关历史和动作后果的同时遵循连续指令。我们提出 Hy-Nomas,一个具有 8B 扩散主干的视频世界模型,支持跨多轮交互的自由形式文本指令和连续相机控制。它根据当前输入和缓存历史生成变长片段。我们的核心设计在于将结构化视频描述与动作感知因果注意力对齐:描述性上下文在片段之间保持可访问,而动作指令被限制在其预期的时间窗口内。视觉语言提示增强器(PE)将用户请求和多模态交互历史转换为下一片段的结构化条件。多阶段课程逐步引入因果生成、文本交互、相机控制以及基于模型生成历史的训练,随后进行扩散蒸馏。在人类评估中,Hy-Nomas 展现出优于现有世界模型的性能。我们发布模型权重、代码和基准,以及轻量级适配工作流,以支持交互式世界生成的可复现研究。
一句话总结
腾讯 Hy 视觉生成团队推出 Hy-Nomas,这是一个 8B 扩散视频世界模型,支持跨多个交互轮次的自由形式文本指令和连续相机控制,其实现方式是将结构化视频字幕与动作感知因果注意力对齐、使用视觉语言 Prompt Enhancer,并采用多阶段课程训练,从而取得更优的人工评测结果,并发布模型权重、代码、基准和轻量级适配工作流。
核心贡献
- Hy-Nomas 是一个 8B 参数扩散视频世界模型,支持跨多个交互轮次的自由形式文本指令和连续相机控制,根据当前输入和缓存历史生成可变长度片段。
- 其核心设计将结构化视频字幕与动作感知因果注意力对齐,使描述性上下文在片段之间保持可访问,同时将动作指令限制在其预期时间窗口内;视觉语言 Prompt Enhancer 将用户请求和多模态交互历史转换为下一片段的结构化条件。
- 多阶段课程逐步引入因果生成、文本交互、相机控制,以及基于模型生成历史的训练,随后进行扩散蒸馏。Hy-Nomas 在基准中实现了比更大模型更强的文本驱动动作控制,并在人工评测中优于现有世界模型;发布内容包含模型权重、代码、基准和轻量级适配工作流。
引言
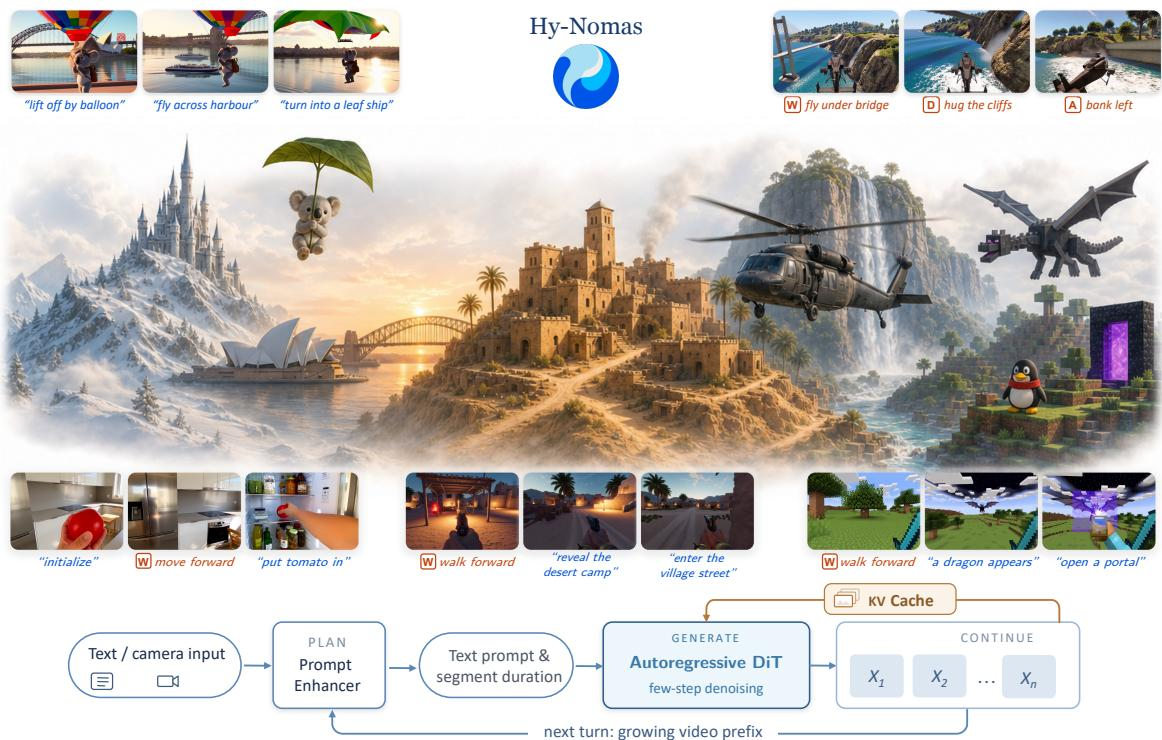
交互式视频世界模型正受到关注,原因在于与传统的固定提示词视频合成不同,用户可以在生成过程中通过命令影响未来的视觉观察。近期系统,例如 Genie 3、HappyOyster 和 LingBot-World v2,已经改进了导航和长时程生成,但改造预训练视频生成器仍然困难,因为存在因果性约束、片段间误差累积、持续场景记忆,以及协调自由形式文本动作与相机控制的需求。作者推出 Hy-Nomas,这是一个基于 HunyuanVideo 1.5 的 8B 参数世界模型,在单个自回归扩散 transformer 中支持多轮自由形式文本指令和连续相机导航。其方法结合了结构化时间顺序字幕、带时间戳的动作注释、动作感知因果注意力,以及用于片段级生成的渐进式训练方案和视觉语言 prompt enhancer。
数据集
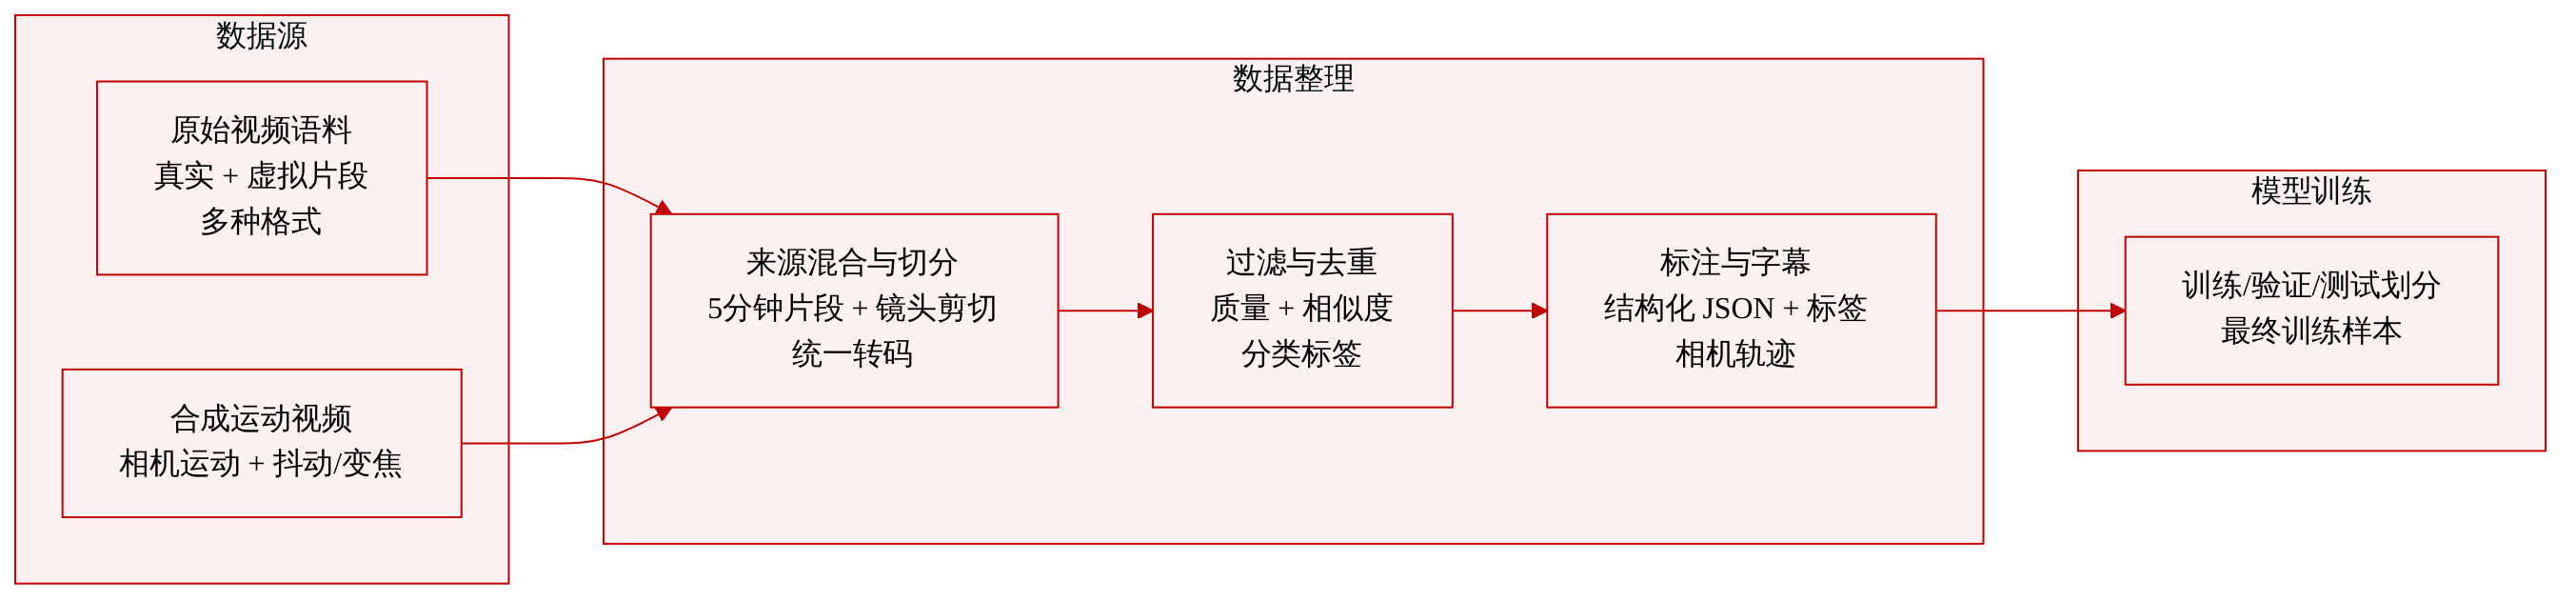
数据集组成与来源
- 作者构建了一个大规模异构视频语料库,涵盖真实环境和虚拟环境。
- 原始视频在编码类型、时长、帧率、分辨率和编码质量方面各不相同。
预处理与过滤
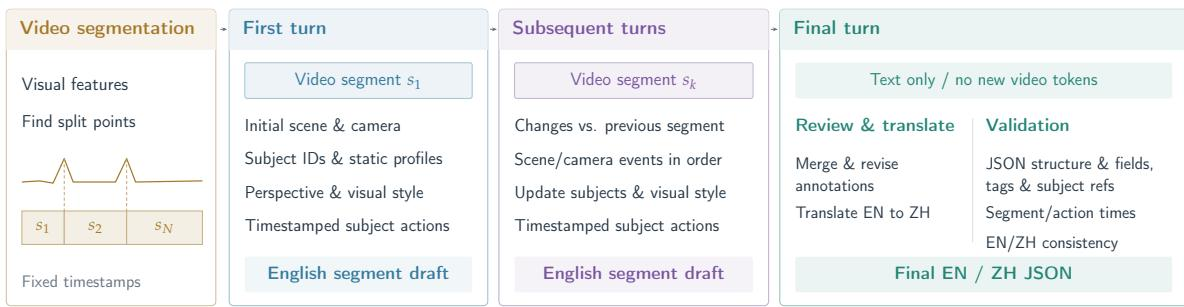
- 每个视频被划分为 5 分钟片段,然后在检测到的镜头边界处切分。
- 镜头边界检测器基于 OmniShotCut,并在高质量标注上进行了微调。
- 片段被转码为统一格式,并按时长、宽高比和分辨率等基本属性过滤。
- 视觉质量过滤器包括运动、清晰度和美学评分。
- 额外过滤器用于筛除衍生内容和突变转场。
分布与去重
- 使用 Qwen3-VL-Embedding 提取视觉嵌入。
- 通过层次聚类按视觉相似性对视频进行分组。
- 在每个聚类内应用 SemDeDup,去除语义冗余片段。
- 层次分类法覆盖语义内容和视觉属性。
- 内容类别包括交互、物体操作、人与物体运动,以及相机运动。
- 视觉属性描述相机视角、主体类型、主体和相机运动模式,以及录制方式。
- 微调后的 VLM 根据该分类法为每个视频打标签。
- 视频还与来自层次聚类的标签相关联。
- 中间聚类级别经过人工标注,用于数据选择。
- 作者使用分类法标签、聚类级别标注或两者来选择视频。
- 在不同训练阶段调整采样权重,以针对早期阶段发现的弱点。
相机轨迹处理
- 对适合轨迹估计的一部分视频,使用 ViPE 估计相机轨迹。
- 相机标定和分割模块升级为更强的预训练模型,同时保留现有深度估计器。
- 应用自适应时空下采样,以减少内存使用并提高吞吐量。
- 调整 SLAM 滑动窗口和优化调度,以平衡优化范围与轨迹漂移。
- 基于预训练 VPT 主干训练一个视频逆动力学模型,用于预测离散相机运动,例如 WASD 键盘输入。
- 逆动力学模型的训练数据包括合成相机运动视频,以及使用稠密光流细化的 ViPE 运动标签。
- 人工标注的抖动和缩放数据提供额外监督,不可用标签在训练期间被屏蔽。
- 轨迹过滤在 ViPE 估计前后进行。
- 过滤包括四个顺序步骤:
- 光流运动分数范围过滤,用于剔除静态场景和突变尖峰。
- 在均匀网格上进行 CoTracker3 点跟踪,剔除帧间可见点位移超过 max(H, W) 的 20%,或总跟踪点位移中位数低于 max(H, W) 的 30% 的片段。
- AnyCalib 联合估计逐帧焦距和径向畸变,对焦距变化过大、焦距突变、焦距过长或强畸变进行惩罚。
- ViPE 轨迹审计,剔除具有重复大方向跳变、帧间视角偏移过大、平移尖峰或整体相机位移不足的轨迹。
视频字幕与注释
- 字幕使用结构化 JSON,包含视频级和片段级信息。
- 视频级字段指定视觉风格、相机视角和共享主体列表。
- 每个主体有显式标识符和静态画像,静态画像锚定在其最早可清晰识别的外观上。
- 后续动作和状态变化引用该标识符,以保持跨片段连续性。
- 在每个片段内,场景描述和相机运动句子按时间顺序交错排列。
- 主体动作和可见结果分别记录,并带开始和结束时间戳。
- 第一个片段建立场景。
- 后续片段描述相对于前一片段的变化,而不重复未改变的上下文。
- 相机运动句子被包裹在显式的
<CameraN>和</CameraN>标签中。 - 对于具有 ViPE 估计轨迹的训练片段,移除相机运动描述和标签,并使用估计轨迹进行显式相机运动监督。
- 对于没有轨迹注释的片段,保留带标签的句子作为文本监督。
- 多轮注释分两个阶段进行:
- 首先,提取 V-JEPA 2 视觉特征,并根据时间变化将片段划分为更短的片段。
- 其次,VLM 在多轮对话中按顺序注释这些片段。
- 第一轮建立初始场景和主体画像。
- 后续轮次描述场景变化和当前动作,同时细化主体身份和视频级标签。
- 前序片段和注释保留在对话上下文中。
- 对于靠后的片段,VLM 仅使用当前片段和前序片段的视觉证据,以减少幻觉。
- 最后进行纯文本轮次,审查累积注释,修正早期草稿,解决不一致,并生成最终英文字幕和结构对齐的中文翻译。
- 该最终轮次检查 JSON 结构、必填字段、主体引用、标签、片段和动作时间戳,以及语言版本之间的一致性。
- 字幕模型因训练阶段而异:
- Gemma 4 和 Qwen3.5-122B-A10B 用于数据密集型阶段的高效大规模字幕生成。
- Kimi K3 用于退火阶段的详细逐片段注释。
在训练中的使用
- 处理后的片段、分类法标签、聚类标签、字幕和相机轨迹构成训练样本。
- 结构化字幕支持逐片段自回归 rollout 训练。
- 相机控制通过映射到轨迹的键盘输入或自然语言相机运动指令进行监督。
- 跨训练阶段使用分类法和基于聚类的数据选择调整采样权重。
- 对于 prompt enhancer 训练,作者从稠密字幕和真实用户提示构建多轮多模态对话数据集。
- 用户提示从现有稠密字幕合成,并从真实用户提示增强。
- 这些提示经过 prompt enhancer 和视频生成流程,记录每轮的字幕响应和生成视频。
- 该数据集包含场景初始化,以及跨主体、环境、视角和控制模式的后续交互。
- 它用于监督微调一个基于 Qwen3.8-27B 的轻量级 prompt enhancer 模型。
方法
作者构建了一个大规模异构视频语料库,涵盖真实环境和虚拟环境。端到端流程通过标准化预处理、过滤、语义去重、相机轨迹注释和结构化字幕生成,将原始视频转换为训练样本。在不同训练阶段调整采样分布,以解决各阶段发现的弱点。
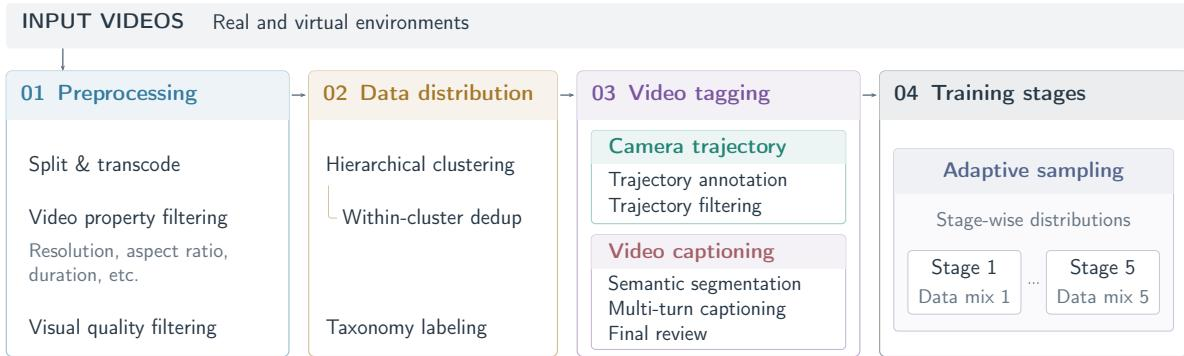
为了保持主体身份、场景上下文和动作时间顺序,作者设计了结构化视频字幕,并对相机运动进行显式标记。字幕使用结构化 JSON,包含视频级和片段级信息。VLM 在多轮对话中按顺序注释片段。第一轮建立初始场景和主体画像,后续轮次描述场景变化和当前动作。最后进行纯文本轮次,审查累积注释,修正草稿,并生成对齐的英文和中文双语字幕。
Hy-Nomas 模型构建在 HunyuanVideo 1.5 之上。它引入逐片段因果注意力,用于自回归世界生成,并引入相机交叉注意力,用于显式相机控制。该模型使用 DCAE-V 视频自编码器和冻结的 Qwen2.5-VL-7B 文本编码器,后接一个 timestep 感知的 token 精炼器。模型从高斯噪声开始,每次对一个片段的视频 latent 去噪,条件包括当前文本提示、可选相机轨迹,以及来自前序片段的缓存 key 和 value。每个 MMDiT 块中的专用交叉注意力模块注入相机条件。
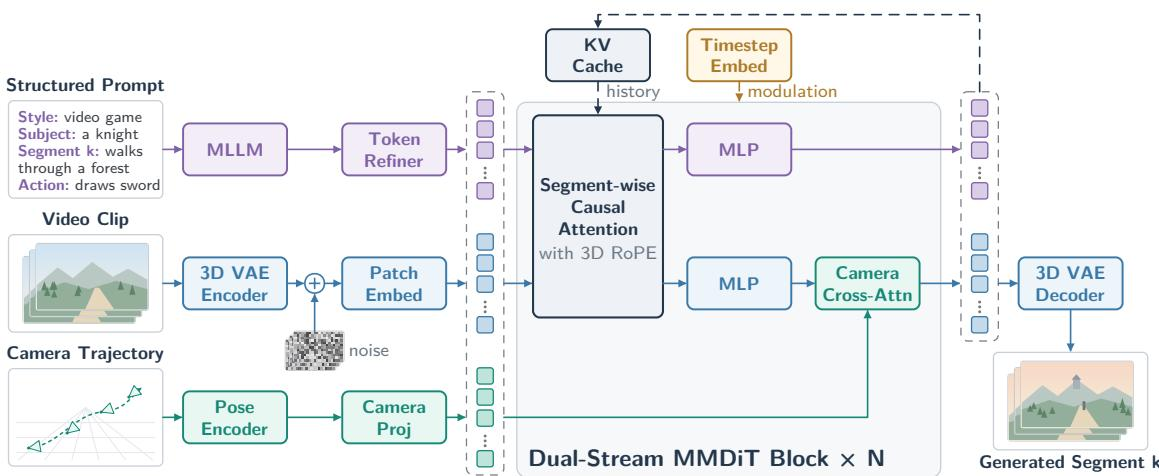
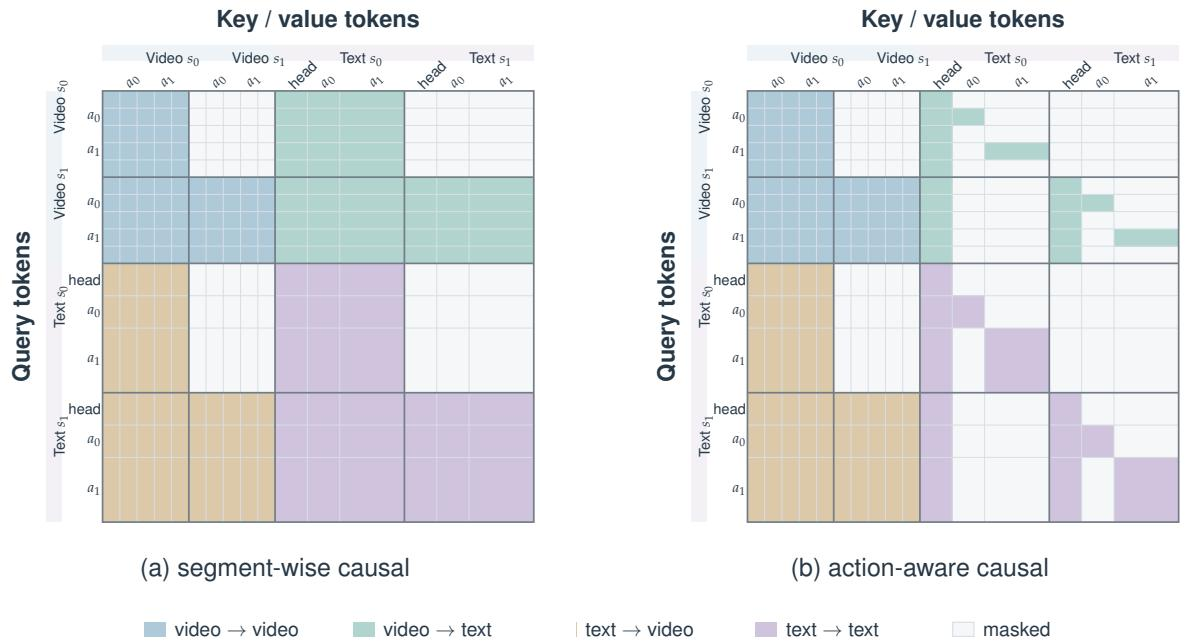
与常规视频生成不同,基于视频的世界模型按时间顺序模拟不断演变的世界状态。作者将完全双向注意力替换为逐片段因果注意力,使其与输入字幕的时间结构对齐。注意力在每个片段内是双向的,在片段之间是因果的。为了解决片段内动作错位和跨片段动作重复问题,作者引入动作感知因果注意力。这通过更细粒度的掩码方案扩展逐片段因果注意力,以区分片段内和跨片段的动作。每个片段的文本 token 被分为描述头和动作尾。动作窗口内的查询 token 仅被限制为关注同一片段中相关联的文本 token 和描述头 token,而描述头对当前片段和后续片段保持可访问。
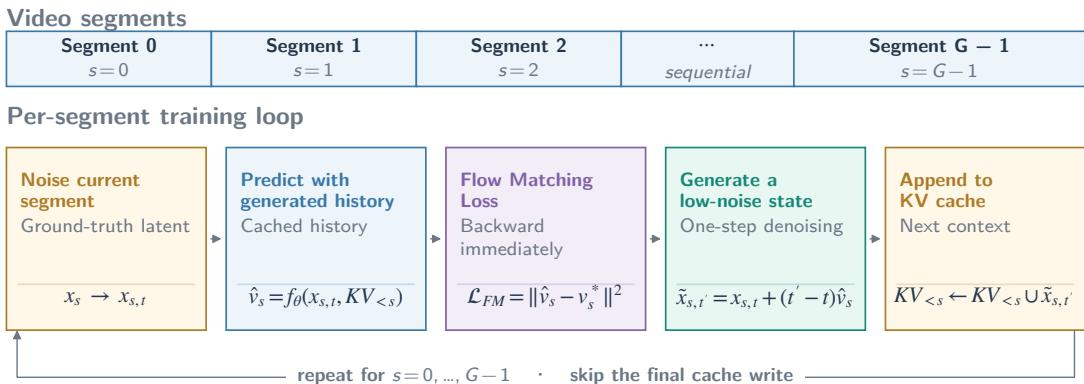
为了让模型适应自回归推理期间不断演进的历史,作者采用 Segment Forcing。它结合了顺序逐片段去噪、一步上下文估计和流式反向传播。给定被划分为多个片段的视频,自回归 DiT 按顺序处理这些片段。在每个片段,模型基于由前序片段构建的 KV cache 预测其 flow-matching 速度。flow-matching MSE 目标仅应用于当前片段预测,并立即反向传播该损失。为了构建下一片段的上下文,使用预测速度对同一噪声 latent 执行一步去噪:
x~s,tctx=xs,t+(tctx−t)v^s,tctx∼U(0.1,0.3).得到的低噪声 latent 被追加到 KV cache 中。流式反向传播仅在内存中保留最新片段的计算图,并在多个片段上累积梯度,用于单次优化器更新。
实验
评测引入 Hy-Nomas-Bench,这是一个包含 280 个案例的基准,涵盖多轮文本交互、相机导航、交错文本与相机控制,以及空间记忆,并在原生接口和两两人工判断下将 Hy-Nomas 与 Genie 3、LingBot-World v2 和 Happy Oyster 进行比较。结果表明,Hy-Nomas 在提示遵循、物理合理性和交错控制方面持续领先,而相机控制优势较小,空间记忆仍然落后于 Genie 3,尽管与 Happy Oyster 相比具有竞争力。额外实验验证,LoRA 适配可改善电影化或机器人特定行为,但可能略微降低相机控制精度;PE 模型可改善指令和格式遵循,同时保持控制性能。
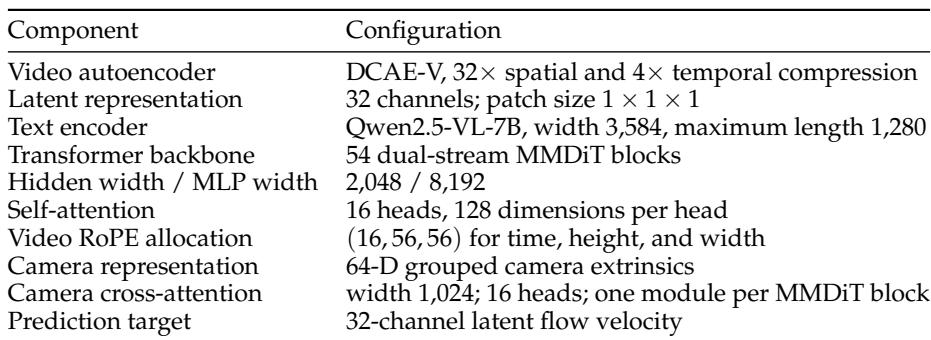
该架构基于 HunyuanVideo 1.5,使用 DCAE-V 视频自编码器,空间压缩 32 倍,时间压缩 4 倍,在 1x1x1 patch 大小下生成 32 通道 latent 表示。文本条件来自冻结的 Qwen2.5-VL-7B 编码器,而去噪主干具有 54 个双流 MMDiT 块,隐藏宽度为 2048,MLP 宽度为 8192。逐片段因果注意力支持跨视频片段的自回归生成,相机交叉注意力注入显式相机控制。视频自编码器的空间压缩远高于时间压缩,产生紧凑的逐位置 latent token。transformer 主干采用深度双流 MMDiT 设计,具有宽 MLP 扩展,并通过专用交叉注意力进行相机条件注入。
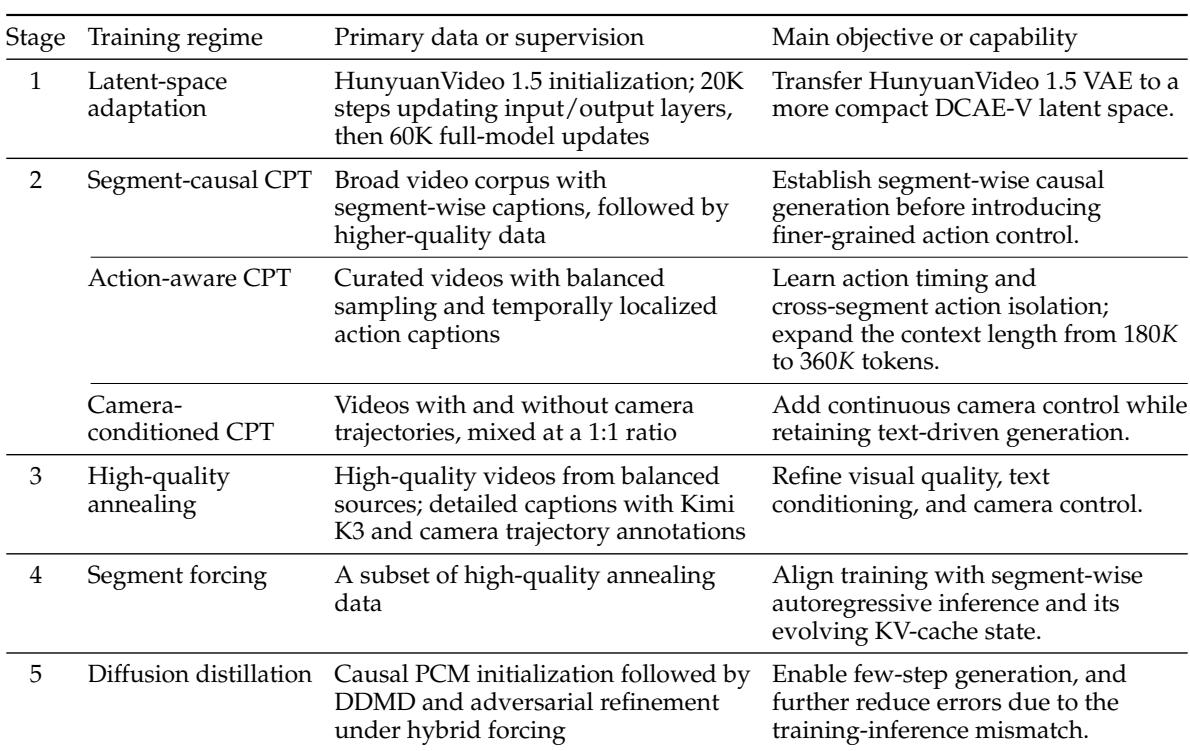
Hy-Nomas 训练组织为分阶段课程:首先将文生视频初始化适配到新的 latent 空间,然后使用持续预训练加入片段因果生成、动作感知时间结构和相机条件控制。后续阶段应用高质量退火、segment forcing 和扩散蒸馏,以提升质量、使训练与自回归推理对齐,并实现少步生成。课程共同推进因果、交互和上下文能力,而不是一次性引入所有技能。片段因果持续预训练先建立逐片段自回归生成,再引入动作感知和相机条件训练。动作感知训练使用时序局部化的动作字幕,以改善动作时序和跨片段隔离,同时扩展最大上下文长度。相机条件训练混合有和没有相机轨迹的视频,以增加连续相机控制而不损失文本驱动生成。Segment forcing 使用来自模型自身预测的缓存上下文进行训练,使训练更接近逐片段自回归推理。扩散蒸馏实现少步生成,并进一步减少训练与推理不匹配带来的误差累积。
评测设置反映了不同比较模型异构的交互接口。Hy-Nomas 和 LingBot-World v2 在多轮文本、相机导航、交错文本与相机,以及空间记忆上进行评测,而其他模型的适用范围更有限。Hy-Nomas 和 LingBot-World v2 支持全部四个基准设置,包括交错文本与相机控制。Genie 3 仅限相机导航和空间记忆,因为其接口不支持基于文本提示的交互。Happy Oyster 分别支持文本交互和导航,但不在交错文本与相机控制上进行评测。LingBot-World v2 从其开源模型适配而来,用于自由形式文本和交错评测。
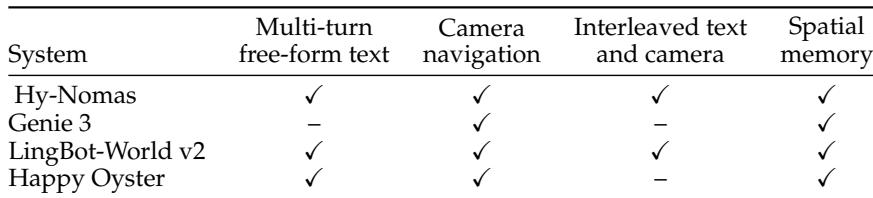
实验从架构、分阶段训练课程和基准评测设置等方面考察 Hy-Nomas。该模型基于 HunyuanVideo 1.5,配备 DCAE-V 自编码器、冻结的 Qwen2.5-VL-7B 文本编码器,以及支持逐片段因果生成和相机交叉注意力的 54 块双流 MMDiT 主干。其训练课程逐步加入片段因果生成、动作感知时间结构、相机条件控制、segment forcing 和扩散蒸馏,以使训练与自回归推理对齐并实现少步生成。评测涵盖多轮文本、相机导航、交错文本与相机控制,以及空间记忆;其中 Hy-Nomas 和 LingBot-World v2 支持所有设置,而其他模型适用范围更有限。