Command Palette
Search for a command to run...
仅在需要时查看:面向高效扩散视觉语言模型的认证引导视觉路由
仅在需要时查看:面向高效扩散视觉语言模型的认证引导视觉路由
Donghyeon Cho Joowon Kim Seungho Shin Eunho Yang
摘要
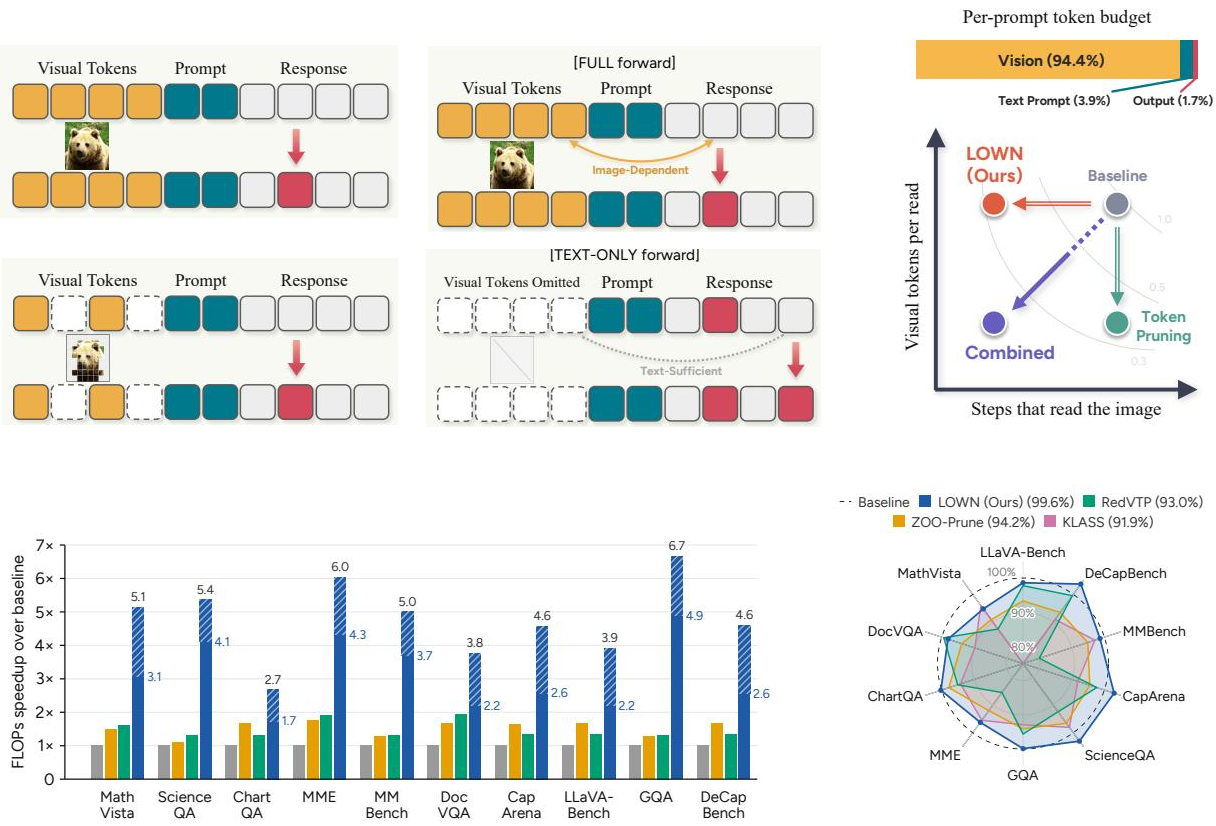
扩散视觉语言模型(DVLMs)在每个去噪步骤都会处理其全部输入。由于在我们所研究的基准上视觉 token 占输入的 89–97%,大部分解码计算都花在重复处理同一图像上。视觉 token 剪枝方法通过移除部分视觉 token 在一定程度上缓解了这一负担,但会丢失被移除的信息,并且仍须在每个步骤处理剩余图像。为衡量图像实际需要使用的频率,我们在每个解码步骤比较 LLaDA-V 在有、无图像条件下的预测,发现移除图像平均仅在 22.8% 的步骤中改变了某个被去掩码的 token,最低仅 7.9%。因此,我们提出 LOWN,一种在每个步骤决定是否处理图像以及去掩码多少 token 的解码方法。LOWN 在无图像条件下预测被掩码的 token,仅当该预测与上一次图像条件预测不一致时才处理图像。一致性为此前的预测提供了可复用的认证,被认证 token 的数量决定该步骤中去掩码多少 token。我们还观察到不同基准对图像的需求不同,因此需要 LOWN 的自适应决策,而非固定调度。在无需训练或调整阈值的情况下,LOWN 在十个基准上以平均 35.3% 的解码 FLOPs 保留了 LLaDA-V 99.6% 的分数。LOWN 还可推广到基于 LLaDA 的不同 DVLMs,可与视觉 token 剪枝正交组合,并可在键值缓存下运行以进一步提高效率。代码与项目主页见 https://hyeon9698.github.io/LOWN/
一句话总结
KAIST 和 AITRICS 的研究者提出 LOWN,一种用于扩散视觉语言模型的证书引导视觉路由解码器,它在不使用图像的情况下预测被掩码 token,仅在与上一次基于图像的条件预测不一致时才处理图像,并认证先前预测以供复用,在十个基准上保留 LLaDA-V 的 99.6% 分数,解码 FLOPs 为 35.3%,且无需训练或调优阈值。
核心贡献
- 对 LLaDA-V 解码的测量研究表明,移除视觉 token 平均只在 22.8% 的步骤中改变被掩码 token,在 MMBench 上甚至低至 7.9%,图像依赖程度随基准和步骤而变化。
- 提出 LOWN,一种无需训练且无需阈值调节的解码方法,它在每一步根据仅文本前向传播与上一次基于图像的条件预测之间的一致性,决定是否处理图像以及去掩码多少个 token。
- LOWN 在十个基准上平均以 35.3% 的解码 FLOPs 保留 LLaDA-V 的 99.6% 分数,并且可推广到基于 LLaDA 的 DVLM,可与视觉 token 剪枝正交组合,并可在 key-value caching 下运行。
引言
扩散视觉语言模型(如 LLaDA-V)通过在视觉和文本输入条件下迭代地去掩码 token 来生成响应,但视觉 token 在输入序列中占主导地位,因此标准解码会反复重新处理不变的图像,并将大部分计算花在此处。先前的加速方法使用视觉 token 剪枝、中间状态缓存或更激进的去掩码调度,但它们不会动态判断当前解码步骤是否真的需要访问图像。固定调度也与观测行为不匹配,因为图像依赖步骤会随任务和轨迹变化。作者提出 LOWN,一种无需训练且无需阈值调节的解码方法,它比较廉价的纯文本前向传播与最新的基于图像的条件预测,以决定何时重新处理图像以及去掩码多少个 token。LOWN 以 0.35 倍的解码 FLOPs 保留 LLaDA-V 的 99.6% 分数,并可与现有剪枝和缓存技术组合。
方法
作者提出 LOWN,一种解码策略,它将“响应状态是否需要视觉上下文”的决策与“解码可以推进多远”的决策分离。如下图所示:
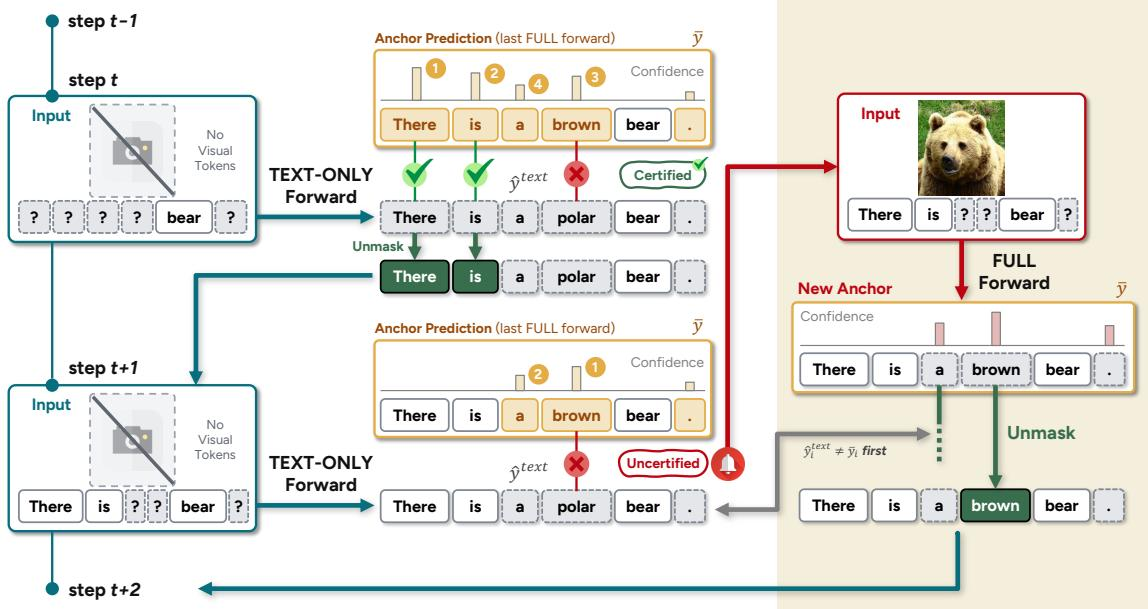
LOWN 不依赖单次 FULL 前向传播同时完成这两个决策,而是保留上一次基于图像的条件预测作为锚点,并使用 TEXT-ONLY 前向传播对其进行检验。仅当纯文本检验未能认证足够数量的 token 时,才执行 FULL 前向传播。该方法既不改变模型参数,也不改变注意力模式。
该方法依赖两个核心机制:锚点证书和证书引导的解码。每当执行 FULL 前向传播时,LOWN 保留其对剩余被掩码位置的预测和置信度,形成锚点。在后续每一步中,执行 TEXT-ONLY 前向传播,并按锚点置信度从高到低对被掩码位置排序。若某候选 token 当前的 TEXT-ONLY 预测与锚点预测一致,则认为该候选 token 通过认证。由于这两个预测在处理图像与否以及计算它们所用的响应状态方面不同,它们的一致可近似表示该 token 不需要图像且锚点在状态演化后仍然有效。通过认证的候选 token 中按置信度排序的最长前缀形成认证集合,其接受长度由当前输入和步骤动态确定,而不是固定常数。
在证书引导的解码阶段,该认证前缀的长度决定后续动作。如果前缀至少包含 k 个 token(其中 k 是基线每步去掩码的 token 数),该步骤完全跳过 FULL 前向传播。它接受整个前缀,将每个认证位置去掩码为其锚点预测,这使得单步可以去掩码超过 k 个 token。相反,如果前缀短于 k,则锚点不再认证足够多的 token。该步骤随后执行 FULL 前向传播,用新预测和置信度替换锚点,并去掩码 k 个位置。这些位置按不一致优先的顺序选择,优先处理 TEXT-ONLY 与 FULL 预测不同的位置,其余位置按 FULL 置信度排序。两条分支都至少去掩码 k 个 token,确保 LOWN 的总步数不超过基线,同时可能减少步数。
作者还提供了成本分析以量化计算节省。令 C(n) 表示对 n 个 token 执行一次前向传播的 FLOPs。与基线相比,LOWN 的相对 FLOPs 可表示为:
R=f+σρ其中 f=nF/T 是 FULL 前向传播的频率,σ=nT/T≤1 是相对步数,ρ=C(NT)/C(NF) 是 TEXT-ONLY 前向传播相对于 FULL 前向传播的单位成本。证书机制降低 f,而接受超过 k 个 token 会降低 σ。输入决定 ρ,当视觉 token 在 FULL 输入中占比更大时,ρ 会下降。该框架还可与视觉 token 剪枝组合,这会进一步降低每次 FULL 前向传播的成本,但不影响 FULL 前向传播的执行频率。
实验
实验在图像和视频基准上评估 LOWN 在 LLaDA-V、LaViDa 和 VidLaDA 上的表现,并将其与视觉 token 剪枝、key-value caching 以及其他加速基线进行比较。单独使用 LOWN 即可在保持接近完整任务质量的同时大幅降低解码 FLOPs,并且可与剪枝和缓存方法组合,进一步降低计算量或延迟而无需重新训练。迁移结果表明该方法能够跨 DVLM 骨干和视频任务泛化,消融实验表明大部分节省来自选择性地跳过完整图像处理,自适应接受长度进一步带来与任务相关的额外降低,证书可靠性保持较高。
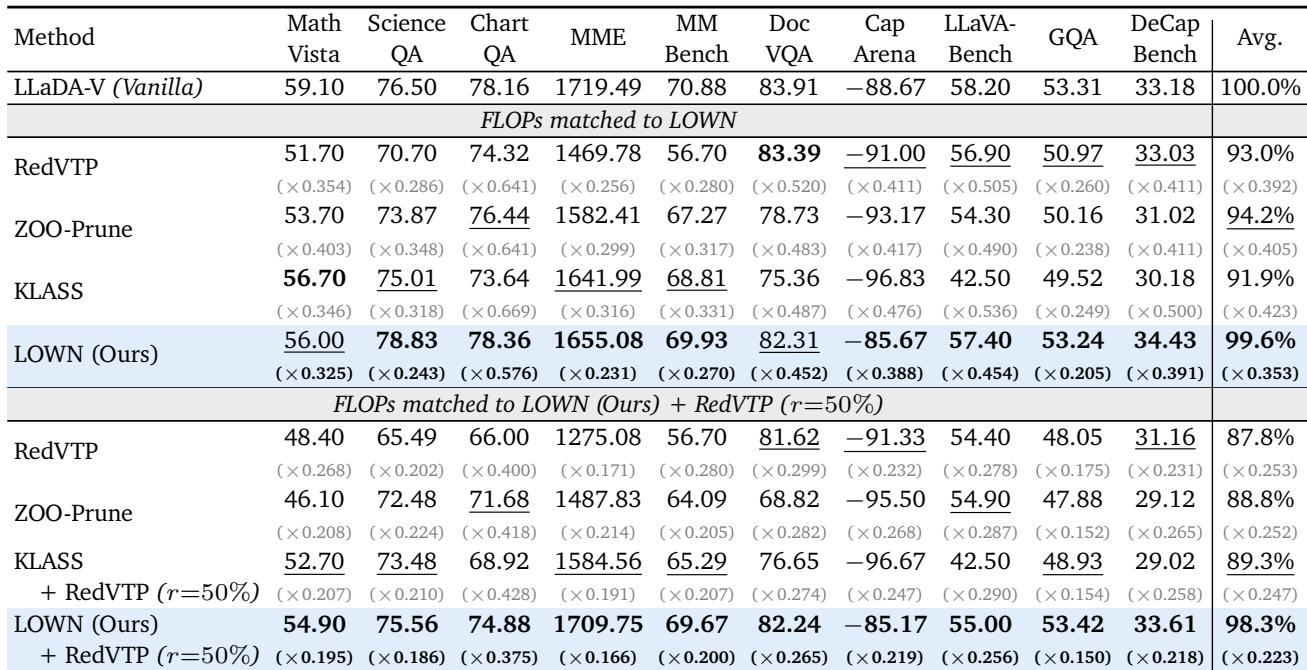
在匹配的解码 FLOPs 下,LOWN 保留了 LLaDA-V 基线几乎全部的平均质量,同时仅使用约三分之一的算力,并且在大多数基准上优于单独的加速方法。将 LOWN 与视觉 token 剪枝组合可进一步降低 FLOPs,并在所有评估基准上取得最高分数,表明自适应图像访问与 token 剪枝是互补的。LOWN 在仅使用匹配解码 FLOPs 一部分的情况下几乎达到基线性能,而竞争方法尽管平均使用更多算力,平均分数仍较低。视觉 token 剪枝与 LOWN 组合可进一步降低 FLOPs;该组合方法在全部十个基准上得分最高,并且较不激进的剪枝可以在质量和算力两方面都优于更激进的剪枝。
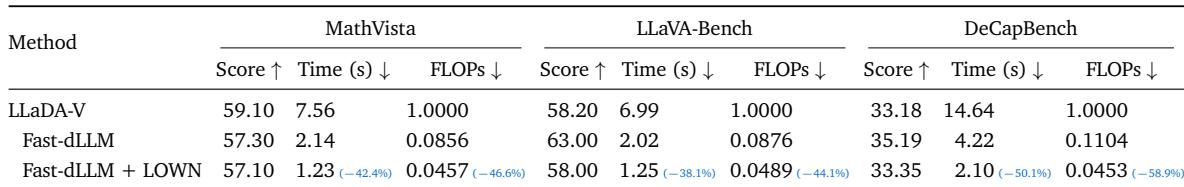
在 LLaDA-V 上将 LOWN 与 Fast-dLLM 组合,相较于 Fast-dLLM 带来了显著的效率提升,同时分数接近 LLaDA-V 基线。在所报告的三个基准上,生成时间下降约五分之二到一半,FLOPs 相对 Fast-dLLM 下降约五分之二到五分之三。组合后的分数在全部三个任务上略低于 Fast-dLLM,其中 LLaVA-Bench 下降最大。将 LOWN 加入 Fast-dLLM 可显著缩短生成时间并减少 FLOPs,时间减少约五分之二到一半,FLOPs 减少约五分之二到五分之三。Fast-dLLM + LOWN 与 LLaDA-V 的分数差距很小,但在全部三个基准上低于 Fast-dLLM,尤其是在 LLaVA-Bench 上。
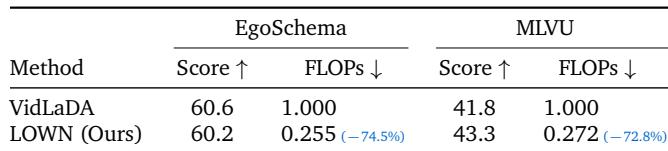
在 VidLaDA-8B 视频理解上,与基线相比,LOWN 在 EgoSchema 和 MLVU 上将解码 FLOPs 降低约四分之三。它密切保持质量,在 EgoSchema 上有小幅下降,在 MLVU 上略有提升。LOWN 在两个视频基准上都实现了大幅 FLOPs 降低,同时分数接近 VidLaDA 基线。在 MLVU 上,LOWN 以解码成本的一部分略微超过基线分数。
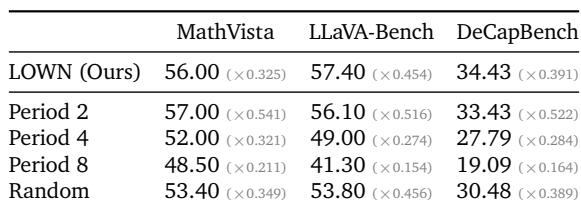
在 LLaDA-V 上,LOWN 取得了优于周期性和随机图像访问调度的质量-算力权衡。它与 Period 2 具有竞争力,同时使用显著更少的 FLOPs,并在全部三个基准上优于算力匹配的随机调度。诸如 Period 4 的固定调度可以在 MathVista 上达到与 LOWN 相近的算力,但分数更低。在相同的平均 FULL 前向传播次数下,LOWN 相比随机调度将任务归一化质量提高 4.9-13.0%。Period 2 相比 LOWN 仅在 MathVista 上取得轻微提升,但使用的相对 FLOPs 高得多。Period 4 在 MathVista 上使用与 LOWN 相似的算力,但分数低 4.0 分。
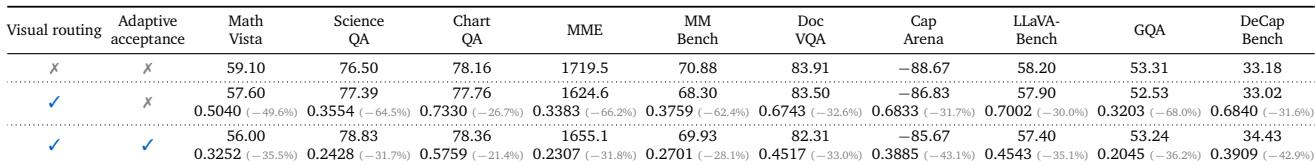
在 LLaDA-V 上,仅使用视觉路由可将 FLOPs 降低约 27% 到 68%,同时各基准上的分数大多接近基线,仅有小幅变化。加入自适应接受长度后,进一步将剩余 FLOPs 降低约 21% 到 43%,并在十个基准中的七个上提高分数,其余基准下降有限。仅使用视觉路由即可实现大幅 FLOPs 降低,各基准约 27% 到 68%,分数变化较小且混合。自适应接受长度进一步将剩余 FLOPs 降低约 21% 到 43%,并提高或基本保持任务质量,在十个基准中的七个上提高分数。
实验在图像、视频和多模态基准上评估 LOWN 在 LLaDA-V 和 VidLaDA-8B 上的表现,并将其与加速解码方法、Fast-dLLM、固定和随机视觉访问调度以及视觉路由和自适应接受长度的消融进行比较。LOWN 持续降低解码 FLOPs 和生成时间,同时保持基线质量或略有提升,并可与视觉 token 剪枝和 Fast-dLLM 组合以获得进一步效率收益。在视频基准上,它将解码 FLOPs 降低约四分之三,分数变化很小,消融实验表明路由和自适应接受长度一起能够比固定或随机调度产生更好的质量-算力权衡。