Command Palette
Search for a command to run...
FrameForge:利用视频基础模型的先验实现统一图像生成
FrameForge:利用视频基础模型的先验实现统一图像生成
Yijing Lin Zhendong Mao Mengqi Huang Yuxin Wang Yongdong Zhang
摘要
统一条件图像生成要求单个模型在保留视觉输入不同方面的同时,生成遵循文本引导的目标图像。预训练视频模型通过在时间维度上编码视觉变换,提供了一个有前景的基础,但现有方法通常将条件和目标分配到固定的时间位置。我们观察到,条件与目标之间的关系在不同生成任务中存在显著差异,而视频模型天然地在不同时间尺度上编码视觉变换。这促使我们利用输入自适应的虚拟时间关系对条件生成进行建模。我们提出 FrameForge,它捕捉此类关系的两个互补方面。时序专家混合(MoTE)通过动态选择具有不同虚拟间隔的时序 RoPE 专家,建模目标与条件之间的距离。时序推理链(CoTR)通过一个潜在中间状态建模条件如何转换为目标,并利用推理瓶颈注意力掩码鼓励信息沿该路径传播。在 DreamBench、COCO2017 和 GEdit-Bench 上的实验表明,FrameForge 在主体驱动生成、Canny 到图像生成和图像编辑任务上,相较于所对比的方法取得了更优性能。
一句话总结
来自中国科学技术大学和 FrameX.AI 的研究人员提出了 FrameForge,该框架利用视频基础模型先验进行统一条件图像生成,通过 Mixture of Temporal Experts 和 Chain of Temporal Reasoning 对输入自适应的虚拟时间关系进行建模,并在 DreamBench、COCO2017 和 GEdit-Bench 上取得了更优的主体驱动生成、canny-to-image 生成和图像编辑效果。
核心贡献
- FrameForge 是一个统一的适配框架,通过建模条件与目标之间输入自适应的虚拟时间关系,利用冻结的预训练视频模型的时间先验进行异构条件图像生成。
- 它引入了 Mixture of Temporal Experts (MoTE) 和 Chain of Temporal Reasoning (CoTR)。MoTE 根据文本和视觉上下文动态选择时间 RoPE 间隔专家,以建模目标与条件之间的距离;CoTR 使用潜在中间状态和推理瓶颈注意力掩码来建模条件到目标的变换。
- 在 DreamBench、COCO2017 和 GEdit 上的实验表明,该方法在主体驱动生成、canny-to-image 生成和图像编辑方面均优于对比方法,消融研究验证了自适应时间关系建模和隐式时间推理的有效性。
引言
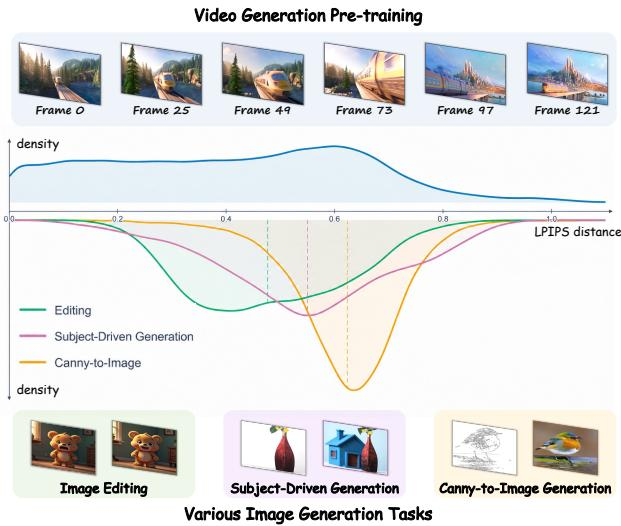
现实世界中的文本到图像生成通常需要以参考图像、文本和结构图等异构输入为条件,这些输入施加了不同的语义和空间约束。构建统一模型具有挑战性,因为此前以图像为中心的方法要么训练大型多任务模型,要么在预训练生成器上附加控制分支和轻量适配器,将条件视为辅助信号,而没有显式建模目标与条件之间的差异程度,或条件应如何被变换为目标。视频基础模型提供了有用的时间先验,但现有适配方法将条件帧和目标帧分配到固定的时间位置,忽略了图像编辑、主体驱动生成和 canny-to-image 生成需要不同的变换幅度,且同一任务内的样本也存在差异。作者将这些异构条件-目标关系建模为输入自适应的虚拟时间间隔,并提出 FrameForge。FrameForge 使用 Mixture of Temporal Experts (MoTE) 选择时间位置专家,使用 Chain of Temporal Reasoning (CoTR) 学习隐式的条件到目标变换路径,同时保持视频骨干网络冻结,并使用单个共享 LoRA。
方法
作者将预训练视频扩散模型适配到条件图像生成,方法是将任务表述为由文本和视觉条件引导的目标帧预测。该框架利用 3D VAE 和多模态扩散 Transformer 在压缩潜在空间中建模视觉内容和时间动态。目标图像被编码并加噪,而视觉条件使用冻结的 VAE 编码器编码为潜在表示。为促进隐式的条件到目标变换,作者引入了一个以噪声初始化的推理潜在变量。这些输入与文本表示一起由骨干网络联合处理,同时一个专门模块确定它们的时间位置配置。整体条件化表示为:
cours=[ztext,zcond,zreason]参见框架图:
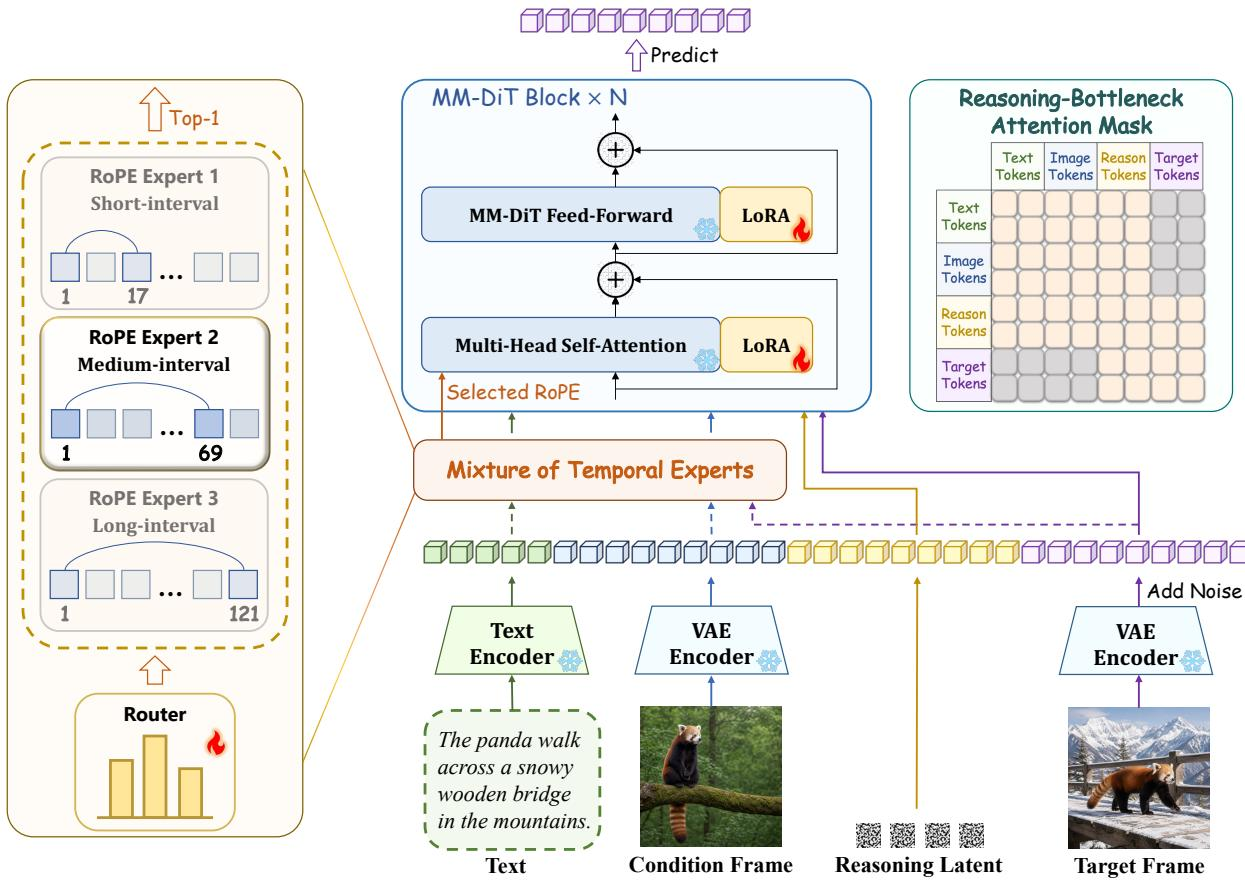
为了给跨帧交互提供灵活的时间先验,作者引入了 Mixture of Temporal Experts。该模块不使用固定的时间间隔,而是构建多个对应不同虚拟间隔的时间旋转位置嵌入专家。每个专家与一个候选潜在跨度相关联,该跨度对应等效的视频帧跨度。对于给定专家,旋转嵌入在虚拟潜在网格上构建,并保留特定时间坐标处的嵌入,用于条件、目标和推理潜在变量。
一个轻量路由器根据拼接的文本、条件和加噪目标表示选择合适的专家。路由器产生 token 级路由 logits,并通过掩码平均池化聚合得到样本级 logit 向量。路由概率和 Top-1 专家分配使用带温度参数的 softmax 函数计算。为实现离散路由的端到端优化,采用直通估计器,使前向传播使用单个选定专家,同时通过软路由概率传播梯度。随后,路由后的旋转嵌入以加权和形式计算,并应用于自注意力中的视觉查询和键。为防止路由坍缩并确保时间专家的均衡利用,引入批量级负载均衡损失,并将其加到标准扩散损失中。
为了建模从条件到目标的隐式变换,作者提出了 Chain of Temporal Reasoning。该模块在条件和目标之间插入一个中间推理潜在状态。该潜在变量从标准高斯分布中采样,并通过与文本、条件和目标表示的交互,在 Transformer 块中逐步被上下文化。它作为在目标预测之前聚合条件信息的潜在通路,仅使用目标帧目标进行训练,无需中间监督。
为确保模型有效利用这一中间通路,作者在中间训练阶段应用随机推理瓶颈注意力掩码。该掩码去除目标 tokens 与文本或条件 tokens 之间的直接注意力,迫使目标 tokens 通过不断演化的推理表示而非直接捷径获取条件信息。该掩码通过向相应自注意力 logits 添加负无穷来修改注意力连接,同时对于未掩码的样本保留原始全注意力模式。该机制不影响时间专家引入的时间位置条件化。
训练策略冻结预训练视频骨干网络权重和 VAE 编码器,同时在 Transformer 的注意力和前馈投影中插入单个 Low-Rank Adaptation 适配器。优化分三个阶段进行。在第一阶段,作者仅优化路由器,采用条件-目标形式,保持适配器参数固定并省略推理潜在变量,以学习时间路由。在第二阶段,加入推理潜在变量,并在应用随机推理瓶颈掩码的同时联合优化路由器和适配器。在最后阶段,保留两个模块,并在全注意力下继续联合优化。这一最终配置与推理设置一致,即路由器在每个去噪步骤选择一个时间专家,且共享适配器被用于每个任务。
实验
FrameForge 在主体驱动生成、canny-to-image 生成和指令引导图像编辑上进行了评估,使用经 LoRA 微调的 HunyuanVideo 骨干网络。实验表明,该方法在遵循文本提示的同时保留主体身份,保持对边缘条件的结构保真度,并改善指令引导编辑,尤其是在运动和空间变化方面。路由分析显示,MoTE 会根据任务和去噪阶段动态选择时间专家,而消融实验证实 MoTE 和 CoTR 是互补的,所选配置提供了最佳的整体权衡。额外结果表明,这些优势在不同视频骨干网络上具有泛化性。
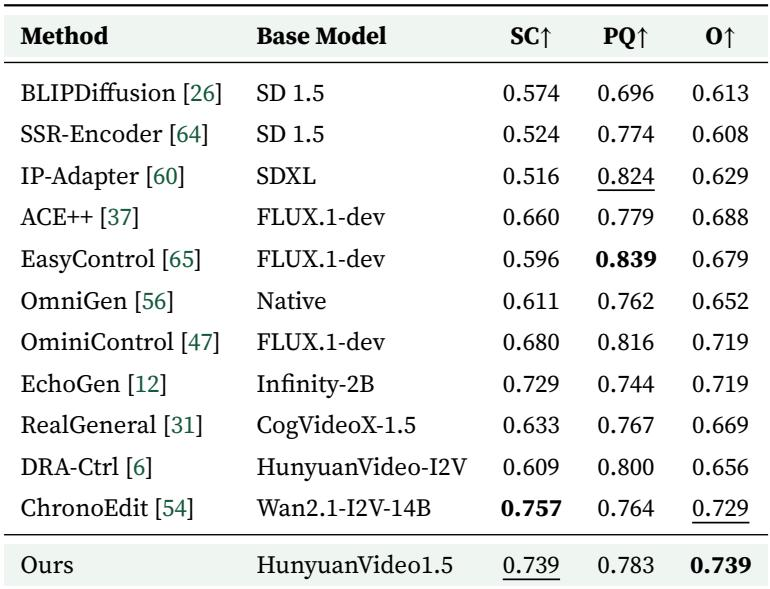
在 DreamBench 上的主体驱动图像生成中,所提方法在对比方法中取得了最强的整体结果,优于 ChronoEdit,并超过 OminiControl、ACE++ 和 EasyControl。其主体一致性仅次于 ChronoEdit,而 EasyControl 和 IP-Adapter 等感知质量较高的方法主体一致性明显较低。结果表明,该方法在保留主体身份和保持图像真实感之间取得了更好的平衡。所提方法在总体得分上排名第一,领先于 OminiControl、ACE++ 和 EasyControl。主体一致性具有竞争力,仅次于 ChronoEdit,而 IP-Adapter 和 EasyControl 为了更高的感知质量牺牲了主体一致性。
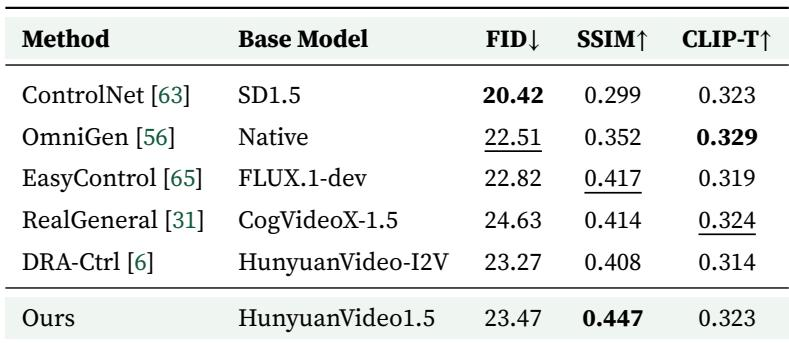
在 COCO2017 的 canny-to-image 生成上,FrameForge 在对比方法中取得了最高的结构相似度,SSIM 相对次优模型提升 7.2%,同时其图文对齐分数与 ControlNet 和 RealGeneral 保持相当。其 FID 与 DRA-Ctrl 和 RealGeneral 等基于视频的基线相当。FID 最低的方法仍表现出较弱的结构保真度,因此所评估指标反映的是互补特性。FrameForge 取得了最佳 SSIM,相对于第二名的 EasyControl 提升 7.2%,而 CLIP-T 分数仍与 ControlNet 和 RealGeneral 相当。FrameForge 的 FID 与 DRA-Ctrl 和 RealGeneral 处于同一范围,而 ControlNet 更低的 FID 并不对应更强的边缘保真度,这凸显了 FID 和 SSIM 的互补性。
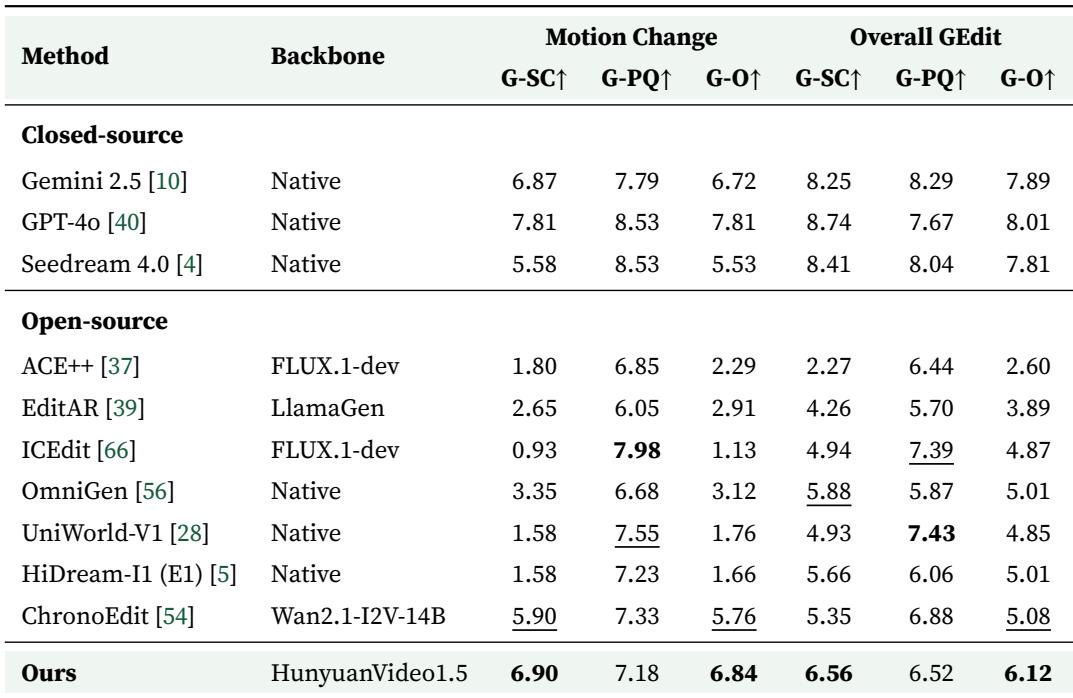
FrameForge 在运动变化和整体 GEdit 上领先于开源方法,明显优于 ChronoEdit。其运动变化性能超过闭源的 Gemini 2.5 和 Seedream 4.0,并接近 GPT-4o。基于图像骨干网络的适配方法在运动变化上落后,尽管 G-PQ 具有竞争力,这凸显了视频基础模型先验的价值。FrameForge 在运动变化和整体 GEdit 上取得了最佳开源分数,明显超过 ChronoEdit。其运动变化分数超过 Gemini 2.5 和 Seedream 4.0,并接近 GPT-4o。ACE++ 及类似的基于图像骨干网络的适配方法尽管 G-PQ 具有竞争力,但在运动变化和整体编辑上表现吃力。闭源原生模型在整体上仍领先,但 FrameForge 在运动为主的编辑上缩小了差距。
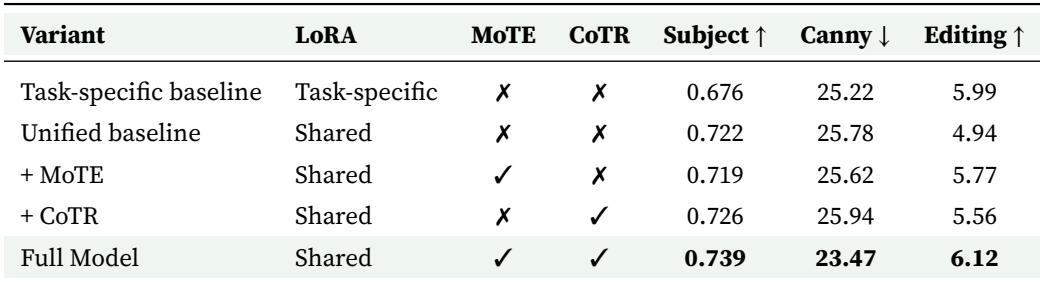
共享 LoRA 联合训练相比任务特定 LoRA 改善了主体驱动生成,但降低了编辑性能。单独加入 MoTE 或 CoTR 主要恢复编辑性能,同时使其他任务保持相对稳定。组合两个模块可获得最佳整体结果,具有最高的主体驱动和编辑分数,以及最低的 canny-to-image FID。共享 LoRA 联合训练改善了主体驱动生成,但相对于任务特定适配会降低编辑性能。MoTE 和 CoTR 具有互补性:单独使用主要改善编辑,而完整组合实现了最高的主体驱动和编辑分数,以及最低的 canny-to-image FID。
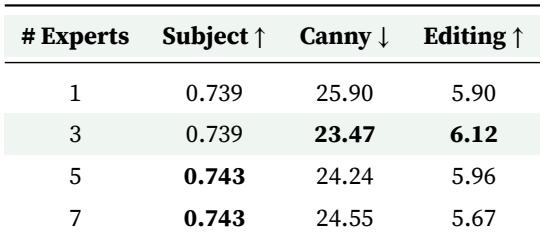
在启用 CoTR 且其他设置固定的情况下,改变时间 RoPE 专家的数量会改变各任务之间的权衡。三个专家实现了最佳整体平衡,与一个专家相比改善了编辑和 canny-to-image FID,同时保持主体驱动生成不变。五个或七个专家略微改善主体驱动生成,但会降低编辑和 canny-to-image 生成质量。将专家数量从一个增加到三个可改善编辑和 canny-to-image FID,同时保持主体驱动分数。五个或七个专家略微改善主体驱动生成,但会降低编辑和 canny-to-image 生成。在测试设置中,三个时间 RoPE 专家提供了最佳整体权衡。
实验涵盖 DreamBench 上的主体驱动生成、COCO2017 上的 canny-to-image 生成以及 GEdit 上以运动为主的生成式编辑。FrameForge 在身份保留与真实感之间取得了最佳的主体驱动总体平衡,主体一致性与 ChronoEdit 相当,并在 canny-to-image 中实现了最强的结构保真度,同时使文本对齐和 FID 与强基线保持可比。在 GEdit 上,它在运动变化和整体编辑方面领先于开源方法,在运动方面超过多个闭源模型并接近 GPT-4o。消融实验表明,将共享 LoRA 联合训练与 MoTE 和 CoTR 结合,并使用三个时间 RoPE 专家,可在主体驱动生成、编辑和 canny-to-image 质量之间提供最佳整体权衡。