Command Palette
Search for a command to run...
The Trinity:面向多模态智能体的能力驱动递归式自我改进
The Trinity:面向多模态智能体的能力驱动递归式自我改进
摘要
多模态智能可以被视为在人类引导下,世界与智能体通过交互进行的协同进化。然而,扩展这一过程面临两个瓶颈:构建异构且可验证的环境成本高昂,人工 Harness 迭代难以跟上任务多样性与复杂性的增长。一个关键见解是,具有不同模态和表层形式的任务可能共享相同的底层能力需求。为此,我们提出了 The Trinity,一个递归式自我改进框架,通过 Creator、Explorer 和 Evolver 三个角色将世界生成与 Harness 进化耦合起来。基于经过验证的执行轨迹,Evolver 将任务组织的依据从表层类别转变为共享需求,将原始任务树重组为层次化的能力树。我们提出了能力驱动的 Real2Sim2Real:对于同一节点上的异构任务,Creator 将其共同需求抽象为简化、可验证的模拟世界以进行能力学习,而在原始任务上的评估则衡量迁移效果。沿着该能力树,Explorer 通过选择性继承逐步演化出可复用的能力模块,形成一棵 Harness 树;其经过验证的更新在固定拓扑中跨迭代不断累积。由此得到的 Harness 针对不同能力各有所长,这促使我们设计了 Capability-Aware Harness Router(能力感知 Harness 路由器),利用公开任务信息从树中选择兼容的模块配置。我们进化得到的 Harness 在 28 个训练基准上将平均性能提升了 34 点,在 18 个未见基准上提升了 26 点,其中包括两个真实世界具身任务。
一句话总结
西安电子科技大学、同济大学、新加坡国立大学、加州大学伯克利分校等机构的研究人员提出 The Trinity,一个递归自我改进框架,该框架通过 Creator、Explorer 和 Evolver 角色将世界生成与 Harness 演化耦合,将任务重组为分层能力树,并应用 Capability-Driven Real2Sim2Real 与 Capability-Aware Harness Router,在 28 个训练基准上实现 34 点平均增益,在 18 个未见基准上实现 26 点平均增益。
核心贡献
- 本文提出 The Trinity,一个递归自我改进框架,通过 Creator、Explorer 和 Evolver 三种角色将世界生成与 Harness 演化耦合,并基于共享需求将异构任务重组为分层能力树。
- 该框架贡献了 Capability-Driven Real2Sim2Real,其中 Creator 将共同任务需求抽象为简化且可验证的模拟世界用于能力学习,Explorer 通过选择性继承逐步演化可复用能力模块,形成带有 Capability-Aware Harness Router 的 Harness 树以进行模块选择。
- 实验表明,演化后的 Harness 在 28 个训练基准上平均性能提升 34 点,在 18 个未见基准上平均性能提升 26 点,包括迁移到两个真实世界具身任务。
引言
多模态基础模型现已支持能够跨文本、图像、视频和音频进行感知、推理和行动的 agent,但将其扩展到复杂开放世界任务受到昂贵的人工环境构建和手工设计协调逻辑的限制。此前递归自我改进主要针对纯文本任务并演化任务特定的 Harness,这类 Harness 可能过拟合,在异构多模态任务中泛化较差;而单一全局 Harness 往往无法满足相互冲突的能力需求。作者主张从任务驱动的自我改进转向能力驱动的自我改进,即按感知和状态跟踪等共享底层需求对任务进行分组。作者提出 The Trinity,该框架通过 Creator、Explorer 和 Evolver 将环境生成与 agent 演化耦合,构建分层能力树,生成简化且可验证的训练世界,并使用能力感知路由为异构任务和真实世界迁移选择专用 Harness。
数据集

作者如下描述 Evolver 的数据集和轨迹收集设置:
- 来源与组成:Evolver 将公开多模态基准规范化为目标、观测、动作、反馈、任务完成标准和预算的统一规范。每个规范化基准都独立对照原始来源进行检查。基准被归入五个需求领域:规则发现、约束问题求解、感知与控制、multi-agent 交互和长时程环境。
- 公共接口:共享的观测-动作接口在不同基准之间保持信息访问和评分规则。
- 划分设计:训练/未见划分在能力归纳之前固定。只有训练记录支持能力树构建、世界生成、模块学习和 Router 训练。未见能力需求仅在能力树固定后用于评估。
- 轨迹收集:Explorer 在固定设置下使用初始策略 H0 从采样的训练实例中收集轨迹。实例选择器和初始状态哈希提前固定。
- 运行过滤与验证:保留已完成的运行。诊断性重跑会重置记忆。基础设施故障被标记为无效并重试。哈希链检查验证执行记录。
- 提供的摘录不包含数据集大小、混合比例或裁剪细节。
方法
作者介绍 The Trinity,一个在冻结骨干模型下将环境生成与 Harness 演化耦合的框架。如下图所示:
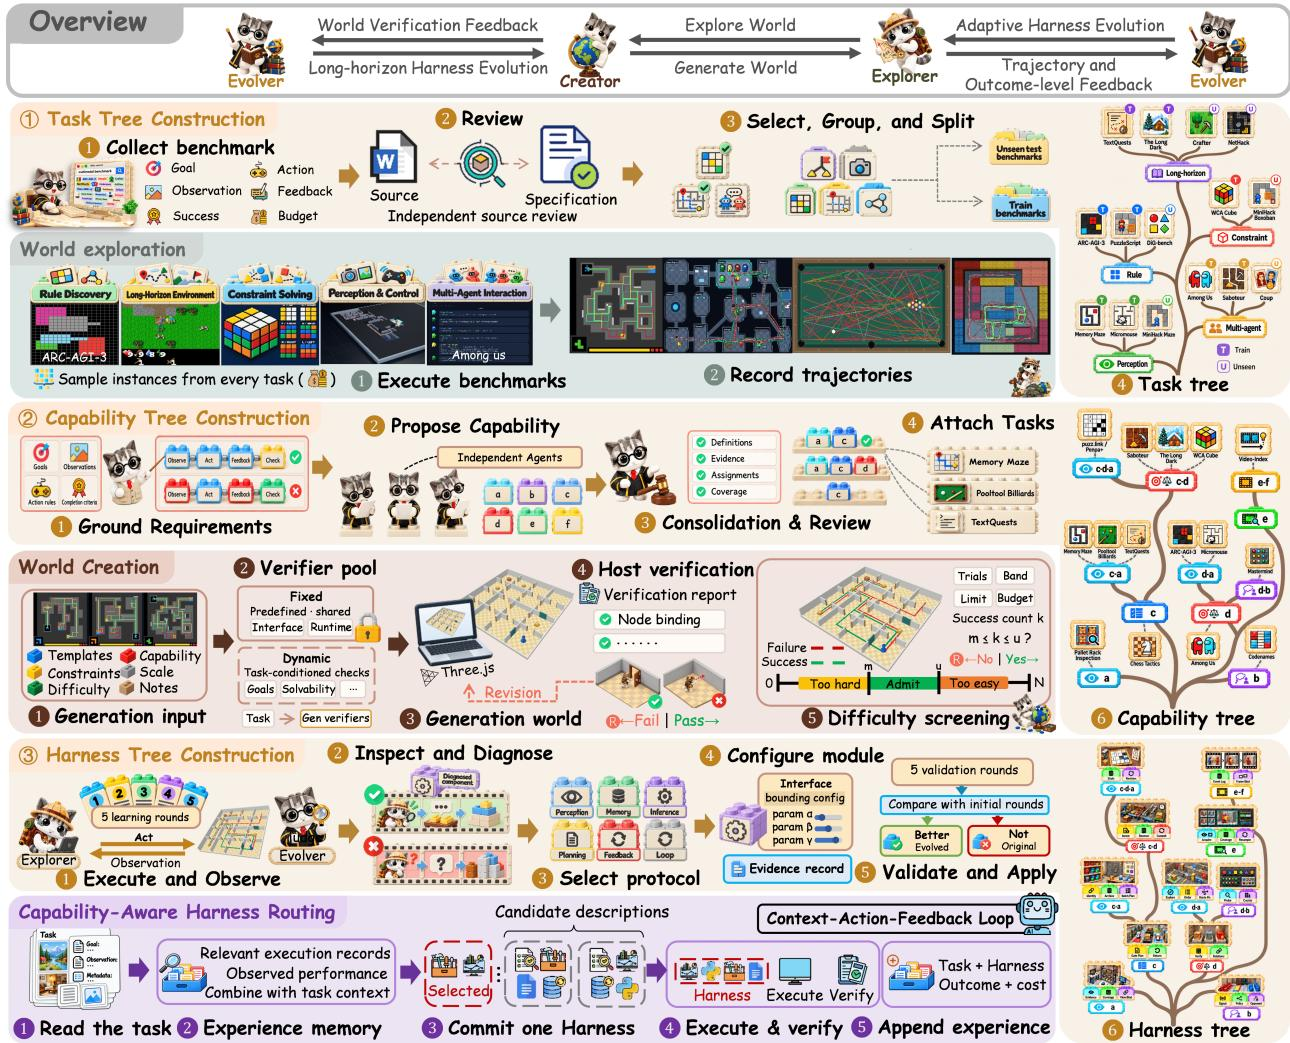
系统通过三个主要阶段运行:任务树构建、能力树构建和 Harness 树构建。Explorer 收集轨迹,Evolver 根据规范和经过验证的轨迹将需求组织为能力树。通过 Capability-Driven Real2Sim2Real,Creator 构建简化且可验证的世界。Explorer 选择性地继承并改进可复用模块,在固定拓扑的 Harness 树中积累经验证的更新。最后,Capability-Aware Harness Router 使用公开任务信息和经过验证的经验选择兼容分支。
一个 Harness 配置 ϕ 通过六个控制流协议协调冻结模型 fθ:
Hϕ=(Πer,M,I,P,F,L)给定任务 τ、观测 ot、公开历史 ξ<t、控制器状态 st 和可用资源 Cτ,各协议如下工作。Perception 提取事实 ft。Memory 构建以历史为条件的视图 νt。Inference 维护兼容候选。Planning 对选项进行排序或剪枝,形成指令 dt。Orchestration 识别适用资源。Loop 解析执行 et 和承诺 ct。模块是所提供公开记录的纯函数,不访问隐藏状态。
Evolver 将公开多模态基准规范化为目标、观测、动作、反馈和任务完成标准的说明。Explorer 使用基础 Harness H0 从采样的训练实例中收集轨迹。Evolver 随后从任务目标推导需求,并将其与规则和轨迹步骤关联。确定性能力顺序 ≺ 定义路径和树结构:
pτ=sort≺(Kτ),T=Trie({pτ:τ∈Btr})Trie 在各领域间合并公共前缀。能力树构建完成后,Creator 根据节点需求设计简化的训练关卡。参见世界创建示例:
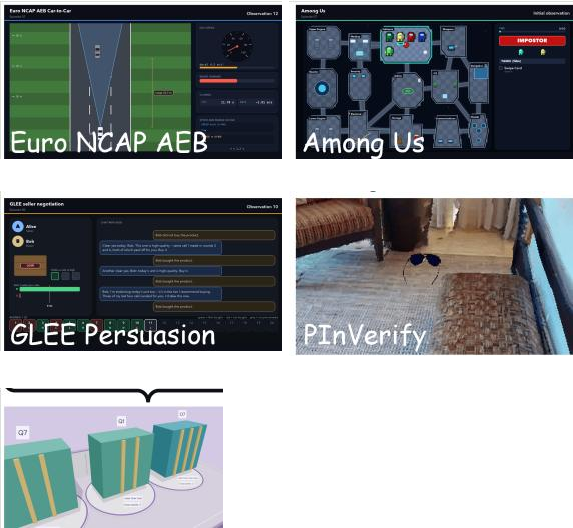
这些生成的世界保留核心决策过程,同时排除目标任务布局和私有证明。Evolver 的宿主执行验证器池检查节点绑定、执行、状态转移和完成情况。
在 Explorer 方面,能力驱动的递归自我改进构建与能力树对齐的 Harness 树。在每个节点,Explorer 使用继承模块和本地模块执行获准世界。Evolver 比较成功轨迹和失败轨迹,以识别节点特有的改进。选择性继承应用于非根节点。Harness 模块配置定义为 HE,ν(i)=Pν(i)⊕Lν(i),其中注册表使用宿主注册的绑定 ID 和右偏并集:
(P⊕L)[m]={L[m],P[m],m∈dom(L),m∈dom(P)∖dom(L).持续细化根据 Explorer 的轨迹 Zν(i+1) 更新本地模块:
Lν(i+1)=Evolve(Lν(i),Zν(i+1),Fν(i))在每次迭代结束时,Creator 对互补更新进行去重并合并到下一个 Base Harness 中。经过验证的修订替换先前版本,不同能力被保留,部分重叠被合并。
路由遵循上下文-动作-反馈循环。设 xn 包含公开目标、初始观测、元数据和图像,设 C⊆H(i) 为固定 Harness 池。记忆 M0 通过导入经过验证的训练侧分类轨迹进行初始化。对每个任务,候选描述、检索到的经验和观测到的性能-成本摘要引导选择:
hn=π(xn,C,R(xn,Mn),S(Mn))agent 在执行前以基于证据的理由承诺 hn。在终止回执经过验证后,结果和成本 fn 更新记忆以用于后续任务:
Mn+1=Append(Mn,(xn,hn,fn))实验
评估使用 28 个训练基准和 18 个未见基准,采用冻结的 Claude Opus 5 骨干模型,对每个基准-Harness 对在五次试验中准备技能,并在评估时保持这些技能固定。实验表明,能力驱动的组织方式优于扁平分组和任务领域分组,尤其是在模拟世界保留任务决策过程时。递归自我改进在多次迭代中带来持续增益,能力感知路由使 agent 能够选择合适的 Harness,能力模块分析证实相关模块的增加有帮助,而移除会造成损害。具身迁移测试进一步表明,经过能力演化的 Harness 提高了 SOON 和 CaP-X 任务中的仿真和真实机器人表现。
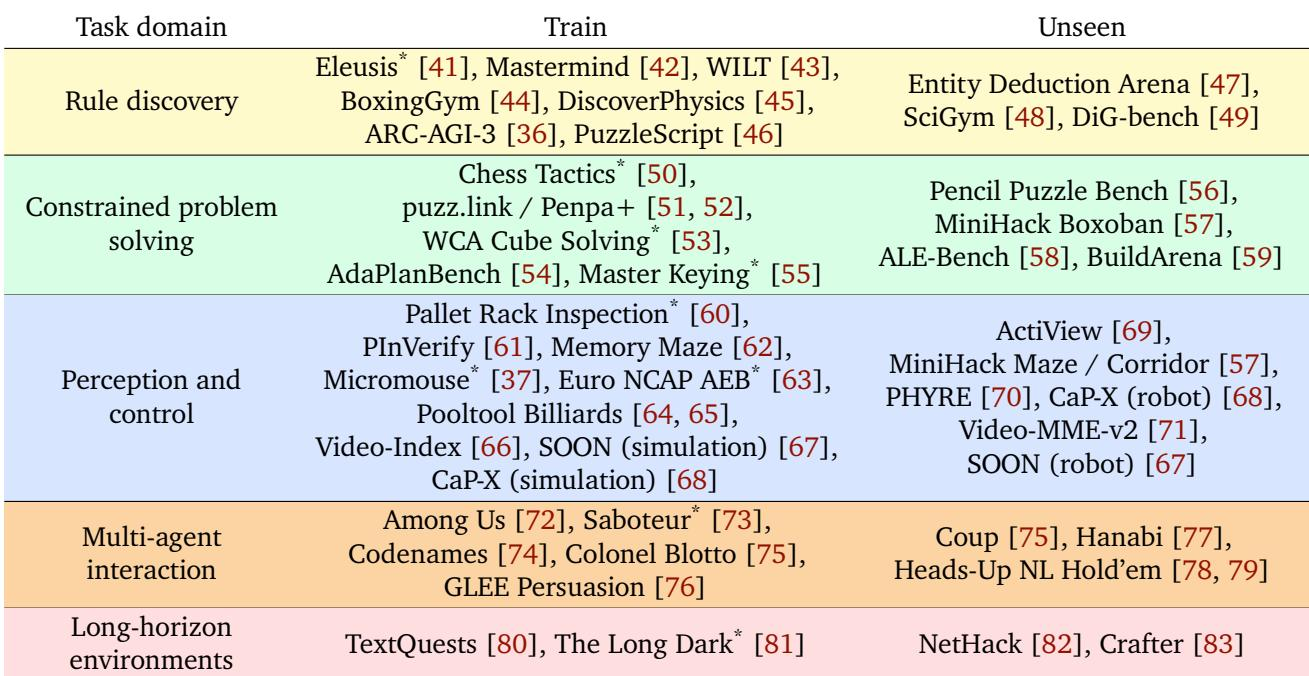
基准套件涵盖五个任务领域:规则发现、约束问题求解、感知与控制、multi-agent 交互和长时程环境。它包含 28 个训练基准和 18 个未见基准,其中训练在多个回合上使用固定的代表性实例,未见使用官方或固定的官方评估集。若干训练任务由 agent 从网络搜索来源构建。训练基准和未见基准都覆盖全部五个任务领域,从规则发现到长时程环境。未见评估包括多种任务,如 NetHack、Crafter、MiniHack Maze、PHYRE 和 Heads-Up NL Hold'em。若干训练基准由 agent 从网络搜索来源构建,包括规则发现、约束问题求解、感知与控制等任务。
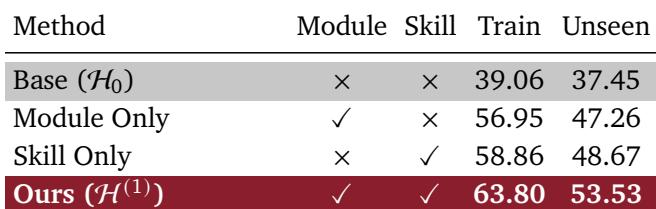
仅添加演化模块或技能在训练和未见评估中都比基础 Harness 有所提升。将演化模块与技能结合产生最强结果,表明两类贡献互补。仅演化模块和仅添加技能都在训练和未见设置中优于基础 Harness。将演化模块与技能结合达到最佳训练和未见性能,优于任一单独干预。
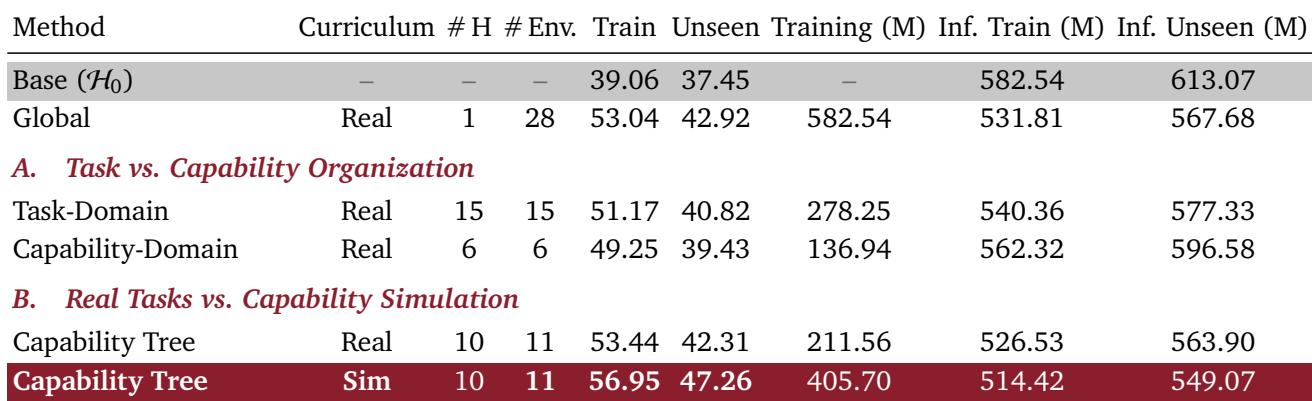
在仅模块评估中,通过全局 Harness 共享经验优于任务领域和扁平能力领域组织,而真实能力树通过选择性继承比扁平分组带来额外增益。仿真能力树达到最强的训练和未见性能以及最低的推理 token 成本,尽管其第一次迭代训练成本高于真实树和任务领域方案。扁平能力分组的训练成本最低,但在训练和未见评估中不如全局经验共享。真实能力树通过共享能力前缀和选择性父级继承优于扁平能力分组。仿真能力树达到最佳的仅模块训练和未见分数以及最低的推理 token 数量,同时需要比真实树和任务领域组织更多的第一次迭代训练 token。
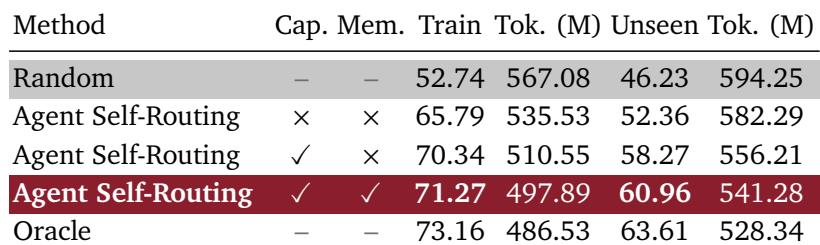
自路由在训练和未见划分上均优于随机路由,添加能力定义和检索到的执行经验进一步改善性能,同时降低估计推理 token。完整自路由配置接近 oracle 性能。随机路由产生最低分数和最高 token 估计。为 agent 自路由添加能力定义和检索到的执行经验改善了两个划分并降低了 token 成本。完整自路由配置接近 oracle 性能。
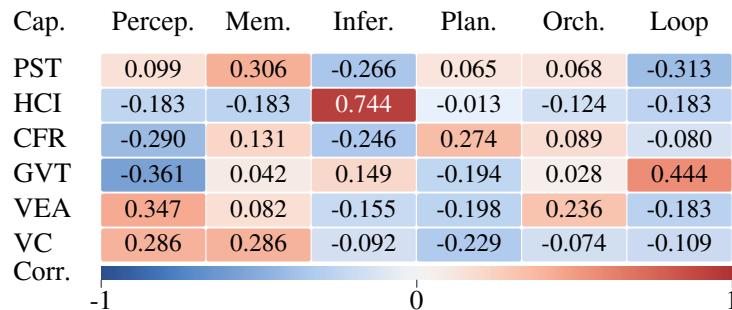
在六个协议中,能力关联并不均衡:inference 与 HCI 强正相关,loop coordination 与 GVT 相关,perception 与 VEA 和 VC 相关,而 PST 显示与 memory 正相关、与 inference 和 loop 负相关。受控模块编辑显示,相关增加的性能增益远大于不相关增加,移除相关模块会降低性能并增加 token 使用。HCI 与 inference 强正相关,与 perception、memory 和 loop 能力负相关。GVT 与 loop coordination 相关,VEA 和 VC 更与 perception 相关。相关模块增加带来的性能提升远大于不相关增加;移除相关模块会降低性能并增加 token 使用。
评估使用涵盖五个任务领域、包含 28 个训练基准和 18 个未见基准的基准套件来测试模块化技能演化与路由。将演化模块与技能结合产生最强结果,仅模块性能受益于全局经验共享和能力树组织,仿真能力树尽管初始训练成本较高,但降低了推理 token 成本。带能力定义和检索到的执行经验的自路由进一步改善分数,同时降低 token 估计,接近 oracle 性能。分析还表明能力与任务之间关联不均衡但有意义,其中添加相关模块产生的增益远大于不相关增加,移除相关模块会降低性能并增加 token 使用。