Command Palette
Search for a command to run...
Rollback:世界模型中的经验回溯以实现策略改进
Rollback:世界模型中的经验回溯以实现策略改进
摘要
以动作为条件的世界模型为改进机器人策略提供了一种可扩展的替代方案,用以替代代价高昂的真实世界交互。然而,现有基于世界模型的方法大多仅将世界模型视为物理环境的前向替代品,未能利用一种物理环境所不具备的能力:回退到过去的决策点以探索反事实未来。在本文中,我们提出 Rollback,一种将世界模型从被动模拟器转变为反事实引擎的策略改进范式:它回退到关键决策点,分支出替代动作,并对比不同动作的结果,从而将成功归因于具体决策。这使得模型想象集中在最关键的环节,并将反事实结果提炼为细粒度的动作级监督,而无需单独学习价值模型。此外,我们构建了一个可扩展的训练系统,将分布式世界模型搜索与异步真实机器人执行统一起来,形成自我强化循环:真实世界经验不断优化世界模型,而更精准的世界模型又反过来进一步推动策略改进。我们将该循环中世界模型一侧称为测试时物理接地(test-time physics grounding),这是手工构建的物理模拟器所不具备的能力:虽然世界模型充当训练环境,但由其所训练策略产生的真实转移会通过轻量级 LoRA 流程校正世界模型的动力学。在三个具有挑战性的真实世界任务上的实验表明,Rollback 在方块提取、抛球和桌面冰壶任务上相较于最强基线分别将成功率绝对提升了 10.67%、11.11% 和 11.85%,并且在整个训练过程中实现了更稳定的提升。尽管 Rollback 的训练从远低于人类水平的遥操作演示开始,但它在训练 8 小时内就在抛球和桌面冰壶两个任务上超过了人类玩家的平均成功率。
一句话总结
AgiBot、北京航空航天大学和新加坡国立大学的研究人员提出 Rollback,一种策略改进范式,它通过回滚到关键决策点、分支到替代动作并对比其结果,将世界模型转化为反事实引擎,从而在无需单独价值模型的情况下提供动作级监督;借助分布式搜索和基于 LoRA 的测试时物理校准,该范式在实际任务成功率上比最强基线提高 10.67 到 11.85 个百分点。
核心贡献
- 本文提出 Rollback,一种策略改进范式,它通过回退到关键决策点、分支替代动作并对比结果,将动作条件世界模型转化为反事实引擎,从而把成功归因到具体决策。该范式将反事实结果提炼为细粒度动作级监督,无需单独学习价值模型。
- 本文提出一个统一训练系统,将分布式世界模型搜索与异步真实机器人执行相结合,形成自我强化的循环:真实经验改善世界模型,改进后的模型进一步驱动策略训练。该系统还引入测试时物理校准,使用轻量级 LoRA 流程,根据正在训练的策略产生的真实转移来修正世界模型动力学。
- 在三个真实机器人任务上的实验表明,Rollback 在方块提取、抛球和桌面冰壶任务上分别比最强基线绝对提高 10.67%、11.11% 和 11.85% 的成功率。Rollback 在训练过程中也获得更稳定的提升,并在训练 8 小时内于抛球和桌面冰壶任务上超过平均人类成功率。
引言
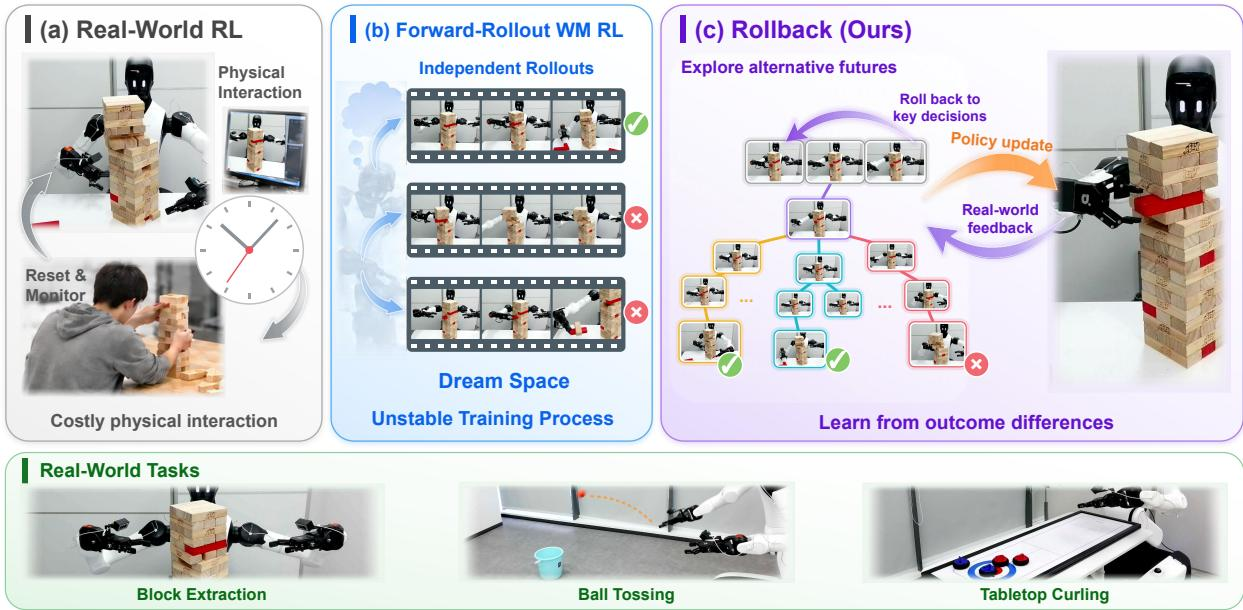
动作条件世界模型为机器人策略学习提供模拟环境,通过让策略在想象结果中改进,降低对昂贵物理试错的依赖。然而,以往基于世界模型的策略学习大多保持真实世界训练中以轨迹为中心的交互协议:它生成前向推演并丢弃中间上下文,因此没有利用所学世界模型回退到更早决策点并探索替代方案的能力。现有方法还面临信息性探索有限、决策级监督稀疏,以及策略分支到不熟悉状态时世界模型预测存在偏差等问题。作者提出 Rollback,一种策略改进范式,它将世界模型转化为可回退的训练环境或反事实引擎,使用经验回溯树搜索、无需单独价值模型的树结构化优势估计,以及带有测试时物理校准的世界模型与策略协同演化,实现更稳定、样本效率更高的真实世界机器人学习。
方法
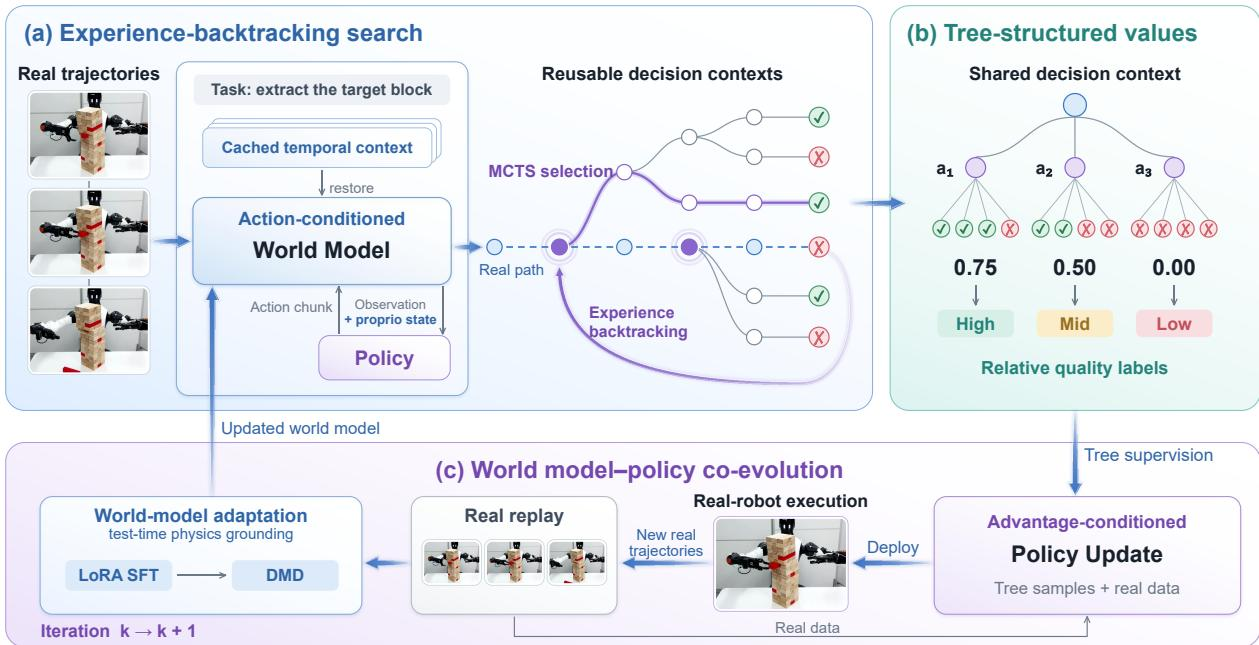
作者提出 Rollback,一种策略改进范式,它在学习到的视频世界模型中利用经验回溯。如框架图所示,Rollback 重新访问决策点,通过下游结果比较替代动作,并将结果提炼到策略中,同时真实世界反馈会优化世界模型。
经验回溯树搜索
与物理环境不同,世界模型允许其显式数据结构被缓存和恢复,使多个后续轨迹可以从同一个决策点分支。作者将此操作称为经验回溯。为了组织可复用的决策上下文,Rollback 构建了一棵搜索树。给定来自离线演示或真实轨迹的种子轨迹,世界模型预测未来的多视角图像帧和机器人本体感觉状态。每个非终止节点都是一个分支点,策略在该节点提出替代动作,世界模型模拟其后果。每个想象节点的世界模型上下文被缓存,从而无需重新生成共享前缀即可进行后续推演。
为了将想象预算集中在有前景的区域,作者采用蒙特卡洛树搜索(MCTS)。对于每个节点 v,维护访问次数 N(v) 和累积回报 W(v),得到经验搜索值 Q(v)=W(v)/N(v)。已有子节点 u 根据 PUCT 分数选择:
U(v,u)=Q(u)+cpuctP(u∣v)1+N(u)1+N(v)其中 P(u∣v) 是先验。对于连续动作块,渐进式扩展允许引入新动作。策略本身作为提议分布,从最高价值区间策略中采样动作块,以探索合理的替代方案。为了确保比较具有信息量,系统将更多推演分配给具有不同临时价值区间的兄弟子树,直到满足置信度阈值。
树结构化价值估计
树结构将动作与多个下游结果连接起来,从而无需拟合额外的价值函数即可生成动作块级别的质量标签。作者使用微调的世界评判器,从动作块 ai 的下游推演结果中估计其价值。动作块价值估计为:
q^(v,ai)=∣L(ui)∣1ℓ∈L(ui)∑yℓ其中 L(ui) 表示以 ui 为根的子树的叶节点集合。为了将这些估计转化为策略监督,会比较同一决策上下文中的替代动作。动作块价值按最佳兄弟价值 qmax(v) 归一化,并离散化为 K 个区间:
ρi=qmax(v)q^(v,ai),bi=min(K,1+⌊Kρi⌋)标签 bi∈{1,…,K} 表示相对表现。遵循 RECAP 的做法,作者以这些离散优势标签为条件,使用流匹配目标训练策略:
Lπ(θ)=E(o,g,a,b)∼Dmixs,ϵ,b~∼p(b~∣b)[vθ(xs,s∣o,g,b~)−(ϵ−a)22]其中 Dmix 混合了树生成样本、离线演示和机器人采集轨迹。
世界模型与策略协同演化
随着策略演化,其分布可能偏离世界模型的训练数据。为了阻止策略利用不准确的预测,作者通过测试时物理校准持续调整世界模型。新采集的真实轨迹被加入重放集,世界模型使用动作条件预测目标进行调整:
LSFT(k)(ϕ)=Eτ∼Dreal(k+1)[t∑ℓWM(ϕ;o≤t,at,ot+1,g)]LoRA 适配器保持每次更新幅度较小,随后应用分布匹配蒸馏(DMD)获得少步生成器,以实现高效的想象交互。
异步真实与想象训练系统
视频世界模型中的搜索计算开销很大,而真实机器人交互速度较慢。为避免资源闲置,Rollback 将真实机器人执行、世界模型搜索、策略训练和世界模型调整作为并发进程运行。基础设施分为三层:云、边缘和设备。
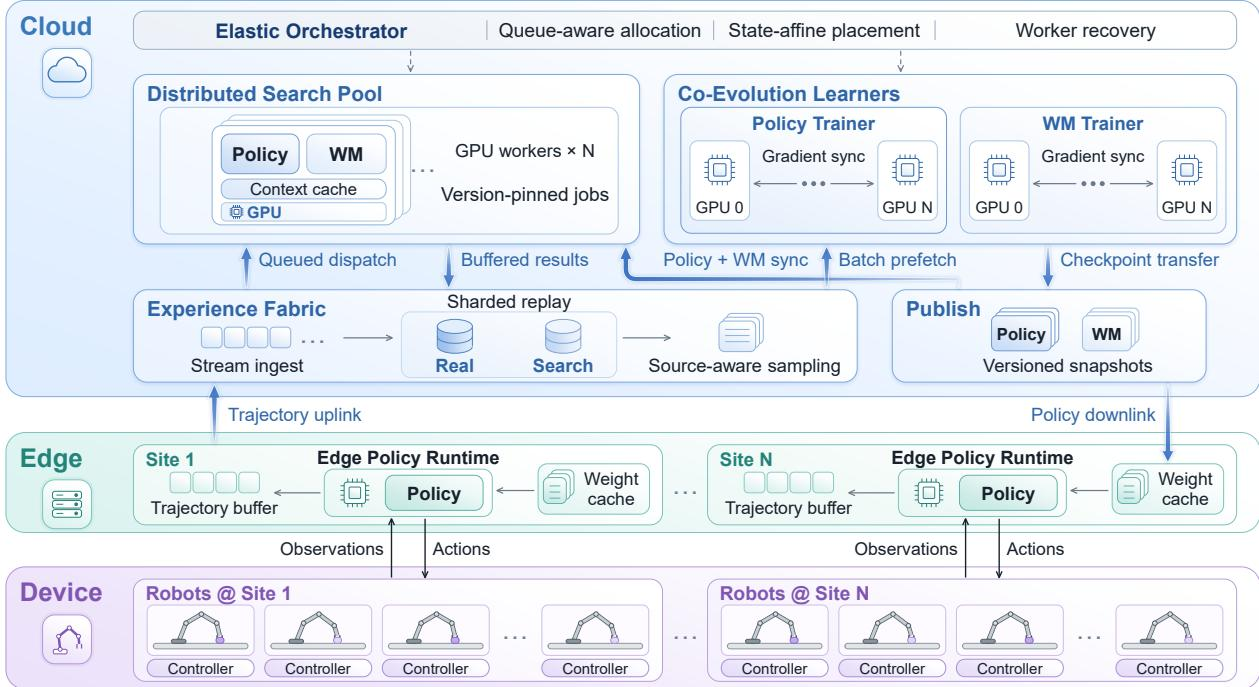
所有 GPU 密集型工作,包括搜索、数据存储和训练,都在云端运行。分布式搜索池(Distributed Search Pool)在 GPU worker 上承载策略副本、世界模型实例和上下文缓存。每个 worker 独立为一条种子轨迹构建搜索树,并且只有在树构建完成后才发送监督信号。Experience Fabric 将真实轨迹和树监督存储在不同的流中,使学习器能够预取批次而无需等待生产者。协同演化学习器(Co-Evolution Learners)由策略训练器(Policy Trainer)和世界模型训练器(WM Trainer)组成,它们使用分布式数据并行持续优化各自的目标。边缘站点为机器人运行策略推理,缓存轨迹以便上传,并缓存策略快照。
训练过程完全异步运行,仅通过 Experience Fabric 和带版本的模型快照交换信息。
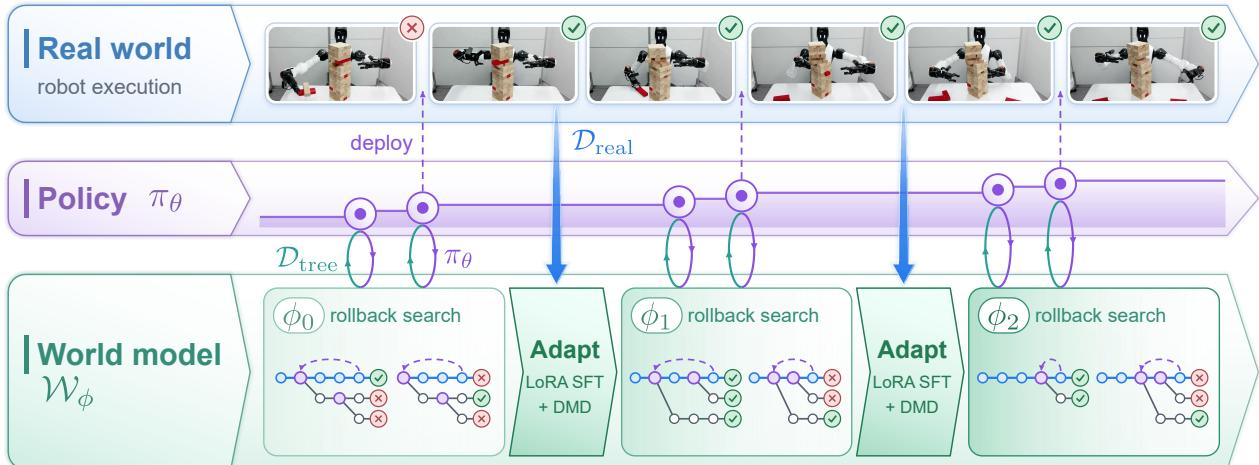
机器人持续执行最新策略,并将带标签轨迹上传到 Dreal。同时,GPU worker 持续运行经验回溯搜索,策略训练器在 Dmix 上更新策略。与此并行,世界模型训练器不断根据累积的真实轨迹调整世界模型。每棵搜索树在开始时都固定于当时可用的最新策略和世界模型快照,以保证内部一致性。策略快照在机器人下一个回合边界生效,每个搜索 worker 在下一棵树开始时获取新快照,从而形成持续改进循环。
实验
Rollback 在一台真实机器人上针对三个操作任务进行了评估,与模仿学习、真实世界强化学习以及使用同一模型的世界模型基线进行比较。实验表明,Rollback 优于所有基线,经验回溯和树结构化价值监督带来的提升最大;消融实验确认,世界模型调整和子树聚合标签都对稳定提升和任务成功很重要。训练动态和定性分析还表明,Rollback 稳定提升,通过从真实中间状态分支在两个任务上超过人类表现,并受益于降低漂移、保持可靠奖励标签的协同演化世界模型。
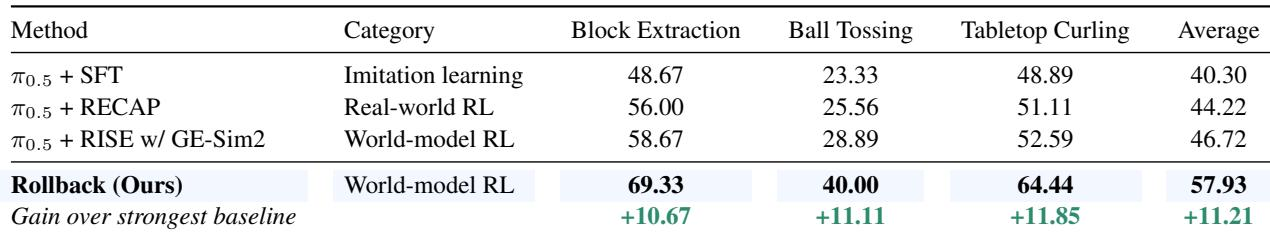
Rollback 在全部三个真实世界任务上取得最高成功率。与最强的前序世界模型基线相比,每个任务约提高 11 个百分点,平均相对提升约 24%。经验回溯带来的收益超过真实世界强化学习和标准前向世界模型推演带来的收益之和。Rollback 在方块提取、抛球和桌面冰壶任务上达到最高成功率,其中抛球和桌面冰壶的提升最大。在相同世界模型下,经验回溯带来的平均提升大于真实世界强化学习和前向世界模型推演之和。
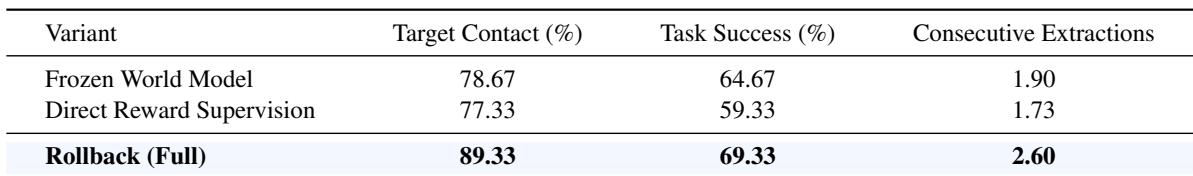
在方块提取任务上的消融实验比较了完整框架、冻结世界模型,以及用直接奖励监督替代树结构化价值估计。完整框架在目标接触、任务成功和连续提取次数上取得最佳结果。直接奖励监督在全部三项指标上记录最低值,表明测试时世界模型调整和树结构化价值估计都支持更可靠的提取。完整框架在目标接触、任务成功和连续提取次数上优于两种消融设置。直接奖励监督在所有报告指标上落后于冻结世界模型,且任务成功率和连续提取次数最低。两种消融设置均低于完整框架,说明测试时物理校准和子树聚合价值估计各自对提取性能有贡献。
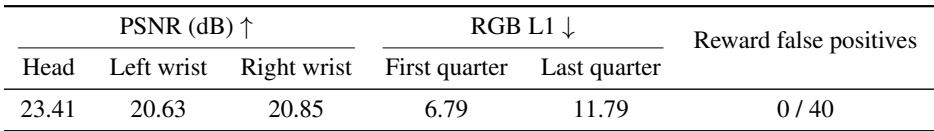
在方块提取任务上,协同演化世界模型中的开环推演表现出中等视觉保真度,头部相机比腕部相机预测得更准确。预测误差随推演时间范围增加,表明更长的想象推演偏离现实越远。在 40 个重放的失败回合中,奖励模型没有产生假阳性成功判断。头部相机视角比左腕和右腕视角预测得更准确。预测误差从推演的前四分之一到最后四分之一逐渐增大,支持使用较短的想象分支。奖励模型在 40 个重放的失败回合中报告零成功事件,避免了假阳性。
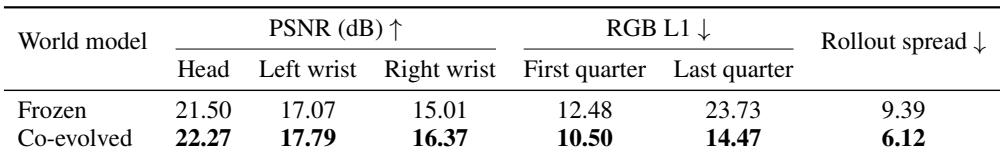
协同演化世界模型比冻结模型更忠实地预测桌面冰壶验证回合。它在各相机视角上表现出更高的 PSNR 和更低的 RGB L1 误差,并且在每个回合上的平均误差都更低。预测漂移随推演的增长也更慢,重复推演之间的离散程度更小。协同演化模型在头部、左腕和右腕视角上提高了 PSNR 并降低了 RGB L1 误差。从推演的前四分之一到最后四分之一,协同演化模型的误差增长远小于冻结模型。协同演化模型的重复推演离散程度更低,表明开环预测更一致。
Rollback 在三个真实世界操作任务上进行了评估,取得了最高成功率,并表明经验回溯的贡献大于真实世界强化学习和前向世界模型推演之和。方块提取上的消融实验表明,测试时世界模型调整和树结构化价值估计都改善了目标接触、任务成功和连续提取次数,而直接奖励监督表现最差。对协同演化世界模型的分析显示,在方块提取上视觉预测中等但存在漂移,失败回合中没有假阳性奖励判断;在桌面冰壶上,它比冻结模型更忠实且一致地预测验证回合。