Command Palette
Search for a command to run...
OmniShowcase:面向多视图图像的全向主体一致性视频生成
OmniShowcase:面向多视图图像的全向主体一致性视频生成
Junyeong Ahn Geonwoo Kim Kinam Kim Gihwi Kim Hoonjin Jung Hyojin Jang Jaegul Choo
摘要
从少量参考图像生成特定主体的视频仍然具有挑战性,尤其是当相机拍摄到输入中不可见的表面时。早期的主体到视频(S2V)方法以单张参考图像为条件,因此必须在视角变化时推断主体不可见的外观和几何形状。为解决这一局限,近期方法将 S2V 扩展到多参考视图,从不同视点提供更多关于主体的信息。然而,这些方法没有显式指定连接这些观测的 3D 结构。此外,现有训练数据无法保证视角变化时保持同一底层 3D 主体。我们提出 OmniShowcase,其构建包含两个部分:(i)一个全自动数据合成流程,沿多样化相机轨迹生成训练视频,其视角变化由底层主体几何驱动,甚至可覆盖完整的 360°环绕轨迹;(ii)一种几何条件化方法,将从参考视图重建的表面法向图转盘提供给视频模型,且无需与生成帧进行时间对齐。我们构建了 SHOWCASE-4K 和 SHOWCASEBENCH:前者是一个基于 3D 资产的视频语料库,涵盖 12 种相机运动、88 种轨迹配置,并带有重建得到的表面法向条件;后者是留出评估集,包含用于渲染每个视频的源网格和相机参数。实验表明,该方法在主体身份和 3D 一致性上达到当前最优水平,同时保持具有竞争力的视频质量和运动表现。项目页面:justin4ai.github.io/OmniShowcase
一句话总结
KAIST AI、仁荷大学和 FLIPTION 的研究人员提出了 OmniShowcase,这是一个多视角主体到视频框架,结合了基于 3D 资产的完全自动化数据合成流水线,用于生成多样化的相机轨迹(包括完整的 360 度环绕轨道),并使用从参考视图重建的表面法线几何条件,同时引入了 SHOWCASE-4K 和 SHOWCASEBENCH,在主体身份保持和 3D 一致性方面达到了当前最优水平。
核心贡献
- OmniShowcase 包含一个完全自动化的数据合成流水线,可沿多样化相机轨迹(包括完整的 360 度环绕轨道)从 3D 资产渲染训练视频。该流水线生成了 SHOWCASE-4K,这是一个覆盖十二种相机运动和 88 种轨迹配置、并带有重建所得表面法线条件的语料库。
- 该框架以从参考视图重建的表面法线图旋转台为条件来驱动预训练的图像到视频扩散 Transformer,提供显式 3D 几何信息,且无需与生成帧进行时间对齐。
- SHOWCASEBENCH 提供带有源网格和相机参数的留出评估集;OmniShowcase 在 SHOWCASEBENCH 和 NAVI 上实现了当前最优的主体身份保持和 3D 一致性,同时保持具有竞争力的视频质量和运动表现。
引言
主体到视频生成旨在根据参考图像创建指定主体的视频,同时保持其外观在时间和视角上的一致性。最近的视频扩散模型可以生成逼真的片段,但大多数主体到视频方法以单张参考图像为条件,这仅约束可见表面,使不可见区域未被定义。随着相机移动,这通常会导致几何不一致、轮廓变化或表面细节不稳定。核心挑战在于几何:模型必须推断输入中缺失的 3D 结构。现有多视角方法要么使用生成的多视角视频,要么对静态图像进行逐主体优化,但都没有显式编码 3D 几何,也无法避免测试时自适应。作者提出了 OmniShowcase,将用于从 3D 资产渲染多视角视频的自动化流水线与几何感知条件相结合。该方法从稀疏参考视图重建表面法线序列,并在生成过程中将其作为上下文线索使用,从而改善主体身份和跨视角 3D 一致性,而无需逐帧对齐或逐主体优化。
数据集
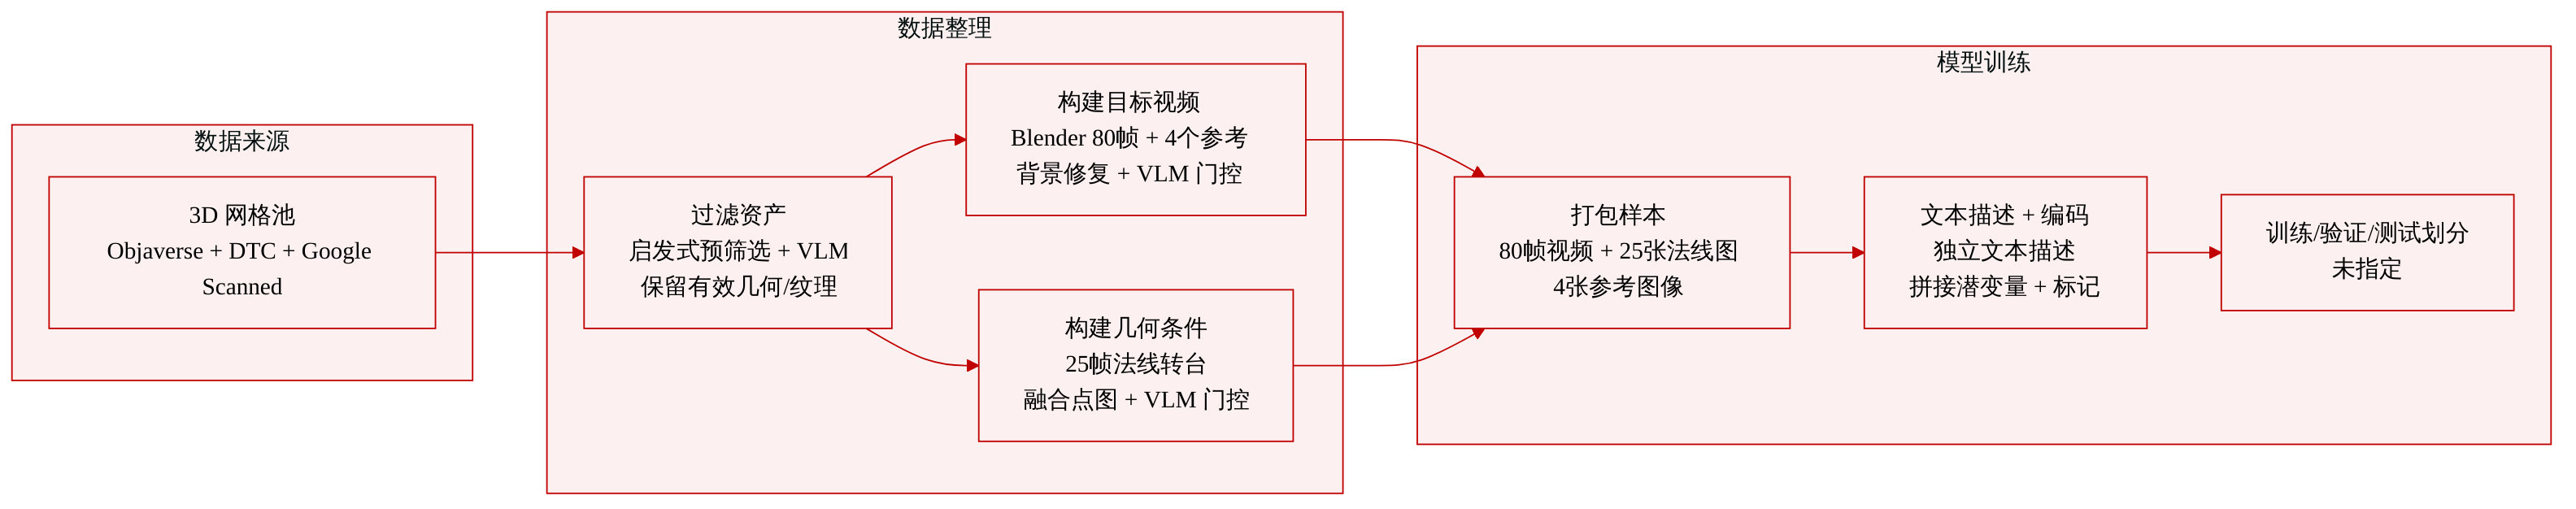
数据集描述:
作者构建 SHOWCASE-4K 作为一个合成的、3D 一致的视频数据集,并带有配对的几何条件。数据流水线分为两个分支:一个用于目标视频生成,一个用于几何条件生成。关键设计是从已知 3D 网格渲染,使所有视图共享同一底层形状和外观,然后合成真实背景。
来源与筛选:
- 3D 网格来自 Objaverse、Digital Twin Catalog 和 Google Scanned Objects。
- 启发式预筛选会移除退化网格。
- 视觉语言模型检查每个资产的四个渲染视图,仅保留几何有效、纹理合理且类别一致的资产。
- 本节未报告各来源的精确数量。
目标视频构建:
- Blender 为每个网格渲染一个 81 帧目标视频,并以 90 度偏航间隔渲染 N=4 个参考视图。
- 合成使用 88 种轨迹配置:四种轨道族运动,每种包含四个旋转量,另有八种附加运动,如弧线、横移、推拉和变焦变体,每种包含九个取景过渡。
- 为缩小与干净背景渲染之间的域差距,来自渲染 alpha 通道的主体掩码驱动视频修复模型,在保留渲染主体像素的同时合成连贯背景。
- 场景提示将来自语言模型编写的场景库中的地点与样本相机运动和光照相结合。
- 视觉语言门控会丢弃主体漂浮、变形或偏离参考的视频。
- 目标被裁剪为 80 帧以满足视频 VAE 的时间约束,并以 16 fps 采样。
几何条件构建:
- 几何条件由四个参考视图重建,而不是直接取自源网格,因此训练和推理的条件信号保持一致。
- 流水线在白色背景上分割主体,用前馈多视角估计器预测每个视角的点图,并通过多视角重建模块将视图融合为 3D 高斯。
- 这些高斯在 25 个均匀间隔的偏航姿态、15 度仰角下渲染,每个渲染深度图被转换为表面法线。
- 视觉语言门控会丢弃偏离参考或破碎的重建结果。
样本结构与使用:
- 每个训练样本包含一个 25 帧法线旋转台条件、一个 80 帧目标视频和四张参考图像。
- 视频语言模型 Tarsier2-7B 分别对法线旋转台和目标视频进行描述。
- 法线段和目标视频段分别编码,然后在潜在空间中沿时间轴拼接;每张参考图像独立编码。
- 条件段和视频段分别配有显式的 [CONDITION] 和 [VIDEO] 标记。
- 文本未说明训练/验证划分或各源网格之间的混合比例。
方法
作者提出一种方法,从少量参考视图生成相机可控的主体视频,同时保持其 3D 结构和外观。给定一组参考视图 R={Ii}i=1N(其中 N=4),系统在 3D 中重建主体,并将几何渲染为表面法线图的旋转序列。这些法线图与参考图像一起提供给预训练视频扩散模型,以生成目标视频。
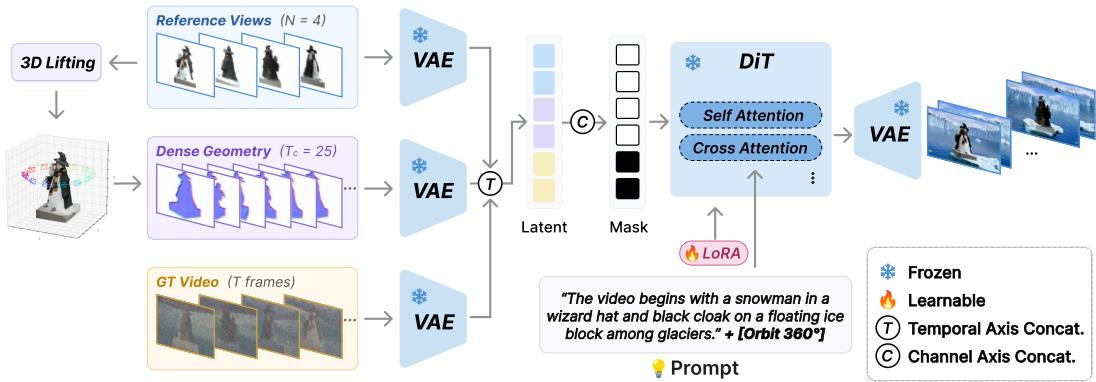
骨干架构基于预训练的图像到视频扩散 Transformer,并通过低秩自适应调优进行适配,保持基础权重冻结。模型在因果视频 VAE 的潜在空间中运行,并使用整流流目标进行训练。为确保训练数据满足主体身份保持、几何一致的视角变化以及显式几何条件,作者设计了自动化的 3D 一致数据合成流水线。与标准相机可控生成器从先验合成不可见表面、往往导致形状变化或主体重复不同,所提出的方法从 3D 资产渲染主体,仅生成背景。
数据合成流水线构建目标视频和几何条件。从 3D 网格出发,系统以 90∘ 偏航间隔渲染一个 81 帧目标视频和 N=4 个参考视图。为消除干净背景渲染带来的域差距,使用视频修复模型将主体合成到提示驱动的场景中,同时视觉语言门控丢弃主体变形或偏离参考的视频。关键是,几何条件由四个参考视图重建,而不是直接使用源网格,从而确保推断时条件信号匹配。系统对主体进行分割,预测对齐的逐视角点图,并将其融合为 3D 高斯。这些高斯沿偏航轨道渲染,生成 25 帧法线旋转台 {Nt}t=1Tc。
对于几何感知条件,序列沿时间轴将 N=4 张参考图像、Tc=25 帧法线旋转台和目标视频帧拼接。参考图像独立编码,而法线图构成一个时间序列,用视频 VAE 编码。拼接后的潜在序列定义为:
z=[zR;zN;zV]∈RL×C×h×w,L=N+Tn+Tv分别编码 25 帧法线条件和 80 帧目标后得到 Tn=7 和 Tv=20 个潜在帧,因此序列长度为 L=31。二进制掩码 m∈{0,1}L 将前 N+Tn 个位置标记为给定。Transformer 输入沿通道轴堆叠三个流:
zτ=m⊙z+(1−m)⊙(τz+(1−τ)ϵ),ϵ∼N(0,I) xτ=Concatchannel(zτ,M,m⊙z)这确保了参考和法线潜在变量保持干净,而仅目标视频潜在变量与噪声进行插值。法线序列和目标序列之间不强制逐帧对应,使旋转台能够作为与轨迹无关的几何线索。
在训练期间,作者仅使用整流流目标优化 LoRA 参数 θ。设 c 表示文本条件,Fθν 表示 Transformer 输出的目标视频段。在骨干流约定下,目标速度为 zν−ϵν。损失按以下方式最小化:
L=E[Dv1∥uθν−(zν−ϵν)∥22]其中 Dv 是 zν 中标量元素的数量,平方误差仅对目标视频潜在元素求平均。在推理时,系统从新主体的参考视图重建几何,渲染偏航轨道以得到表面法线旋转台,并以此条件生成器产生目标潜在变量。法线条件潜在变量和生成的目标潜在变量被拼接,并由因果 VAE 联合解码以生成最终视频帧。
实验
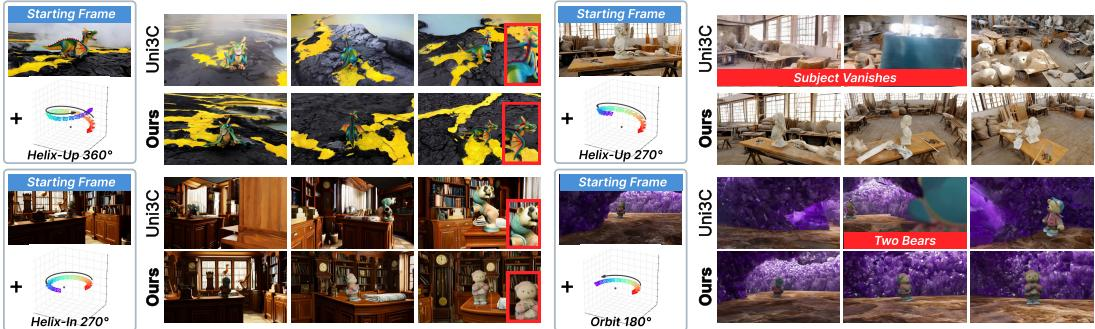
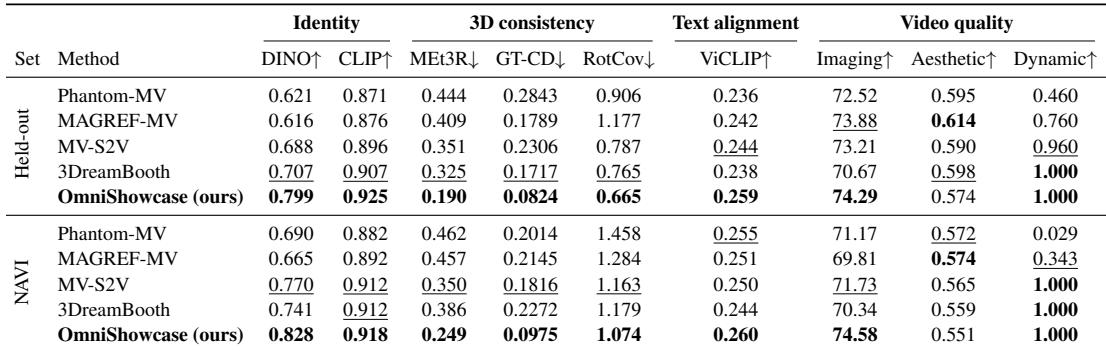
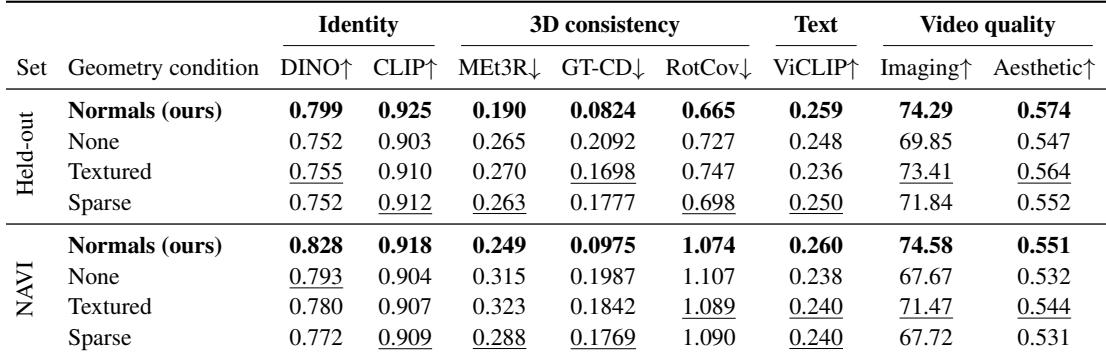
评估使用留出的 SHOWCASEBENCH 和 NAVI 基准,在身份、3D 一致性、文本对齐和视频质量指标上比较多视角主体到视频生成与 Phantom-MV、MAGREF-MV、MV-S2V 和 3DreamBooth。定性和定量结果表明,基线方法难以保持相机轨迹、身份和 3D 一致性,而 OmniShowcase 取得了最佳身份和几何得分,并具有竞争力的文本和视频质量。消融实验确认几何条件至关重要,因为移除它或将其替换为纹理渲染会削弱身份和 3D 一致性,而减少旋转台帧数会损害覆盖范围和重建可靠性。
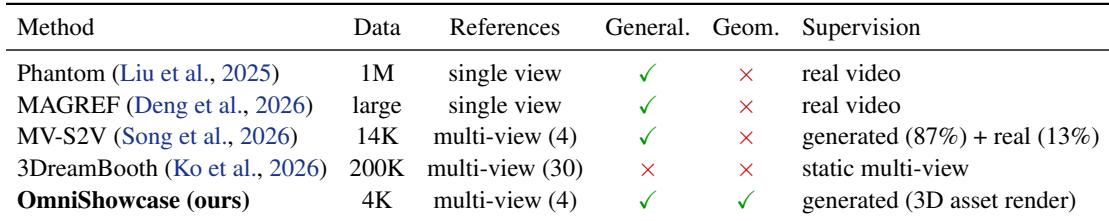
OmniShowcase 是所比较的主体到视频方法中唯一将无需推理时优化的泛化能力与显式几何条件相结合的方法。它使用渲染的 3D 资产监督和多视角参考,而先前方法依赖真实视频、生成视频或静态多视角图像,并且缺乏几何条件。该方法的训练数据量也远少于先前的多视角基线。OmniShowcase 是所列方法中唯一同时具备无需推理时优化的泛化能力和显式几何条件的方法。其训练信号来自渲染的 3D 资产,不同于其他在真实视频、生成视频或静态多视角捕获上训练的方法。它使用的训练样本和参考视图数量都少于静态多视角基线,同时仍保持泛化能力。
OmniShowcase 在所比较方法中实现了最强的主体身份保持和 3D 一致性,在两个报告的基准上均取得最佳 DINO、CLIP、MEt3R 和 GT-CD 结果。Phantom-MV 和 MAGREF-MV 在身份和相机轨迹覆盖方面落后,而 MV-S2V 和 3DreamBooth 在不同维度上各有优势。OmniShowcase 即使未领先,也能保持文本对齐和视频质量的竞争力。OmniShowcase 在留出基准上记录了最高的 DINO 和 CLIP 身份分数,以及最低的 MEt3R 和 GT-CD 误差。Phantom-MV 和 MAGREF-MV 与较强基线相比,主体身份保持较弱,RotCoverage 更差,这与它们几乎不围绕主体旋转的定性观察一致。MV-S2V 和 3DreamBooth 各自在不同指标上领先,没有基线在所有维度上都是最强。OmniShowcase 在改善身份和 3D 一致性的同时,保持了具有竞争力的 ViCLIP 文本对齐和视频质量。
完整的表面法线几何条件在两个评估集上在身份、3D 一致性、几何精度和视角覆盖方面领先。移除几何、将法线替换为纹理渲染或减少旋转台帧数都会降低身份和几何质量;在留出集上,纹理几何在消融中得到最低几何误差,而稀疏视角得到最佳视角覆盖,在 NAVI 集上,移除几何得到最高几何误差。完整的表面法线条件在两个评估集上的身份和 3D 一致性指标上均优于消融变体。消融显示出不同的权衡:移除几何对身份和几何精度损害最大,纹理几何在留出集上对文本对齐削弱最大,而稀疏视角相对于完整条件降低了视角覆盖。
第一项比较将 OmniShowcase 确立为唯一一种无需推理时优化即可泛化、同时使用显式几何条件和渲染 3D 资产监督、且训练数据和参考视图均少于先前方法的主体到视频方法。主要基准评估验证了该设计产生最强的主体身份保持和 3D 一致性,并具有竞争力的文本对齐和视频质量,而基线方法表现出较弱的主体环绕或在其他方面各有取舍。消融实验确认,移除或改变完整的表面法线几何条件,包括将法线替换为纹理渲染或减少旋转台帧数,通常会降低身份、几何精度和视角覆盖,尽管每个消融显示出略有不同的权衡。