Command Palette
Search for a command to run...
DTCA:用于扩散语言模型强化学习的去噪 Token 信用分配
DTCA:用于扩散语言模型强化学习的去噪 Token 信用分配
Hongze Chen Miao Pan Lizhou Liang Qinfeng Li Xinyin Ma Yongliang Shen Weishi Wang Daniel Dahlmeier Xuhong Zhang Wenqi Zhang
摘要
扩散语言模型(DLM)通过迭代去噪生成文本,从而实现双向上下文建模和并行 token 细化。近期研究已将强化学习(RL)应用于 DLM,并改善了其推理性能。然而,迭代去噪过程使信用分配更具挑战性,因为最终结果奖励仅能提供关于不同 token 如何对最终输出做出贡献的有限信息。本文提出了去噪 Token 信用分配(DTCA),一个用于扩散语言模型强化学习的 token 级信用分配框架。DTCA 通过测量 token 被确定后剩余掩码位置预测置信度的提升来估计 token 贡献,并根据词性(POS)类别对这些信号进行分组。这些贡献权重被用于选择具有信息量的去噪时间步,并在 RL 训练期间分配 token 级学习信号。DTCA 进一步根据策略更新引起的 token 级熵变化来校准这些学习信号。在 LLaDA-8B-Instruct 上的实验表明,DTCA 在不同生成预算下均能一致提升数学推理性能,相比基础模型在 MATH500 上最多提升 9.0 分,在 GSM8K 上最多提升 5.3 分。
一句话总结
浙江大学、新加坡国立大学和 SAP 提出 Denoising Token Credit Assignment(DTCA),这是一种面向扩散语言模型强化学习的 token 级信用分配框架。该框架通过 token 承诺后的置信度增益和词性(POS)分组来加权 token 贡献,通过 token 级熵变化校准学习信号,并在 MATH500 和 GSM8K 上相对基础模型将 LLaDA-8B-Instruct 的数学推理能力分别提升最多 9.0 分和 5.3 分。
核心贡献
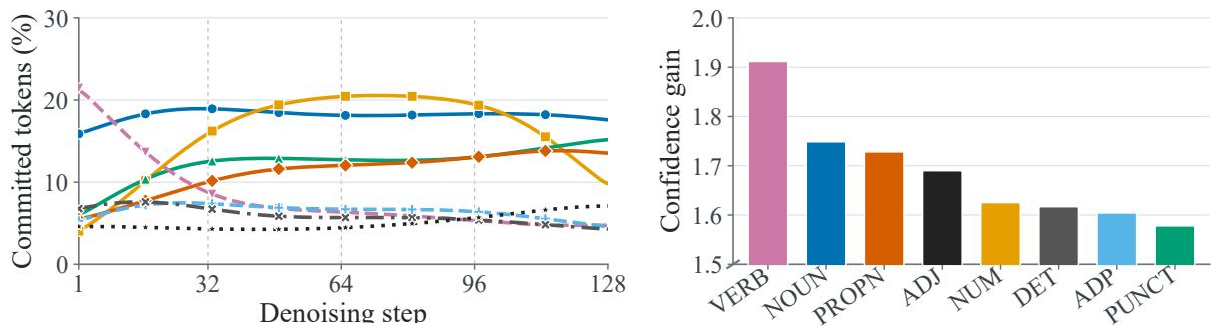
- 论文分析了扩散语言模型中不同词性(POS)类别的去噪行为,并提出 Denoising Token Credit Assignment(DTCA),这是一种面向强化学习的 token 级信用分配框架。DTCA 从 token 承诺后其余被掩码位置的预测置信度提升中估计 token 贡献,并按 POS 类别聚合这些信号。
- DTCA 使用得到的贡献权重来选择有信息量的去噪时间步,并分配 token 级学习信号。该方法还将 OPEFO 中的基于熵的信用校准适配到扩散语言模型场景,以实现更稳定的策略更新。
- 在 LLaDA-8B-Instruct 上的实验表明,在不同生成预算下数学推理能力持续提升,在 MATH500 上相对基础模型最多提升 9.0 分,在 GSM8K 上最多提升 5.3 分。消融实验验证了基于贡献的信用分配和熵校准组件的作用。
引言
扩散语言模型(DLM)已成为自回归生成的一种替代方案,因为它们支持双向上下文建模和并行 token 细化。近期针对 DLM 的强化学习方法通常从去噪轨迹或中间状态中获取学习信号,但这种粗粒度视角不够充分,因为 token 是逐步提交的,每个已提交 token 都可能影响其余被掩码位置的细化方式。估计细粒度 token 贡献具有挑战性,因为多个 token 会在同一步去噪中被提交,它们的影响通过共享去噪过程相互作用,并且贡献估计在不同 rollout 之间可能差异很大。作者提出 Denoising Token Credit Assignment(DTCA),该方法从其余被掩码位置的置信度提升中估计 token 贡献,按词性类别聚合这些信号以获得更稳定的权重,使用这些权重进行去噪时间步选择和 token 级 RL 信号分配,并引入受 OPEFO 启发的基于熵的信用校准。在 LLaDA-8B-Instruct 上的实验表明,DTCA 在 MATH500 上相对基础模型最多提升 9.0 个百分点,在 GSM8K 上最多提升 5.3 个百分点。
方法
作者提出 Denoising Token Credit Assignment(DTCA),这是一个面向扩散语言模型强化学习的 token 信用分配框架。DTCA 从去噪细化动态中估计 token 贡献,并利用得到的贡献权重进行有信息量的去噪状态选择和 token 级信用分配。此外,该框架根据策略更新引起的熵变化校准 token 级学习信号。
如下图所示,整体流程包括贡献估计、时间步选择、信用分配和熵校准。
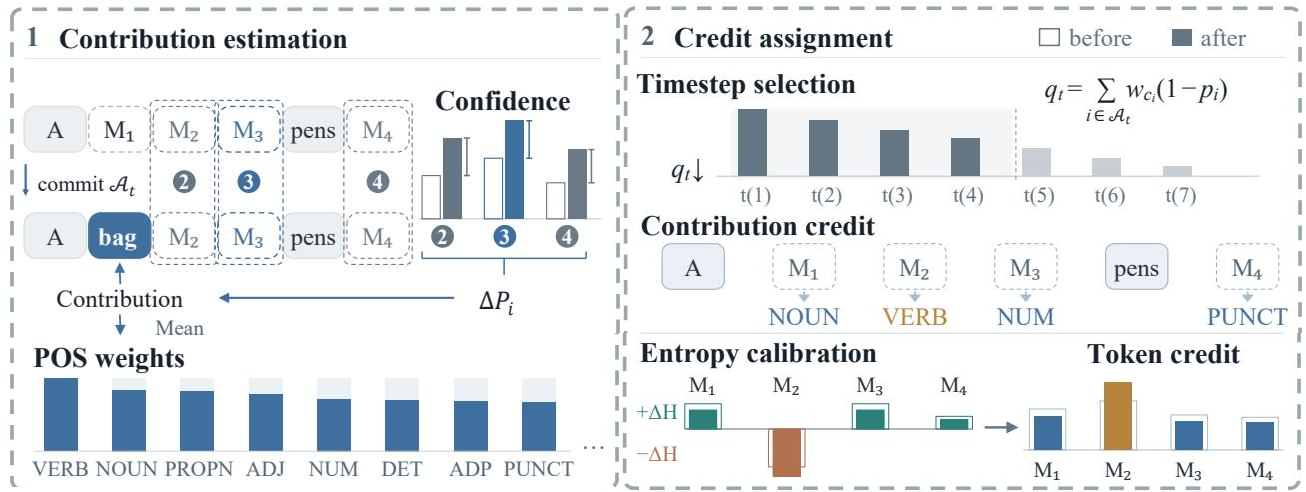
为了评估每个已提交 token 的细化贡献,DTCA 测量其余被掩码位置预测置信度的提升。给定固定提示和去噪状态,其余被掩码位置上的聚合预测置信度定义为最大预测概率之和:
F(x;M)=j∈M∑v∈Vmaxpθ,j(v∣q,x)其中 j 索引被掩码位置,V 是词表,pθ,j(v∣q,x) 是位置 j 上 token v 被分配的概率。已提交 token 的细化贡献估计计算如下:
ΔPi=max(0,F(xt(i);M)−F(xt;M))为了避免在策略优化期间评估单个 token 效果带来的大量计算开销,DTCA 从离线去噪 rollout 中构造这些估计。随后按词性类别聚合这些估计以降低方差。类别 c 的平均细化效果计算如下:
mc=Nc1i:ci=c∑ΔPi这些类别贡献被归一化为有界贡献权重 wc,范围在 [0.8,1.2] 内,以防止过度的信用缩放,同时保留原始强化学习目标。
类别贡献权重用于识别训练中最有信息量的去噪时间步。对于给定时间步,重要性分数通过将贡献权重与已提交 token 的不确定性结合来计算:
qt=i∈At∑wci(1−pi)其中 pi 表示 token 提交时的置信度。DTCA 根据该分数对时间步排序,并选择累计分数达到总分数预定义比例的最小时间步集合,以确保稳定高效的训练。
在选定的时间步内,DTCA 根据 token 的词性类别为其分配不同的信用。特定 token 的信用权重通过将其类别贡献权重相对优化集中所有 token 的平均权重进行归一化来确定:
at,i=∣Bt∣1∑k∈Btwckwci该归一化确保每个时间步内的平均信用保持为 1。最终 token 级学习信号通过缩放原始时间步优势得到:
At,i=at,iAt因此,来自估计细化贡献较高类别的 token 会收到更强的学习信号。
为了考虑不同去噪状态之间熵变化的差异,DTCA 引入基于熵的信用校准模块。目标位置由策略更新引起的熵变化估计如下:
ΔHt,i(b)=−ηAt,i(b)(1−pi(b))2(logpi(b)+Hi(b))其中 pi(b) 是当前策略分配的概率,Hi(b) 是完整预测分布的熵。更新被分为熵增集合和熵减集合。为每个响应计算单独的熵流平衡系数 λb,以平衡这些更新。该系数随后用于重新缩放 token 级学习信号,根据熵变化方向放大或削弱信用,从而细化强化学习优化过程。
实验
实验通过从 LLaDA-8B-Instruct 在 MATH 上初始化 RL 训练,并在不同生成预算下于 MATH500 和 GSM8K 上测试来评估 DTCA,对比对象包括监督式基线和扩散语言模型 RL 基线。DTCA 持续优于基础模型,尤其是在有限的去噪预算下,消融实验表明基于贡献的信用分配和熵校准都有助于性能提升。进一步分析表明,贡献信用塑造了 token 级更新质量,而熵校准稳定了后期策略优化,并且学习到的去噪行为以类别特定而非均匀的方式改变了 token 承诺模式。
在所有评估的生成预算下,DTCA 在 MATH500 和 GSM8K 上均优于 LLaDA-8B-Instruct 基础模型。提升在最小预算下最大,并随着预算增加保持为正。消融基于贡献的信用分配或熵校准都会降低准确率,表明这两个组件都对 DTCA 性能有贡献。DTCA 在每个评估基准和预算设置中都报告了最高准确率。相对基础模型,DTCA 的提升在预算 128 时最强,在预算 256 和 512 时有所下降但仍保持为正。移除贡献信用或熵校准会持续降低准确率,其中移除熵校准在预算 512 时于两个基准上都出现更大下降。
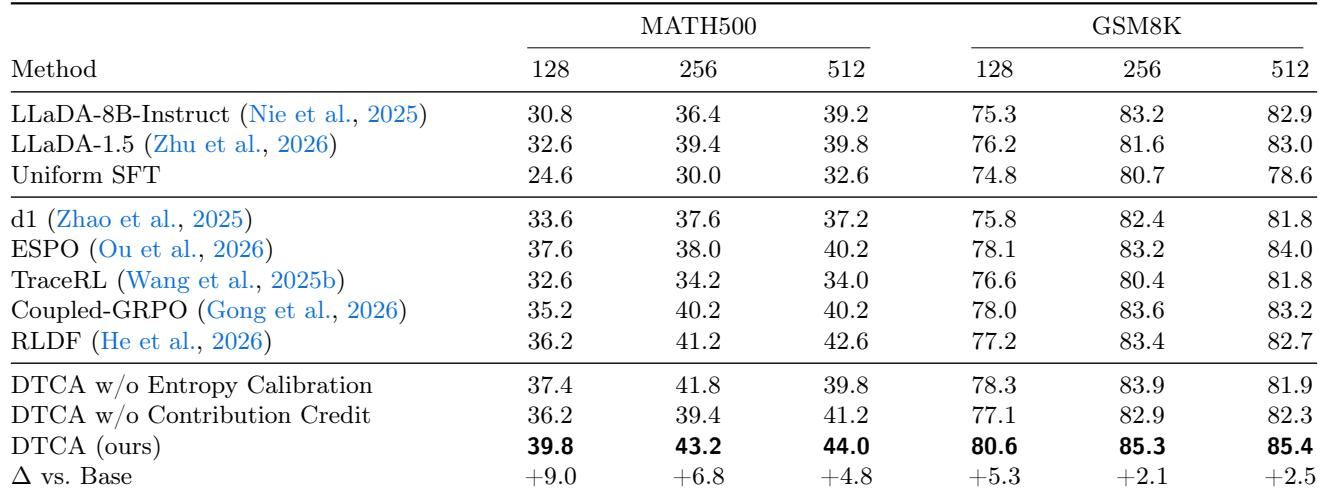
DTCA 在多个生成预算下与 LLaDA-8B-Instruct 基础模型在 MATH500 和 GSM8K 上进行了比较,并在每个设置中都提高了准确率,最大提升出现在最小预算下,在较大预算下提升较小但仍为正。消融研究表明,移除基于贡献的信用分配或熵校准都会降低性能,并且移除熵校准在预算 512 时导致更大下降,表明这两个组件都很重要。总体而言,结果验证了 DTCA 持续优于基础模型,并且其信用分配和校准机制都对准确率有贡献。