Command Palette
Search for a command to run...
StreamVibe:面向动态用户意图的主动式视频智能体
StreamVibe:面向动态用户意图的主动式视频智能体
摘要
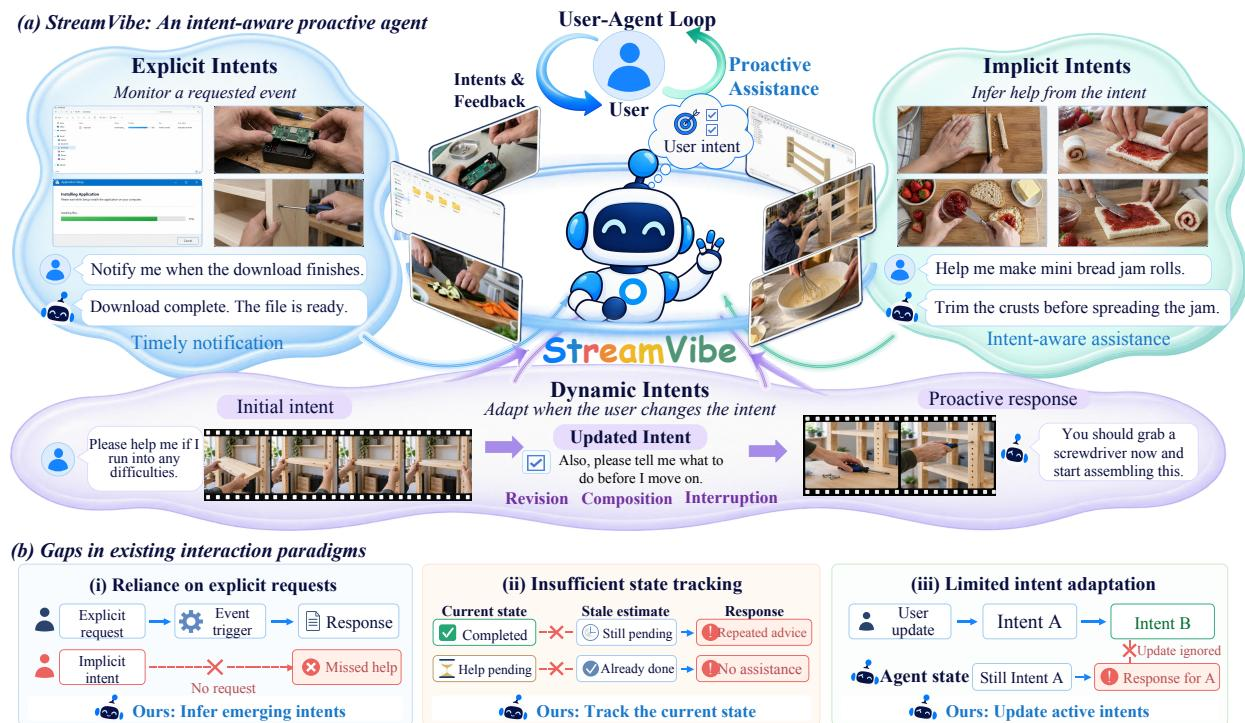
视觉-语言模型正从离线被动理解转向在线主动交互。然而,现有方法大多依赖显式请求,忽略了隐式用户意图(例如,用户浏览网站时的“我接下来该点击哪里?”),并且未能随用户请求可能持续变化而同步更新状态。这些局限使它们在实际中不太适用于意图感知交互。为应对这些挑战,我们提出 StreamVibe-Bench,一个作为用户意图交互测试平台的新基准,包含 4.1K 个评估样本和 85K 个训练样本,覆盖显式、隐式和动态意图。在该基准基础上,我们开发了 StreamVibe-VL,一种流式主动模型,能够从连续观察中推断隐式用户意图,并随这些意图演变动态调整其交互。我们还提出 StreamVibe-Harness,通过分层记忆将用户意图维护为具有灵活生命周期的持久状态,以跟踪最新的用户意图和环境状态。实验揭示了三项关键发现:(i) StreamVibe-VL 在保持较强通用视频理解能力的同时,将响应时机和回答质量较其他基线提升了 10.7%;(ii) 现有主动模型在理解用户意图和决定何时响应方面仍然有限,尤其是在隐式和动态意图下;(iii) StreamVibe-Harness 进一步提升了持续交互中的响应一致性与适应性,使主动交互增益达到 12.3%。
一句话总结
来自 Google、UCSB、UCSC 等机构的研究者提出了 StreamVibe-Bench、StreamVibe-VL 和 StreamVibe-Harness,它们利用持续观察和分层记忆来推断隐式与动态的用户意图,定制主动交互,并将响应时机和回答质量提升 10.7%,将主动交互提升 12.3%。
核心贡献
- 本文提出了 StreamVibe-Bench,一个统一的主动流式用户意图交互基准,包含 4.1K 评估样本和 85K 训练样本,覆盖显式、隐式和动态意图,并提供点级和轨迹级评估。
- 本文介绍了 StreamVibe-VL,一种流式主动视频模型,通过自适应流式 SFT 和局部轨迹 RL 训练,以在隐式且不断演化的用户意图下联合学习何时以及如何提供帮助;实验显示,在保持通用视频理解的同时,响应时机和回答质量提升了 10.7%。
- 本文还开发了 StreamVibe-Harness,它将用户意图和任务进度维护为具有灵活生命周期和分层记忆检索的持久可更新状态,使主动交互提升 12.3%,并在持续交互中产生更一致、更具适应性的响应。
引言
视觉语言模型正从离线理解转向流式环境中的持续主动辅助,在这种环境中,agent 不仅要决定说什么,还要决定何时提供帮助。此前的主动交互方法主要处理显式的单轮请求,在开放式场景中表现困难:它们无法推断隐式用户意图,无法在环境变化时跟踪任务相关状态,也无法更新通过反馈演化的意图。作者通过引入 StreamVibe-Bench 来解决这些不足,该基准包含显式、隐式和动态意图;StreamVibe-VL 是一种通过流式监督微调和局部轨迹强化学习训练的流式主动模型;StreamVibe-Harness 则维护持久、可更新的意图状态,并通过分层记忆实现一致的长时程辅助。
数据集
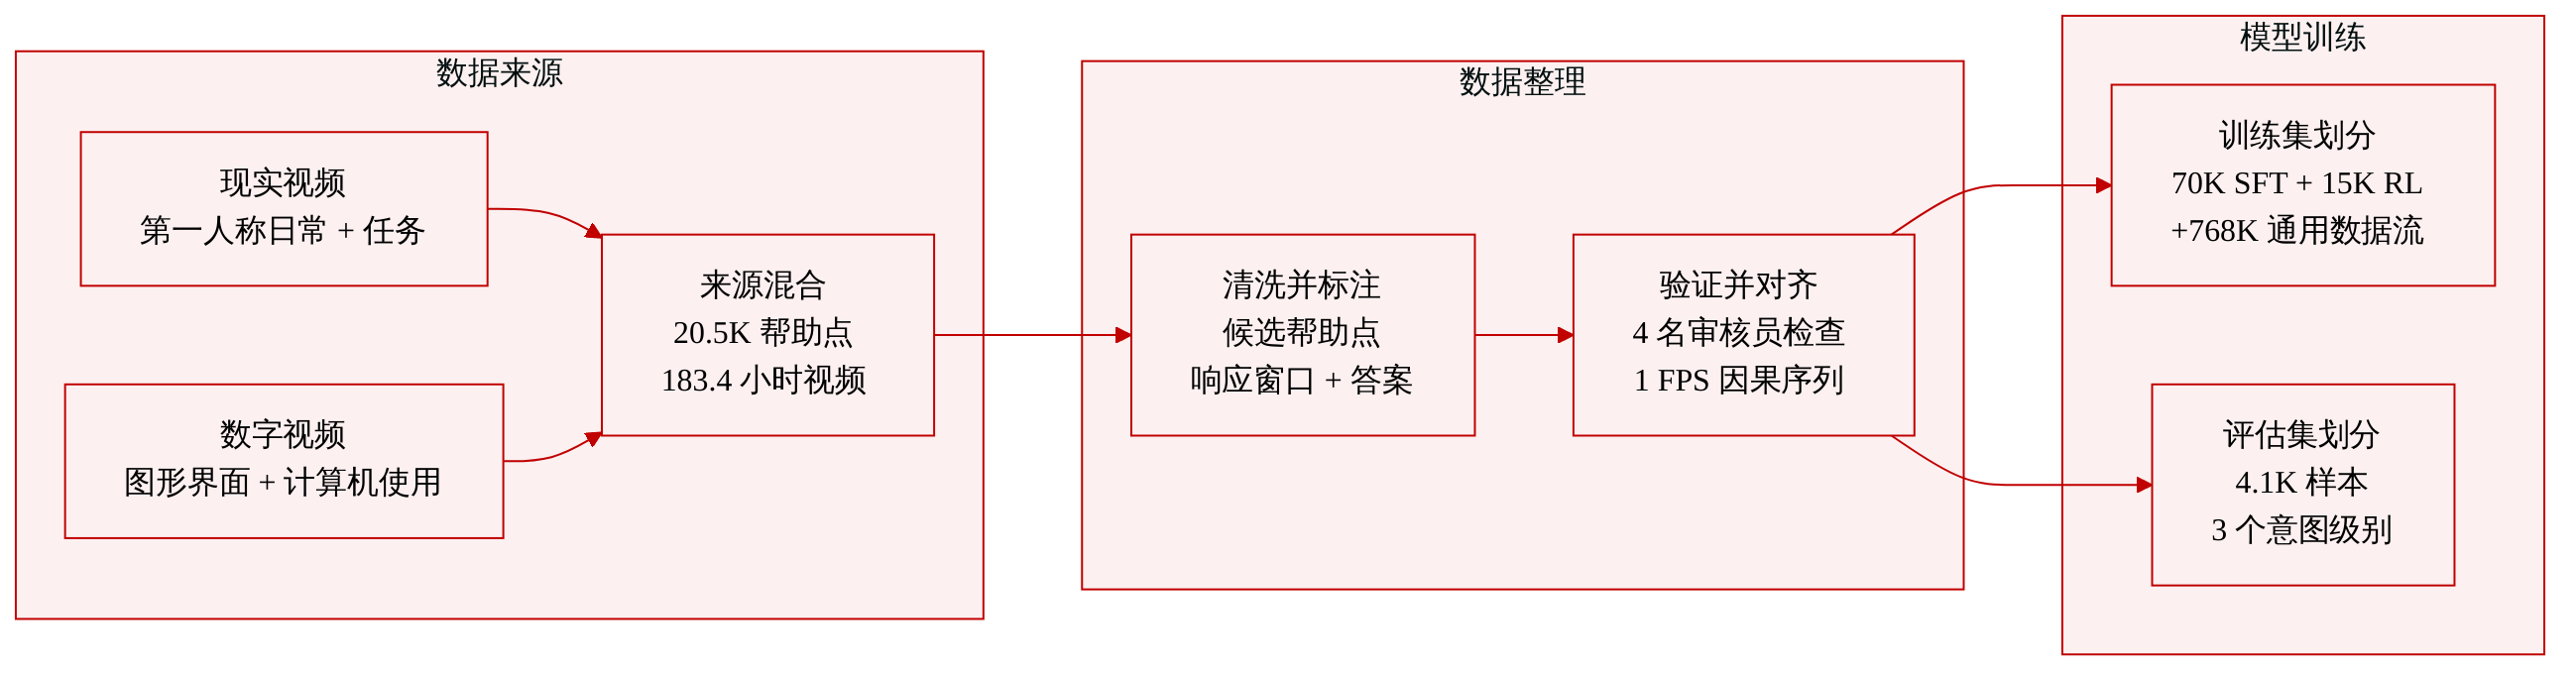
数据集部分描述了 StreamVibe-Bench 及其相关训练数据。
-
来源与构成
- 视频收集自物理环境和数字环境。
- 物理任务包括以自我为中心的日常活动和任务执行。
- 数字任务侧重于 GUI 和计算机使用场景。
- 该基准包含三个交互层级:显式意图、隐式意图和动态意图。
- 显式意图包括单事件、转换和重复事件。
- 隐式意图包括指导、学习、监控和工具。
- 动态意图包括修订、组合和中断。
- 评估集包含 4,100 个样本:600 个显式意图、2,000 个隐式意图和 1,500 个动态意图。每个类别中的子类型均匀分布。
- 总体而言,StreamVibe-Bench 包含 20,546 个帮助点和 183.4 小时视频。
-
标注与处理
- 对于每个视频请求对,作者使用 Gemini-3.8-Flash 清理数据,并识别带有响应窗口、偏好时间和参考答案的候选帮助点。
- 动态意图被构建为带时间戳的多轮交互,其中意图可能被修订、扩展或中断。
- 四名审核者独立验证用户请求和响应时机。证据不足的样本会被修正或移除,仅保留所有审核者都批准的样本。
- 经验证的标注被对齐到 1 FPS 流,并转换为因果交互序列,用于训练和评估。
-
数据使用方式
- 每个意图可以对应一个或多个证据点,每个证据点都有有效的响应窗口和参考响应。
- agent 只观察过去的视频、过去的用户输入和过去的交互历史,并在无法访问未来视频或用户输入的情况下预测沉默或响应。
- 训练集 StreamVibe-85K 包含 70K 监督微调样本和 15K 强化学习任务。
- 在监督微调期间,作者还纳入了来自 TimeChat-Online 和 VideoChat-Flash 的 768K 通用流式视频样本。
方法
作者提出 StreamVibe 以应对主动交互中的两个主要挑战:证据定位和状态跟踪。证据定位要求策略将活跃意图锚定在新出现的视觉证据中,并确定最佳响应时机和方式。状态跟踪涉及维护一组最新的活跃意图和交互历史,这很难由单独的策略可靠地管理。为了将基于视频的响应决策与持久状态跟踪解耦,作者引入了 StreamVibe-Harness。该模块显式管理交互状态,并为策略提供持续更新的上下文。
如下图所示,整体框架将 Harness 与交互模型及后续训练阶段集成在一起。
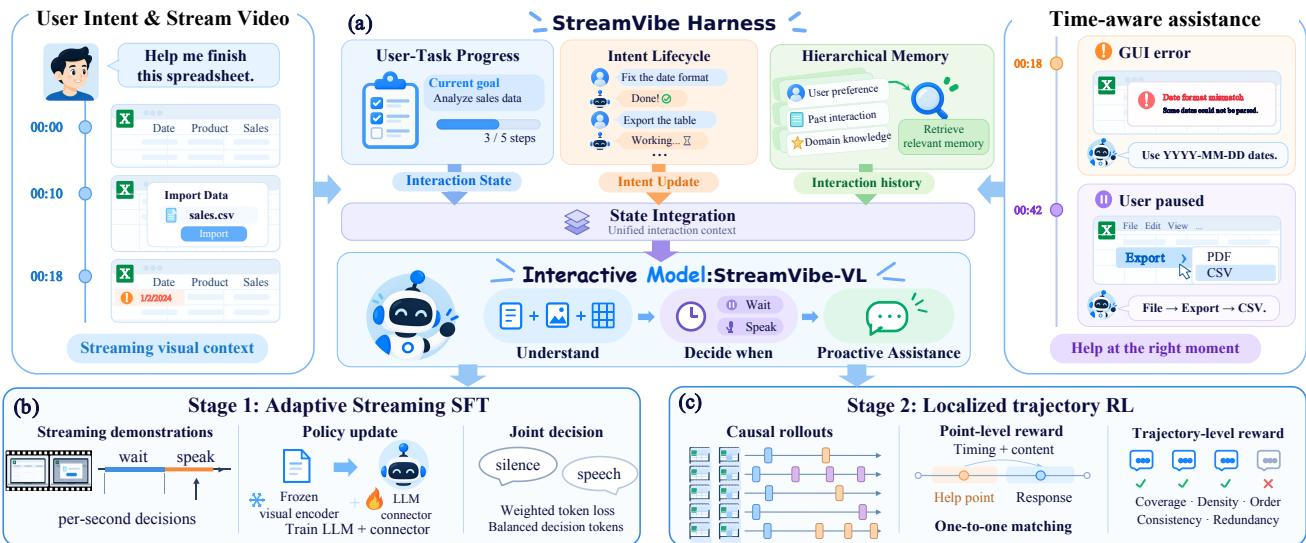
StreamVibe-Harness 维护一个显式交互状态,包括当前活跃意图、任务进度和先前给出的响应。随着新的用户输入和观测到来,系统通过添加、修订或终止意图来增量更新该状态。状态变化严格以充分的感知证据为条件,以防止过早更新。每个意图被管理为独立的有状态实例,允许多个意图同时保持活跃并演化。生命周期跟踪每个意图的状态、相关证据和完成状态,但何时以及如何响应的实际决定仍由 agent 策略作出。
为了管理长期上下文而不持续扩大 agent 输入窗口,Harness 将过去的观测组织为分层记忆。近期信息以细粒度方式保留,而较旧内容被逐步压缩,以保存与任务相关的实体、动作和约束。在每次决策之前,Harness 根据活跃意图和任务状态检索相关历史。随后,它将持久交互状态和检索到的记忆与因果上下文整合,生成统一上下文,并传递给 agent 策略以生成响应。由此产生的交互随后被写回状态和记忆。
为了训练流式视频策略,作者采用了两阶段的证据定位策略学习过程。
在第一阶段,即自适应流式监督微调(SFT)中,作者引入自适应流式监督,以平衡不同训练来源中沉默与响应比例的变化。该方法根据当前训练分布调整决策 token 的权重,同时单独优化响应生成,从而减少对过度沉默或过度响应的偏置。SFT 目标被表述为:
LSFT=−∣Y∣1j∈Y∑ωjlogπθ(zj∣ct(j),z<j)其中 Y 表示有监督的助手 token。权重 ωj 对决策 token 设为 γB,c(j),对响应 token 设为 λtext。自适应权重 γB,c(j) 遵循当前训练分布,而 λtext 保持响应生成的学习。
在第二阶段,即局部轨迹强化学习(RL)中,作者在 SFT 模型基础上,围绕标注的帮助点构造短因果 rollout,并使用 GRPO 对它们进行优化。避免全轨迹优化,以防止信用分配分散和奖励干扰。RL 阶段使用两种互补奖励。首先,点级奖励评估证据点与预测响应之间的对齐程度。时间偏移定义了一个时序分数,该分数乘以一个由 LLM 判断的内容质量分数。一对一匹配得到一组匹配对,对齐奖励计算为:
Ralign=Npred+αNgt(1+α)∑(g,p)∈Mτ(Δg,p)ρ(g,p)其中 Npred 和 Ngt 分别是预测响应和证据点的数量,α 控制漏掉证据与过度响应之间的权衡。其次,轨迹级奖励将 rollout 作为整体进行评估,以确保整体一致性和自然性,抑制冗余或冲突的响应。最终奖励将两个目标结合为 R=λRalign+(1−λ)Rglob,其中 λ=0.7,以优先考虑响应时机和内容质量,同时保持轨迹连贯性。
实验
评估使用 StreamVibe-Bench,这是一个主动流式基准,覆盖物理和数字视频中的显式、隐式和动态意图,并采用点级和轨迹协议来衡量响应时机和质量。StreamVibe-VL 优于开源基线,强化学习进一步改善了动态意图处理,同时保持通用视频理解。分析表明,现有主动 agent 在未说明或变化的意图、响应选择性不足以及持续交互中稳定性下降方面存在困难。策略学习改善了局部主动决策,而状态跟踪 harness 减少了不必要的响应,并提高了内容一致性,尤其是对于动态意图。
StreamVibe-Bench 被提出为一个更完整的主动交互基准,覆盖物理和数字环境中的显式、隐式和动态意图,并支持点级和轨迹评估。现有基准在持续时间、证据量和覆盖范围上差异很大,没有哪个基准能匹配这一综合范围。所引用的实验还表明,隐式和动态意图仍然更难,持续交互会放大时机和一致性错误,而策略学习加状态跟踪可以改善主动决策和长时程稳定性。现有的主动交互基准只支持意图类型、环境和评估设置的部分组合,而 StreamVibe-Bench 以点级和轨迹评估覆盖物理和数字环境中的显式、隐式和动态意图。隐式和动态意图比显式意图更难,当前 agent 难以在召回率和误触发之间取得平衡,这些问题在更长的交互中变得更加明显。策略学习改善了局部主动决策的选择性,而状态跟踪有助于维护有效意图和任务进度,减少持续交互中的冗余或与状态不一致的输出。
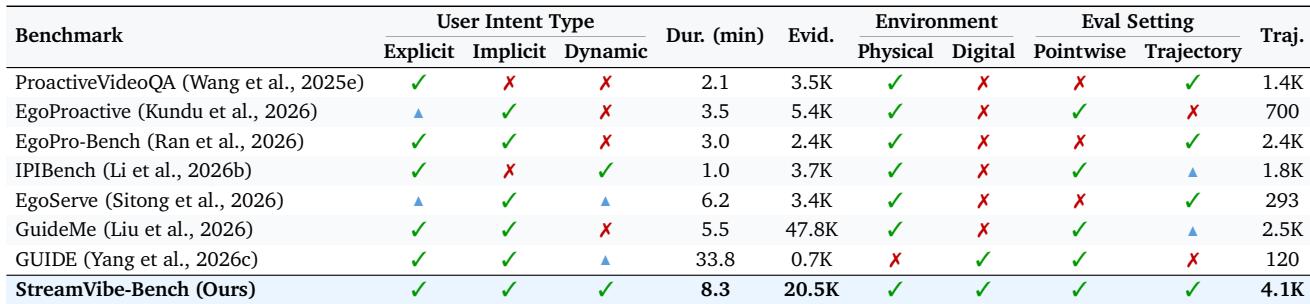
StreamVibe-VL 在 StreamVibe-Bench 上持续优于开源基线,在点级评估下取得最高的 Content F1,同时在响应质量上与专有模型保持竞争力。强化学习在 SFT 基础上进一步改善,在动态意图上增益更大,并且这一优势在使用自生成历史的轨迹评估下仍然保持。分析还表明,隐式和动态意图、响应选择性以及长时程交互稳定性对当前主动 agent 而言仍然具有挑战性。StreamVibe-VL 优于开源基线,并取得最佳的点级 Content F1。强化学习在 SFT 基础上有所改善,尤其是在动态意图上,并提高了轨迹评估的 Content F1 和响应质量。隐式和动态意图比显式意图更难,较高的召回率往往带来更多不必要的触发。策略学习减少了误触发并改善了决策选择性,而状态跟踪进一步抑制不必要的响应并支持长时程稳定性。
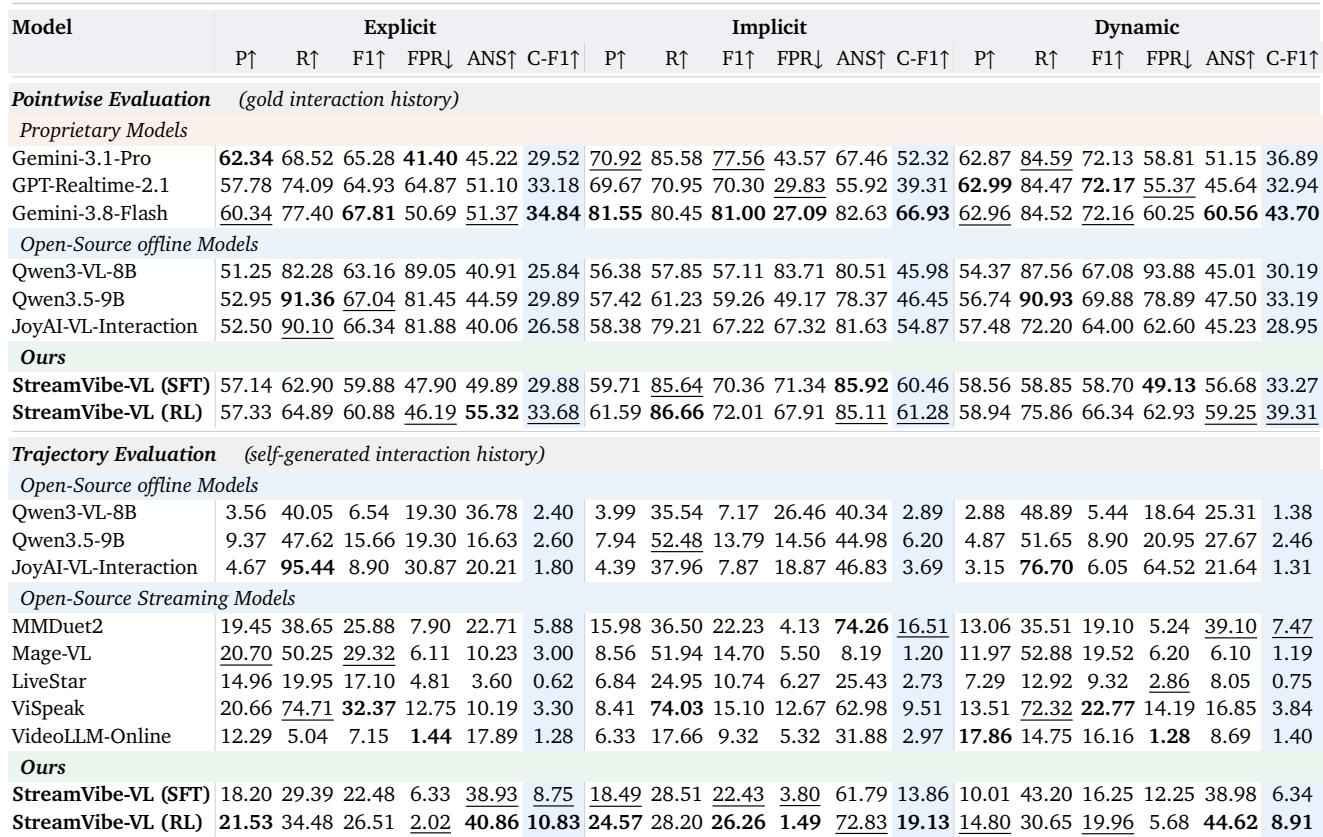
这些实验使用 StreamVibe-Bench 评估主动交互,该基准覆盖物理和数字环境中的显式、隐式和动态意图,并提供点级和轨迹评估。StreamVibe-VL 优于开源基线并取得最佳的点级 Content F1,而强化学习在监督微调基础上进一步改善,尤其是在动态意图和轨迹设置下。结果表明,隐式和动态意图以及长时程稳定性仍然困难,因为 agent 难以在召回率和误触发之间取得平衡。策略学习改善了局部决策选择性,状态跟踪有助于维护有效意图和任务进度,减少冗余或与状态不一致的输出。