Command Palette
Search for a command to run...
DynaFlow:学习自由形式的多智能体编排
DynaFlow:学习自由形式的多智能体编排
Ruhao Liu Qi Li Shizun Wang Xinchao Wang
摘要
多智能体系统通常依赖预定义的协作结构,这限制了它们适应多样化任务需求的能力。我们提出了 DynaFlow,一个将自由形式的可执行工作流合成集成到主智能体动作空间中的框架。该智能体决定何时需要协作,并生成针对特定任务的程序,通过顺序或并行执行、结构化信息交换与验证来协调子智能体。执行结果与轨迹会为后续动作提供依据,使智能体能够随着推理推进而调整协作方式。我们仅对主智能体进行训练:首先在蒸馏得到的轨迹上进行监督微调,随后在针对无依据前提、有偏验证和信息流缺陷筛选出的示例上进一步优化。所有子智能体保持固定,从而将编排学习与执行器能力提升分离开来。在涵盖数学推理、科学问答和多跳检索的六个基准上,DynaFlow 在 Forced 模式下取得了 88.08% 的整体准确率,在相同 Qwen3.5-27B 骨干模型下比最强评估基线高出 10.90 个百分点。工作流分析发现,训练后对上游输出的显式利用、验证和精炼更加明显,突出表明跨阶段信息流是多智能体编排的一个关键维度。
一句话总结
新加坡国立大学的研究人员引入 DynaFlow,一个将自由形式的可执行工作流合成集成到主 agent 动作空间中的框架,使 agent 生成任务特定的程序,通过顺序或并行执行、结构化信息交换和验证来协调固定的子 agent;DynaFlow 通过在蒸馏轨迹上进行监督微调,并在筛选出的无依据前提、有偏验证和信息流缺陷示例上进一步细化训练,在六个涵盖数学推理、科学问答和多跳检索的基准上,Forced 模式下达到 88.08% 的总体准确率,使用相同的 Qwen3.5-27B 基座模型,比最强评估基线高出 10.90 个百分点。
核心贡献
- DynaFlow 将自由形式的可执行工作流合成集成到主 agent 的动作空间,使其能够决定何时需要协作,并生成任务特定的程序,通过顺序或并行执行、结构化信息交换和验证来协调子 agent。
- 主 agent 通过在蒸馏轨迹上进行监督微调训练,然后在筛选出的无依据前提、有偏验证和信息流缺陷示例上进行细化,使编排质量成为明确的筛选标准,同时保持所有子 agent 固定。
- 在六个涵盖数学推理、科学问答和多跳检索的基准上,DynaFlow 在 Forced 模式下达到 88.08% 的总体准确率,使用相同 Qwen3.5-27B 基座模型时比最强评估基线高出 10.90 个百分点;Dynamic 模式还在不调用工作流的情况下回答 47.1% 的问题,同时保持接近 Forced 执行的准确率,工作流分析显示训练后对上游输出有更显式的使用、验证和细化。
引言
基于大型语言模型的多 agent 系统通常依赖固定的协作结构,但不同任务的协调需求各不相同,固定结构可能带来不必要的通信、延迟和计算。此前的自动化工作流方法缓解了部分刚性,但 DyFlow 从有限的算子模板集合中构建计划,MAS-Orchestra 则在单次决策中生成完整协调结构,而不观察中间执行结果。作者引入 DynaFlow,将可执行工作流合成视为主任务求解 agent 的原生动作。主 agent 可以直接回答、使用普通工具,或者生成任务特定的工作流程序,在代码中定义子 agent 角色、依赖关系和输出处理;受预算约束的运行时返回输出和执行轨迹,为后续编排决策提供信息。该训练框架仅更新主 agent,基于蒸馏演示进行训练,并按编排质量进行筛选,同时保持子 agent 固定。在六个基准上,DynaFlow 报告 Forced 模式下 88.08% 的总体准确率,比使用相同基座模型的最强评估基线高出 10.90 个百分点。
方法
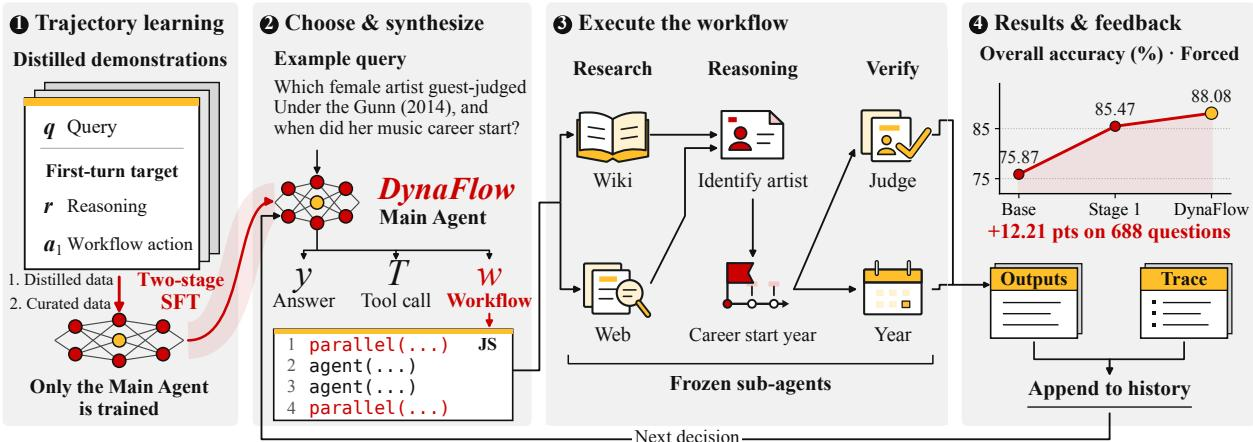
作者引入 DynaFlow,一个将自由形式的可执行工作流合成直接集成到主 Agent 动作空间的框架。该设计使 agent 能够动态决定何时以及如何与固定的子 agent 协作,而不是依赖刚性的预设结构。如下图所示,系统通过持续反馈回路运行,主 Agent 在其中编排任务、执行工作流,并使用执行轨迹来指导后续决策。
给定问题 q 和任务指令 I,主 Agent 遵循统一动作空间上的策略 πθ,该动作空间定义为:
A=Atool∪{Aans,(P,W(P))}其中,Atool 表示普通工具调用动作,Aans 表示最终答案输出动作,(P,W(P)) 构成单个工作流动作。该工作流动作既包括主 Agent 合成的 JavaScript 程序 P,也包括通过工作流工具 W 对其进行的调用。在每一轮 k,agent 生成动作 ak∼πθ(⋅∣I,q,hk−1),其中 hk−1 是先前动作和观察的有序历史。
合成的程序 P 明确定义子 agent 角色、执行阶段和依赖关系,使无依赖的调用能够并发运行,并使有依赖的调用能够接收上游输出。一旦被调用,工作流工具会在资源约束下使用冻结的子 agent 执行 P。它返回观察 ok=W(P),将程序输出与执行轨迹相结合,详细说明每次子 agent 调用的状态和结果。主 Agent 将 (ak,ok) 追加到其历史中,并决定是输出最终答案、调用另一个工具,还是合成后续工作流以细化结果。
为了训练编排策略 πθ,作者采用两阶段监督微调流程,仅更新主 Agent,同时保持所有子 agent 固定。
在第一阶段,即轨迹蒸馏阶段,教师模型使用相同的工作流接口和固定的子 agent 生成轨迹。作者保留产生正确最终答案且严格遵循委派协议的轨迹。监督目标是首轮输出 s=(r,a1),其中 r 是推理轨迹,a1=(P,W(P)) 是工作流动作。这形成了初始数据集 D1。两个训练阶段都最小化标准监督微调损失:
LSFT(θ;D)=−(I,q,s)∈D∑logπθ(r,a1∣I,q)该损失同时监督推理 token 和动作 token,并屏蔽指令、问题和工具定义,以聚焦于首轮任务分析和工作流合成。
在第二阶段,即高质量数据筛选阶段,作者对初始数据集进行过滤,以解决信息传递不畅和 agent 判断错误等编排失败问题。LLM 评判器通过检查三类具体缺陷来评估每条轨迹的编排质量:前提注入,即把未经验证的主张呈现为既定前提;验证缺陷,即审阅者被引导至预期答案;信息流缺陷,表现为上下文缺失或上游输出的有损传递。只有通过这一基于证据检查的示例才会被保留,形成筛选后的子集 D2=J(D1)。随后在 D2 上从 Stage 1 检查点继续训练,使用较小的学习率来细化 agent 的编排能力。
实验
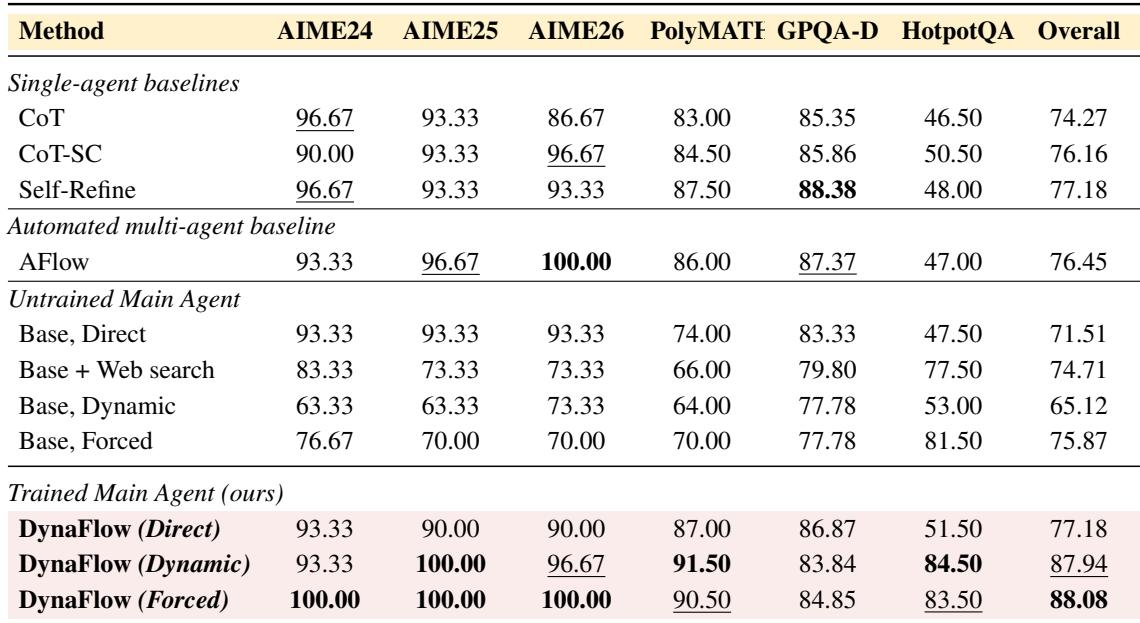
这些实验在 AIME、PolyMATH、GPQA-Diamond 和 HotpotQA 上评估工作流编排主 Agent,子 agent 保持固定,并比较 Base 模型、Stage 1 轨迹蒸馏以及在筛选后的高质量演示上进行 Stage 2 训练后的 DynaFlow。实验表明,编排训练将工作流访问转化为有效协作,DynaFlow 取得了最强的总体结果,并且 Stage 2 通过更紧密连接的阶段、更好的信息传递、显式验证和任务特定角色分配改进了工作流设计。Dynamic 模式下的自适应调用在保持接近 Forced 执行的准确率的同时,使用的子 agent 明显更少,这表明主 Agent 学会了选择性协作,不过科学推理上的失败凸显了独立验证和最终答案选择方面仍然存在的挑战。
DynaFlow 在 Forced 和 Dynamic 两种执行方式下均取得最高总体准确率,在仅训练主 agent 并保持子 agent 固定的情况下,比最强基线高出十个百分点以上。它在 Forced 模式下达到完美的 AIME 准确率,并在 HotpotQA 上取得最佳性能;在 GPQA-Diamond 上,它相较于 Base 对应模型有所提升,但仍落后于 Self-Refine 和 AFlow。DynaFlow 的两种执行模式总体上均比最强基线高出十个百分点以上。Forced 执行解决了所有 AIME 问题,两种模式均比最强 PolyMATH 基线高出数个百分点。Dynamic 和 Forced 模式均达到最高的 HotpotQA 准确率,比启用搜索的基线高出六到七个百分点。在 GPQA-Diamond 上,DynaFlow 相对于其 Base 对应模型有所提升,但未超过 Self-Refine 和 AFlow。工作流训练使这一模式从在多个基准上大多落后于直接回答,转变为达到或超过直接回答。
训练将工作流执行从一种在许多基准上最初落后于直接回答的模式,转变为有效的协作策略。Stage 1 之后,Forced 工作流执行在所有六个基准上达到或超过直接回答基线,进一步训练缩小了 Dynamic 与 Forced 模式之间的差距。最终模型在 Dynamic 和 Forced 模式下表现相近,但在能够直接回答时使用的子 agent 少得多。从 Base 到 DynaFlow,所有执行模式下的总体准确率均有所提升,其中 Dynamic 模式的提升最大。Stage 1 之后,在同一检查点内,Forced 执行总体上超过 Direct 8.73 个百分点,并在所有六个基准上达到或超过 Base Direct 参考水平。Dynamic 与 Forced 之间的准确率差距从 Base 时的 10.75 个百分点缩小到 DynaFlow 的 0.14 个百分点。在 Dynamic 模式下,DynaFlow 直接回答 47.1% 的问题,使用的子 agent 数量比 Forced 执行少约 41%,同时准确率保持接近 Forced 执行。
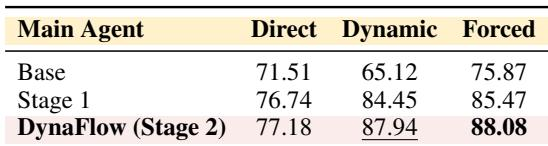
实验在 AIME、HotpotQA、GPQA-Diamond 和 PolyMATH 上,使用 Forced 和 Dynamic 工作流执行评估 DynaFlow,其中仅训练主 agent,子 agent 保持固定。工作流训练使多 agent 执行从经常落后于直接回答,转变为达到或超过直接回答;DynaFlow 实现了最高总体准确率,并在两种执行模式下均比最强基线高出十个百分点以上。DynaFlow 在 Forced 模式下达到完美的 AIME 准确率,并取得最佳的 HotpotQA 准确率;在 GPQA-Diamond 上,它相较于 Base 对应模型有所提升,但仍落后于 Self-Refine 和 AFlow。Stage 1 之后,Forced 执行已在所有六个基准上超过直接回答;最终模型缩小了 Dynamic 与 Forced 之间的准确率差距,同时 Dynamic 模式直接回答 47.1% 的问题,并使用少约 41% 的子 agent。