Command Palette
Search for a command to run...
ChronoReplay:单一答案接口不足以支撑流式空间智能
ChronoReplay:单一答案接口不足以支撑流式空间智能
摘要
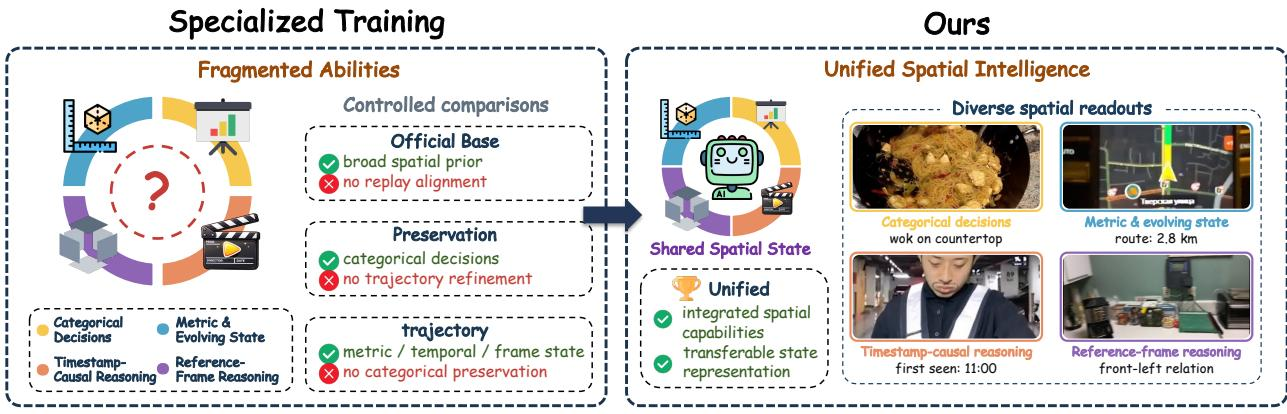
训练一个空间 VLM 来回答物体位于哪一侧,并不要求它保留决定该答案的度量位移;而对距离估计的监督则可能让类别关系在很大程度上不受约束。当后训练强调某一种读出方式时,改进可能因此集中于该接口,而向其他接口的迁移仍然较弱甚至退化;我们将这一观察到的专门化现象称为接口锁定(interface lock-in)。ChronoReplay 通过将异构空间监督按时间顺序组织成片段进行重放、保留来源原生的目标形式,并在不同监督族之间进行均衡来解决该问题。在相同的观测访问条件下,单个 ChronoReplay 检查点可同时提升 OVO-S-Bench、OST-Bench 和 UCS-Bench 的表现,其中在 OST-Bench 上提升 13.41 分,并在本文比较的监督设置中取得最高的三项基准平均分。同数据对照进一步分离了这一迁移的各个成分:答案序列化在 OST 与 UCS 之间重新分配增益;监督族均衡学习优于普通联合 SFT 和自然轮次加权;时间顺序重放在两个配对种子上比顺序偏移对照高出约 2.41 个 OST 分数。自适应帧选择随后在保持已训练模型不变的情况下改变证据获取方式,从而以更低的视觉成本提供额外的推理时增益。流式空间性能取决于监督保留了哪些区分性信息、学习过程中异构历史如何被组织,以及推理在测试时能够利用哪些因果证据。
一句话总结
西湖大学、浙江大学、中国科学技术大学等机构提出 ChronoReplay,它通过将异构空间监督重放为按时间顺序组织的情节,并使用源原生目标和家族均衡学习,减轻流式空间 VLM 中的接口锁定,同时提升 OVO-S-Bench、OST-Bench 和 UCS-Bench,包括 OST-Bench 提升 13.41 分,并在所比较的监督设置中获得最高的三基准平均分。
核心贡献
- 论文识别出一种被称为接口锁定的经验模式,即单一家族空间监督改善一种读出方式,却限制或削弱对其他空间读出方式的迁移。
- 论文引入 ChronoReplay,一种训练配方,它按时间顺序以情节形式重放异构空间监督,保留源原生目标,并在类别、度量和时序家族之间平衡监督。在匹配观察访问条件下,单一 ChronoReplay 检查点同时改善 OVO-S-Bench、OST-Bench 和 UCS-Bench,OST-Bench 提升 13.41 分,并在所比较的设置中获得最高的三基准平均分。
- 论文给出相同数据对照组,以分离迁移成分:答案序列化在 OST 和 UCS 之间重新分配收益,家族均衡学习优于普通联合 SFT 和自然轮次加权,时间顺序重放在成对种子上的 OST 分数比顺序偏移对照组高约 2.41 分。自适应帧选择在不改变已训练模型的情况下,以更低视觉成本带来推理时收益。
引言
作者研究流式空间智能,其中以自我为中心的观察者必须仅依据过去观测,从因果视频历史中回答类别、度量和时序空间问题。这具有挑战性,因为单一历史必须支撑多种答案格式,同时保留对象关联、累积运动以及变化参考系下的关系。先前工作通常一次只监督一种答案格式,未检验单一模型能否在同一因果流上服务所有格式。作者记录了一种接口锁定问题,即单一家族训练改善其原生读出方式,但对其他格式迁移不均衡;并指出当度量或时序目标脱离产生它们的历史时会变得含糊。其主要贡献是 ChronoReplay,它将保持目标原生格式的家族均衡学习与因果重放构建相结合,后者将异构监督重放为按时间顺序组织并绑定到合法因果前缀的情节。在匹配观察访问下,该方法改善 OVO-S、OST 和 UCS 基准。
数据集
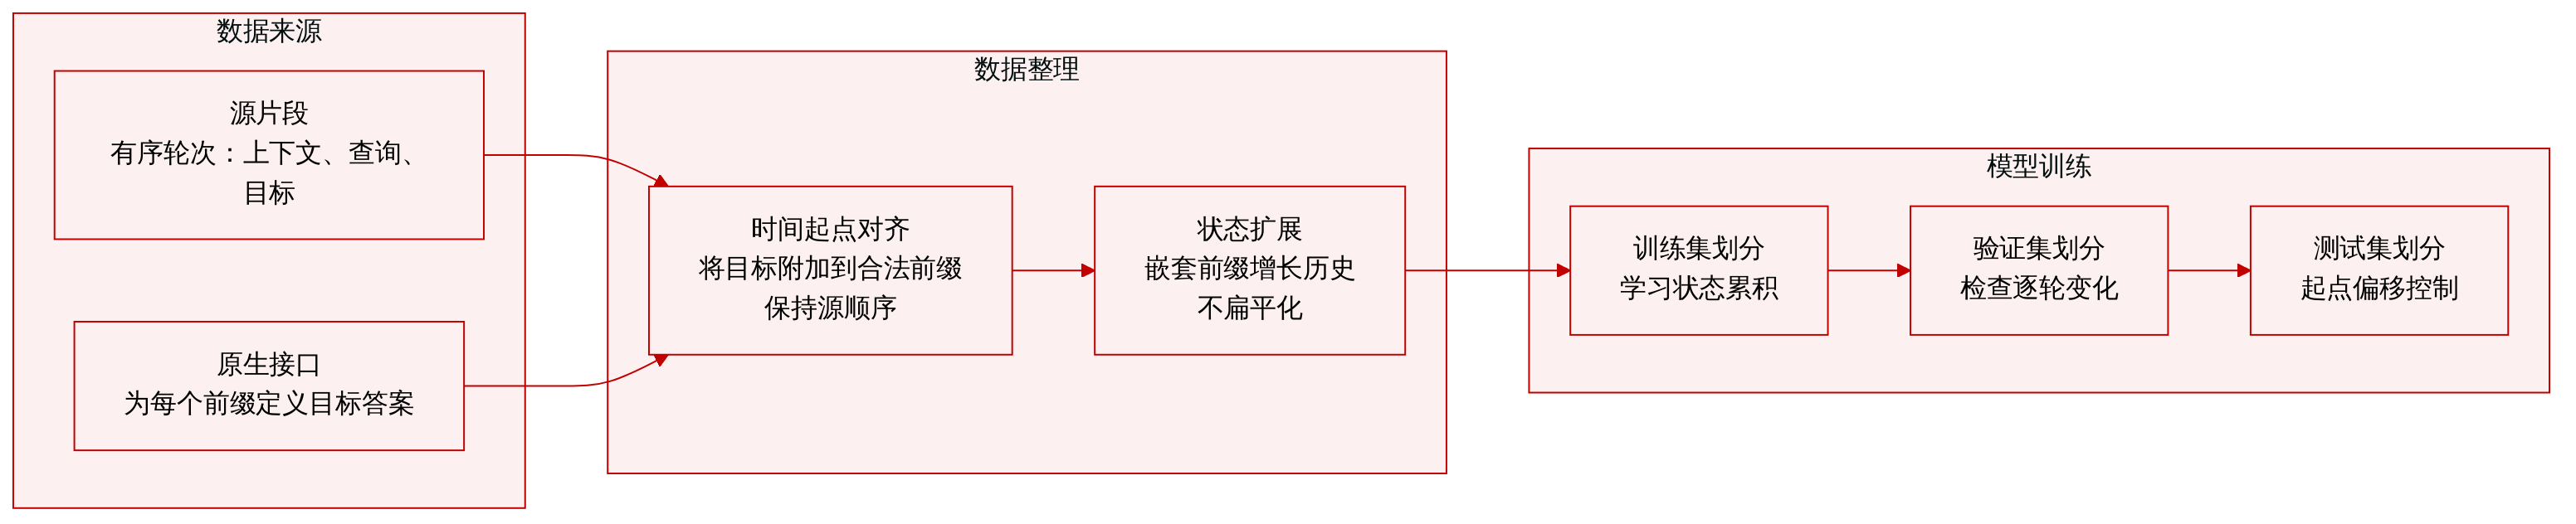
作者描述了一种称为时间原点对齐的数据集构建规则。数据被组织为有序情节,而不是独立的问答对。
来源与组成
- 监督来自源情节以及这些情节中存在的接口。
- 每个情节写作
E_i = (c_ij, q_ij, y_ij, κ_ij),其中轮次为j = 1 ... m_i。 c_ij是第j轮处的合法因果前缀:该轮可用的所有观测,加上先前的交互历史。q_ij是空间查询。κ_ij标识产生该查询的原生接口。y_ij是该接口在当前前缀下产生的目标答案。- 前缀是嵌套的,因此
c_ij包含于c_{i,j+1}。
处理规则
- 每个目标都绑定到其合法因果前缀。
- 多轮标注不会被展平为孤立配对。
- 源顺序和条件历史在原始视频时间轴上保留。
- 一个情节产生
m_i个受监督状态,它们共享同一原点,并在历史长度上增长。 - 单轮示例对应
m_i = 1,而多轮度量和时序示例形成更长情节。
在模型中的使用
- 模型在状态累积本身上训练,学习位移或事件顺序如何在轮次之间变化。
- 将 VLM 应用于连续前缀会诱导出隐式状态轨迹。
- 不添加任何地图、记忆模块或辅助状态损失。
- 第一个前缀定义情节原点。
- 原点偏移对照组改变排序和前置上下文,同时保持每个轮次块及其局部监督不变,以检验时间顺序重放规则的整体贡献。
方法
作者提出 ChronoReplay,一种用于视觉语言模型(VLM)的后训练框架,使单一共享表示既能支持原生空间读出方式,又保留每种读出方式依赖的历史上下文。该方法分为两个主要阶段:因果重放构建和家族均衡学习。
如下图所示,该框架将异构数据处理为统一重放池,并使用均衡目标优化模型。
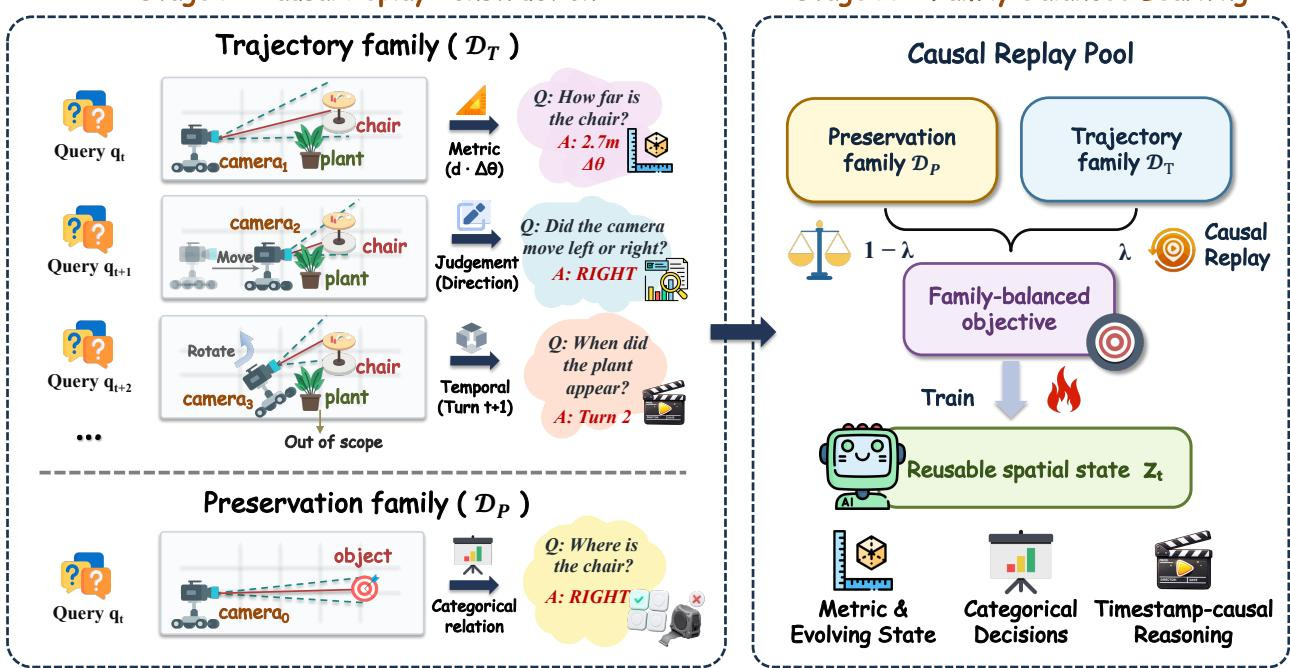
在第一阶段,因果重放构建中,作者确保异构答案空间在组合时不丢失任务特定语义。与施加额外的答案空间变换不同,每个目标都保留在其源接口的原生值空间中。类别目标保持其候选结构,度量目标保持大小、符号、单位和精度,时序目标保留时间戳和事件索引。对于给定接口 κ,在 VLM 表示 Z=Fθ(C) 下,因果前缀 C 的原生目标 Yκ 的总体风险定义为:
Rκ(Fθ,Gκ)=E[−logGκ(Yκ∣Z,Q)]为解决度量或时序目标脱离历史后产生的歧义,作者强制时间原点对齐。监督被放置在源情节的视频时间轴上,并按原始时间顺序重放。一个情节 Ei 被表示为合法因果前缀、空间查询、原生目标和接口标识符的序列:
Ei=(cij,qij,yij,κij)j=1mi,cij⪯ci,j+1其中因果前缀包含关系 cij⪯ci,j+1 确保模型在历史累积上训练,而不是在孤立快照上训练。将 VLM 应用于这些连续前缀会诱导出隐式状态轨迹 zij=Fθ(cij),无需辅助记忆模块或状态损失。
在第二阶段,家族均衡学习中,作者解决保留家族 DP(包含 33,180 个单轮示例)与轨迹家族 DT(包含 6,381 个有序情节,产生 45,006 个受监督轮次)之间规模差异的问题。为防止某一家族主导共享参数,作者在每个家族内归一化风险。保留风险 LP 和轨迹风险 LT 定义为:
LP=∑r∈DPwr∑r∈DPwrℓrP,LT=∣T∣∑(i,j)∈TℓijT其中 ℓrP 和 ℓijT 表示相应示例的原生损失,wr 表示源定义权重。最终均衡目标组合这些归一化风险:
Lreplay=(1−λ)LP+λLT,λ=1+αα这里 α 控制轨迹家族相对于保留家族的相对损失质量。当设定 α=0.5 时,轨迹家族获得总质量的三分之一,而保留家族获得三分之二。此外,答案长度归一化为每个受监督轮次分配平均 token 损失,以防止长答案仅凭 token 数量主导优化。
实验
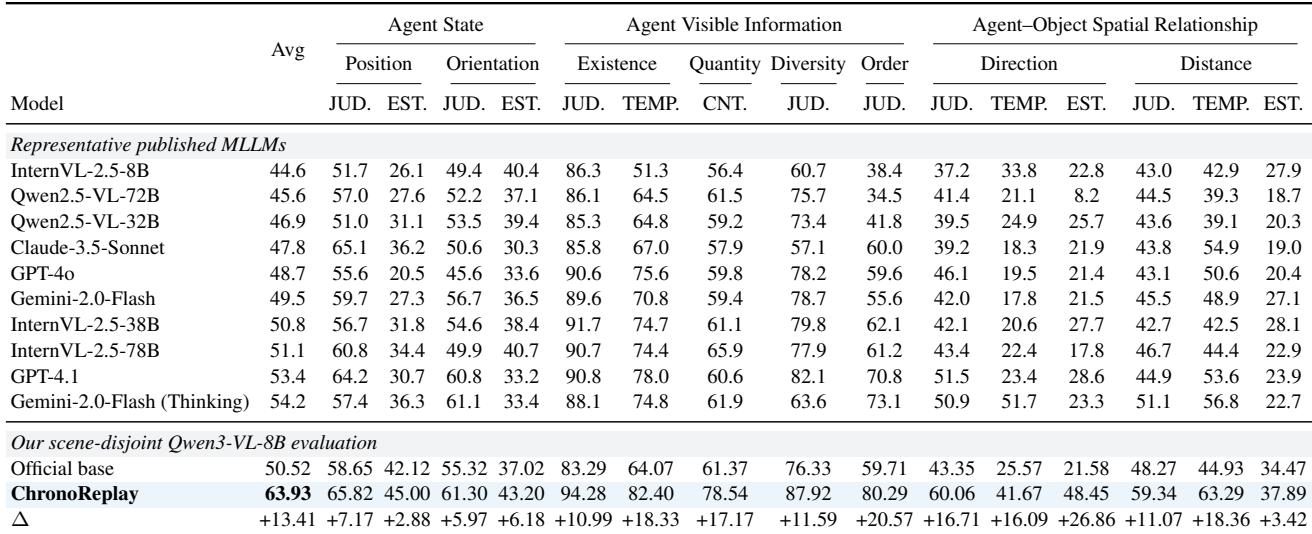
实验在 OVO-S-Bench、OST-Bench 和 UCS-Bench 上评估 ChronoReplay,使用固定的 Qwen3-VL-8B 基座,并对训练变体、答案格式、训练顺序和观察访问进行对照比较。结果表明 ChronoReplay 能在类别、连续和时间戳因果推理之间迁移,当答案需要组合累积的多轮状态时收益最大。诊断分析将效果归因于完整的时间顺序重放配方,而非单一家族训练,并表明原生目标和时间顺序会在不同读出方式之间重新分配或改善迁移。观察访问被进一步隔离为正交因素,自适应访问在训练收益之外带来额外好处。
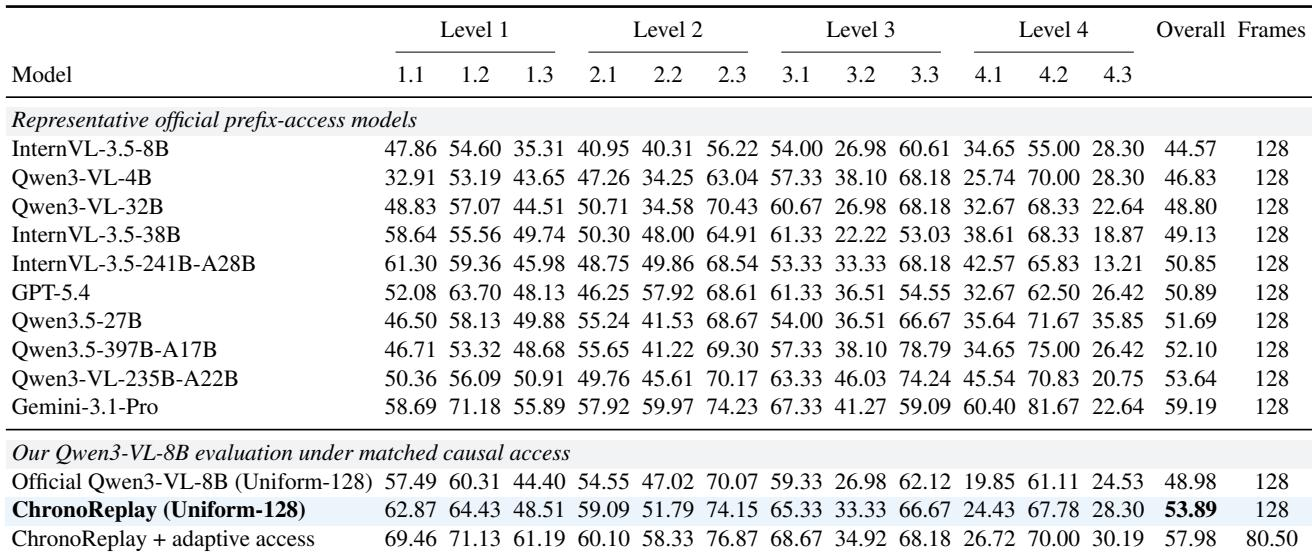
在所列举的代表性官方前缀访问模型中,总体准确率相对接近,最大的 InternVL 模型领先,最小的 InternVL 模型落后。任务家族分数差异很大,最后的 Level 4.3 任务家族在所列举模型中属于最弱之列。训练和自适应访问分别带来收益,自适应访问在 Level 1 上帮助最大,而 Level 4 仍然最难。所列举的最大 InternVL 模型总体准确率最高,最小的 InternVL 模型总体最低。最后的 Level 4.3 任务家族对每个所列举模型都属于最弱之列,其他若干任务家族也远低于最强家族。训练改善所有四个 Level,自适应访问在 Level 1 上带来最大额外提升,同时也改善 Level 4,但 Level 4 仍是最难级别。
在匹配的场景不相交评估下,ChronoReplay 相对于基座模型改善了细粒度 OST-Bench 性能,在全部十五个子类型上均产生正向迁移。方向估计、顺序判断和距离时序定位的收益最大,这些任务需要组合累积多轮状态来生成答案。较低分的难度等级也得到改善,但最难等级仍为最低。在场景不相交协议下,OST-Bench 总体准确率比基座提高 13.41 分。全部十五个细粒度子类型均改善,最大收益出现在方向估计、顺序判断和距离时序定位。改进集中在答案依赖累积多轮状态而非仅当前视图的地方。全部十二个难度家族均改善,但最低分等级仍最难。
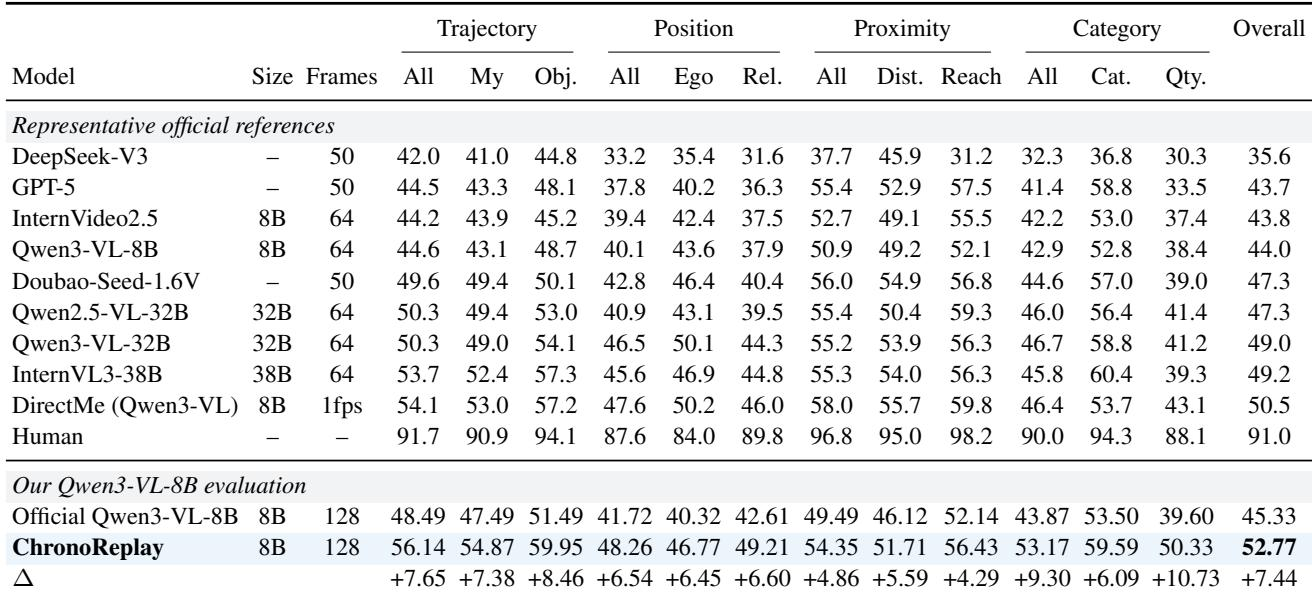
参考模型在轨迹和接近性问题上始终强于位置和类别问题,物体和可达子类别通常贡献较高分数。Doubao-Seed-1.6V 在总榜和所有聚合组中领先于所列模型,其余参考模型彼此接近。类别组内部差异最大,类别问题远高于数量问题。轨迹和接近性聚合得分最高,而位置和类别聚合在各参考模型中始终较低。Doubao-Seed-1.6V 是总体及每个聚合组中最强的所列模型,其他模型彼此接近,在关系和数量子类别上仍然较弱。
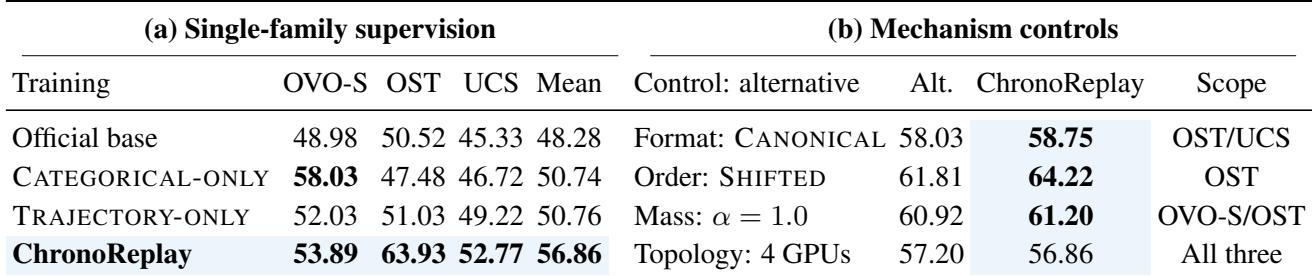
诊断分析显示,完整 ChronoReplay 取得最强的三基准综合结果,而单一家族监督造成不均衡的跨读出方式迁移。对照实验将收益归因于均衡目标和时间顺序,而答案格式主要在 OST 和 UCS 之间重新分配性能,而不是均匀改善所有端点。完整 ChronoReplay 获得最高三基准均值,明显高于仅类别、仅轨迹和官方基座。仅类别监督改善 OVO-S 但大幅降低 OST,而仅轨迹监督结果更均衡但更低。ChronoReplay 在所有三个评估端点上优于普通 token SFT 和自然轮次加权。原生答案格式有利于 UCS 和双基准均值,而规范格式有利于 OST,表明存在重新分配而非均匀增益。在两个种子对中,时间顺序重放均在 OST 上领先于偏移训练顺序,支持时间原点对齐。
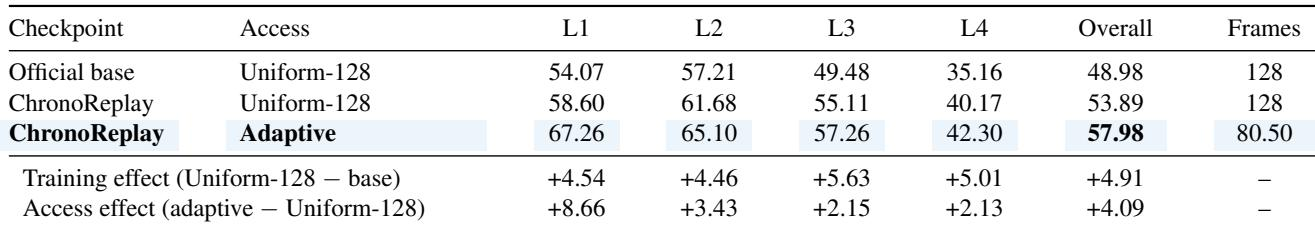
ChronoReplay 训练在每个难度等级和总体上均比官方基座提高准确率,总体训练提升略低于 5 分。自适应观察访问随后带来略高于 4 分的进一步总体提升,其中 L1 层级收益最大,L4 最小。即使经过这两项干预,L4 仍是最难层级。ChronoReplay 训练改善每个难度等级,总体比官方基座提升略低于 5 分。自适应访问带来略高于 4 分的总体提升,L1 改善最大,L4 改善较小,同时使用更少帧。
实验先比较代表性前缀访问模型,然后在场景不相交 OST-Bench 下评估 ChronoReplay 与其基座模型,最后进行参考模型和诊断分析。前缀访问基线总体准确率接近,但任务家族差距很大,Level 4.3 始终较弱,自适应访问在 Level 1 帮助最大,而 Level 4 仍最难。ChronoReplay 改善全部十五个细粒度 OST-Bench 子类型和所有难度家族,尤其是方向估计、顺序判断和距离时序定位,表明收益来自依赖累积多轮状态的答案。参考模型在轨迹和接近性上最强,在位置和类别上最弱,Doubao-Seed-1.6V 总体领先;诊断消融将 ChronoReplay 的收益归因于均衡目标和时间顺序,而答案格式主要在 OST 和 UCS 之间重新分配性能,训练加自适应访问改善所有等级但 L4 仍最难。