Command Palette
Search for a command to run...
Trajectory2Gym:面向工具使用智能体的决策有据组合式交互合成
Trajectory2Gym:面向工具使用智能体的决策有据组合式交互合成
Yihao Hu Zhihao Wen Yitong Lin Siyuan Lu Pan Wang Wei Wu Jiang-Ming Yang Tao Lin
摘要
成功的工具使用轨迹并不一定是有用的监督信号。即使是成功的交互,也可能未充分表示多步依赖,或包含在决策时刻无法由智能体可见信息所支持的动作。我们确定了有效轨迹监督的两个相互耦合的要求:组合覆盖性,以确保重要的观察—动作依赖得到表示;以及决策有据性,以确保每个受监督动作都能由学习器可见的交互历史所支持。我们引入了 Trajectory2Gym,该方法围绕支持不足的组合结构构建可执行交互,并仅从其实际执行中有据可依的决策中导出监督。结构支持度选择负责分配由此产生的经验,而父归一化监督微调则保持语义交互作为训练权重的单位。这将轨迹生成重新定义为有意识地构建可学习的交互经验,而非收集成功轨迹。在五种 Qwen3 规模上,Trajectory2Gym 在每种测试规模上均提升了 Tau1、Tau2 和 BFCL 的表现,使三项基准的等权平均分提升 16.9–29.8个百分点。这些提升在有状态和多轮交互中最为显著,因为其中的后续决策依赖于先前的观察和反馈。我们的结果表明,扩展工具使用智能体不仅依赖于收集更多成功轨迹,还依赖于构建这样的交互:其中依赖关系得到表示,且决策能够从智能体可见历史中学习得到。
一句话总结
西湖大学和蚂蚁国际的研究者提出 Trajectory2Gym,围绕支持不足的组合结构构造可执行工具使用交互,并仅对基于决策依据的动作进行监督,采用结构支持选择与父级归一化微调,在五个 Qwen3 规模上将 Tau1、Tau2 和 BFCL 的等权三基准平均分提高 16.9 至 29.8 个百分点。
核心贡献
- 本文提出 Trajectory2Gym,一个轨迹构造框架,围绕支持不足的组合结构构建可执行工具使用交互,并仅从基于学习者可见交互历史的决策中导出监督。
- Trajectory2Gym 贡献了用于分配所得经验的结构支持选择,以及保持完整语义交互作为训练权重单位的父级归一化监督微调。
- 在五个 Qwen3 规模上的实验表明,在构造交互上进行标准监督微调可在每个测试规模上提升 Tau1、Tau2 和 BFCL,使等权三基准平均分提高 16.9 至 29.8 个百分点,其中在有状态和多轮任务上增益最大。
引言
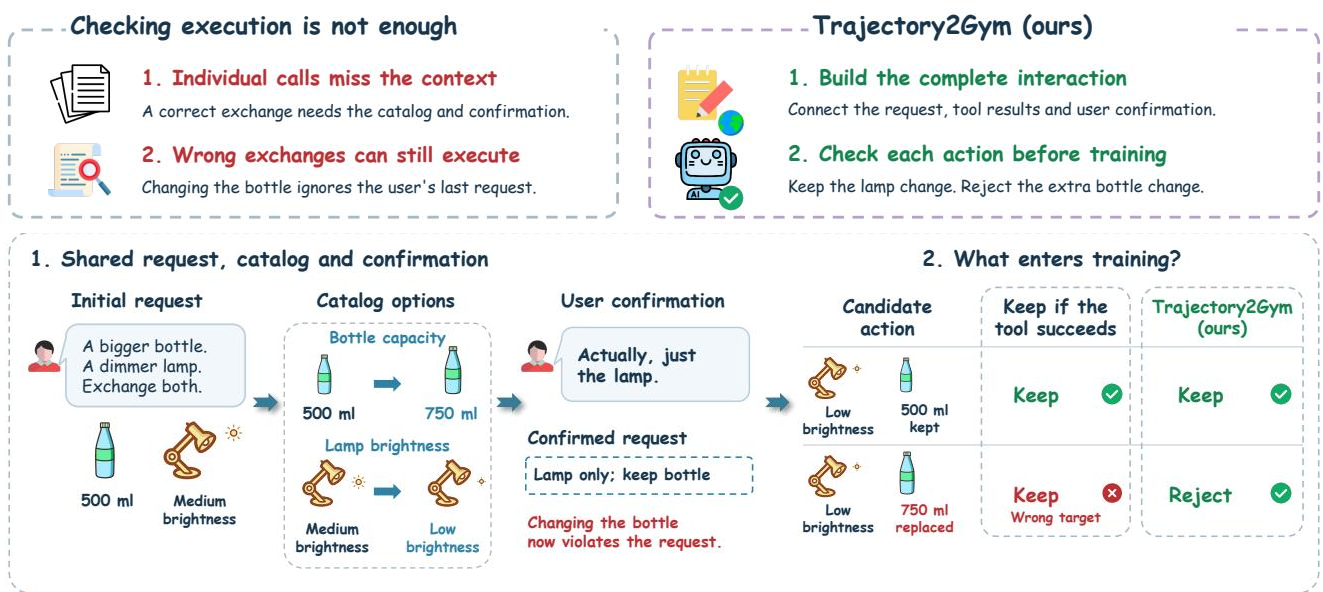
工具使用 agent 必须学习组合式交互,在多轮工作流(如客户支持和 API 使用)中,观察、用户更新或状态变化决定后续决策。先前的训练流程通常按任务完成或单次调用执行来过滤轨迹,但仅成功并不能保证每个被模仿的动作都由 agent 可见历史所证明,而且日志数据往往缺乏对跨步骤依赖和真实错误后恢复的充分覆盖。作者提出 Trajectory2Gym,它合成支持不足的交互路径,仅对基于可见证据和工作流顺序的决策认证监督,并应用结构支持选择与父级归一化监督微调。
数据集

作者从原生环境中执行的组合能力路径构造合成交互数据集。
-
来源与组合:共享能力词表覆盖语义动作与参数、观察结果、恢复、分支、交接、终止和时间范围。原生工具与观察映射到这些角色。有序路径将所需能力组合为一次交互。生成器为目标路径创建请求和兼容初始状态,教师则在原生环境中执行任务。每条轨迹被分配一个规范路径用于支持统计。
-
认证与过滤:仅当路径的动作和观察依赖出现在执行日志中时,该路径才被认证。只有被认证的结构会更新支持库存并指导后续合成轮次。该方法针对支持低于规模特定目标的路径,并据此条件化生成器。构造过程为每条路径建立实体、前置条件和信息来源,并将所需值绑定到可见来源,如请求、用户交换或工具结果。
-
数据集组装:作者从认证池中组装 Ds。选择保持任务广度,覆盖能力路径,并对发现、恢复和完成等代表性不足的结构给予重复支持。每个可行规范路径的目标不同轨迹数量随学习者规模增长:从 1.7B 到 30B-A3B 分别为 1、2、3、4 和 8。选择从固定的认证核心开始,为每个训练任务添加一个完成示例,补齐未覆盖的原子和路径,然后添加减少支持缺口的轨迹。
-
处理与模式:所选轨迹通过原生提示、角色、工具模式和可见观察进行渲染。一条语义轨迹可能产生多个训练示例。非目标可见消息保留为上下文。
-
在模型中的使用:对于监督微调,作者使用父级归一化 SFT。每个父轨迹获得相等权重,其权重按经过认证的目标 token 数量比例分配到渲染出的示例中。这防止长多轮交互在按示例平均中占主导。所给摘录未描述显式的训练/验证/测试划分,或除规模相关的每条路径支持目标之外的混合比例。
方法
作者提出 Trajectory2Gym,一个旨在通过解决组合覆盖和决策依据问题,为工具使用 agent 构建高质量监督轨迹集的框架。整体流程由三个紧密耦合阶段组成:组合式交互合成、有依据监督和结构支持学习。
参见框架图:
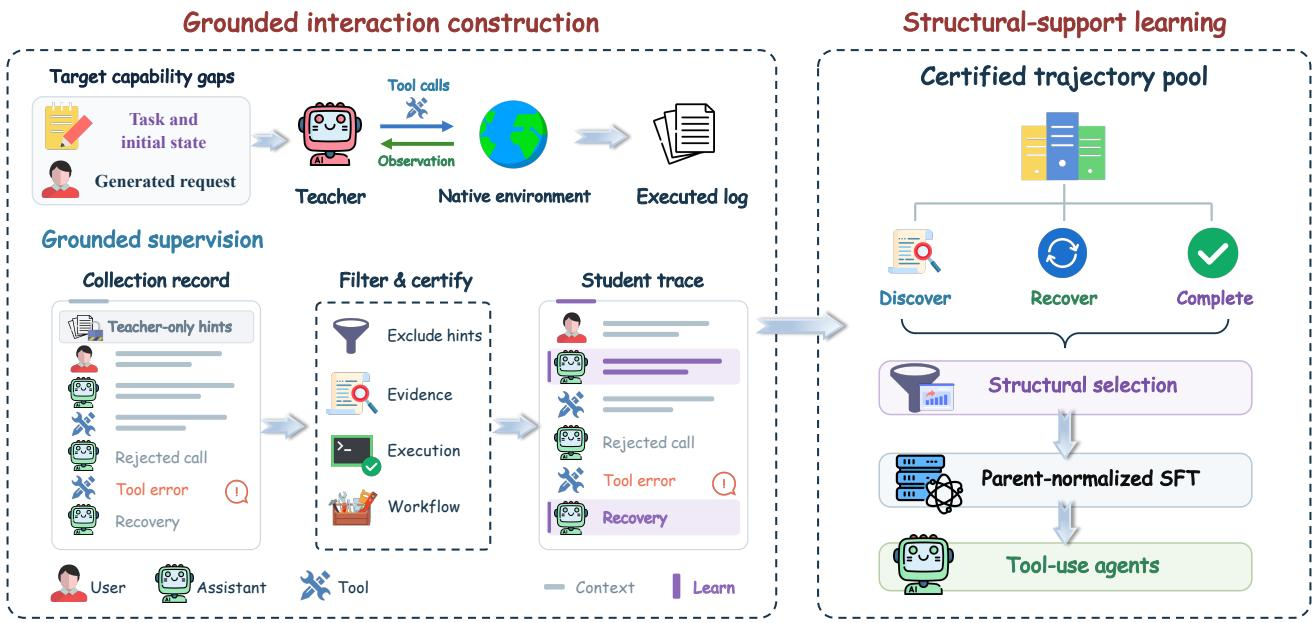
在第一阶段,组合式交互合成中,作者将支持不足的交互路径转化为已执行的原生交互。共享能力词表覆盖语义动作、参数、观察结果、恢复、分支和终止。生成器为目标路径构造请求和兼容初始状态,教师则在原生环境中执行任务。每条轨迹被分配一个规范路径用于支持统计。原生执行提供真实观察、状态变化和拒绝,确保仅教师可见的引导不会进入学生轨迹。只有当路径的动作和观察依赖出现在执行日志中时,该路径才被认证。
第二阶段,有依据监督,将每条执行日志转化为学生上下文和一组认证目标。该阶段确保每个受监督动作都由已实现的交互及其决策时上下文支持。
如下图所示:
作者区分原生执行有效性 et∈{0,1} 与决策时有依据性 vt∈{0,1},将局部合格性定义为:
gt=etvt决策上下文仅包含通过原生 agent 接口暴露的事件;教师提示和私有事件绝不进入学生上下文。对于工具调用,执行有效性要求经过认证的无错误执行,而决策时有依据性要求工具可用,且类似标识符的参数由前置可见信息支持。最终监督掩码纳入原生终止成功和任务需求的有序子序列包含:
mt=Rτ1[qτ⪯Aτ]gt其中 Rτ 是原生终止成功,qτ 是任务有序需求,Aτ 是相关操作的规范化序列。被拒绝的调用及其真实错误保留为可见上下文而不产生模仿损失,而随后有依据的恢复成为目标。
第三阶段,结构支持学习,作者组装最终数据集以保持任务广度并覆盖能力路径,对发现、恢复和完成等代表性不足的结构给予重复支持。对于给定的学习者规模,定义每个可行规范路径的目标不同轨迹数量。所选集合的剩余缺口计算为:
δs(p;S)=[ds−nS(p)]+选择过程从固定的认证核心开始,为每个训练任务添加完成示例,补齐未覆盖的原子和路径,然后添加减少支持缺口的轨迹。
在训练中,作者采用父级归一化监督微调(SFT)。由于一条语义轨迹可能产生多个训练示例,按示例平均会使长多轮交互主导损失。因此,每条轨迹的贡献定义在父级层面。轨迹损失为其认证下一 token 对的平均负对数似然:
ℓθ(τ)=−Nτ1u=1∑Nτlogπθ(yu∣hu),LSFT(θ)=∣Ds∣1τ∈Ds∑ℓθ(τ)这种方法确保每个父级获得相等权重,无论渲染重复次数如何,使语义训练量独立于轨迹被渲染成的示例数量。
实验
Trajectory2Gym 通过在规模条件轨迹数据上微调 1.7B 到 30B 的 Qwen3 模型,并在 Tau1、Tau2 和 BFCL 上进行测试来评估,同时与各模型自身初始化以及公开 agent 训练检查点进行配对比较。实验表明,在基于决策依据的组合数据上进行标准 SFT 可在每个测试规模上改进有状态工具使用,增益集中在多步骤和多轮任务中,且经过后训练的较小模型可以超过大得多的 RL 训练检查点。匹配消融表明,定向扩展、决策依据、结构选择和父级归一化都有贡献,其中父级归一化带来最大的独立增益,而敏感性分析显示更深入的结构支持并不自动更好。定性案例证实,该方法监督了基于证据的决策和顺序敏感的工作流恢复,而这些行为是基线 agent 未能展现的。
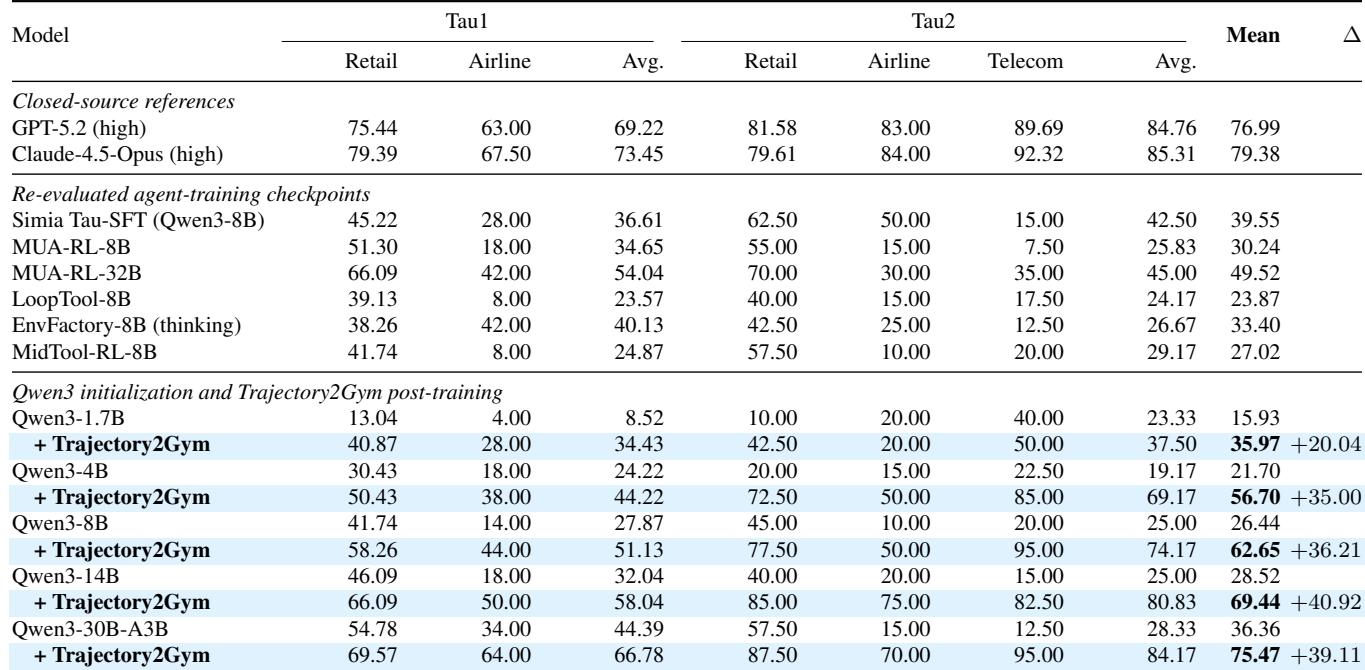
Trajectory2Gym 在每个测试模型规模上均改善了 Tau1 和 Tau2 的有状态工具使用结果,平均增益在 20 到 41 点之间,并有广泛的配对改进。后训练模型超过更大的公开初始化和重新评估的 agent 训练检查点,最大的后训练模型接近闭源参考分数。仅凭强函数调用结果不能迁移到有状态任务。Tau1 和 Tau2 平均分在每个测试规模上提升 20 到 41 点,25 个配对领域-规模比较中有 24 个改善。配对增益在 1.7B 规模最小;从 4B 起为 35 到 41 点。后训练的 4B 模型在 Tau2 上达到 69.17,远高于公开 30B-A3B 初始化,后训练的 30B-A3B 模型与闭源参考分数相差不到 1.2 点。8B Trajectory2Gym 模型在 Tau2 上达到 74.17,至少比重估的所有 agent 训练检查点(包括 14B 和 32B 模型)高 28 点。函数调用技能不会迁移到有状态任务:EnvFactory-8B 模型在 BFCL Overall 上几乎与 8B 模型持平,但在 Tau2 上落后 47.5 点。
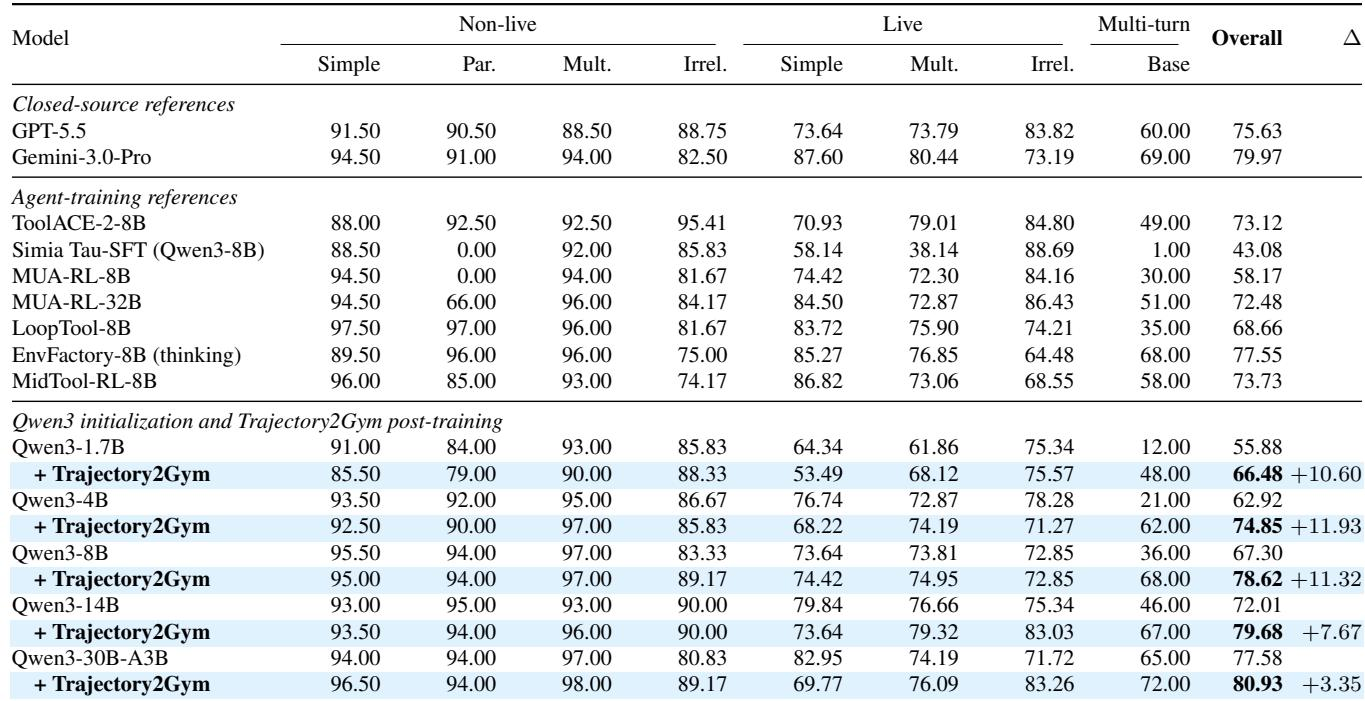
在此 BFCL 比较中,报告的闭源模型整体领先,Gemini-3.0-Pro 得分最高,GPT-5.5 紧随其后。ToolACE-2-8B 整体具有竞争力,但其多轮基础得分低得多,而 Simia Tau-SFT 因并行非实时和多轮基础得分接近零而大幅落后。Gemini-3.0-Pro 整体领先,其次是 GPT-5.5,两个闭源模型均高于所列 agent 训练参考。ToolACE-2-8B 在并行非实时、多重和不相关类别中表现强劲,但在多轮基础中急剧下降。Simia Tau-SFT 的并行非实时和多轮基础结果接近零,产生所报告模型中最低的整体得分。
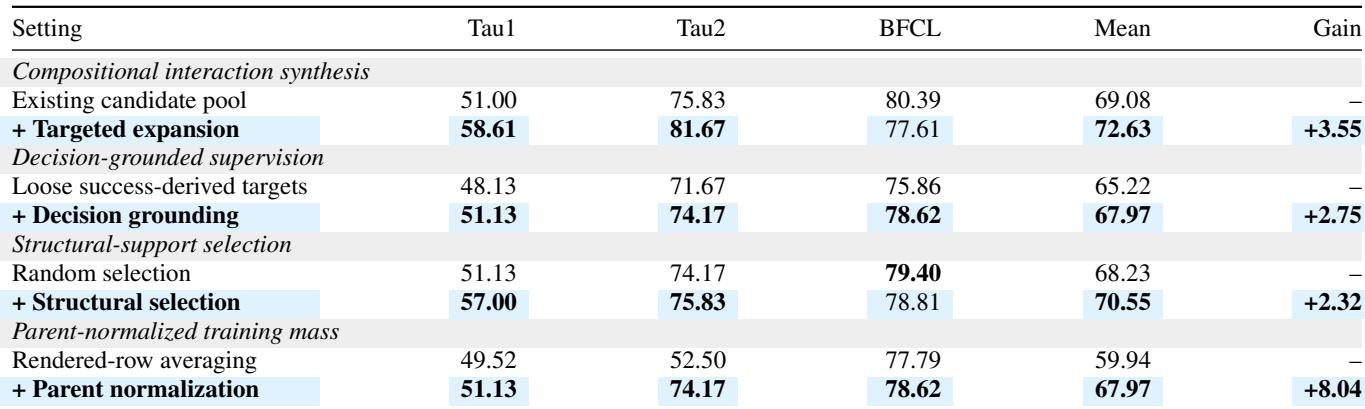
所有四个匹配组件比较均支持所提出的 Trajectory2Gym 选择,优于阶段匹配的替代方案,并具有正的平均增益。由于每对改变不同阶段,增益具有方向性且不可相加。父级归一化提供最大的独立改进,支持将语义交互作为优化单位。所有四个匹配比较均产生正平均增益,其中父级归一化显示最大的独立增益。定向扩展主要增强有状态 Tau 任务,决策依据改善决策级监督,结构选择在相同预算下覆盖更多规范路径。
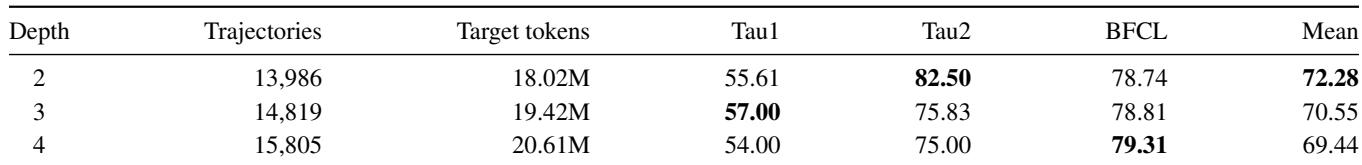
在此敏感性运行中,基准平均分随结构支持深度的增加而下降,最浅设置表现最佳,尽管其轨迹数和目标 token 数最少。降幅集中在 Tau2,而 BFCL 保持相对稳定;由于深度也会改变监督量,该结果不能将路径支持与 token 数分离。平均基准性能在最浅支持深度时最高,并随深度增加而下降。Tau2 降幅最大,而 BFCL 在各支持深度上保持相对稳定。
实验在有状态工具使用基准 Tau1 和 Tau2 上评估 Trajectory2Gym,比较函数调用和 BFCL 行为,消融所提出的组件,并测试结构支持深度。Trajectory2Gym 在所有模型规模上改善有状态工具使用,并超过更大的公开初始化和 agent 训练检查点,而仅函数调用技能不会迁移到有状态任务。闭源模型在 BFCL 整体上仍然领先,参考 agent 训练模型在多轮或并行非实时设置中表现出明显弱点。消融显示所有提出的组件均有帮助,其中父级归一化提供最大的独立增益,敏感性结果偏向较浅的结构支持,尽管深度与监督量存在混杂。