Command Palette
Search for a command to run...
RynnUnify:迈向统一具身大脑
RynnUnify:迈向统一具身大脑
摘要
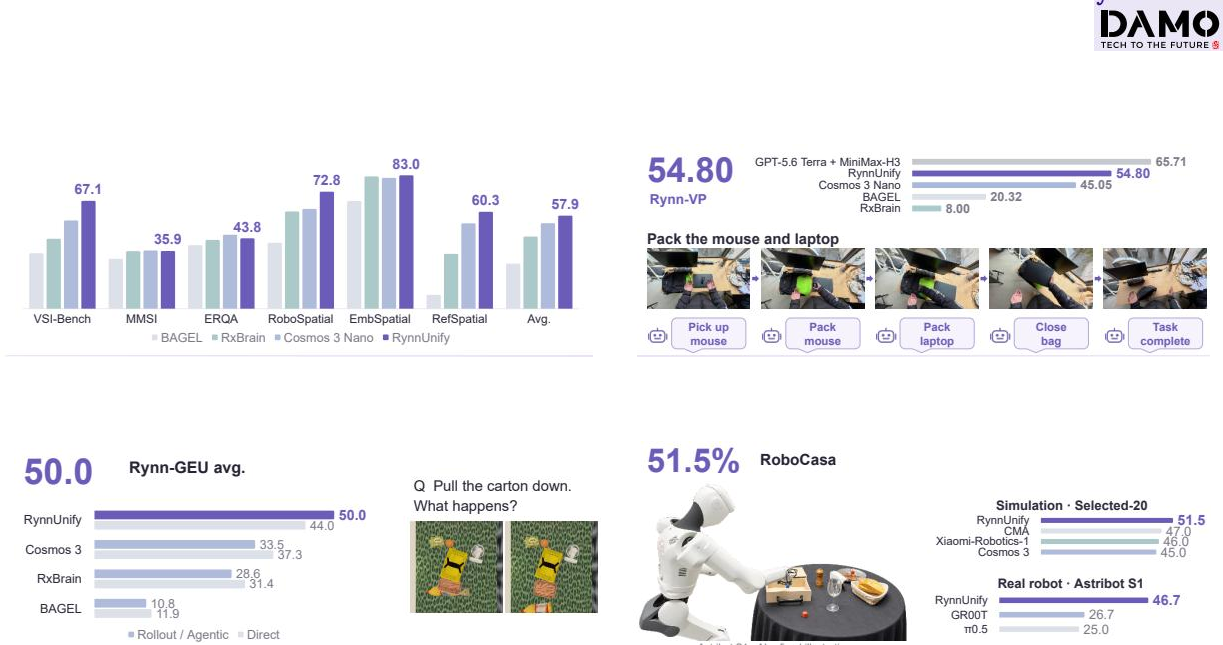
我们提出 RynnUnify,一个 16B 的统一具身模型,通过交错的视频-语言推理将强大的具身理解与长时程视觉规划相结合。凭借涵盖空间推理、物理预测和 grounding 的能力,RynnUnify 将对物理世界的理解与对其在连续子任务间如何演变的视觉预期联系起来。基于这些能力,我们进一步通过强化学习开发了 agentic 扩展,以选择性地使用视频预测对未观测状态和交互结果进行推理。我们还为完整 RynnUnify 模型开发了 world-action 扩展,将其理解与预测能力转化为机器人控制。为评估这些能力,我们引入了 Rynn-VP 和 Rynn-GEU,用于长时程视觉规划和预期推理。实验表明,RynnUnify 在所评估的统一多模态模型中取得了最高的平均具身理解得分,并将 Rynn-VP 总体得分较 Cosmos 3 Nano 提高了 9.75 分。其 agentic 扩展将 Rynn-GEU 平均得分较直接推理提高了 6.0 分,而 world-action 扩展在 20 个选定的复合 RoboCasa365 任务上实现了 51.5% 的成功率,并在三个真实机器人任务上实现了 46.7% 的平均成功率。这些结果共同将 RynnUnify 确立为具身理解、视觉规划和机器人控制的共享基础,向统一具身大脑迈出了一步。
一句话总结
达摩院与阿里巴巴集团湖畔实验室推出 RynnUnify,这是一个 16B 的统一具身模型,通过交错式视频语言推理结合具身理解与长时程视觉规划,并具有支持预判推理与机器人控制的 agentic 强化学习和 world-action 扩展。该模型在已评测的统一多模态模型中取得最高的具身理解平均分,同时 Rynn-VP 总分比 Cosmos 3 Nano 提高 9.75 分。
核心贡献
- 提出 RynnUnify,一个 16B 的统一具身模型,通过交错式视频语言推理结合具身理解与长时程视觉规划,并使用场景记忆和 self-forcing 改善长时程生成中的视觉一致性。
- 提出 Rynn-VP 和 Rynn-GEU 作为长时程视觉规划与预判推理基准;RynnUnify 在已评测的统一多模态模型中取得最高平均具身理解分数,并在 Rynn-VP 总分上比 Cosmos 3 Nano 提高 9.75 分。
- 一个 agentic 扩展学会选择性使用视频预测来推理未观测状态,将 Rynn-GEU 平均分比直接推理提高 6.0 分;一个 world-action 扩展将模型的理解和预测能力转化为机器人控制,在 20 个选定的复合 RoboCasa365 任务上达到 51.5% 成功率,并在三个真实机器人任务上平均成功率达到 46.7%。
引言
通用机器人脑需要统一模型,能够理解物理场景、预判动作如何改变世界,并将任务意图转化为动作。以往的统一多模态模型可以联合处理理解与生成,但长时程协调仍然困难,因为预测误差会累积,静态视觉输出可能遗漏中间动态。作者推出 RynnUnify,这是一个基于 Cosmos3 的 Mixture-of-Transformers 架构的 16B 具身模型,将一个 8B 自回归推理器与一个 8B 扩散生成器配对,以执行面向长时程视觉规划的交错式视频语言推理。作者还添加了 agentic 扩展以决定何时生成用于预判推理的视频,添加了 World-Action Model 扩展用于机器人控制,并提出 Rynn-VP 与 Rynn-GEU 两个基准,用于评估持续的视觉规划与生成增强的具身理解。
数据集
数据集概览
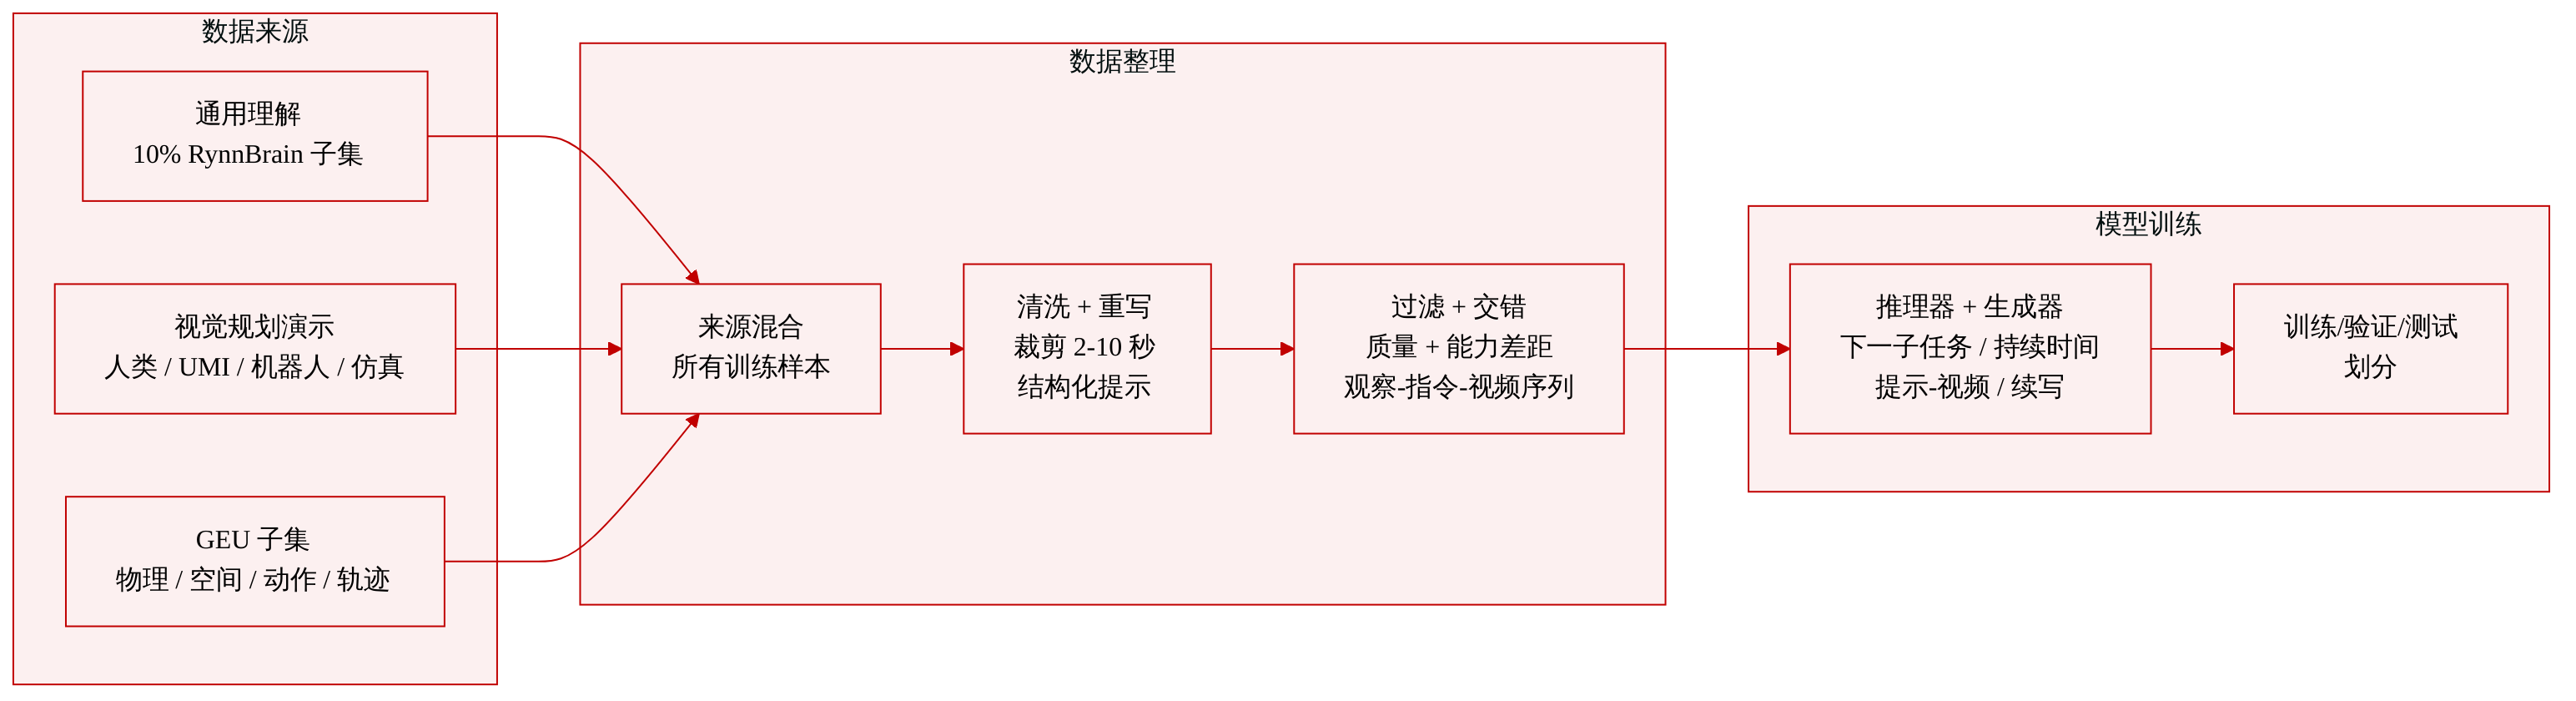
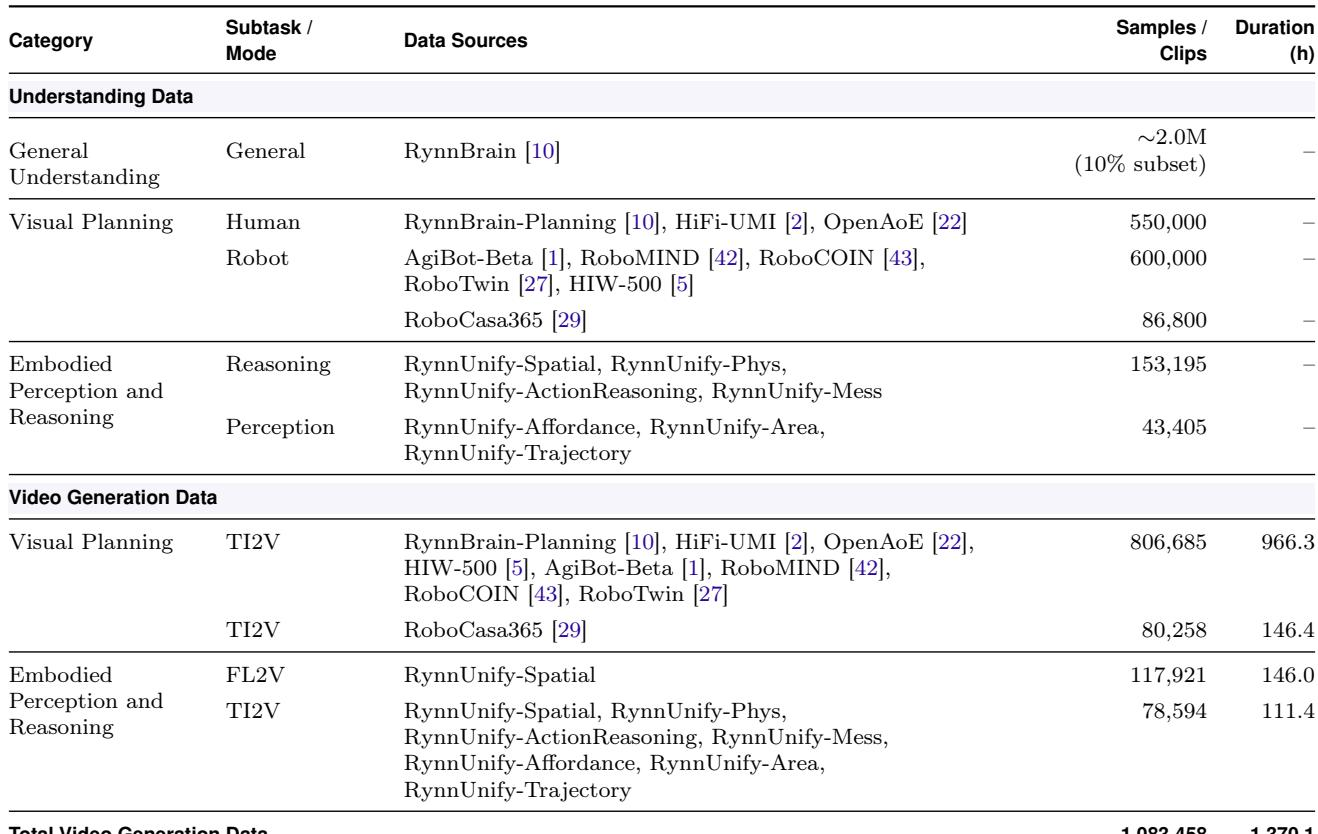
作者使用表 1 所总结的数据微调两个组件:一个用于规划并生成世界建模指令的推理器,以及一个用于预测相应视频的生成器。训练数据结合了通用理解、视觉规划与生成增强理解样本。
1. 通用理解数据
- 使用 RynnBrain 预训练语料的 10% 子集。
- 覆盖通用图像和视频理解、视觉问答、时序推理、指令遵循以及具身认知任务,如物体理解、空间推理、计数和以自我为中心的任务理解。
- 包含空间定位监督:物体定位、区域定位、affordance 定位、轨迹预测和操作规划。
- 该子集在模型面向更专门化规划与感知数据微调时保留广泛的具身理解。
2. 视觉规划数据
- 来源:RynnBrain-Planning、HiFi-UMI、OpenAoE、HIW-500、AgiBot-Beta、RoboMIND、RoboCOIN、RoboTwin、RoboCasa365,以及 RynnUnify 采集中的以自我为中心的移动操作视频。
- 覆盖人类演示、UMI 演示、真实机器人交互和仿真操作。
- 处理:
- 如果存在显式子任务标注,作者直接使用;否则由 Qwen3.6-27B 进行时序分割和重新标注。
- 视频片段尽可能保持在 2 到 10 秒。
- GPT-5.6-Terra 将每条子任务指令改写为结构化视觉提示,描述场景、相关物体、交互过程和结果状态变化。
- 过滤:
- 一个开源 MLLM 对单片段和完整轨迹的视觉质量、操作完整性以及指令视频对齐度评分,低分样本被移除。
- GPT-5.6-Terra 分析基础模型视频以识别能力缺口,并将相似任务和场景样本与随机采样数据组合。
- 使用:
- 交错样本保留原始任务目标和时序顺序。
- 观测与子任务指令、结构化视觉提示和操作时长交错排列。
- 推理器学习预测下一子任务并估计时长。
- 对齐的提示视频对监督生成器,连续片段支持跨越子任务边界的视频续写。
3. 生成增强理解,即 GEU,数据
- 每个 GEU 样本是一个交错对话:模型接收观测和问题或任务指令,首先生成世界建模指令,再接收一段视频作为视觉上下文,然后返回以答案或空间输出结尾的推理响应。
GEU 子集
-
RynnUnify-Phys
- 基于 PhysInOne 中的渲染视频和仿真标注构建。
- 每个序列划分为已观测前缀和未来延续。
- 问答对来源于延续部分的物体轨迹和事件标注。
- 每个 SFT 样本包含:已观测视频和问题、世界建模指令、真值延续视频,以及以答案结尾的推理响应。
- GPT-5.6-Luna 使用已观测前缀中的带时间戳帧改写世界建模指令。
- 审核检查事实依据、交互覆盖和未来结果泄漏。
- 包含 10,028 个 SFT 样本和 1,553 个用于强化学习的数值问题。
-
RynnUnify-Mess
- 基于 RoboTwin 中受控干预(如拉出或移除物体)的杂乱桌面场景构建。
- 记录物体位姿、接触与支撑关系,以及支撑丧失、掉落和可见性变化等事件。
- GPT-5.6-Terra 改写视频生成提示;MiniMax-H3 以这些提示和仿真的初始帧、最终帧为条件,在 FL2V 模式下生成视频。
- 自动运动和可见性准则以及基于 GPT 的后过滤移除瞬移、严重穿透和无关不稳定等伪影。
- 每个样本组合了初始观测和干预问题、视频生成提示、中间视频 rollout,以及一个答案。
-
RynnUnify-Spatial
- 覆盖位置、方向、距离和尺寸推理。
- 位置子集基于 ScanNet++ 构建,使用相机内参和外参、3D 边界框以及逐视图可见性。
- 基于规则的模板创建四种位置问题类型:物体到相机、相机到相机、相机运动和物体到物体。
- 位置子集包含 100,000 个样本:99,200 个训练样本和 800 个测试样本,每个问题类型 200 个测试样本。
- 方向、距离和尺寸样本采样自 RynnBrain 基于视频的空间感知数据,并由 Qwen3.8-27B 改写。
- MiniMax-H3 在 FL2V 模式下生成中间视觉上下文;部分尺寸样本使用单图 I2V 生成。
- GPT-5.6-Luna 生成思维链标注。
-
RynnUnify-ActionReasoning
- 基于 RynnBrain 中具有物理感知的规划演示构建,包括 AgiBot、Galaxea、RoboCasa、RoboCOIN、RoboMIND、RoboTwin、SoftFold 和自采数据。
- 片段被切分为相邻的 2 到 6 秒已观测上下文和未来延续片段。
- 覆盖七种能力:动作原语选择、移动与够取、动作意图识别、推动方向、旋转与朝向、度量动作,以及 affordance 与可行性。
- 质量控制结合多模态评判和适用性评分。
- 作者保留每个类别前 2,000 个样本,共 14,000 个样本。
- 划分:13,300 个训练样本和 700 个测试样本,每个类别 1,900 个训练样本和 100 个测试样本。
-
RynnUnify-Affordance 和 Area
- 基于 RynnBrain-Planning 中具有时序顺序的原子子任务子集构建。
- 子任务包含语言指令和空间标注:目标物体边界框、affordance 点和放置区域点。
- 视频被切分为操作片段。
- RynnUnify-Affordance 要求模型识别目标物体上的交互点。
- RynnUnify-Area 要求模型定位目标区域,例如放置目标位置。
- GPT-5.6-Terra 从子任务片段生成世界建模描述。
- 包含 20,039 个 affordance 样本和 13,774 个 area 样本,共 33,813 个训练样本。
-
RynnUnify-Trajectory
- 基于 RH20T 操作视频构建。
- 每个样本将一个操作片段的初始帧与一条任务指令配对。
- 目标是表示为最多十个点的 2D 轨迹,坐标归一化到 0 到 1000。
- 执行片段最长为 8 秒,采样率为 24 帧每秒。
- Qwen-VL-Max 从干净的初始帧生成初始世界建模描述;这些描述再使用执行片段中的四帧进行改写。
- 投影轨迹路径长度低于 20 像素的样本被排除。
- 包含 9,892 个样本:9,592 个训练样本和 300 个测试样本。
4. 评测基准
-
Rynn-VP
- 包含 200 个手工采集的以自我为中心的长时程视觉规划任务场景。
- 给定初始图像和任务指令,模型生成任务执行视频或有序步骤图像序列。
- 参考演示和带时间戳的子任务标注保留用于评测。
- 评分使用三个维度:规划智能、视觉实现和视觉质量。
- 总分:0.5 规划智能加 0.4 视觉实现加 0.1 视觉质量。
-
Rynn-GEU
- 包含十个子集,覆盖空间关系、物理预测、连锁反应、动作推理、affordance grounding、区域 grounding 和轨迹预测。
- 构建遵循相应的 RynnUnify-GEU 训练流程,但评测场景与训练场景分离。
- Mess 使用训练中未出现的 RoboTwin2.0 场景。
- Spatial、Trajectory 和 Action Reasoning 排除训练数据中出现或高度相似的场景。
- Phys 使用不同的 PhysInOne 资产和场景。
- Affordance 和 Area 使用与训练数据来源不同的 AgiBot-Beta。
- 面向未来的样本选择偏好那些有未来视觉证据时回答良好、无未来视觉证据时回答较差的问题。
- 评测在统一的 0 到 100 分制上使用任务特定指标。
方法
RynnUnify 采用 Mixture-of-Transformers (MoT) 架构,包含两个不同分支:一个用于多模态理解和语言生成的自回归推理器,以及一个通过 rectified flow 预测连续视觉 latent 的扩散生成器。两个分支使用独立的 Transformer 参数,并通过联合注意力交互,使生成器能够关注推理器产生的表示。
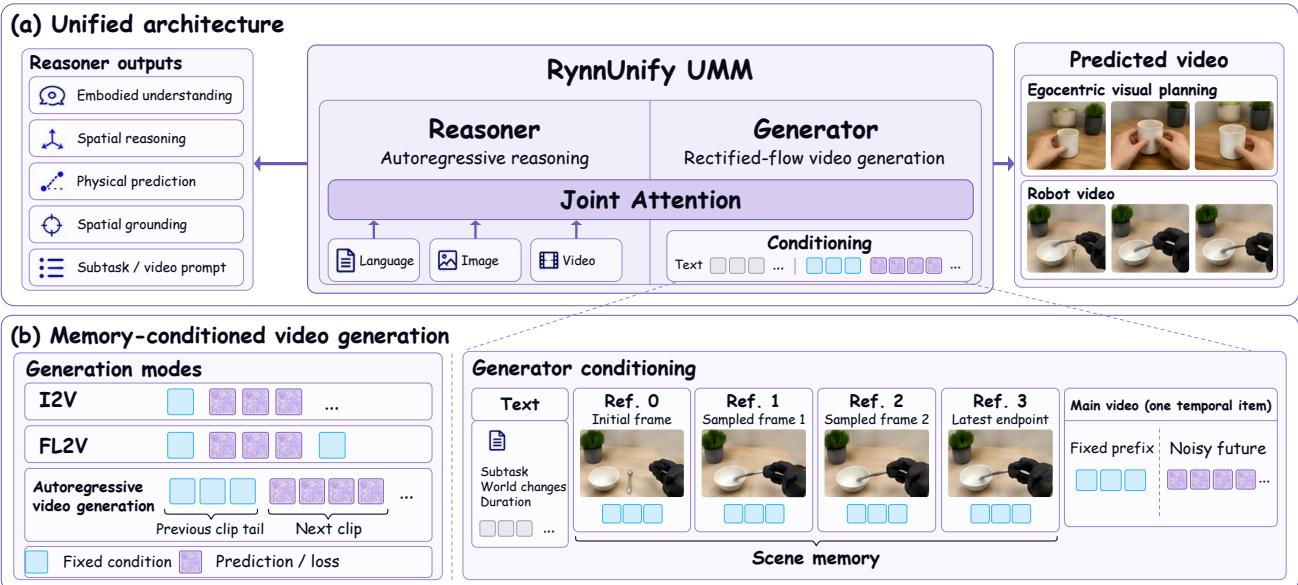
推理器处理多模态观测和语言上下文,以支持具身理解、空间定位和任务规划。对于视觉规划,它以任务目标、初始和当前观测以及先前子任务历史为输入,预测下一个可执行子任务,并给出其预期视觉演变的详细描述和估计时长。
对于视频生成,视觉输入通过一个因果视频 VAE 编码,空间和时间压缩因子分别为 16 和 4。得到的 latent 被空间 patch 化为视觉 token。场景记忆帧和主视频都遵循该 VAE 通路。启用场景记忆时,token 序列组织为:
St=[SAR;ZmemZmem(0);…;Zmem(3);zt]其中 SAR 表示由推理器处理的文本条件 token,Zmem(i) 表示第 i 个参考帧的视觉 token,zt 表示去噪时间 t 时的主视频 token。
为支持长时程规划,作者引入了跨块场景记忆。它由四个独立编码的参考帧组成,放置在主视频 token 之前,包括一个持久的初始观测、两个来自较早历史的关键帧,以及一个来自最近步骤的参考帧。此外,来自前一块的连续视频前缀占据主视频时序序列的开头。该模型支持三种生成模式:图像到视频(I2V)、首尾帧到视频(FL2V)和跨块视频续写,其中特定 latent 帧在去噪过程中保持不变。
训练过程遵循多阶段流程,旨在培养推理器和生成器的互补能力。
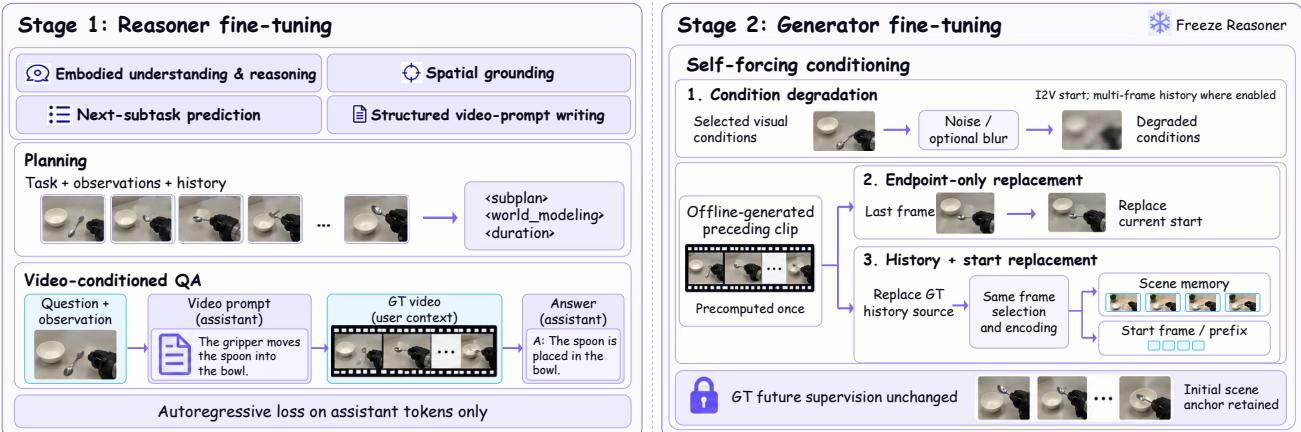
在阶段 1 中,作者微调推理器,以发展时空理解、物理世界定位、子任务规划和视频提示构建能力。模型使用标准自回归损失在助手响应 token 上优化:
LR=−i∈IR∑logpθR(si∣s<i)其中 IR 索引助手响应 token。
长时程视觉规划样本通过将视觉观测与子任务指令和结构化视觉提示交错排列来构建。
在阶段 2 中,推理器被冻结,生成器被微调以将结构化视觉提示和场景上下文转换为视频预测。作者采用 self-forcing 策略来提高长时程 rollout 的鲁棒性。这些策略包括条件退化,即对起始条件帧施加高斯噪声和下采样上采样模糊;离线端点替换,即将起始观测替换为离线生成的前一片段的最终帧;以及联合历史与端点替换,将替换扩展到用于条件构建的前序视频。生成器使用 flow-matching 目标优化,仅作用于需要预测的主视频位置:
LG=E∣Ω∣1j∈Ω∑∥vθG(zt,t,c)j−vt,j⋆∥22其中 Ω 索引需要预测的主视频位置。
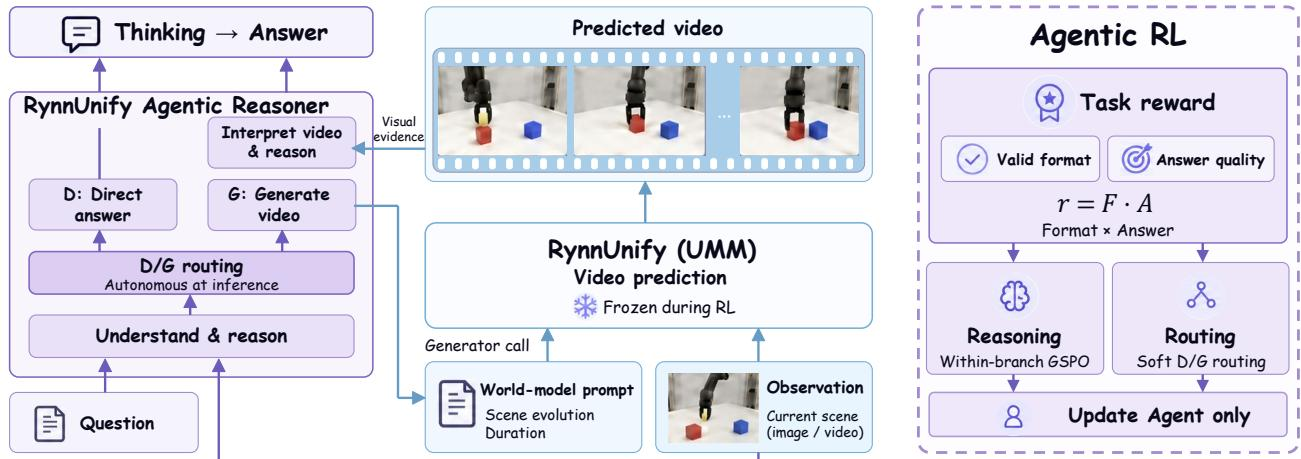
阶段 3 引入 Branch-Conditional Policy Optimization(BCPO),这是一个 agentic 强化学习框架,联合优化推理行为和生成器调用。推理器在直接推理和生成辅助推理之间选择。分支内奖励比较使用序列级 GSPO 目标改进每条交互路径上的推理,而分支间奖励差异教会推理器选择对任务有利的路径。完整目标结合了分支特定推理、调用学习和策略正则化:
LRL=LGSPO+λrouteLroute+βLKL−ηH最后,作者通过后训练将 RynnUnify 扩展为用于机器人控制的 World-Action Model(WAM)。
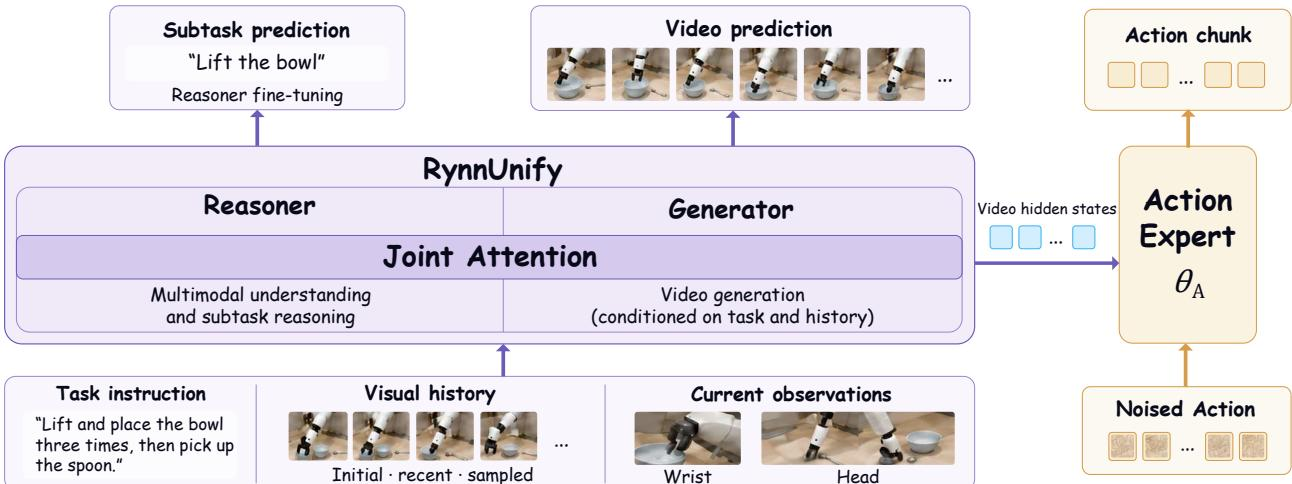
在此架构中,推理器以任务指令、当前 RGB 观测和视觉历史为输入,生成连续子任务 latent。该 latent 通过逐层注意力条件化生成器,以预测未来视频。一个 18 块的动作头通过交叉注意力读取生成器的视频隐藏状态,并使用 flow matching 预测动作块的 velocity field。WAM 分三个阶段训练:在子任务标注上训练推理器,使用子任务 latent 训练生成器,以及在保持推理器冻结的情况下联合优化生成器和动作头进行动作头训练。最后一个阶段中,辅助相机位姿头提供几何监督。
实验
所提出的基准通过无仿真器的生成 rollout 评估长时程视觉规划,并通过生成视觉上下文评估预判性具身理解。基础具身理解实验表明,RynnUnify 提供强大的空间、交互和轨迹推理能力,而当预测具有选择性和依据时,agentic 视觉生成可进一步改善推理;但不可靠的生成上下文可能损害其他模型。交错规划结果表明,保留场景记忆并适应不完美预测可改善任务推进和视觉一致性。面向移动操作和历史依赖任务的仿真与真实机器人评测确认,后训练模型在运动协调、精度和依赖记忆的执行方面优于基线。
微调数据涵盖通用理解、视觉规划以及具身感知和推理。通用理解来自一个大样本池,但只使用 10% 子集。视觉规划以机器人片段为主,人类片段紧随其后,仿真数据规模较小;具身推理样本比感知样本多出三倍以上。机器人视觉规划片段构成最大的规划集合,人类视觉规划片段紧随其后,RoboCasa365 贡献较小。具身推理数据比具身感知数据多出三倍以上。
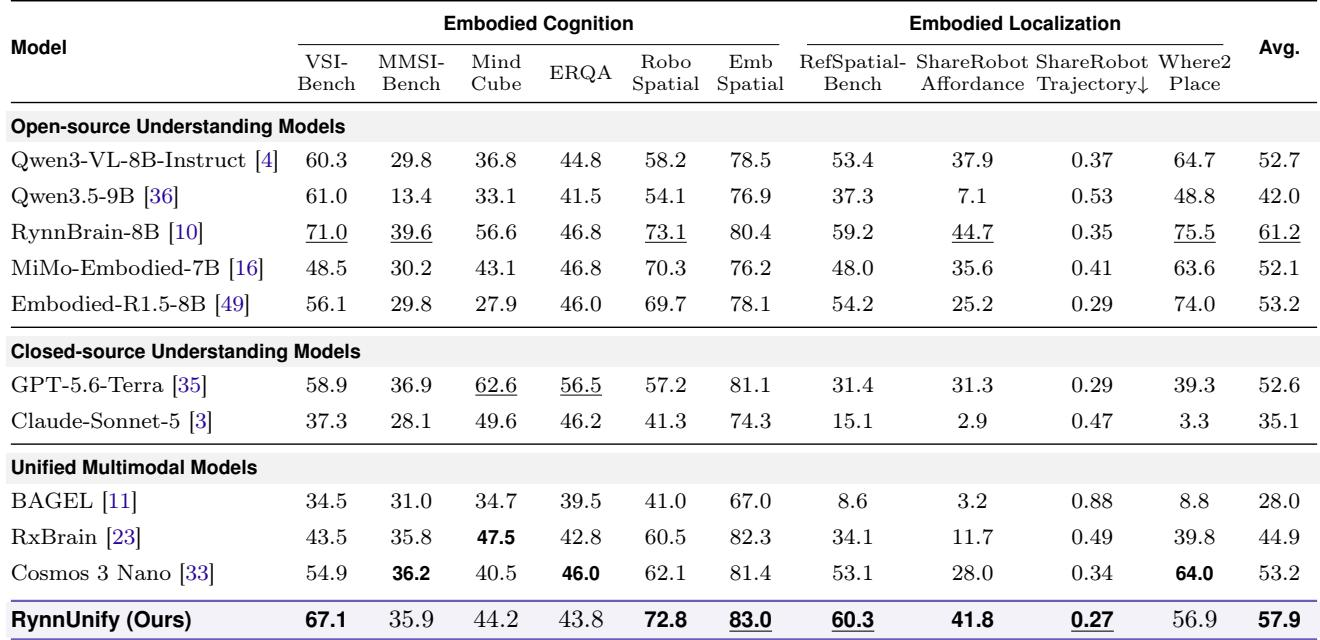
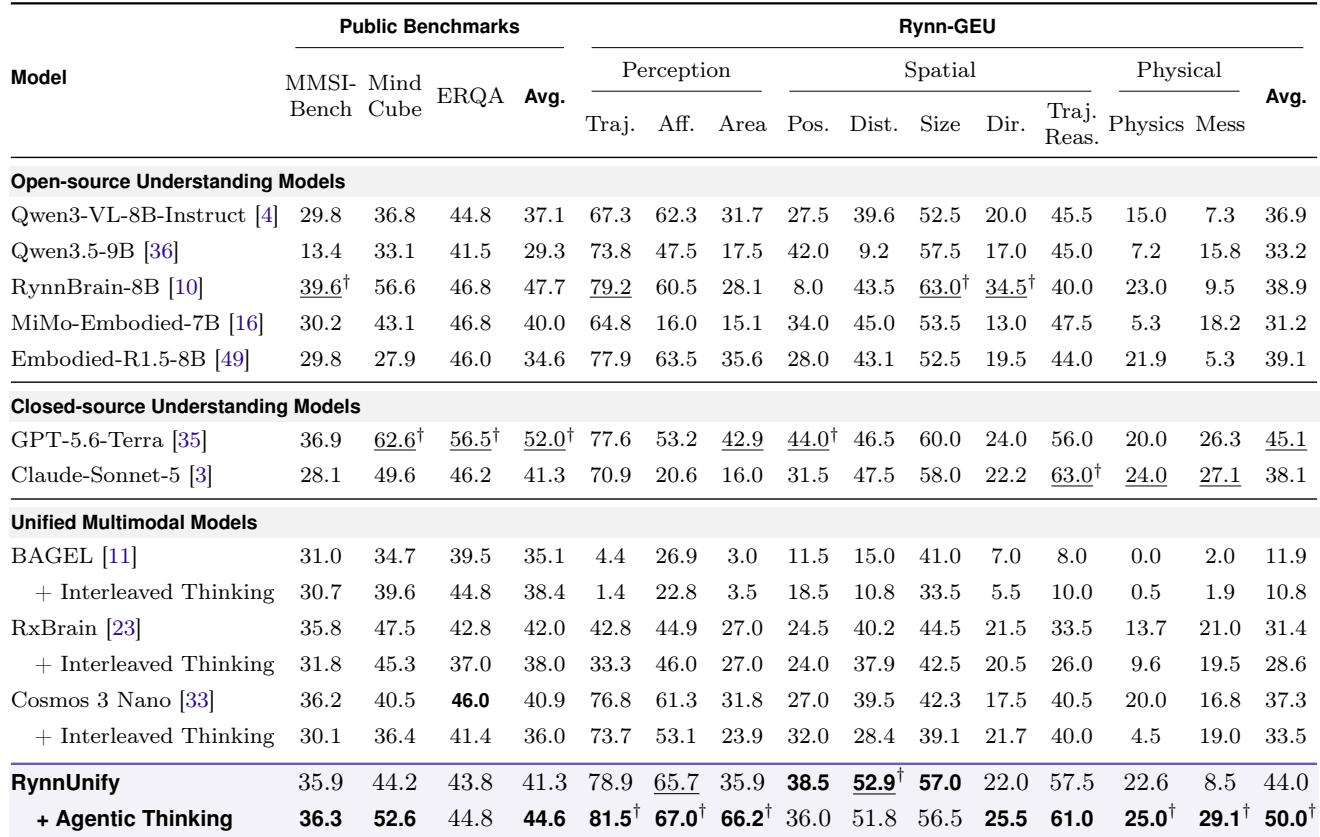
RynnUnify 在统一多模态模型中取得最高的平均具身理解分数,并在十个评测指标中的六个上领先。它在空间理解上表现尤其突出,在 VSI-Bench 和 RoboSpatial 上相比 Cosmos 3 Nano 有大幅提升,并在多个定位基准上取得最佳结果。这些改进包括对任务相关交互点的更准确定位以及更好的轨迹预测。RynnUnify 在十个具身理解指标中的六个上领先,并在统一多模态模型中取得最高平均分。它在 VSI-Bench 和 RoboSpatial 上以两位数优势超过 Cosmos 3 Nano,并在 EmbSpatial、RefSpatial-Bench 和 ShareRobot Trajectory 上取得最佳整体结果。
在对比的开源理解模型中,RynnUnify 在 Rynn-GEU 上取得最强的直接回答性能,展现了对动作、物理变化和空间关系的预判推理。加入 agentic 视觉生成扩展后,Rynn-GEU 性能进一步提升至所有对比方法中的最高水平,并在感知、空间和物理任务上都有提升。在 agentic 设置下,公开推理基准也有所提升,其中 MindCube 增幅显著。RynnUnify 在开源理解模型中取得最佳直接回答 Rynn-GEU 平均分。agentic 扩展将 Rynn-GEU 平均分从 44.0 提高到 50.0,超过包括 GPT-5.6-Terra 在内的所有对比方法。与直接回答相比,agentic rollout 改善了十个 Rynn-GEU 任务中的七个,并在所有十个任务上优于其他 UMM rollout 变体。公开基准平均分从 41.3 上升到 44.6,其中 MindCube 提升显著。
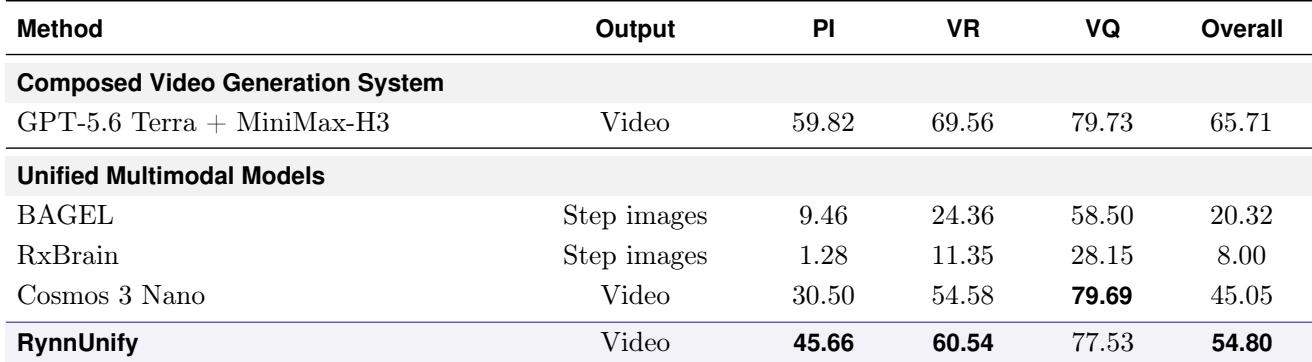
在 Rynn-VP 上的统一多模态模型中,RynnUnify 取得最高的规划智能、视觉实现和总分。相比 Cosmos 3 Nano 的提升主要来自规划智能的大幅提高和视觉实现的中等提升,而视觉质量略低。一个组合视频生成系统在所有展示方法中仍报告最高总分。RynnUnify 将总分从 Cosmos 3 Nano 的 45.05 提高到 54.80,规划智能提升超过 15 分。视觉实现从 54.58 提高到 60.54,而视觉质量从 79.69 略微下降到 77.53。
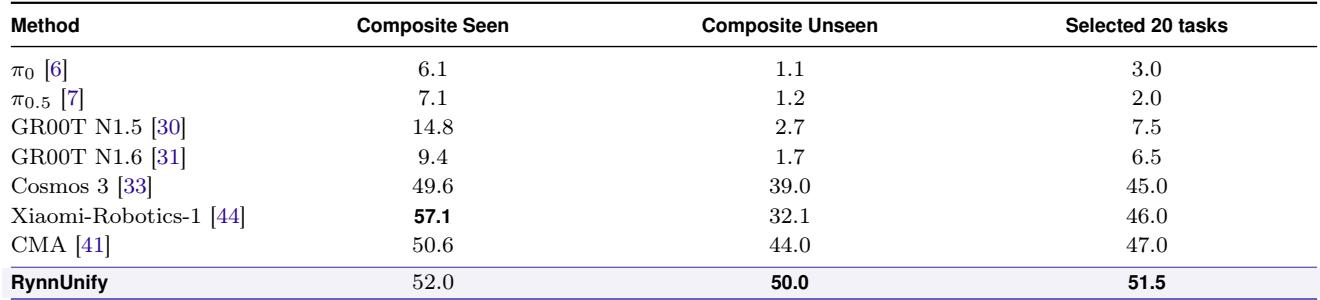
在 RoboCasa365 上,早期策略在 composite 划分和 Selected-20 上的成功率低得多。RynnUnify 在 Composite-Seen 和 Composite-Unseen 上达到约 50%,在对比方法中 Composite-Unseen 排名第一。其后训练 WAM 以 51.5% 的成功率领跑 Selected-20 移动操作任务,明显领先 CMA、Xiaomi-Robotics-1 和 Cosmos3。RynnUnify 在评测方法中取得最佳 Composite-Unseen 成功率,以明显百分点优势超过 CMA 和 Cosmos3。后训练 WAM 取得最高 Selected-20 成功率,超过最强基线约 5 到 7 个百分点。若干基线策略在完整 composite 划分和 Selected-20 上的成功率仍为个位数或低十几,远低于领先方法。
微调数据涵盖通用理解、视觉规划以及具身感知和推理,其中机器人视觉规划片段和具身推理样本占比最大。RynnUnify 在具身理解、推理基准、视觉规划和 RoboCasa365 操作上进行了评测。它在具身理解上领先统一多模态模型,取得最佳直接回答 Rynn-GEU 分数,并通过 agentic 视觉生成获得进一步提升;在视觉规划上超过 Cosmos 3 Nano,并在 RoboCasa365 上取得强劲成功率,包括最佳 Composite-Unseen 和领先的 Selected-20 表现。