Command Palette
Search for a command to run...
面向真实声学场景的高效流式音视频目标说话人提取
面向真实声学场景的高效流式音视频目标说话人提取
Wendi Sang Kai Li Yifan Li Jianqiang Huang Xiaolin Hu
摘要
流式音视频目标说话人提取(AVTSE)对延迟敏感应用至关重要。然而,当前因果系统面临两个相互耦合的缺口。第一,标准基准将说话人数量固定为两人,并忽略真实场景中的近场/远场干扰、混响和突发噪声。第二,高性能因果架构对边缘部署而言过于庞大。轻量级替代方案试图通过反复调用一个小型分离器来恢复模型容量,但这会抵消节省的收益。为弥补第一个缺口,我们发布了 RealSSA,一个现实的 AVTSE 基准,包含 RealSSA-Sim 和 RealSSA-Real。RealSSA-Sim 提供可控的模拟场景,包含 1–5 个动态近场干扰说话人;包含远场干扰的场景还另有 10–15 个远场干扰说话人。RealSSA-Real 提供一个留出的真实录制评估集。为弥补第二个缺口,我们提出 Falcon,一种因果 AVTSE 方法。其 Separator 在单次编码器–解码器前向过程中执行多尺度时频分离。我们使用编码器空间说话人对比损失训练 Falcon。该损失在零推理成本下抑制近场泄漏,并可跨骨干网络迁移。Falcon 在 RealSSA-Sim、LRS2-2Mix、LRS3-2Mix 和 VoxCeleb2-2Mix 上取得了最先进的提取质量。与因果 AV-TFGridNet 基线相比,Falcon 将参数量减少 91.9%,计算量减少 20.2 倍,GPU 推理延迟降低 11.1 倍。代码和演示可在 https://cslikai.cn/Falcon/ 获取。
一句话总结
来自青海大学、清华大学和中国脑科学研究所的研究人员发布了 RealSSA,这是一个具有近场和远场干扰的逼真音视频目标说话人提取基准,并提出 Falcon,一种将多尺度时频分离与编码器空间说话人对比损失相结合的因果方法,在达到最先进提取质量的同时,与因果 AV-TFGridNet 相比参数减少 91.9%,计算量减少 20.2×,GPU 推理延迟降低 11.1×。
核心贡献
- RealSSA 被提出作为一个逼真的音视频目标说话人提取基准,包含 RealSSA-Sim 和 RealSSA-Real。RealSSA-Sim 提供可控的模拟场景,包括 1 到 5 个动态近场干扰说话人、包含 10 到 15 个远场干扰源的远场场景、混响和突发噪声,而 RealSSA-Real 提供一个留出的真实录制评估集。
- Falcon 是一种因果提取方法,其分离器在单次编码器-解码器过程中执行多尺度时频分离。Falcon 使用编码器空间说话人对比损失进行训练,在零推理成本下抑制近场泄漏,并且可以跨骨干网络迁移。
- Falcon 在 RealSSA-Sim、LRS2-2Mix、LRS3-2Mix 和 VoxCeleb2-2Mix 上达到了最先进的提取质量,并在 RealSSA-Real 上达到了有竞争力的感知质量、WER 和目标说话人相似度。与因果 AV-TFGridNet 相比,参数减少 91.9%,计算量减少 20.2×,GPU 推理延迟降低 11.1×。
引言
音视频目标说话人提取(AVTSE)利用说话人的唇部流作为注册线索,从多说话人混合信号中分离出该说话人,而视频会议和助听设备等延迟敏感应用需要因果处理。先前因果 AVTSE 工作存在两个局限:基准固定说话人数量和声学条件,且没有真实录制评估;而因果架构要么计算量过大无法进行边缘部署,要么以侵蚀延迟收益的方式迭代复用小型模块。作者提出了 RealSSA,一个基准,包含 1 到 5 个动态近场干扰源、可选的 10 到 15 个远场干扰源、联合混响、环境噪声和突发噪声的模拟场景,外加一个留出的真实录制评估集。作者还提出了 Falcon,一种单次前向因果模型,其解码器在不同层级应用频率轴、时间轴和联合时频建模,并配备编码器空间说话人对比损失,在无推理成本的情况下减少近场泄漏。Falcon 达到或超过了强因果基线,同时与因果 AV-TFGridNet 相比参数减少 91.9%,计算量减少 20.2×,GPU 推理延迟降低 11.1×。
数据集
作者使用 RealSSA 作为主要数据集,包含两个互补子集:
-
RealSSA-Sim:用于训练、验证和测试的模拟场景套件。
- 包含四种声学场景:小型会议室、中型室内空间、大型公共空间和户外环境。
- 近场干扰说话人每个样本从 1 到 5 个变化;包含远场干扰的场景还包括 10 到 15 个远场干扰说话人。当说话人位于麦克风 3 m 以内时为近场,否则为远场。
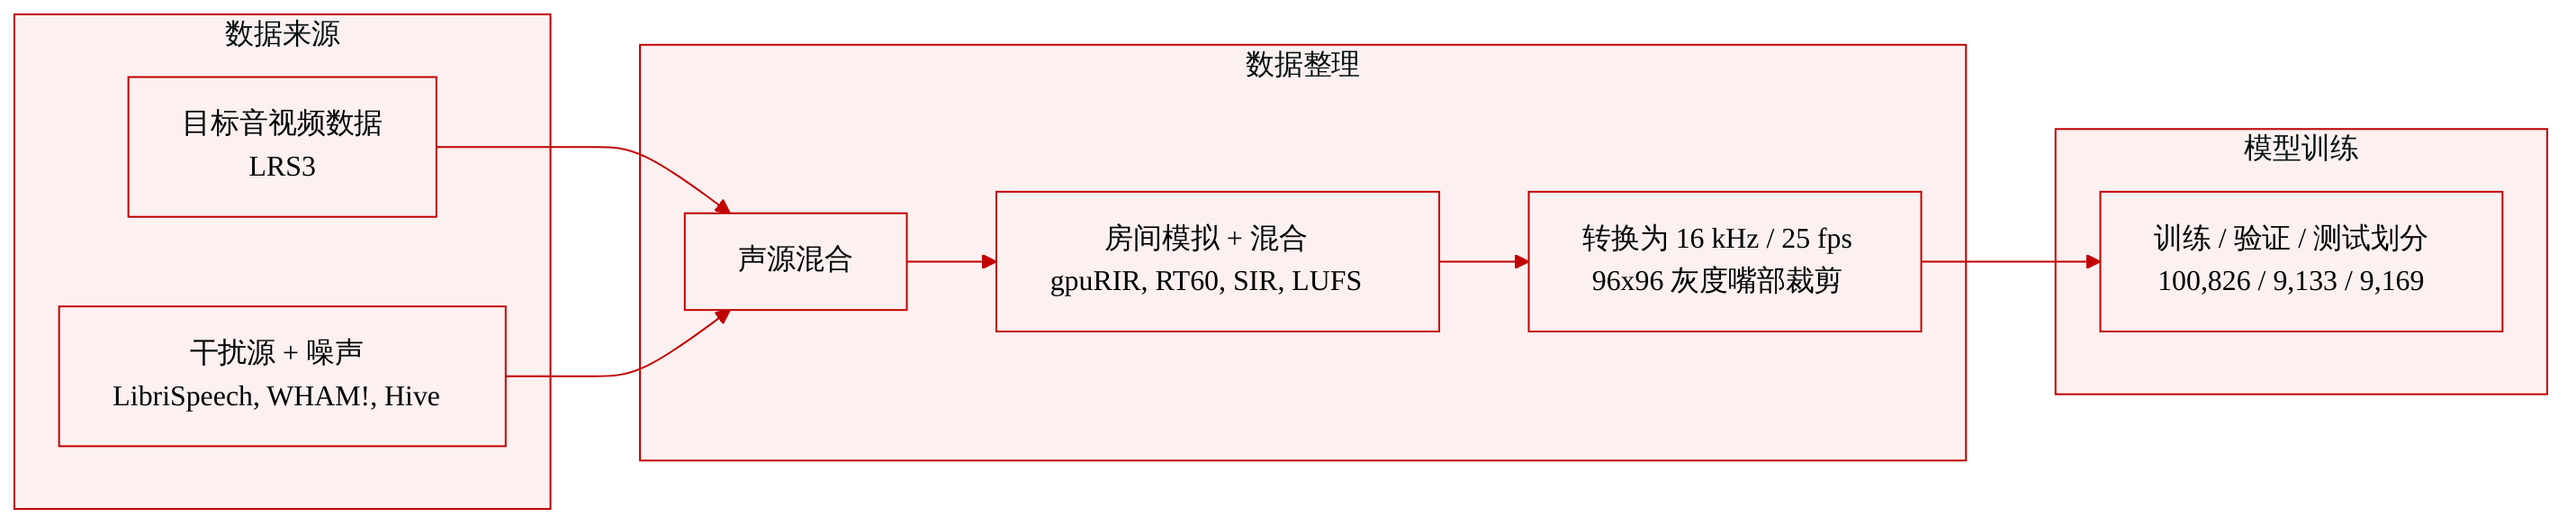
- 目标音视频数据采样自 LRS3;干扰说话人来自 LibriSpeech;连续背景噪声来自 WHAM!;突发噪声事件来自 Hive。
- 房间模拟使用 gpuRIR 生成房间脉冲响应,每个样本采样场景类型、房间几何形状和 RT60。
- 混合时将目标语音归一化至 -23 LUFS,按场景特定 SIR 范围添加干扰源和噪声,将最终混合峰值限制在 -1 dBFS,并输出单通道 16 kHz 音频。
- 规模:100,826 个训练样本、9,133 个验证样本和 9,169 个测试样本,总计约 153 小时。四种场景类型均匀采样,每个样本平均有 2.5 个近场干扰说话人。
-
RealSSA-Real:一个留出的真实世界评估集。
- 使用单一移动设备在日常室内、公共和户外环境中录制,包含自然背景噪声、房间混响和不受控制的干扰语音。
- 仅用于评估,从未用于训练或验证。
- 仅进行后处理以匹配 AVTSE 输入格式:音频重采样至 16 kHz,视频转换为 25 fps,并提取 96x96 灰度嘴部区域。
- 使用 DNSMOS 和 NISQA 评估感知质量,使用 WER 评估语音可识别性,使用说话人相似度评估目标说话人一致性。
在论文实验中,所有数据集使用 16 kHz 音频配以 25 fps 的 96x96 灰度嘴部裁剪。公开基准 LRS2、LRS3 和 VoxCeleb2 遵循其官方划分。RealSSA-Sim 用于训练、验证和测试,而 RealSSA-Real 仅用于评估。
方法
作者提出了 Falcon,一个旨在给定目标说话人嘴部视频的情况下从混合波形中提取目标语音的模型。混合信号被建模为目标语音、近场干扰语音、远场干扰语音和加性环境噪声之和。
如下图所示:
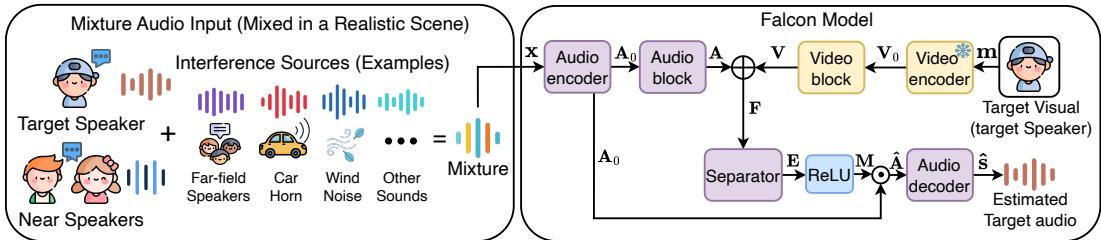
视觉骨干在训练期间冻结,从视频中提取嘴部特征,并通过视觉瓶颈进行映射。音频编码器对混合信号应用 STFT,拼接实部、虚部和幅度谱,并通过二维卷积层处理。在融合之前,音频特征由 AudioBlock 处理,视觉特征由 VideoBlock 处理,VideoBlock 聚合时间上下文并上采样至音频帧率。视觉特征沿频率轴扩展并与音频特征相加,得到融合特征。该融合特征随后由分离器处理,以获得目标说话人特征。掩码生成器从该特征预测时频掩码。掩码和初始音频编码的通道维度被拆分为实部和虚部子带,掩码嵌入通过复数乘法获得:
A^=[Mr⊙A0,r−Mi⊙A0,iMr⊙A0,i+Mi⊙A0,r]最后,音频解码器将掩码嵌入映射回频谱分量,并通过 iSTFT 重建目标语音。
分离器在提取目标说话人特征中起核心作用。它被设计为非对称 U-Net,其中时频建模集中在编码器瓶颈处,以形成粗略场景上下文,而每个解码器分辨率上的层级特定块恢复细粒度频谱结构。
如下图所示:
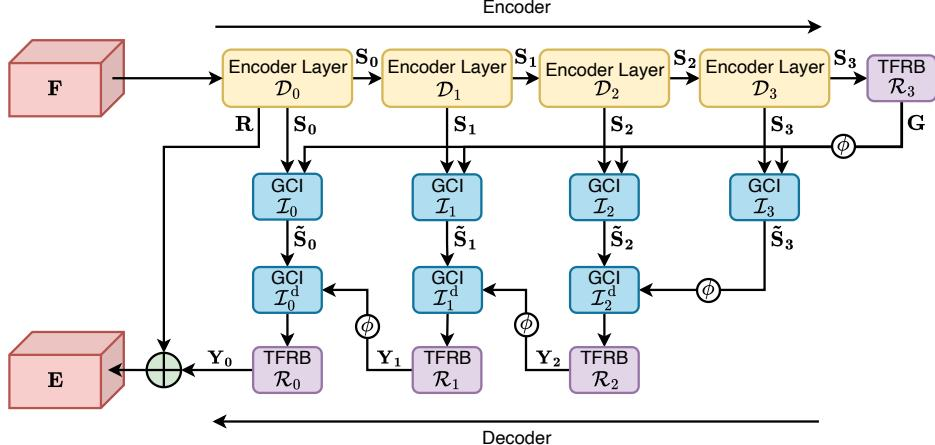
输入特征首先通过深度卷积形成残差分支,作为全局跳跃连接。逐点卷积将其投影到隐藏通道维度,随后进行流式因果层归一化。编码器由四个层级的深度卷积组成,逐步将时间和频率轴减半。时频建模仅在瓶颈处使用时间频率精炼块(TFRB)进行。
如下图所示:
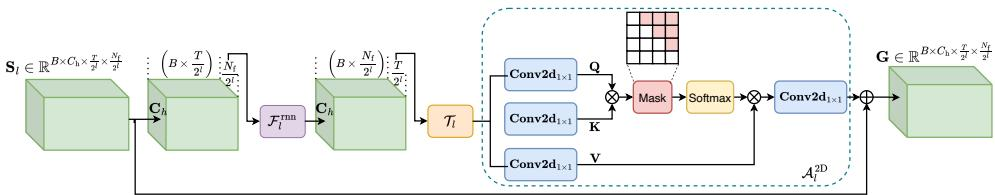
每个 TFRB 级联沿频率轴的双向 LSTM、沿时间轴的单向 LSTM,以及在展平的时频平面上以块因果掩码运行的二维自注意力机制。
为了将全局上下文注入解码器,使用了全局上下文注入(GCI)模块。它对瓶颈特征进行上采样,并使用门控机制来强调或抑制局部跳跃连接的频带。解码器从粗到细恢复分辨率,在不同分辨率上应用 TFRB,在单次前向过程中跨越四个时频尺度。最终解码器输出被投影并与残差分支相加,得到目标说话人特征。
为了明确地将估计语音推离近场干扰源,作者引入了一种复用音频编码器的对比损失。查询是编码器空间中的估计目标,而正参考和负参考分别是经过音频编码器并带停止梯度的干净目标和近场干扰源。远场干扰源被排除在负样本集之外。轻量级说话人池化函数将每个编码器空间特征映射为单位范数说话人嵌入。对比损失结合了正吸引项和基于 softmax 加权的间隔排斥项:
Lspk=(1−cos(q,p))+k=1∑K∑j=1Kexp(τsj)exp(τsk)ReLU(sk−m)其中 m=0.5 是角度间隔,τ 是逆温度,在训练期间从 0 线性退火至 1。最终训练目标将该对比损失与基于负 SI-SNR 的标准重建损失相结合。
实验
评估使用三个公开 AVTSE 基准以及模拟和真实的 RealSSA 集合,衡量分离质量、感知质量、可懂度、说话人相似度和计算效率。Falcon 达到了最佳的 SI-SNRi、SDRi 和感知质量,同时在关键提取任务上获得了最低的 WER 和最高的目标说话人相似度,与强基线相比在参数、MACs 和推理延迟方面有大幅降低。泛化实验表明,在 RealSSA-Sim 上训练可提升真实世界感知质量,消融实验证实了多阶段下采样、编码器空间说话人对比损失和温度退火的益处。
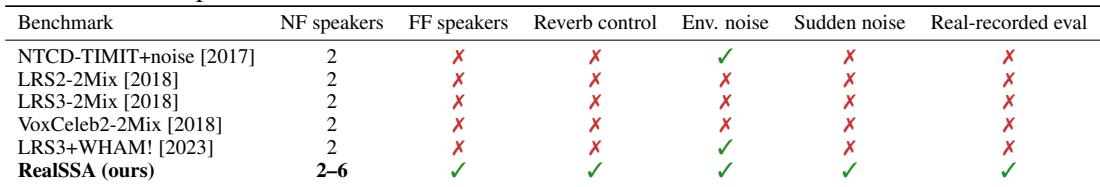
现有 AVTSE 基准仅限于固定近场说话人对,并且对声学条件的控制很少;只有一部分添加了环境噪声,没有一个包含远场源、受控混响、突发噪声或真实录制评估。RealSSA 通过支持可变说话人数量并添加远场源、受控混响、环境噪声、突发噪声和真实录制评估来放宽这些约束。先前基准如 LRS2-2Mix、LRS3-2Mix 和 VoxCeleb2-2Mix 固定了近场说话人数量,且不提供受控混响或突发噪声。RealSSA 是该比较中唯一包含远场说话人、可变说话人数量、受控混响、突发噪声和真实录制评估的基准。
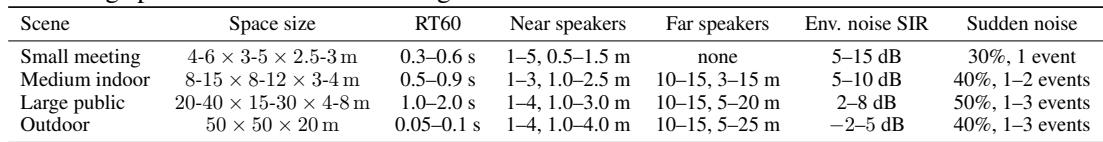
模拟套件定义了四种声学场景类型,涵盖小型室内房间、中型和大型室内空间以及户外环境。室内场景从短混响和仅有近场干扰源逐步过渡到较长混响和大量远场干扰源,而户外场景将最小混响与更强的背景噪声配对。突发噪声事件和声源距离也因场景类型而异。混响时间在小型、中型和大型室内场景中逐步增加,而户外场景几乎保持无回声。小型会议室仅包含近场干扰说话人,而其他三种场景在更远距离添加远场干扰说话人。环境噪声 SIR 范围从室内场景到户外场景向下移动,表明背景噪声逐渐增强。突发噪声事件在小型会议室中出现最少,在大型公共场景中出现最多。
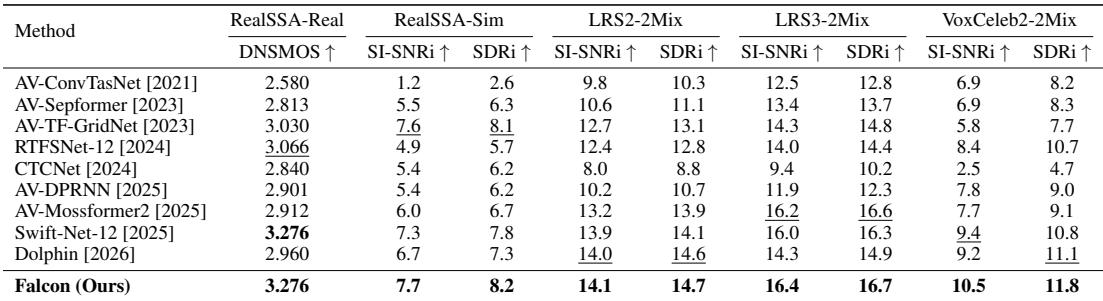
Falcon 在所有四个模拟基准上达到了最高的 SI-SNRi 和 SDRi,在 RealSSA-Sim 上仅以微弱优势领先于 AV-TF-GridNet。在真实录制上,Falcon 达到了最佳 DNSMOS,同时与 SwiftNet-12 并列,并优于 AV-TF-GridNet 和 Dolphin。在所示基线行中,AV-TF-GridNet 在 RealSSA-Sim 上具有竞争力,但在 VoxCeleb2-2Mix 上较弱,后者由 RTFSNet-12 领先。Falcon 在所有模拟基准上以 SI-SNRi 和 SDRi 领先,其 RealSSA-Sim 结果略高于 AV-TF-GridNet。在 RealSSA-Real 上,Falcon 与 SwiftNet-12 并列获得最高 DNSMOS,并明显超过 AV-TF-GridNet 和 Dolphin。
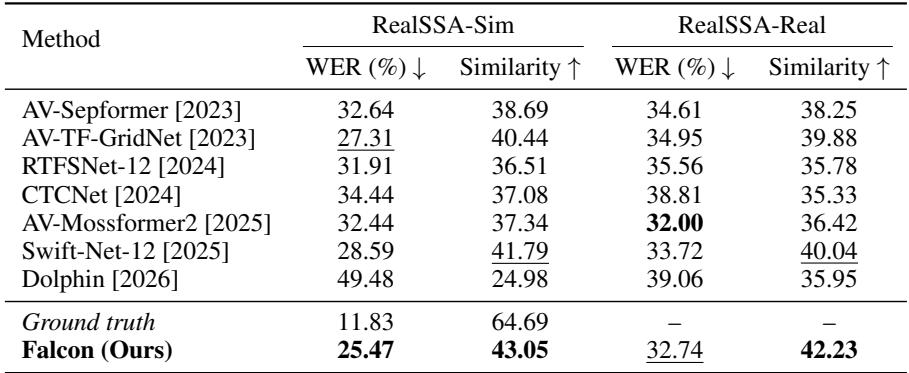
Falcon 在模拟集上取得了提取系统中最低的词错误率,并在两个评估集上取得了最高的目标说话人相似度。在真实录制上,Falcon 的词错误率排名第二,以微小差距落后于最佳基线。结果表明,与先前系统相比,在转录准确性和目标说话人一致性之间取得了有利的平衡。Falcon 在提取系统中取得了模拟集最佳 WER,优于该集合上的最强基线。Falcon 在模拟和真实录制上均产生了最高的目标说话人相似度,在每个集合上均超过次优基线。在真实录制上,Falcon 的 WER 排名第二,落后于 AV-Mossformer2。
Falcon 在比较的因果模型中取得了最低的计算和内存成本,参数数量与 Swift-Net-12 相当,同时所需 MACs 大幅减少且 GPU 延迟更低。与所有列出的基线相比,它还降低了 CPU 延迟、RAM 和 GPU 推理内存。Falcon 在参数数量上与 Swift-Net-12 相当,但仅需其约四分之一的 MACs 和不到其三分之一的 GPU 延迟。与最强基线相比,Falcon 获得了更高的分离质量,同时使用了显著更少的参数、MACs 和 GPU 延迟。Falcon 报告了所有比较方法中最低的 CPU 延迟、GPU 延迟、RAM 和 GPU 推理内存。
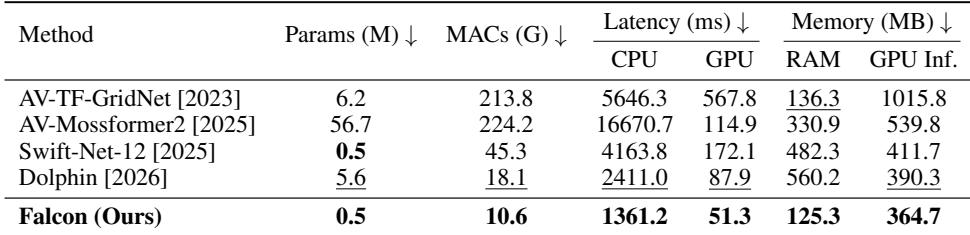
实验评估了新的 RealSSA 基准,该基准具有可变远场说话人、受控混响、环境和突发噪声以及真实录制。Falcon 在模拟室内和户外场景以及真实数据上与基线进行了比较,验证了分离质量、转录准确性、说话人相似度和效率。它在模拟分离指标和真实 DNSMOS 上持续领先,取得了最佳的模拟词错误率和最高的目标说话人相似度,并在因果模型中显示了最低的计算和内存成本。