Command Palette
Search for a command to run...
对 MLLM 检索头的更广泛审视
对 MLLM 检索头的更广泛审视
Jia Wang Yuqing Li Jiangnan Li Zheng Lin Mo Yu
摘要
在长输入中定位相关证据是多模态大语言模型的一项核心能力。此前研究将这一能力归因于检索头,即一组稀疏的注意力头,负责把信息从上下文传递到输出。然而,这些分析仅限于少量模态及相应模型。此外,如何利用检索头来增强模型仍有待进一步探索。本文探讨这一机制是否随模型输入模态的扩展而扩展。我们将音视频输入作为新增模态,构造成对输入,使同一答案或以语音形式出现,或显示在屏幕上。在证据内容固定的情况下,检索头在新模态中仍然保持稀疏,并在很大程度上跨模态共享。在 18 个语言、视觉-语言和全模态检查点上,全模态模型在很大程度上保留了其骨干模型的检索头。消融这些头几乎消除了所有音视频检索能力。跨模态共享的头占全部头的比例不到 2%,但消融它们同样会降低文档理解、空间感知和视觉数学能力。基于这些发现,我们将检索头作为优化目标,通过排序目标训练其注意力。此举将 Qwen3-VL-8B 在 MMDocIR 上的页面 Recall@1 提高了 6.03 个百分点,并在三个模型家族上改善了文档检索。功能性注意力头因此既可以作为观察多模态模型的透镜,也可以作为改进它们的目标。
一句话总结
中国科学院信息工程研究所、中国科学院大学和腾讯的研究人员证明,多模态检索头在视听模态之间仍然稀疏且大部分共享,并且以排序目标训练这些检索头可使 Qwen3-VL-8B 在 MMDocIR 上的页面 Recall@1 提升 6.03 个百分点,并在三个模型系列上改善文档检索。
核心贡献
- 对跨音视频证据模态以及 18 个语言、视觉语言和全模态检查点的成对分析表明,检索头在新模态中仍然稀疏,在模态之间大部分共享,并且在全模态模型中从骨干网络保留下来。
- 消融实验提供因果证据,表明检索头对音视频检索是必要的,并且一个共享的跨模态子集占所有头不到 2%,也支持更广泛的多模态推理,如文档理解、空间感知和视觉数学。
- 一种基于排序的优化方法训练检索头注意力,使相关页面相对于干扰页面获得更高偏好,使 Qwen3-VL-8B 在 MMDocIR 上的页面 Recall@1 提升 6.03 个百分点,并在三个模型系列上改善文档检索,包括在没有布局监督的情况下改善布局检索。
引言
多模态大语言模型通常必须从跨越多种模态的长输入中定位一小段相关证据,因此证据定位成为核心挑战。此前在语言和视觉语言模型中的工作识别出稀疏的检索头,它们将相关上下文传递给输出,但尚不清楚这种机制是否可推广到音频等较新模态,以及它能否用于改进模型而不只是分析模型。作者通过研究 18 个全模态检查点中的成对音视频证据来回答这一问题,表明检索头是稀疏的、跨模态共享的、从骨干网络保留下来,并且对多模态推理具有因果重要性。随后,作者利用这些发现通过排序目标优化检索头注意力,从而在多个模型系列上改进多模态文档检索。
数据集
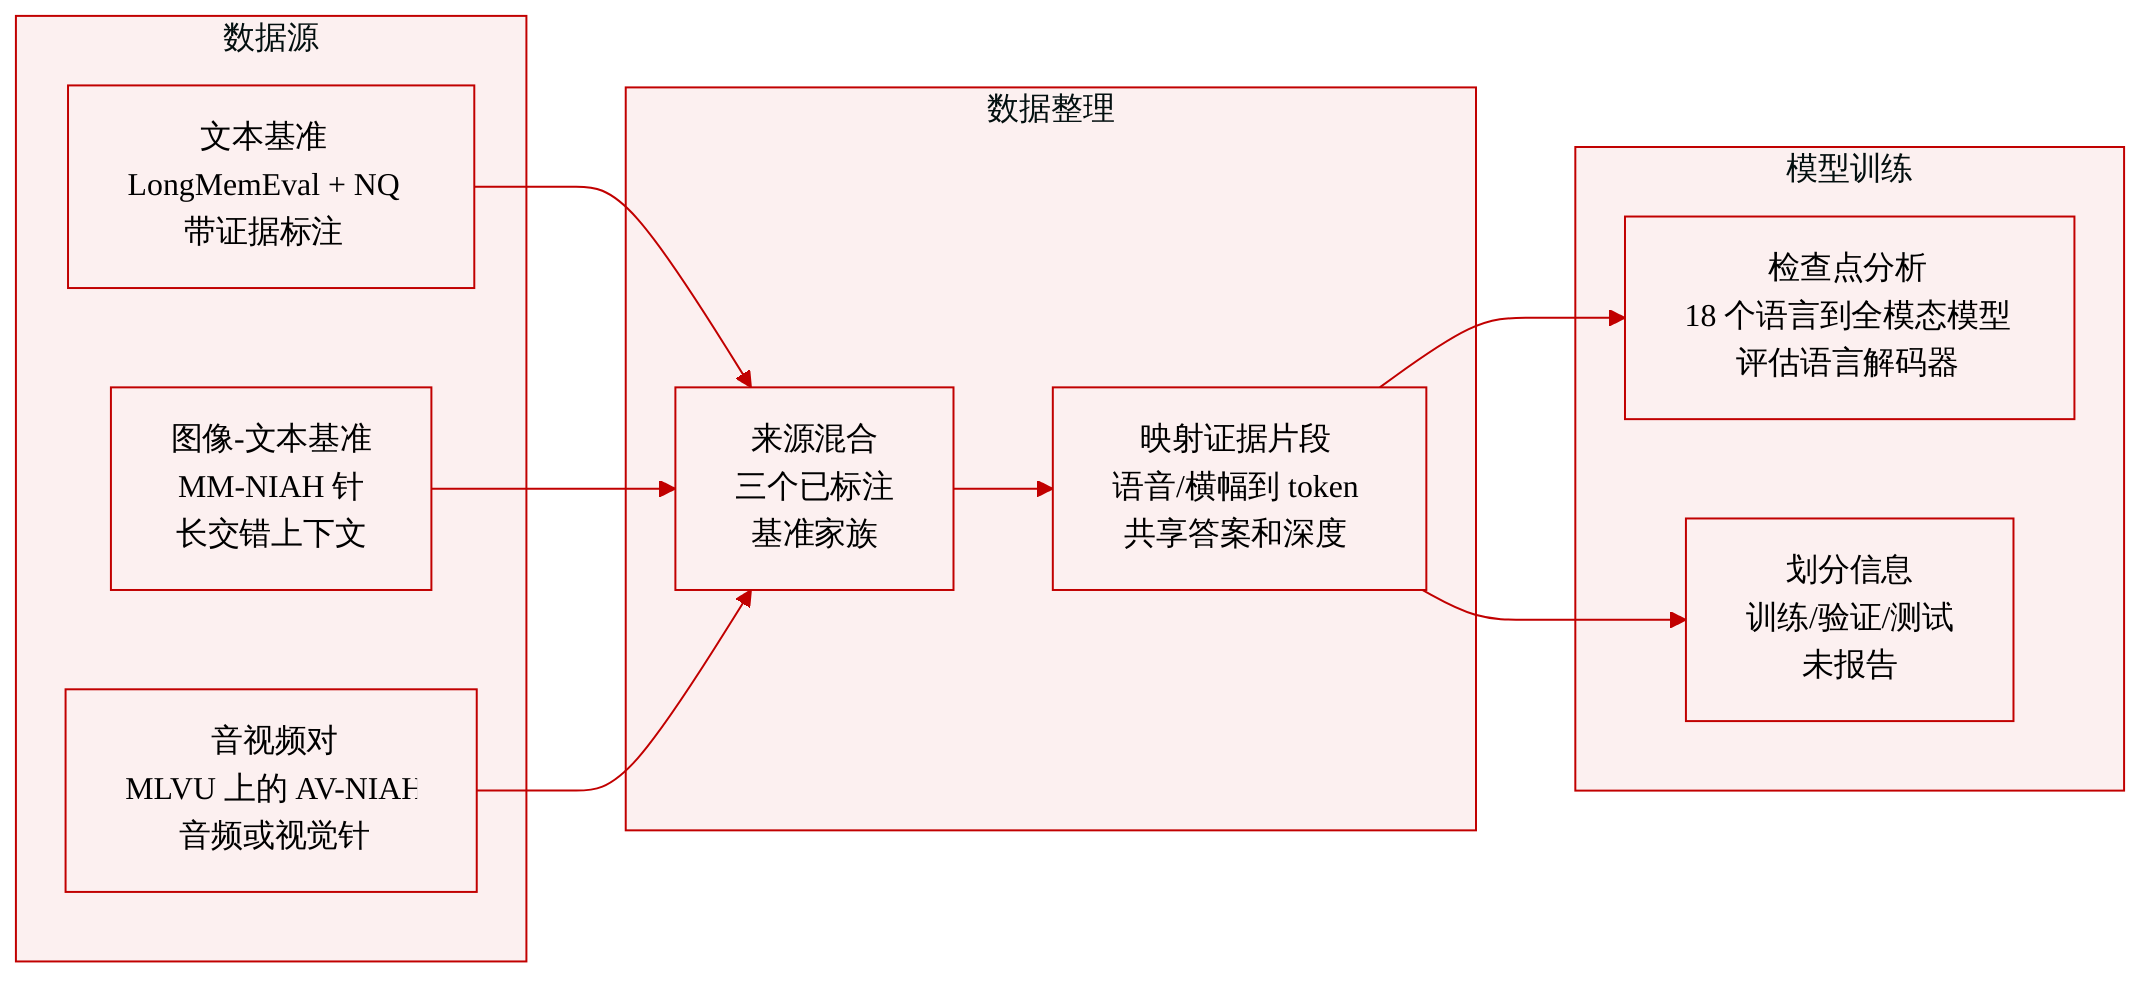
作者使用三个带有证据标注的基准系列进行统一的检索头检测。
-
文本基准:
- 来源:LongMemEval 和 Natural Questions 的经证据标注子集,由 QRHead 处理。
- 每个问题都包含回答所需的标注证据。
-
图文交错基准:
- 来源:MM-NIAH。
- 它在长交错上下文中放置文本或自然图像针。
- 每个问题都有证据标注。
-
音视频基准:
- 来源:新构建的成对 AV-NIAH 示例,基于 MLVU 的背景视频。
- 在两种模态条件下,将一个六位数字插入背景视频。
- 音频条件:合成语音读取数字,视频轨道保持不变。
- 视觉条件:数字在居中横幅上出现一秒,音频轨道保持不变。
- 两种条件共享相同的源视频、答案、插入深度以及问题“What is the secret number?”
- 语音或横幅的时间跨度被映射到对应的音频或视频 token,形成证据跨度 G_i。
-
数据使用方式:
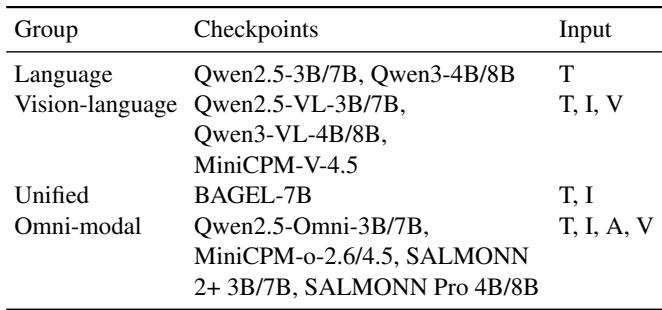
- 这些数据用于分析 18 个检查点,涵盖语言、视觉语言、统一和全模态模型。
- 评估目标是生成文本的语言解码器,包括 Qwen2.5-Omni 的 Thinker 和 BAGEL 的理解专家。
- 若干全模态检查点由同一集合中的语言或视觉语言骨干网络适配而来,这支持保留分析。
-
规模和处理说明:
- 摘要中并未报告子集规模、过滤规则、训练划分和混合比例。
- 未描述单独的裁剪策略。
- 所述数据用于检测和评估,而非模型训练。
方法
统一检索头检测与引导排序
作者提出一种统一方法,用于识别检索头、跨模型比较检索头,并利用其注意力模式训练文档排序。核心思想是,检索头应将更多注意力从问题 token 指向证据 token,而不是指向输入其余部分。
对于示例 i,设 Qi 表示问题 token 位置,Gi 表示证据 token 位置。头 (l,h) 的原始证据注意力为
ulh(i)=∣Qi∣1q∈Qi∑t∈Gi∑alh(i)(q,t),其中 alh(i)(q,t) 是第 l 层头 h 中从位置 q 到位置 t 的注意力。该注意力的一部分反映了与问题无关的位置或内容偏好。为消除这些偏好,作者在同一上下文上使用无信息问题重新计算同一统计量,记为 ulh(i,∅)。校准后的检索分数为
slh=N1i=1∑N(ulh(i)−ulh(i,∅)).头按 slh 排序。除非另有说明,检索头被定义为该排序中排名前 5% 的头。所有注意力值均在模型原生可见性约束下计算。
比较与干预协议
两种比较结构构成分析。在模型内部,仅改变证据模态可检验检索头是否跨模态共享。在相关检查点之间,固定文本任务可检验头部在模态适配下是否被保留。两种情况中,对所有头计算 Spearman 的 ρ 以衡量完整排序的一致性,而顶级集合之间的重叠则衡量最强头之间的一致性。
注意力分数可识别候选头,但作者还检验模型是否确实依赖它们。头集合 S 的消融方式为:在注意力输出投影之前将其中头的输出置零。作为对照,从每层移除相同数量的头,并从检索头之外随机抽取,使用三个种子。设 t 为消融 S 后的任务分数,rˉ 为匹配随机消融后的平均分数。S 的效应为其额外下降:
E(S)=rˉ−t.较大的 E 表示移除 S 的损害远大于移除同等数量、同等分布的其他头集合。所有消融都使用从头选择中留出的示例,显著性通过配对聚类自助检验和 Holm 校正进行评估。
检索头引导的文档排序
作者还检验训练检索头注意力是否能改善文档排序。给定问题和来自一个文档的候选 D={d1,…,dm},模型按相关性对候选排序。对于固定检索头集合 Hk、问题位置 Q 以及候选 dj 的视觉 token 位置 Tj,候选分数为
rj(θ)=(l,h)∈Hk∑∣Q∣1q∈Q∑t∈Tj∑alhθ(q,t).这将在所选头上应用与公式 (1) 相同的注意力统计量,将每个候选视为证据跨度。
训练分三步进行。首先,头集合 Hk 从基础模型中一次性选出,并在训练和推理期间保持固定。其次,原始注意力分数在每个示例内进行归一化,因为其取值范围较小且不稳定。归一化分数为
zj={γ(rj−b)/Δ,rj,Δ>ϵ,Δ≤ϵ,其中 b=sg(minjrj)、Δ=sg(maxjrj−minjrj),sg 停止梯度,γ 设置 logit 尺度,ϵ 防止退化取值范围。将端点从计算图中分离可将 logit 范围固定在 [0,γ],同时梯度仍流经每个 rj。
第三,最小化排序目标。每个训练示例包含一个相关页面 j+ 和一个来自同一文档的困难负样本,顺序随机。损失为
Lrank=−log∑jexp(zj)exp(zj+).该损失仅定义在所选头上,但其梯度会更新注意力投影上的 LoRA 适配器。在推理时,候选按 rj 减去使用无信息问题获得的分数进行排序,与公式 (2) 中使用的校准一致。
实验
实验首先分析全模态模型中的检索头,表明位于中间层和后层的稀疏头集合处理语音和显示证据,匹配的音视频证据大体上招募相同的头,并且这些头继承自语言或视觉语言骨干网络。消融研究确认,移除这些头会破坏音视频检索和更广泛的多模态任务,其中一个小型跨模态子集尤为重要。随后,文档排序评估在 MMDocIR 上使用检索头引导打分,证明检索头在页面检索和布局检索上优于随机头,并且轻量排序训练在没有布局监督的情况下在多个模型系列上改善两种粒度。
机制分析使用 18 个检查点,涵盖语言、视觉语言、统一和全模态模型。输入覆盖范围从语言模型中的仅文本,到全模态模型中的文本、图像、视频和音频。所有测量均针对语言解码器,若干全模态检查点由语言或视觉语言骨干网络适配而来,以支持保留分析。全模态检查点是唯一覆盖全部四种输入模态(文本、图像、视频和音频)的组别。视觉语言检查点处理文本、图像和视频,统一检查点覆盖文本和图像,语言检查点仅覆盖文本。若干全模态检查点由语言或视觉语言骨干网络适配而来,可进行跨模型类型的保留比较。
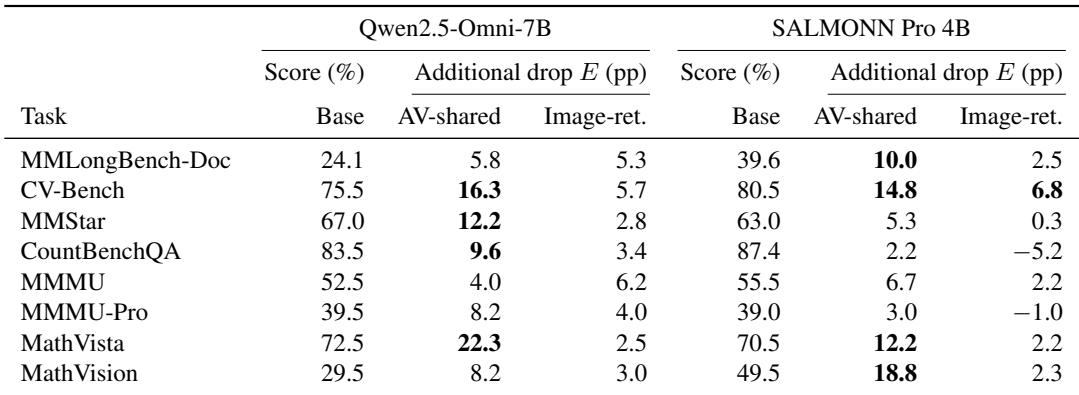
消融 AV 共享头会在报告的下游多模态任务和两个模型上产生超过匹配随机消融的额外性能下降。其效应通常强于消融图像检索选出的头,在每个模型上对更多任务造成显著损害。这支持一个结论:一小组跨模态头对多模态证据使用有广泛贡献。AV 共享头消融在两个模型的每个报告任务上都产生正的额外下降,表明其损害始终超过随机消融。所报告的最大 AV 共享下降出现在视觉感知基准如 CV-Bench 上,而图像检索头产生的额外下降较小甚至为负。AV 共享效应在每个模型八项任务中有四项统计显著,而图像检索头最多为八项中的一项。
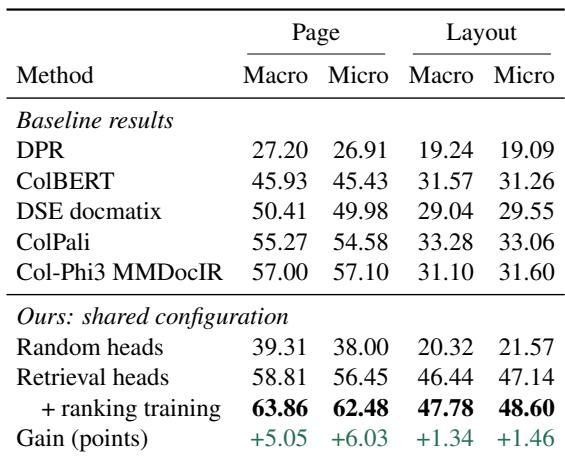
已发布的基线检索器在页面检索和布局检索上表现出很大的 Recall@1 差距,其中 ColPali 和 Col-Phi3 MMDocIR 属于最强方法。在受控 Qwen3-VL-8B 设置中,检索头排序在训练前已经优于随机头排序。微调改善了全部十个文档领域的页面检索,并在没有布局监督的情况下改善了布局检索,训练后的检索头打分器超过已发布基线,尽管设置不同。检索头在训练前对候选的排序优于随机头,页面检索在每个文档领域训练后都得到改善。布局检索也在没有布局监督的情况下改善,训练后的模型超过已发布基线,尽管评估设置不同。
排序训练改善了全部三个模型系列的页面检索和布局检索。Qwen 模型的页面检索增益最大,且尽管缺少布局监督,所有模型的布局检索均得到改善。每个模型系列在训练后的页面和布局检索分数都更高。两个 Qwen 模型显示出最大的页面检索改进。Gemma3-12B 在评估模型中页面增益最小,但布局增益最大。
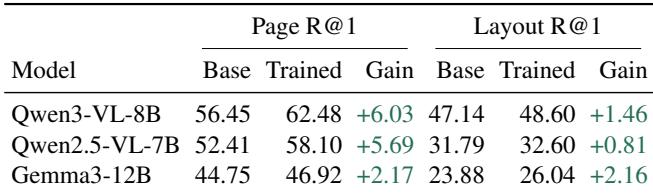
实验评估了跨模型系列的多模态证据使用和检索。机制分析涵盖 18 个语言、视觉语言、统一和全模态检查点,考察跨输入模态的语言解码器保留。消融一小组 AV 共享跨模态头会导致超过随机消融的持续额外性能下降,尤其在视觉感知任务上,表明它们在多模态整合中具有广泛作用。检索实验表明,检索头排序在训练前优于随机头排序,微调在多个领域和模型系列上改善了页面和布局检索,训练后的检索头打分器超过已发布基线。