Command Palette
Search for a command to run...
RSIHub:一种面向智能体演化方法的可组合框架
RSIHub:一种面向智能体演化方法的可组合框架
摘要
智能体演化方法利用执行反馈来改进提示、技能、工具和编排,但其实现往往重复搭建相同的实验机制。我们提出了 RSIHub,一个用于在共享基础设施上构建、比较和扩展这些方法的开源框架。Recipes 组合可复用算子并声明可变资源;RSI-Hub 提供执行、评估、恢复和血缘跟踪。研究人员可以专注于演化策略,而评估保持在可变表面之外,结果仍与候选方案和评估条件绑定。我们在不修改框架核心的情况下实例化了 AHE、Hyperagents、A-Evolve 和 GEPA,将方法特定逻辑保留在 recipes 和算子中。我们在固定的模型和评估器配置下,使用 MiniSWE 和 Codex 在 Terminal Bench 2 和 τ³ Banking 上对它们进行评估。观察到的最大整体 pass@1 提升为 13.5 个百分点,而方法排名在不同设置下有所变化,且优化收益并不总能迁移到留出任务上。RSIHub 为比较演化策略提供了通用协议、可检查的候选历史,以及用于开发新方法的可复用组件。
一句话总结
加州大学伯克利分校的研究人员与合作者提出了 RSIHub,一个面向 agent 演化方法的开源可组合框架。在该框架中,配方组合可复用算子,共享基础设施负责执行、评估、恢复和谱系记录,从而无需修改框架核心即可实例化 AHE、Hyperagents、A-Evolve 和 GEPA,并在 Terminal Bench 2 与 τ³ Banking 上取得最高 13.5 个百分点的 pass@1 提升,尽管各方法排名会变化,且提升未必能迁移。
核心贡献
- 本文提出了 RSIHub,一个开源框架,为 agent 演化方法提供共享的执行、评估、恢复和谱系记录,同时将评估置于可变优化表面之外。
- 该框架用可复用算子与可变资源构成的配方来表示方法;论文通过在不修改核心框架的情况下实例化 AHE、Hyperagents、A-Evolve 和 GEPA,证明了其通用性。
- 在固定模型与评估器配置下,使用 MiniSWE 和 Codex 在 Terminal Bench 2 与 τ³ Banking 上进行的实验表明,整体 pass@1 最大提升为 13.5 个百分点,不同设置下方法排名会变化,提升并非总能迁移到留出任务上。
引言
语言模型 agent 的开发通常由经验循环驱动:开发者检查执行情况,修改提示、技能、工具或编排,并重新评估行为。agent 演化与程序优化系统使这一循环的部分环节自动化,但先前实现常将方法策略与重复出现的基础设施耦合在一起,例如候选工作区、任务执行、评估、产物保留、恢复和谱系记录。因此,实现一个新方法可能需要再构建一个端到端系统,而比较不同方法需要协调运行器、配置和评估器接口。作者提出了 RSIHub,一个可组合框架,通过绑定生命周期算子、声明可变表面并指定运行配置的配方,将方法策略与这些共享基础设施分离;同时受保护的运行时与经过验证的归档使评估和记录保留处于框架控制之下。他们将 AHE、Hyperagents、A-Evolve 和 GEPA 表示为配方,并在固定模型和评估器配置下,跨两个种子 agent 和两个基准进行比较。
方法
作者提出了 RSIHub,一个可组合框架,旨在将方法特定策略与候选执行、评估和记录保留等重复出现的基础设施解耦。通过固定演化生命周期的槽位并使其内容保持开放,研究人员可以用可互换部件组装演化方法。配方为每个槽位指定算子实现并对其进行配置,同时显式声明可变表面,即候选体被允许更改的资源。这种分离确保工作区构建和谱系记录等框架管理服务只需实现一次,并可在不同方法之间复用。
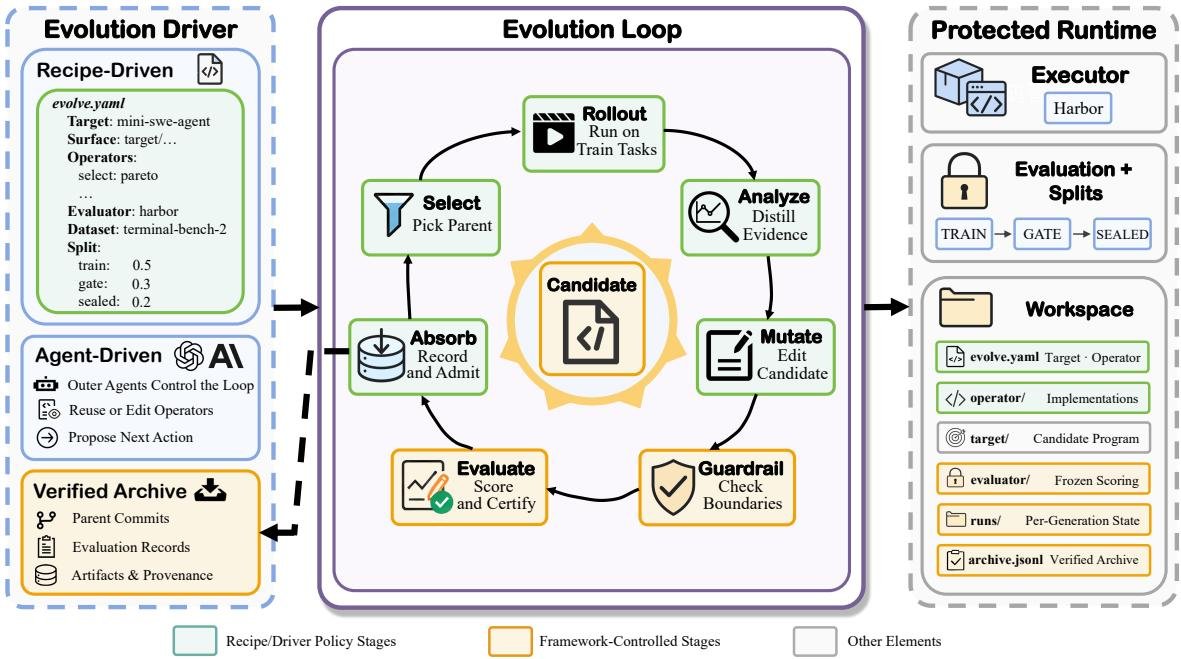
如框架图所示,系统架构分为三个主要组件:Evolution Driver、Evolution Loop 和 Protected Runtime。
Evolution Driver 管理配方配置,该配置既可以由研究人员编写并保持固定,也可以由外层 agent 动态修订。Protected Runtime 通过 Harbor 提供容器执行的底层基础,管理评估划分,并强制实施可变表面边界。关键的是,框架对评估和评分保持严格控制,以防止方法控制下的更改改变测量条件。
框架的核心是可组合候选体生命周期,它经历七个不同阶段。在这些阶段中,配方绑定五个必需算子接口:Select、Rollout、Mutate、Gate 和 Record,以及四个可选接口:Analyze、Validate、Novelty 和 Reflect。
生命周期从 Select 阶段开始,在此阶段从经过验证的归档中选择符合条件的父代。接下来,Rollout 阶段在训练任务上执行父代,以收集执行证据。随后的可选 Analyze 阶段将这些证据提炼为有界变异数据。在 Mutate 阶段,一个算子(通常是 agent)严格在已声明可变表面内提出编辑。随后,Guardrail 阶段根据可变表面边界检查提议的更改,并可应用可选验证或新颖性检查以过滤近似重复项。
Evaluate 阶段完全由框架管理。它提交经过审查的候选体,在 gate 任务上对其评分并认证结果,确保密封任务保留用于留出报告。最后,Absorb 阶段根据认证分数决定子代是否成为父代,记录方法特定注释,并可选择性地反思归档历史以供后续世代使用。
为保持实验完整性,该框架可在配方驱动模式下运行(此时配方保持不变),也可在 agent 驱动模式下运行(此时外层 agent 在迭代之间调整算子绑定和策略设置)。在两种模式下,目标、评估器、运行时和数据划分都保持固定。系统生成经过认证的评估事件,以密码学方式将提交的候选体、其父代和当前配方快照绑定到评估器指纹与试验结果。这种溯源模型使研究人员能够隔离特定策略组件,并调查停滞的进展,而无需重建底层实验基础设施。
实验
评估回答三个问题:RSIHub 是否支持有效的 agent 演化、是否保留已执行 agent 的能力,以及是否保持实验完整性。该评估在 Terminal Bench 2 和 τ³ Banking 上,跨 MiniSWE 与 Codex 比较了四个适配配方和一个爬山基线,发现收益随设置而异,尽管整体有所改进,但在一些留出任务上出现退化。框架介导的执行显示分数变化在直接执行变异性范围内,且恢复与故障注入试验均达到有效、可溯源状态,没有纳入被破坏的结果。
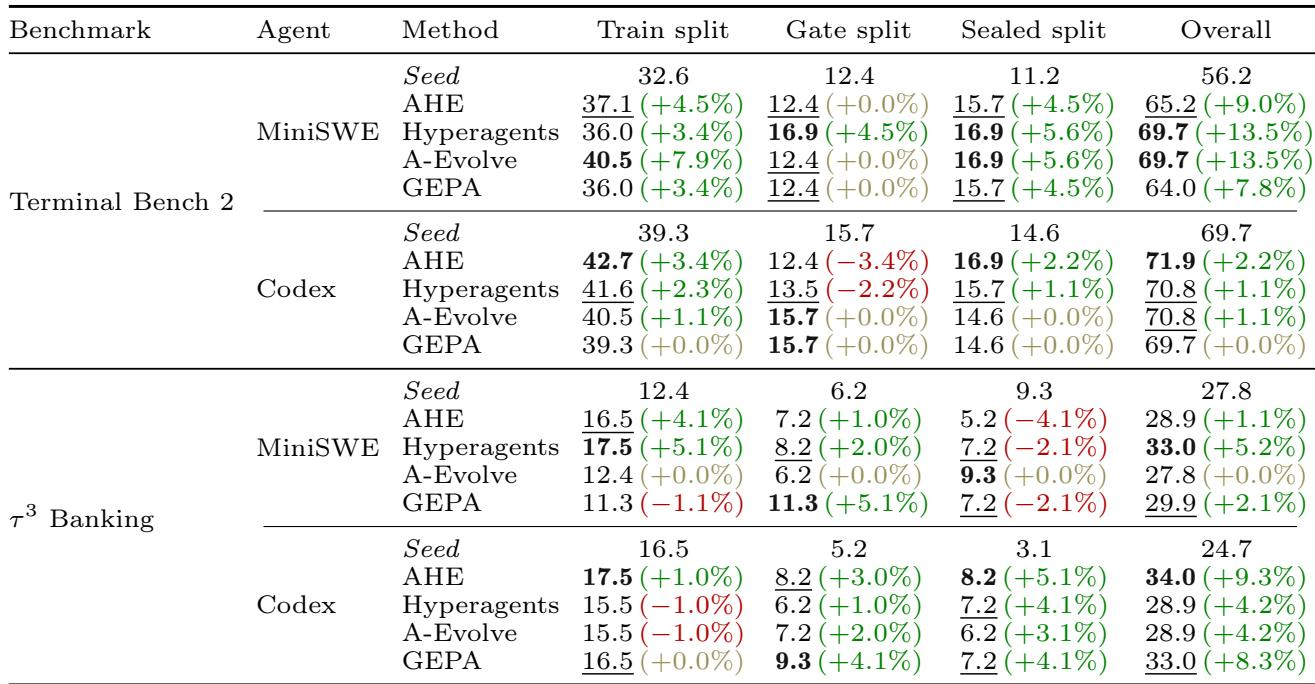
在 Terminal Bench 2 上,所有报告方法中,演化均使 MiniSWE 的 pass@1 相对其种子有所提升,主要来自 train 和 sealed 划分的贡献。对于所报告的 AHE 变体,Codex 的整体提升较小,train 和 sealed 上的收益被较低的 gate 贡献部分抵消。改进因方法和划分而异,表明收益并未一致迁移。对 MiniSWE 而言,所有报告的演化方法均使整体 pass@1 相对种子提升,其中 Hyperagents 和 A-Evolve 在 MiniSWE 演化变体中达到最高整体得分。对 MiniSWE 而言,train 和 sealed 划分的贡献推动了大部分收益,在所报告的演化方法中,只有 Hyperagents 在 gate 划分上有提升。对 Codex 而言,所报告的 AHE 变体提升了 train 和 sealed 划分的贡献,但降低了 gate 划分的贡献,因此仅获得适度的整体收益。
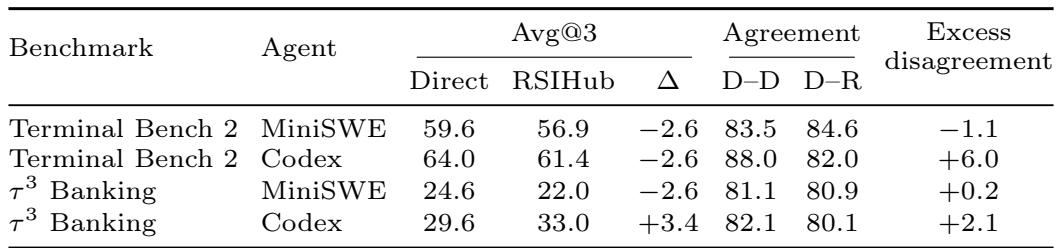
在三次重复中,与直接执行相比,RSIHub 执行仅使平均 pass@1 变化几个百分点,两个 agent 在 Terminal Bench 2 上均下降,而在 τ^3 Banking 上方向不一致。重复的直接运行也显示出任务级不一致,且与 RSIHub 的额外不一致因 agent 和基准而异,其中 Codex 在 Terminal Bench 2 上增加最多。这些结果描述的是执行变异性,并不建立执行模式等效性。在 Terminal Bench 2 上,MiniSWE 和 Codex 在 RSIHub 下的得分均比直接执行低 2.6 个百分点。在 τ^3 Banking 上,MiniSWE 在 RSIHub 下略有下降,而 Codex 有所提升,因此方向并不一致。重复直接执行在 12.0% 至 18.9% 的任务上不一致,表明在 RSIHub 之外还存在基线变异性。Codex 在 RSIHub 下表现出比 MiniSWE 更大的额外不一致,尤其是在 Terminal Bench 2 上。
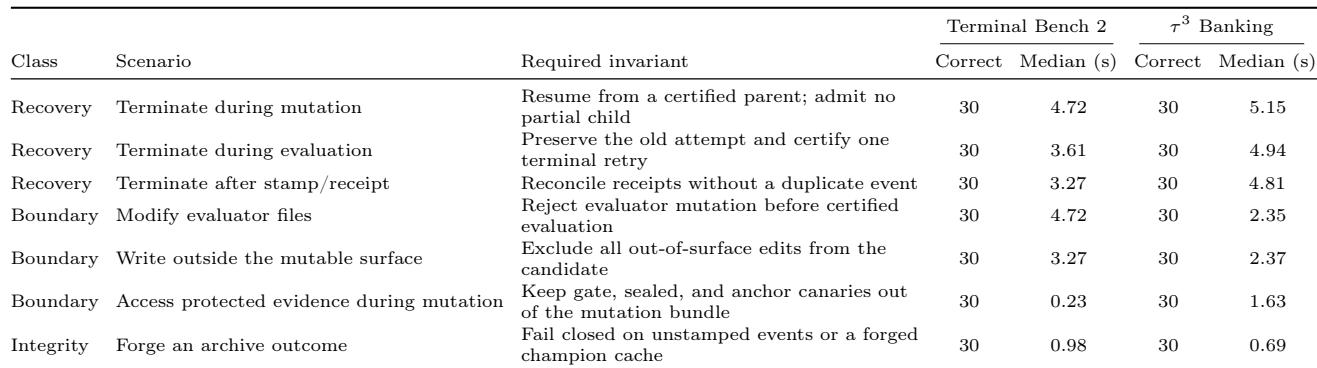
在所有报告的故障注入和边界强制执行运行中,每个场景都取得了完美的正确结果记录,且没有任何试验纳入被破坏的状态。恢复场景表现出较大的中位延迟,而边界场景则各不相同,在两个基准活动中,变异期间访问受保护证据的延迟最低。这些结果仅在所测试的生命周期边界和攻击用例内支持完整性。在两个基准活动中,每个故障注入和边界场景都取得了完美的正确结果。在任何报告的恢复或边界强制执行运行中,没有任何试验纳入被破坏的状态。在变异期间访问受保护证据在两个基准上具有最低的中位延迟,而 banking 边界场景通常比恢复场景更快。
实验评估了 Terminal Bench 2 上演化后的 agent 变体、Terminal Bench 2 和 τ^3 Banking 上 RSIHub 下的执行变异性,以及故障注入和边界强制执行场景下的正确性。演化可靠地提升了 MiniSWE 的 pass@1,主要来自 train 和 sealed 划分的贡献,而 Codex 的收益更小,且在不同划分上不均衡。RSIHub 执行仅使分数变化几个百分点,并揭示出任务级不一致,但方向因 agent 和基准而异,因此未能建立执行模式等效性。所有故障注入和边界强制执行运行均取得完美的正确结果,且没有出现被破坏的状态,支持在所测试生命周期边界内的完整性。